

JavaScript 数组去重性能对比:从低效到高性能的实现方案
本文通过实际测试对比了 JavaScript 中多种数组去重方法的性能。从基础的 filter+indexOf、双重循环,到 ES6 的 Set 和对象属性利用,详细分析了各方案在处理 15W 及 150W 数据量时的耗时差异。结果显示,利用 ES6 Set 和对象属性标记的方法在高性能场景下表现优异,为开发者提供了明确的选型依据。
引言与测试背景
在与同事的交流中,我们探讨了数组去重这一常见编程问题。
我分享了一种常用的去重方案,但随即被资深同事指出该方案效率存在不足。
回家后我进行了独立测试,证实了该方案在处理较大数据时确实速度较慢。
基于此,我展开了对高性能数组去重方法的深入研究。
测试模版设计
一、测试模版设计
数组去重是前端开发中的经典问题,网络上存在多种解决方案。
为了客观评估各方案的性能差异,我编写了一个统一的测试模板,用于精确计算不同去重逻辑的执行耗时。
// distinct.js
let arr1 = Array.from(new Array(100000), (x, index)=>{
 return index
})
let arr2 = Array.from(new Array(50000), (x, index)=>{
 return index+index
})
let start = new Date().getTime()
console.log('开始数组去重')
function distinct(a, b) {
 // 数组去重
}
console.log('去重后的长度', distinct(arr1, arr2).length)
let end = new Date().getTime()
console.log('耗时', end - start)
测试中分别生成了长度为 10W 和 5W 的两个数组。
随后通过 distinct() 方法将两数组合并,并执行去重操作。
该数据规模虽非极端庞大,但已足以反映不同算法间的性能差距。
Array.filter() + indexOf 方案
二、Array.filter() + indexOf 方案
该思路先将两个数组拼接,再利用 ES6 的 Array.filter() 遍历数组,并结合 indexOf 方法筛选出首次出现的元素以排除重复项。
function distinct(a, b) {
 let arr = a.concat(b);
 return arr.filter((item, index)=> {
 return arr.indexOf(item) === index
 })
}
这正是之前被质疑的方案,代码看似简洁,但实际运行效率堪忧。
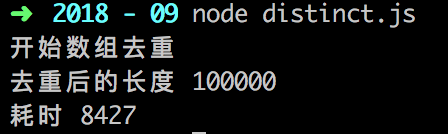
测试结果显示,处理长度为 15W 的数组耗时高达 8427ms。
双重 for 循环方案
三、双重 for 循环方案
这是最直观的实现方式:外层循环遍历元素,内层循环检查是否存在重复值。
发现重复元素时,可通过 push() 保留或 splice() 移除。
function distinct(a, b) {
 let arr = a.concat(b);
 for (let i=0, len=arr.length; i<len; i++) {
 for (let j=i+1; j<len; j++) {
  if (arr[i] == arr[j]) {
  arr.splice(j, 1);
  // splice 会改变数组长度,所以要将数组长度 len 和下标 j 减一
  len--;
  j--;
  }
 }
 }
 return arr
}
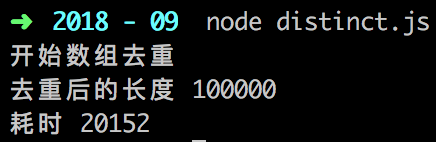
然而,该方法内存占用较高,且执行效率在所有对比方案中最低。
for...of + includes() 方案
四、for...of + includes() 方案
这是对双重 for 循环的改进版:外层使用 for...of 语句,内层改用 includes() 方法检查重复。
逻辑为先创建空数组,当 includes() 返回 false 时,将当前元素 push 至结果数组。
同样可以使用 indexOf() 替代 includes() 实现类似逻辑。
function distinct(a, b) {
 let arr = a.concat(b)
 let result = []
 for (let i of arr) {
 !result.includes(i) && result.push(i)
 }
 return result
}
该方案与 filter + indexOf 的思路相似。
区别在于将 filter() 的内部逻辑显式用 for 循环实现,并将 indexOf 替换为 includes。
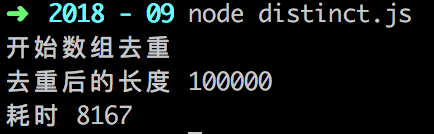
因此,其执行时长与 filter + indexOf 方案接近。
Array.sort() 排序方案
五、Array.sort() 排序方案
首先调用 sort() 对数组进行排序。
接着比较相邻元素是否相等,从而剔除重复项。
function distinct(a, b) {
 let arr = a.concat(b)
 arr = arr.sort()
 let result = [arr[0]]
 for (let i=1, len=arr.length; i<len; i++) {
 arr[i] !== arr[i-1] && result.push(arr[i])
 }
 return result
}
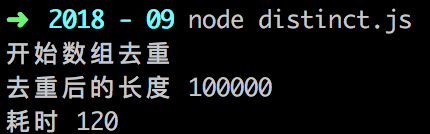
由于仅执行一次排序和一次循环,其效率优于前几种方法。
new Set() 方案
六、new Set() 方案
ES6 引入了 Set 数据结构,其成员具有唯一性,类似于数组但自动去重。
利用这一特性,Set 成为数组去重的理想选择。
function distinct(a, b) {
 return Array.from(new Set([...a, ...b]))
}
那么,使用 Set 处理 15W 数据需要多少时间?
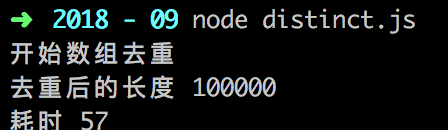
测试结果令人惊讶:仅需 57ms。
随后我将数组长度分别增加一个 0,即在 150W 的数据量下继续测试。
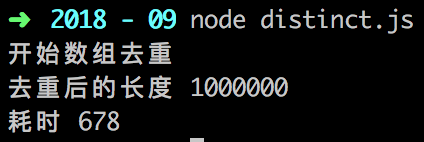
Set 展现了如此高性能且代码简洁的优势,令人印象深刻。
for...of + Object 方案
七、for...of + Object 方案
此方法多见于技术文章,实际工作中使用较少。
实现逻辑是创建空对象,利用 for 循环遍历数组。
借助对象属性名不重复的特性,校验数组元素是否已存在于对象中。
function distinct(a, b) {
 let arr = a.concat(b)
 let result = []
 let obj = {}
 for (let i of arr) {
 if (!obj[i]) {
  result.push(i)
  obj[i] = 1
 }
 }
 return result
}
查看该方法的测试结果后,结果同样令人意外。
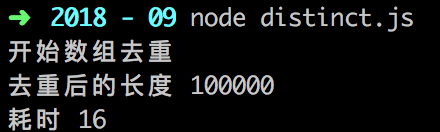
处理 15W 数据仅需 16ms,速度甚至快于 Set()。
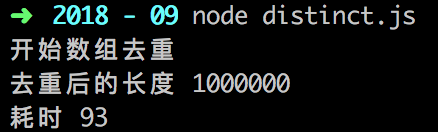
在 150W 数据量的测试中,该方法依然保持了优异的性能表现。
总结
总结
以上是对 JavaScript 高性能数组去重方法的详细分析与测试,希望能为读者提供有价值的参考。
UmiJS 项目构建速度优化与打包体积精简技巧
2026-11-04 22:37:09
原生JS操作DOM与Vue/React虚拟DOM的本质区别
2026-11-04 17:52:27
怎么使用console.group和table优化JS日志可读性
2026-11-03 23:14:34
基于AST抽象语法树的JS代码反混淆实战教程
2026-11-03 21:22:24
JS手机号输入校验的性能优化与用户体验提升
2026-11-03 19:19:19