详解webpack中的hash、chunkhash、contenthash区别
本文详细解析Webpack构建中hash、chunkhash与contenthash三种哈希策略的区别与应用场景。通过对比全项目hash、基于入口chunkhash及基于文件内容contenthash的生成机制,说明如何优化代码缓存策略,实现资源更新时精准失效,提升前端加载性能。
hash、chunkhash、contenthash
Webpack哈希策略概述
在Webpack构建流程中,哈希值通常与CDN缓存机制配合使用。构建完成后,生成的文件名会自动附加对应的MD5哈希值。当文件内容发生变化时,其哈希值随之改变,进而导致HTML中引用的URL地址更新。这一变化会触发CDN服务器从源站重新拉取数据,从而更新本地缓存。然而,在实际应用中,不同哈希类型的计算逻辑存在显著差异。
项目结构
为便于理解,我们构建一个简化的测试案例:入口文件index.js引用了index.css,同时引入jquery.js和test.js作为公共库。
//index.js

 require('./index.css')
 module.exports = function(){
  console.log(`I'm jack`)
  var a = 12
 }
//index.css

 .selected : {
   display: flex;
   transition: all .6s;
   user-select: none;
   background: linear-gradient(to bottom, white, black);
 }
接下来,通过修改webpack.config.js配置文件,模拟不同哈希类型的计算方式。
hash:全项目构建哈希
hash
hash基于整个项目的构建过程。只要项目中任意文件发生更改,整个项目的构建哈希值都会更新,且所有生成的文件将共用同一个hash值。
 var extractTextPlugin = require('extract-text-webpack-plugin'),
  path = require('path')

 module.exports = {
  context : path.join(__dirname,'src'),
  entry:{
  main: './index.js',
  vender:['./jquery.js','./test.js']
  },
  module:{
  rules:[{
   test:/\.css$/,
   use: extractTextPlugin.extract({
   fallback:'style-loader',
   use:'css-loader'
   })
  }]
  },
  output:{
  path:path.join(__dirname, '/dist/js'),
  filename: 'bundle.[name].[hash].js',
  },
  plugins:[
  new extractTextPlugin('../css/bundle.[name].[hash].css')
  ]
 }
依据上述配置执行webpack命令后,可获得如下结果。
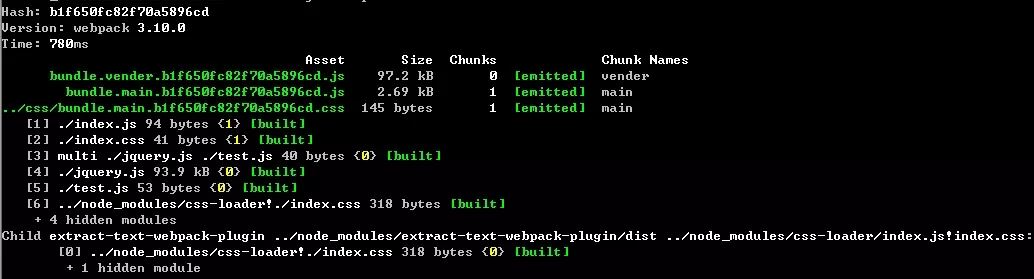
采用hash计算的执行结果1:
执行结果2:
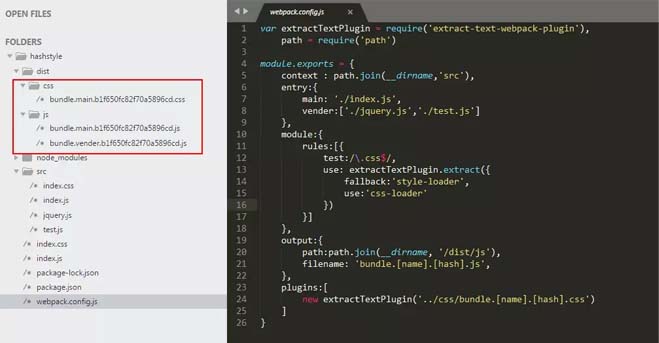
从构建生成的文件哈希值可以看出,它们完全一致。这证实了hash计算与整个项目构建紧密相关,同一次构建过程中生成的所有文件哈希值均相同。
chunkhash:基于入口文件的哈希
chunkhash
若使用hash策略,即使文件内容未发生任何改变,每次构建生成的哈希值也会不同。这种方式无法实现有效的缓存效果,因此需要引入另一种哈希计算方式,即chunkhash。
与hash不同,chunkhash根据每个入口文件(Entry)解析依赖并构建对应的chunk,进而生成独立的哈希值。在生产环境中,我们将公共库与程序入口文件区分开,单独打包构建。采用chunkhash生成哈希值后,只要公共库代码未改动,其哈希值就不会受到影响。
 var extractTextPlugin = require('extract-text-webpack-plugin'),
  path = require('path')

 module.exports = {
  ...
  ...
  output:{
  path:path.join(__dirname, '/dist/js'),
  filename: 'bundle.[name].[chunkhash].js',
  },
  plugins:[
  new extractTextPlugin('../css/bundle.[name].[chunkhash].css')
  ]
 }
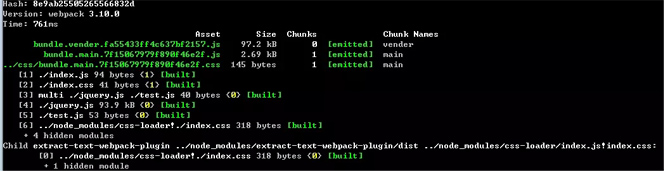
采用chunkhash计算的执行结果1:
执行结果2:
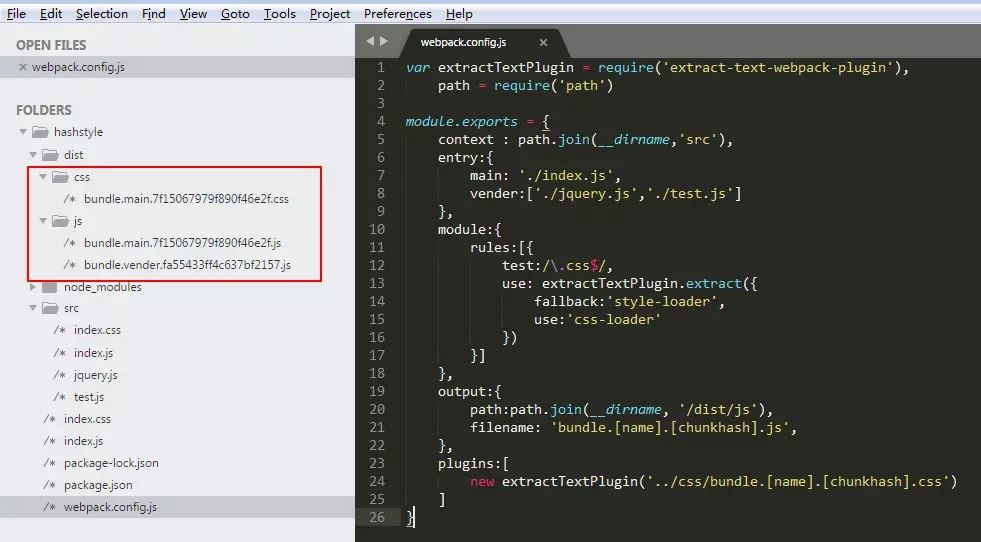
结果显示,由于采用chunkhash,项目主入口文件Index.js及其依赖的Index.css因打包在同一模块中,共用相同的chunkhash。而公共库因属于不同模块,拥有独立的chunkhash。这种机制确保了线上构建时,若文件内容未更改,则无需重复构建。
contenthash:基于文件内容的哈希
contenthash
在chunkhash示例中,由于index.css被index.js引用,二者共用相同的chunkhash值。但这带来一个问题:若index.js代码发生更改,即使css文件内容未变,由于所在模块发生变化,css文件仍会被重新构建。此时,可借助extract-text-webpack-plugin提供的contenthash值。即使同一模块内其他文件内容改变,只要css文件本身未变,就不会触发重复构建。
 var extractTextPlugin = require('extract-text-webpack-plugin'),
  path = require('path')

 module.exports = {
  ...
  ...
  output:{
  path:path.join(__dirname, '/dist/js'),
  filename: 'bundle.[name].[chunkhash].js',
  },
  plugins:[
  new extractTextPlugin('../css/bundle.[name].[contenthash].css')
  ]
 }
采用contenthash计算的执行结果1:
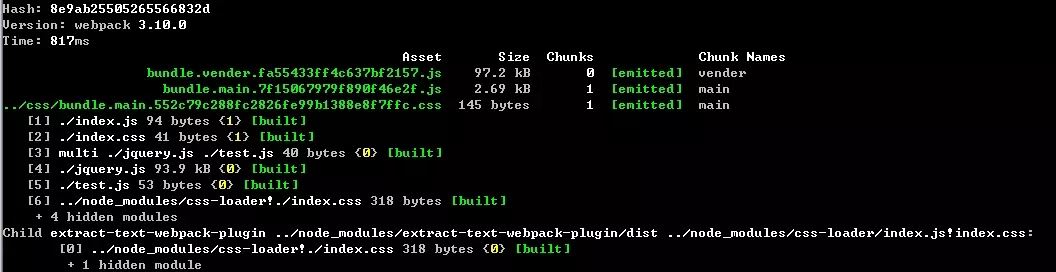
执行结果2:
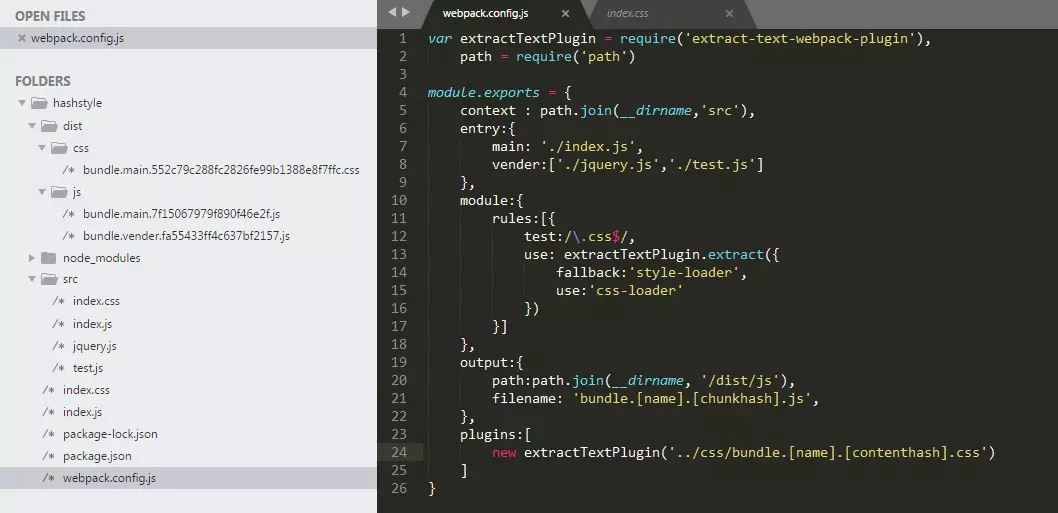
以上为本文全部内容,希望对您的学习有所帮助,也欢迎大家继续支持本站。
UmiJS 项目构建速度优化与打包体积精简技巧
2026-11-04 22:37:09
原生JS操作DOM与Vue/React虚拟DOM的本质区别
2026-11-04 17:52:27
怎么使用console.group和table优化JS日志可读性
2026-11-03 23:14:34
基于AST抽象语法树的JS代码反混淆实战教程
2026-11-03 21:22:24
JS手机号输入校验的性能优化与用户体验提升
2026-11-03 19:19:19