

JS解析.xls与.xlsx文件的兼容性差异
深入解析在JavaScript中解析.xls与.xlsx电子表格的底层格式差异、主流库兼容性表现、字符集编码坑点、内存与流式性能瓶颈,并提供高健壮性的魔数识别与自适应解析工程方案。
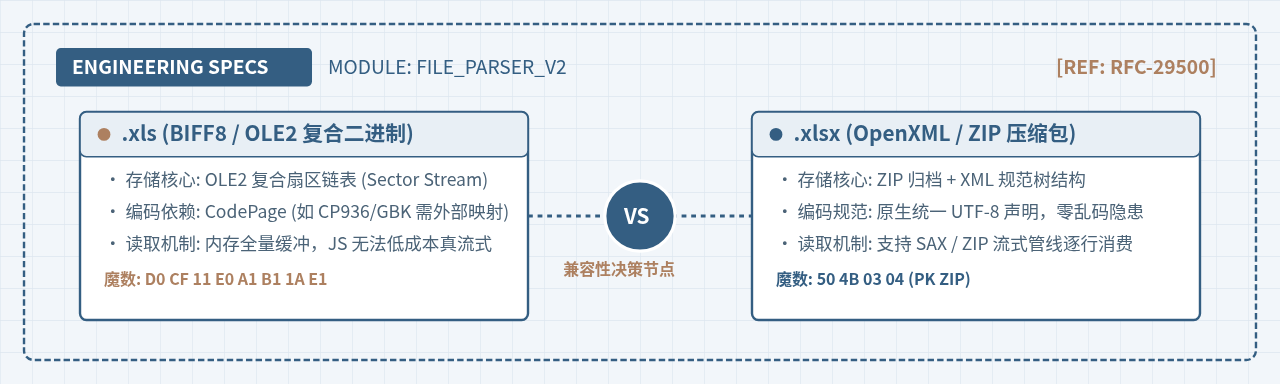
.xls 是基于微软专属复合二进制规范(BIFF8 / OLE2),而 .xlsx 则是基于国际标准 OpenXML 的 ZIP 压缩 XML 包。理解两者的格式差异、编码依赖、流式读取边界及主流库支持现状,是构建高可用、不崩溃的前端与服务端表格导入模块的关键。
一、底层存储结构对比:二进制扇区与压缩 XML 包
在编写任何 JavaScript 解析代码之前,首先需要明确 .xls 和 .xlsx 并不是简单的“新旧版本换了后缀”,它们在物理存储上的组织形式存在根本代差:
1. .xls 文件结构(BIFF8 与 OLE2 复合文档)
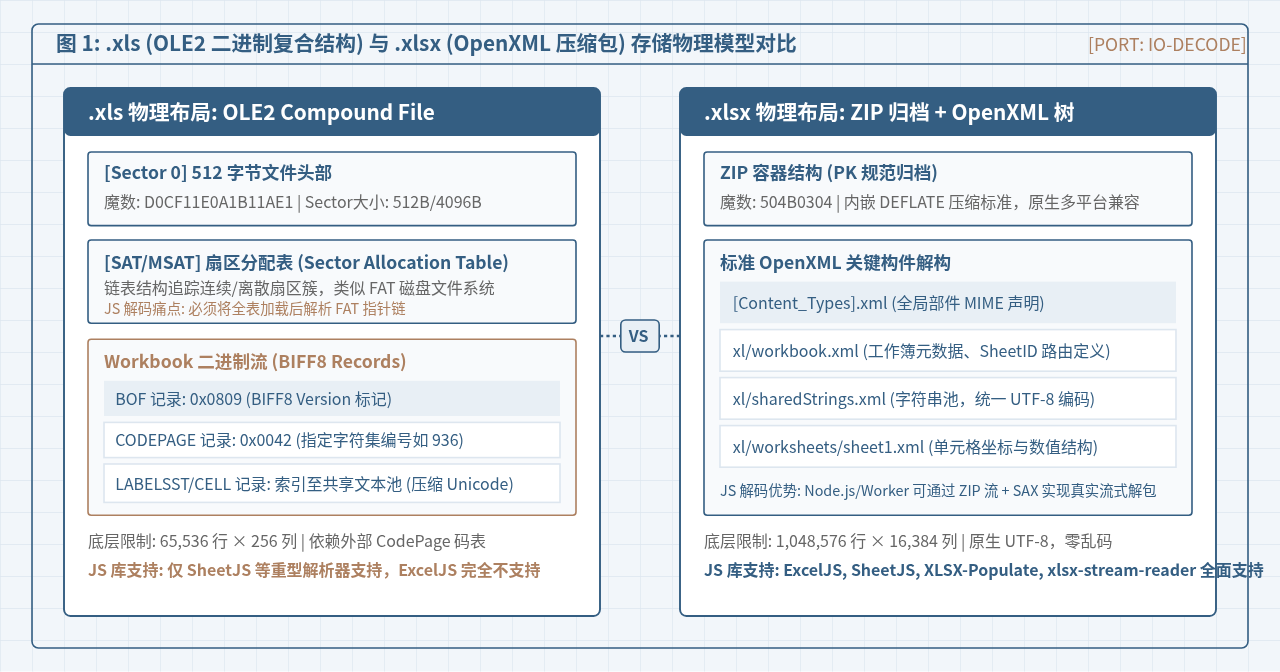
.xls 格式(主要为 Excel 97-2003 标准)基于 OLE2 复合文档规范(Structured Storage)。该规范将单个文件设计成一个微型的“虚拟磁盘文件系统”,内部划分为 512 字节或 4096 字节的扇区(Sector)。
在 OLE2 结构内部,通过 SAT(Sector Allocation Table,扇区分配表) 和 Directory Entries(目录项) 来索引数据流。真正记录表格数据的实体是 Workbook 字节流,采用 BIFF8(Binary Interchange File Format 8) 记录格式。每一个 BIFF8 记录均由 Record Type(2 字节) + Length(2 字节) + 二进制 Payload 构成。JavaScript 引擎若要解析它,必须先用纯 JS 模拟扇区链表寻址,再逐个解包二进制字节码。
2. .xlsx 文件结构(ISO/IEC 29500 OpenXML)
.xlsx(Excel 2007 至今的标准)采用 Office Open XML(OOXML) 开放标准。它在物理上是一个标准的 ZIP 归档容器。如果将一个 .xlsx 文件的后缀名改为 .zip 并直接解压,可以清晰看到内部的文件树结构:
[Content_Types].xml:定义整个压缩包内所有构件(Part)的 MIME 类型映射关系。_rels/.rels:顶层关系清单,指定工作簿的入口指针。xl/workbook.xml:包含工作表清单(Sheet 名、r:id、状态等元数据)。xl/worksheets/sheet1.xml:存储具体行(<row>)与单元格(<c>)的行列坐标与数值。xl/sharedStrings.xml:全局共享字符串池,所有单元格文本统一存放在此,单元格只记录索引序号。
二、核心维度差异:编码、内存与流式性能
底层结构的代差,直接映射到 JavaScript 运行时的几个关键技术瓶颈上:
1. 字符集编码与乱码风险
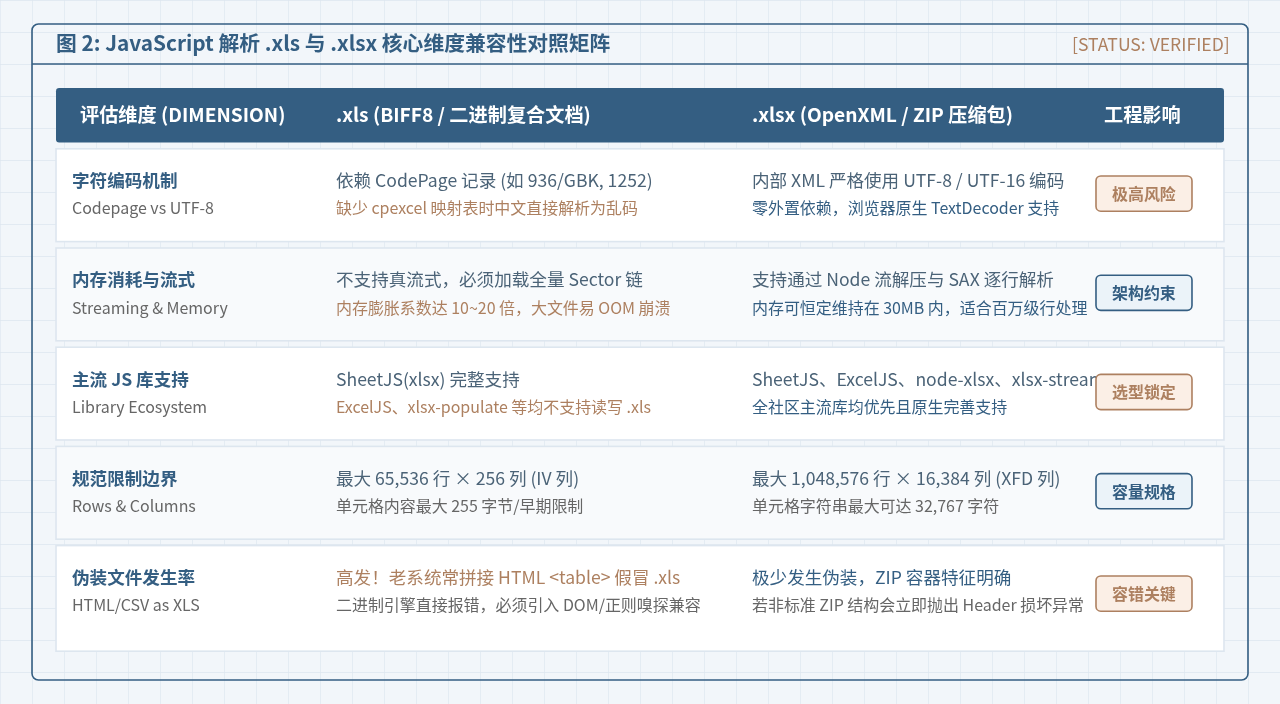
在 .xlsx 中,所有内部 XML 文件强制要求声明并使用 UTF-8 或 UTF-16 编码。浏览器与 Node.js 拥有原生的 TextDecoder 支持,解码过程几乎不会产生乱码,也不需要任何外置字符映射包。
但在 .xls 中,文本可能以旧式的 CodePage(代码页) 编码存储。例如,中文环境下生成的 .xls 内部记录包含 CODEPAGE (0x0042),对应 Windows-936(GBK)或 CP1252。如果前端只加载了轻量解析器而缺少 cpexcel 映射库,中文字符串在转换为 Unicode 时将发生不可逆的乱码。
xlsx.full.min.js),内部已打包了多国语言代码页支持;但如果使用现代化微型打包或按需引入的模块,必须确认是否单独挂载了 cpexcel.js 码表,否则读取旧版 .xls 的中文内容时将解析为乱码或空白。
2. 内存占用与流式解析(Streaming)
在业务场景中,当导入的 Excel 达到数万行甚至数十万行时,两者的内存表现差距巨大:
-
.xls 无法做真正的流式读取:
由于 OLE2 复合文档的扇区链表(SAT)通常分散在整个文件各处,且 BIFF8 的字符串池(SST 记录)往往需要在全表加载后才能完成指针关联。解析器必须将整个文件的
ArrayBuffer全部载入内存,并构建完整的虚拟扇区映射。这使得在前端解析一个 15MB 的.xls文件时,内存峰值常会膨胀至数百兆,极易触发浏览器的 OOM 甚至导致页面崩溃。 -
.xlsx 支持高能效流式扫描:
由于
.xlsx是纯 ZIP 归档,Node.js 服务端或浏览器 Web Worker 可以利用zlib解压流配合 SAX / Pull XML 解析器,以事件驱动的形式逐行读取<row>节点。每读取完一行即可将数据落库或流式消费并交由 GC 回收,使得处理 100 万行数据的内存开销恒定维持在 30MB 左右。
三、主流 JS 库的兼容性表现与选型陷阱
在选型解析库时,许多团队常犯的错误是将各类 Excel 库混为一谈,直到生产环境出现 Zip signature not found 报错才发现不兼容:
| 库名称 | .xlsx 支持情况 | .xls 支持情况 | 典型适用场景与限制 |
|---|---|---|---|
| SheetJS (xlsx) | 完整支持 (读/写) | 完整支持 (BIFF8/BIFF5) | 全格式兼容的首选库。缺点是体积极大,新版本 CDN 商业闭源化,开源旧版存在维护滞后。 |
| ExcelJS | 完整支持 (读/写/流式) | 完全不支持 | 现代化、类型完善、流式支持优异。传入 .xls 会直接抛出解包异常。 |
| xlsx-populate | 完整支持 (读/写/模板) | 完全不支持 | 专注于 .xlsx 模板替换与样式处理,底层依赖 JSZip。 |
| node-xlsx | 支持 | 支持 (内部封装 SheetJS) | 本质是 SheetJS 的薄层封装,行为与 SheetJS 一致。 |
ExcelJS 作为核心库,必须在前端上传或后端接收的第一道关卡设置校验,拒绝 .xls 格式,或者通过服务端无头 Office 转换服务先将其转换为 .xlsx,否则系统必然报错。
四、标准化解析实施方案:魔数嗅探与分支路由
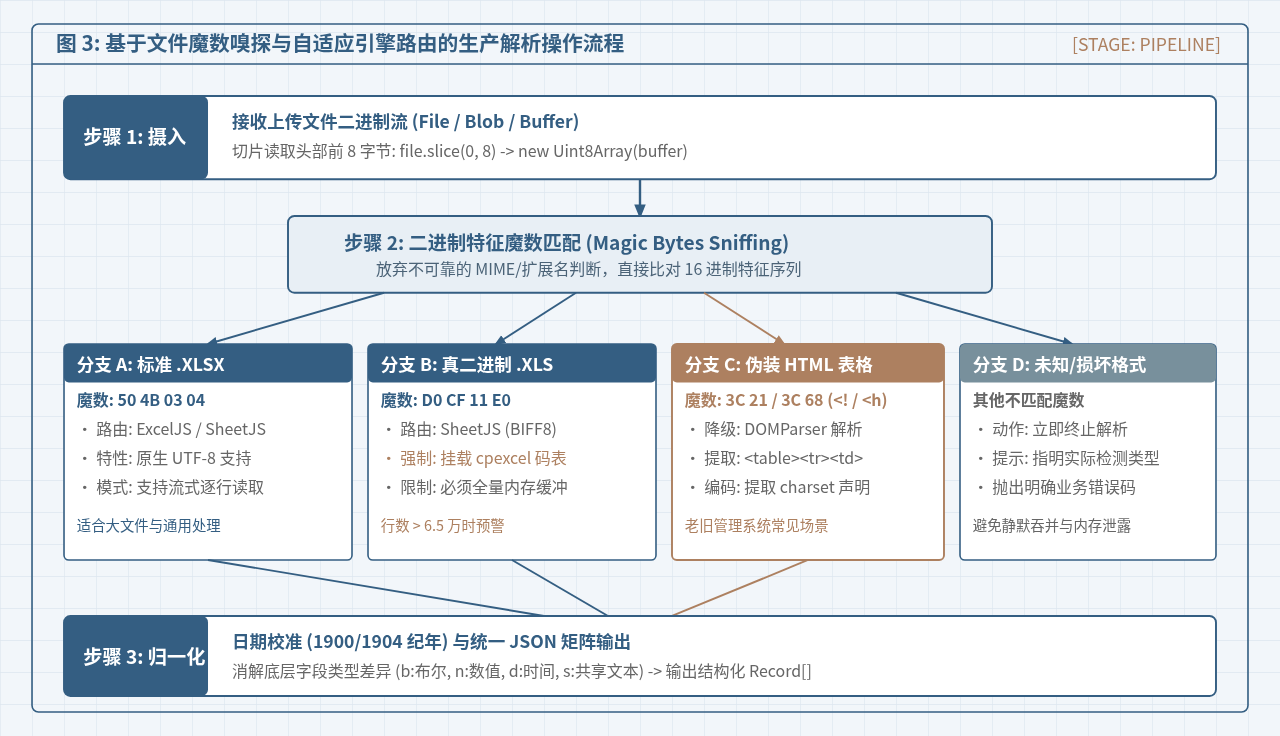
在实际生产环境中,不能单纯依赖文件扩展名(.xls 或 .xlsx)以及 MIME 类型。很多老旧业务系统或第三方报表直接把 HTML <table> 或逗号分隔 CSV 文件重命名为 .xls 导出。如果将伪装的 HTML 传给二进制 BIFF8 解析器,必然会抛出格式非法异常。
稳妥的工程做法是读取文件开头的前 8 个字节(Magic Bytes),通过二进制特征码进行自适应路由分发:
完整实现:文件类型嗅探与自适应解析器
以下代码给出了在现代浏览器与 Node.js 均可复用的核心检测与解析逻辑:
/**
 * 提取文件前 8 字节并转换为十六进制特征字符串
 * @param {ArrayBuffer} buffer
 * @returns {string} 16进制大写字符串
 */
function getFileHeaderHex(buffer) {
  const bytes = new Uint8Array(buffer.slice(0, 8));
  return Array.from(bytes)
    .map(b => b.toString(16).padStart(2, '0').toUpperCase())
    .join('');
}

/**
 * 识别电子表格实际底层类型
 * @param {ArrayBuffer} buffer
 * @returns {'xlsx' | 'xls' | 'html_fake_xls' | 'unknown'}
 */
function detectSpreadsheetType(buffer) {
  const hex = getFileHeaderHex(buffer);

  // 1. 标准 ZIP 格式 (PK..) -> .xlsx
  if (hex.startsWith('504B0304')) {
    return 'xlsx';
  }

  // 2. OLE2 复合二进制规范 -> .xls (BIFF8)
  if (hex.startsWith('D0CF11E0A1B11AE1')) {
    return 'xls';
  }

  // 3. HTML 伪装表格 (<!DOCTYPE 或 <html)
  // 3C 21 = <!, 3C 68 = <h, 3C 48 = <H
  if (hex.startsWith('3C21') || hex.startsWith('3C68') || hex.startsWith('3C48')) {
    return 'html_fake_xls';
  }

  return 'unknown';
}

/**
 * 通用安全导入解析函数 (需引入 SheetJS 或相应引擎)
 * @param {File} file 用户上传的 File 对象
 */
async function parseExcelSafe(file) {
  const arrayBuffer = await file.arrayBuffer();
  const fileType = detectSpreadsheetType(arrayBuffer);

  switch (fileType) {
    case 'xlsx': {
      // .xlsx 格式: 既可用轻量 ExcelJS,也可直接用 SheetJS
      return parseViaSheetJS(arrayBuffer, { type: 'array' });
    }

    case 'xls': {
      // 真实 .xls: 必须使用具备 BIFF8 解析能力的 SheetJS,并确保码表就绪
      return parseViaSheetJS(arrayBuffer, { type: 'array', codepage: 936 });
    }

    case 'html_fake_xls': {
      // 降级处理: 历史遗留系统导出的 HTML Table
      console.warn('检测到伪装成 .xls 的 HTML 报表,启用 HTML DOM 解析分支');
      const textDecoder = new TextDecoder('utf-8');
      const htmlText = textDecoder.decode(arrayBuffer);
      return parseHtmlTableToRows(htmlText);
    }

    default: {
      throw new Error(`不支持的文件格式,检测到二进制头: ${getFileHeaderHex(arrayBuffer)}`);
    }
  }
}

// SheetJS 标准调用与行归一化
function parseViaSheetJS(data, options) {
  if (typeof XLSX === 'undefined') {
    throw new Error('当前环境未加载 SheetJS (XLSX) 核心库');
  }
  const workbook = XLSX.read(data, options);
  const firstSheetName = workbook.SheetNames[0];
  const worksheet = workbook.Sheets[firstSheetName];

  // 转换为二维数组或对象矩阵,raw: false 可自动应用数字与日期格式
  return XLSX.utils.sheet_to_json(worksheet, { header: 1, defval: '' });
}

// HTML 降级解析
function parseHtmlTableToRows(htmlText) {
  const parser = new DOMParser();
  const doc = parser.parseFromString(htmlText, 'text/html');
  const table = doc.querySelector('table');
  if (!table) throw new Error('未在伪装文件中检测到有效 <table> 节点');

  const rows = [];
  table.querySelectorAll('tr').forEach(tr => {
    const row = [];
    tr.querySelectorAll('td, th').forEach(cell => {
      row.push(cell.textContent.trim());
    });
    if (row.length > 0) rows.push(row);
  });
  return rows;
}
五、工程架构与生产选型决策
在实际项目落地时,应当根据系统所面对的用户环境和性能要求,采取对应的架构策略:
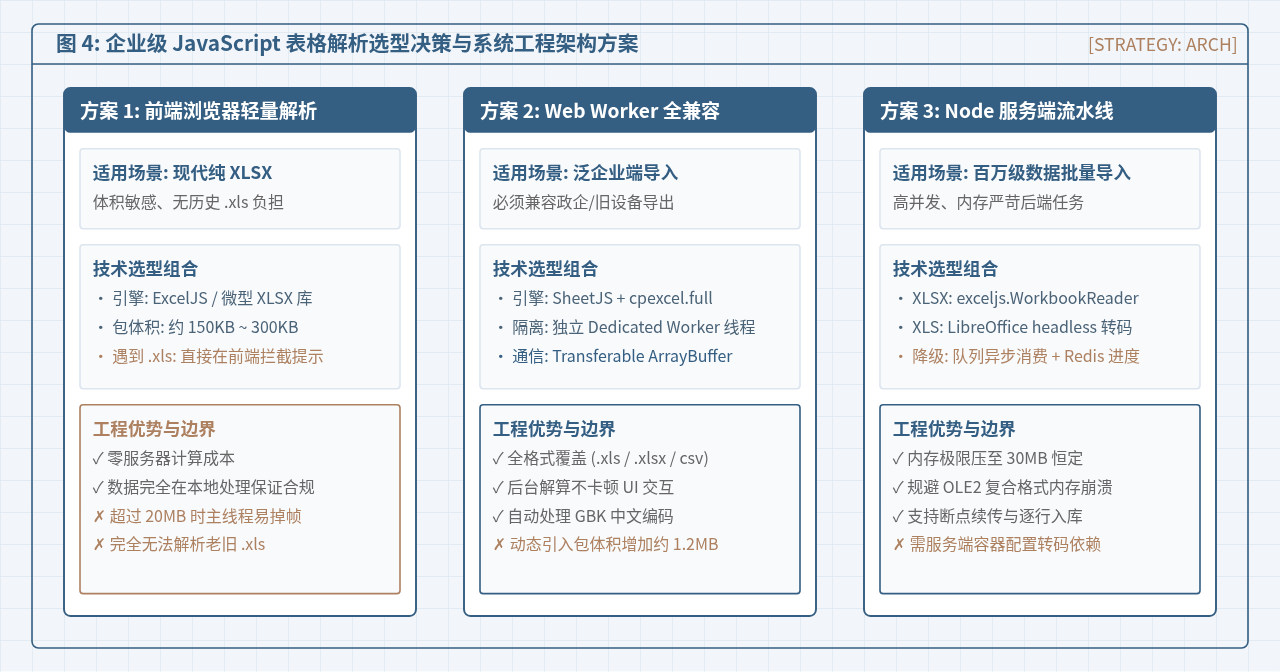
1. 现代化纯 Web 方案(推荐,业务无旧版包袱)
如果应用面向一般互联网用户或企业内部办公,建议在产品层面强制统一使用 .xlsx。前端使用 ExcelJS 或轻量解析库,并在 <input type="file" accept=".xlsx"> 处过滤。如果用户上传 .xls,前端在魔数校验阶段直接拦截并友好提示:“请将文件另存为 .xlsx 格式后再上传”。这种策略可以使前端 bundle 体积节省 80% 以上,并彻底消除 OLE2 内存泄漏与乱码隐患。
2. 政企与历史系统兼容方案(Web Worker 隔离)
在涉及政企客户、传统制造业、老旧医疗或工业仪器导出的场景中,.xls 是不可规避的客观存在。此时应当采用 Dedicated Web Worker 隔离架构:
- 将
SheetJS和cpexcel放置在 Worker 线程中运行,主线程仅负责文件选择和进度展示。 - 通过
worker.postMessage(arrayBuffer, [arrayBuffer])使用 Transferable Objects 传递数据,避免在主线程中产生二次内存复制。 - Worker 完成解析后,将轻量的 JSON 结构回传给主线程渲染。即使遇到异常结构导致 Worker 内存过高,也不会引起主页面卡死。
3. 海量数据流水线方案(Node.js 服务端转码流)
当数据行数达到数十万级别时,任何在浏览器端解析 .xls 的尝试都可能导致弱机崩溃。此时最优解是将文件流式推送到 Node.js 后端:
- 对于
.xlsx,直接使用exceljs.WorkbookReader进行事件驱动的流式消费,每行解析完成后批量插入数据库。 - 对于
.xls,由于其本身无法突破 65,536 行规范限制,可先在服务端通过无头工具(如 LibreOffice Headless 或 Gotenberg 微服务)快速异步转换为.xlsx,再接入统一的高性能流式处理管道。
总结
.xls 与 .xlsx 之间的差异绝不仅仅是文件扩展名或新旧版本的差异,而是 OLE2 复合二进制 与 OpenXML ZIP 包 两种底层技术体系的代差。在 JavaScript 开发中:
- 库支持上:
ExcelJS仅支持.xlsx,要兼顾.xls必须引入具备 BIFF8 能力的引擎(如SheetJS)。 - 编码处理上:
.xlsx原生 UTF-8 免除配置,而.xls必须关注 CodePage 码表挂载,防范中文乱码。 - 性能控制上:
.xls需全量加载扇区,严防前端 OOM;.xlsx则能够利用流式 SAX 解析支撑高并发大数据。 - 健壮性上:切勿仅凭文件扩展名判断格式,必须依托二进制魔数嗅探(
504B0304与D0CF11E0)构建自适应分流通道,确保系统在复杂边界下的高鲁棒性。
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13
相关标签:







