为什么 JSON.parse(JSON.stringify) 无法完美深拷贝?
深入剖析为什么使用 JSON.parse(JSON.stringify) 进行 JavaScript 深拷贝会出现数据丢失、类型降级、特殊数值篡改及循环引用抛错,并提供原生 structuredClone 和工业级递归方案。
JSON.parse(JSON.stringify(obj)) 复制对象是许多人最早接触的深拷贝写法。这种方法利用了“先把对象转为 JSON 文本,再将文本重新解析为全新对象”的特性来切断原始引用。然而,这种技巧无法称作真正的“完美深拷贝”。其根本原因在于:JSON 是一套独立于语言的文本数据交换格式,它只支持基础标量类型的极小子集,并不具备表达 JavaScript 丰富运行时内存模型的能力。在序列化与反序列化的闭环中,它会产生静默属性丢失、类型降级退化、特殊数值篡改,甚至在遭遇循环引用与 BigInt 时直接抛错崩溃。
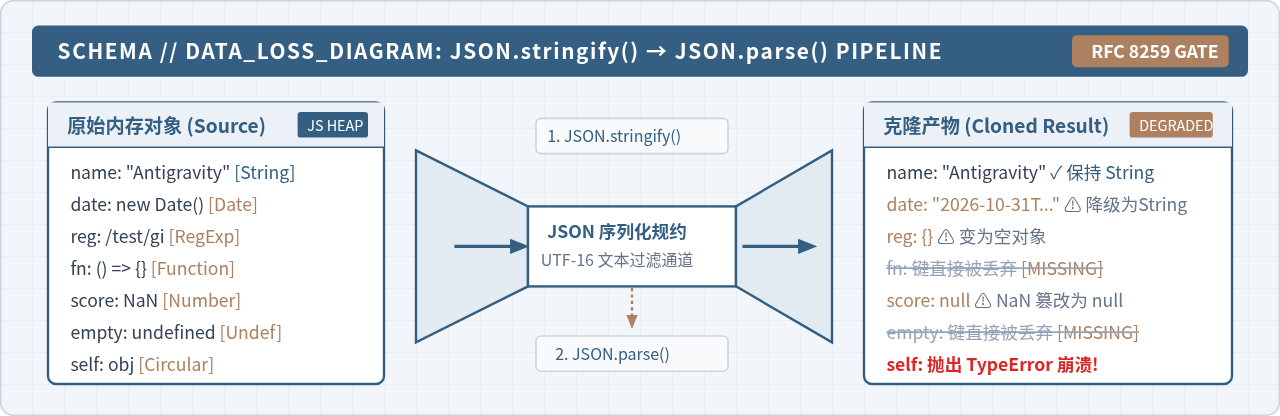 图 0:JSON.parse(JSON.stringify) 深拷贝漏斗模型与数据漏损全貌
一、执行原理:JSON 序列化流水线如何“清洗”内存对象
要弄清楚数据为何在拷贝后失真,首先需要了解引擎在执行序列化时经历的处理阶段。当开发者调用 JSON.stringify(value) 时,ECMAScript 规范定义的抽象操作 SerializeJSONProperty 将依次对目标对象执行多层递归清洗与格式投影。
在这个流水线中,JavaScript 运行时中的活体内存对象被强制压缩为纯静态的 UTF-16 文本字符串。任何无法在 RFC 8259 规范中找到直接对应语法的语言特性,都必须在这一步完成妥协:要么被静默抹除,要么被强制转换降级。反序列化阶段的 JSON.parse() 则仅能依据字符串中的有限词法记号(Token)重构最普通的通用 Object 与 Array,原始对象的类型元信息、方法函数和原型链在中间文本态生成的一瞬间就已经彻底蒸发。
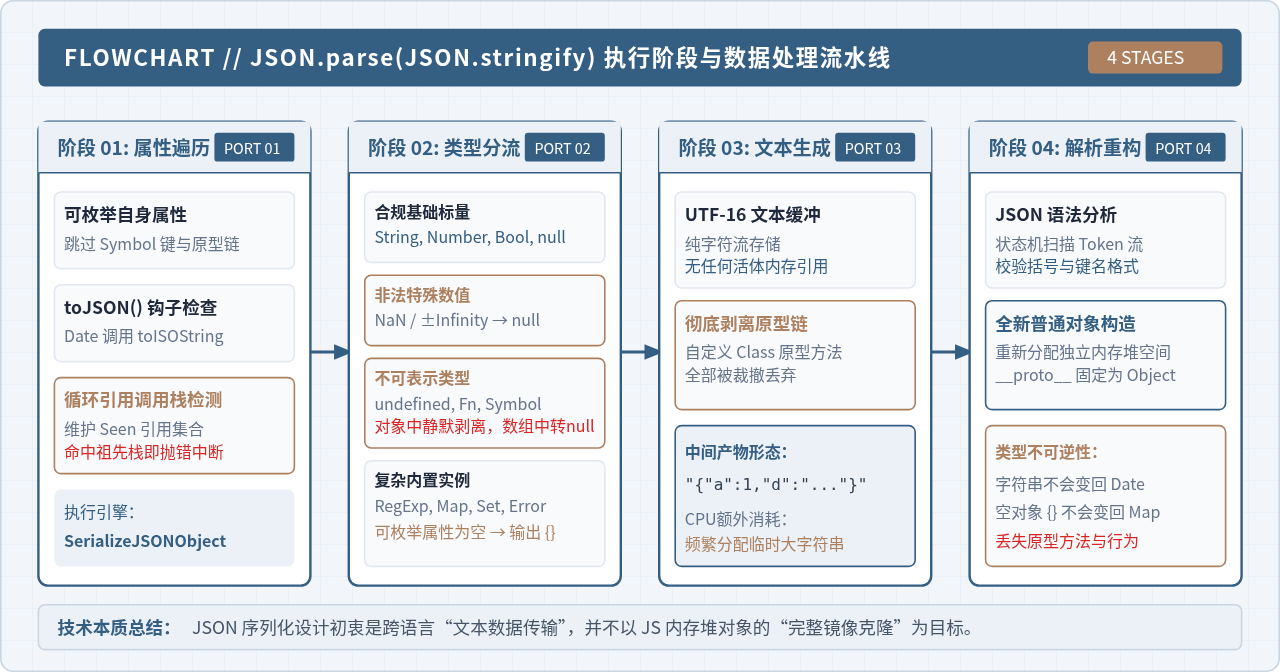 图 1:JSON.parse(JSON.stringify) 执行阶段与数据处理流水线
二、核心缺陷实测:六大失真与崩溃场景剖析
为了直观展现这一过程中的数据损失,我们通过具体的代码测试,按破坏程度逐一拆解六大核心缺陷。
1. 类型静默丢失与键过滤(undefined、Function、Symbol)
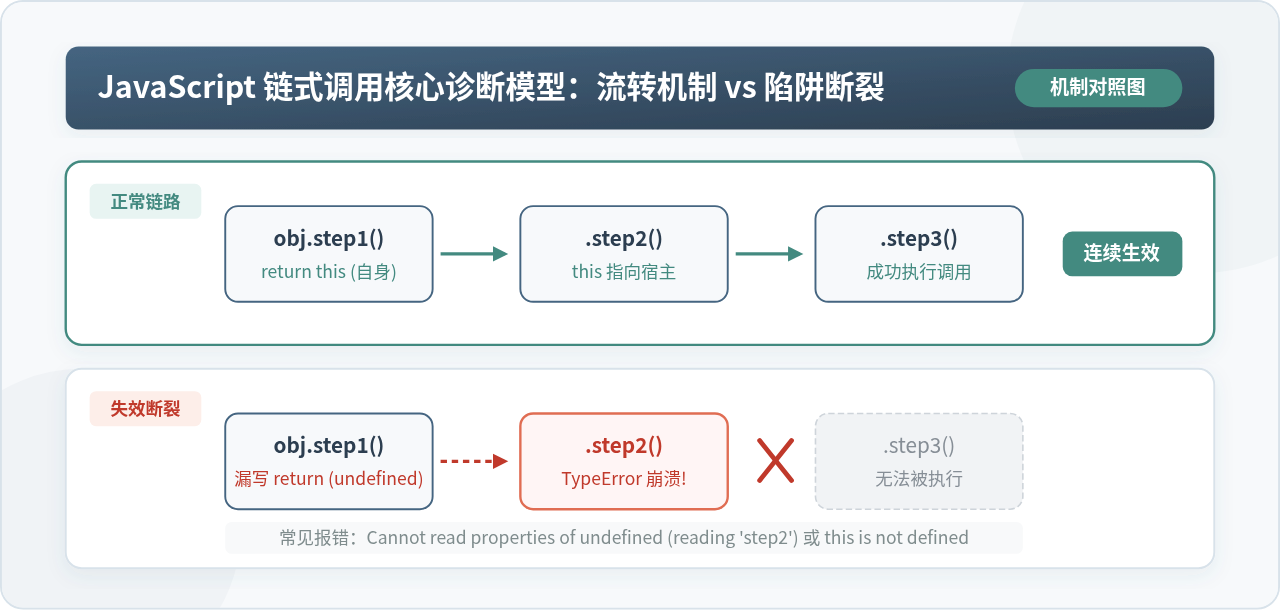
JSON 规范中不存在 undefined、函数(Function)以及 ECMAScript 6 引入的 Symbol。当对象的属性值为这三者时,JSON.stringify 会直接忽略这些键值对;而当它们作为数组的元素存在时,为了保持数组下标索引不被错位,引擎会将其强制替换为 null。
const source = {
  name: "Antigravity",
  action: function() { console.log("running"); },
  extra: undefined,
  symValue: Symbol("secret"),
  [Symbol("key")]: "symbolKeyContent",
  list: [1, undefined, function() {}, Symbol("arr"), 5]
};

const copy = JSON.parse(JSON.stringify(source));
console.log(copy);{
name: "Antigravity",
list: [1, null, null, null, 5]
}
// 注意:action、extra、symValue 属性完全消失;
// Symbol 属性名 [Symbol("key")] 直接被跳过;
// list 数组项中的 undefined、函数与 Symbol 被强行篡改为 null。2. 特殊数值被篡改为 null(NaN、Infinity、-Infinity)
在 IEEE 754 浮点数标准中,NaN、Infinity 与 -Infinity 属于合法的 Number 类型。但是 JSON 规范为了确保跨语言实现的通用性,只接受常规十进制有限数值(RFC 8259 Section 6)。任何无法表示的特殊数值,都会在序列化时被强行替换为 null。
const metrics = {
  score: NaN,
  maxLimit: Infinity,
  minLimit: -Infinity,
  normal: 100
};

const clonedMetrics = JSON.parse(JSON.stringify(metrics));
console.log(clonedMetrics);{
score: null,
maxLimit: null,
minLimit: null,
normal: 100
}
// 原本用于指示计算溢出或无效状态的数值,反序列化后沦为普通的 null。3. 高级内置对象退化与数据置空(Date、RegExp、Map、Set)
JavaScript 提供了大量专用的内置构造器,它们在经过 JSON 管道后无一例外会发生退化甚至状态蒸发:
- Date 实例:
Date.prototype默认内置了toJSON()方法,其返回 ISO 8601 格式的字符串(如"2026-10-31T11:48:00.000Z")。当反序列化时,JSON.parse()只会将其当作普通字符串,丢失所有的 Date 原型方法(例如copy.time.getFullYear()将直接抛出 TypeError 异常)。 - RegExp 与 Error 实例:序列化时只会遍历它们自身的可枚举属性,由于正则表达式的规则和标志存储在内置私有槽中,序列化产物直接退化为空对象
{}。 - Map 与 Set 集合:键值对并非对象的常规键,全部存储在内部映射表中,序列化后同样退化为
{},数据完全丢失。
const complexData = {
  createTime: new Date("2026-10-31T08:00:00Z"),
  validator: /^[a-z]+$/gi,
  tags: new Set(["frontend", "javascript"]),
  cache: new Map([["key1", "val1"]])
};

const copy = JSON.parse(JSON.stringify(complexData));
console.log("createTime 类型:", typeof copy.createTime, "值:", copy.createTime);
console.log("validator:", copy.validator);
console.log("tags:", copy.tags);
console.log("cache:", copy.cache);createTime 类型: string 值: 2026-10-31T08:00:00.000Z
validator: {}
tags: {}
cache: {}
// 结论:Date 变为了 string,正则表达式与集合数据全部置空!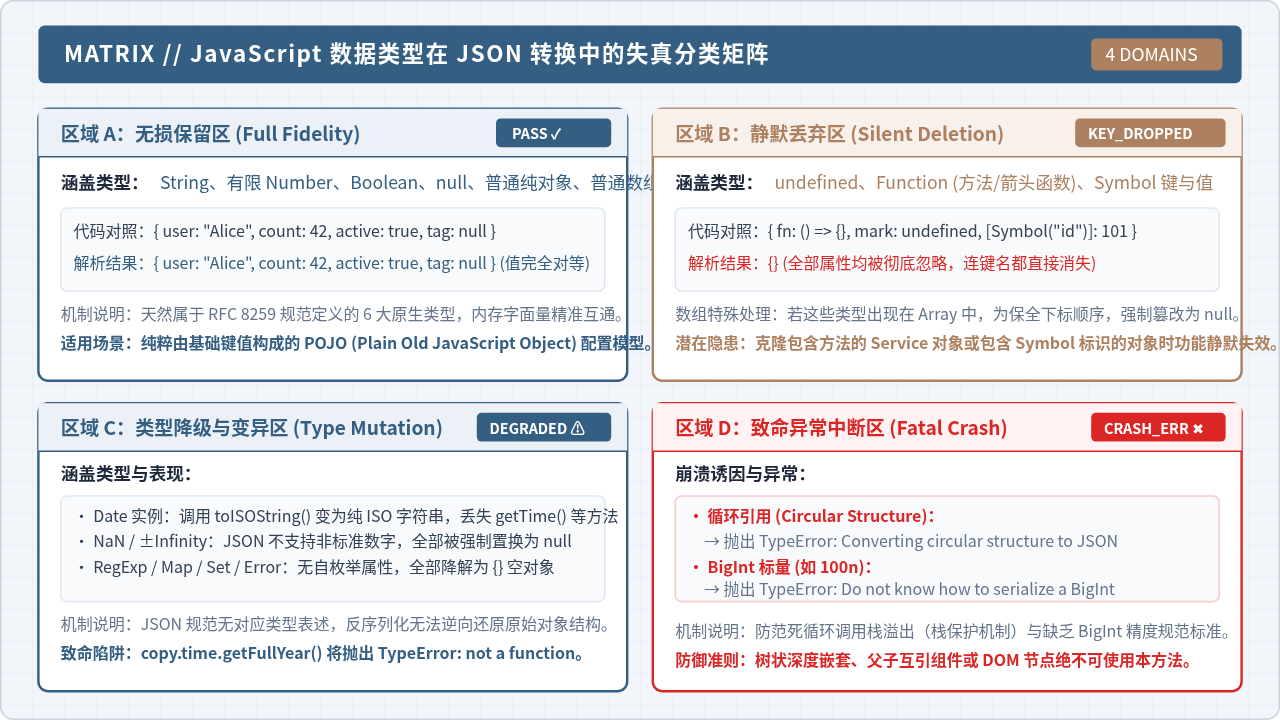 图 2:JavaScript 数据类型在 JSON 序列化中的失真分类矩阵
4. 循环引用导致程序抛错崩溃(TypeError)
在复杂的应用或组件树中,对象之间常常存在父子双向引用或自身引用。当把包含循环引用的对象传递给 JSON.stringify 时,由于序列化过程采用递归遍历,若不设防将导致调用栈无限溢出。因此,JavaScript 引擎在内部维护了激活栈对象集合(Seen Objects),一旦检测到目标对象正在处于调用路径中,便会立即中断并抛出未捕获异常:TypeError: Converting circular structure to JSON。
const parent = { title: "RootNode" };
const child = { name: "ChildNode", parentRef: parent };
parent.childRef = child; // 构成循环引用:parent -> child -> parent

try {
  JSON.parse(JSON.stringify(parent));
} catch (err) {
  console.error("捕获到致命异常:", err.message);
}捕获到致命异常: Converting circular structure to JSON
--> starting at object with constructor 'Object'
| property 'childRef' -> object with constructor 'Object'
--- property 'parentRef' closes the circle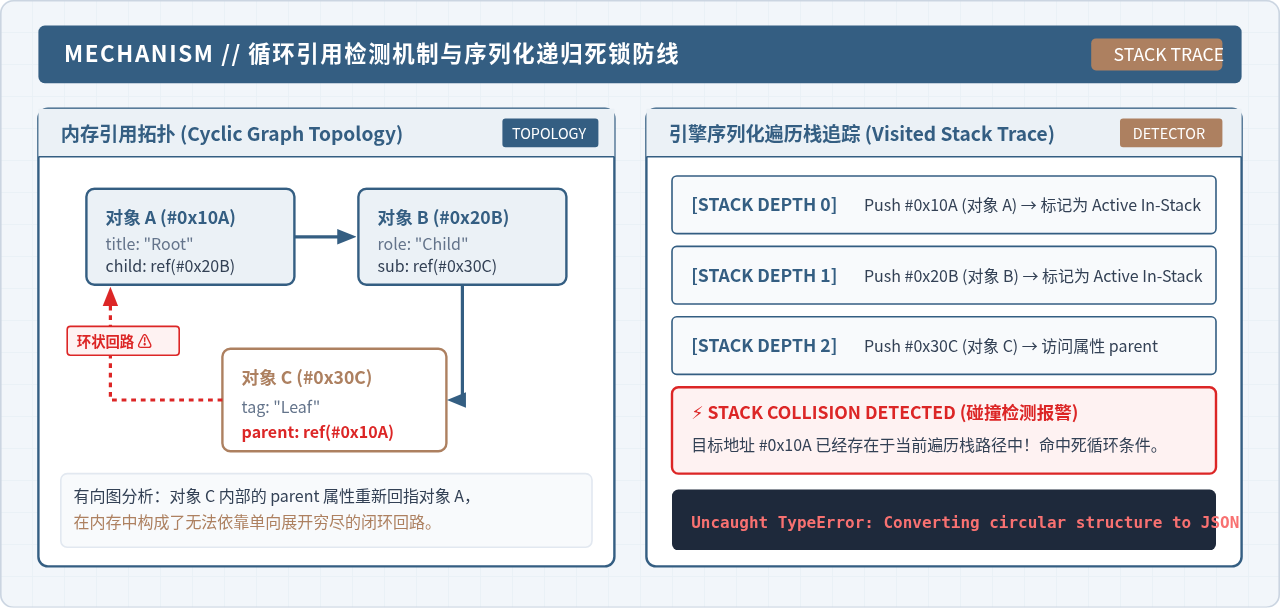 图 3:循环引用检测机制与序列化递归死锁防线
5. BigInt 标量序列化直接报错
随着现代 JavaScript 广泛处理高精度 ID 与密码学运算,BigInt(例如 9007199254740993n)的使用越来越普遍。然而 JSON 规范中所有数值均对应 IEEE 754 双精度浮点数,直接将 BigInt 序列化会导致不可逆的精度截断。为了避免隐式精度破坏,ECMAScript 规范强制规定:遇到 BigInt 时不可默认转换,必须直接抛出 TypeError: Do not know how to serialize a BigInt。
6. 原型链丢失与不可枚举属性被忽略
深拷贝许多时候针对的是领域模型类(Domain Class)的实例。通过 class 或构造函数实例化的对象,其方法通常挂载在原型链(prototype)上。另外,通过 Object.defineProperty() 将 enumerable 设为 false 的私密字段同样属于对象的固有组成部分。
而 JSON.stringify() 仅收集对象自身的可枚举属性(enumerable: true)。经过解析后,新对象的隐式原型指针(__proto__)无条件指向最顶层的 Object.prototype,原有的自定义原型方法、Getter/Setter 存取器以及不可枚举属性统统荡然无存。
三、深拷贝的最佳替代方案与选型实践
既然 JSON.parse(JSON.stringify) 存在如此多的边界陷阱,在实际工程中我们应当如何安全、稳健地完成深拷贝任务?
方案 1:优先采用现代原生标准 structuredClone()
自 HTML 规范标准化并在各大引擎普及后,原生提供的 structuredClone() 已经成为现代 JavaScript 环境下的首选深拷贝方案(Chrome 98+、Node.js 17.0.0+、Firefox 94+、Safari 15.4+ 全面内置)。
structuredClone() 采用结构化克隆算法(Structured Clone Algorithm),运行在浏览器或 Node.js 底层,原生支持循环引用、Date、RegExp、Map、Set、ArrayBuffer、TypedArray 等绝大多数复杂内置类型,执行效率远高于文本序列化。
const origin = {
  date: new Date(),
  pattern: /^[0-9]+$/g,
  map: new Map([["status", "active"]]),
  set: new Set([1, 2, 3]),
  scores: [98, 100]
};
// 构造自引用
origin.self = origin;

// 原生深拷贝
const copy = structuredClone(origin);

console.log(copy.date instanceof Date); // 输出: true (保留Date原型)
console.log(copy.map.get("status"));    // 输出: "active" (保留Map)
console.log(copy.self === copy); // 输出: true (完美还原循环引用关系)尽管功能强大,structuredClone() 依旧不支持克隆函数(遇到 Function 会抛出 DataCloneError)、不支持 DOM 节点克隆,并且同样不会保留自定义类的原型链。
方案 2:工业级手写递归深拷贝(基于 WeakMap 解决循环引用)
如果在兼容老旧环境(如旧版 Node 或老式 WebView)、或者需要定制克隆策略(如保留函数引用、处理原型链)时,编写一个基于 WeakMap 的轻量递归函数是最稳妥的做法:
function deepClone(target, hash = new WeakMap()) {
  // 1. 处理 null 或基本标量类型
  if (target === null || typeof target !== "object") {
    return target;
  }

  // 2. 检查循环引用:若已存在映射,直接返回对应副本
  if (hash.has(target)) {
    return hash.get(target);
  }

  // 3. 处理 Date 与 RegExp 特殊实例
  if (target instanceof Date) return new Date(target);
  if (target instanceof RegExp) return new RegExp(target.source, target.flags);

  // 4. 处理 Map 与 Set
  if (target instanceof Set) {
    const resultSet = new Set();
    hash.set(target, resultSet);
    target.forEach(val => resultSet.add(deepClone(val, hash)));
    return resultSet;
  }
  if (target instanceof Map) {
    const resultMap = new Map();
    hash.set(target, resultMap);
    target.forEach((val, key) => resultMap.set(deepClone(key, hash), deepClone(val, hash)));
    return resultMap;
  }

  // 5. 保持原型链,创建新对象或数组
  const cloneTarget = Array.isArray(target)
    ? []
    : Object.create(Object.getPrototypeOf(target));

  // 记录到 WeakMap 中,防止循环嵌套死锁
  hash.set(target, cloneTarget);

  // 6. 递归遍历包含 Symbol 在内的所有自身可枚举属性
  const keys = Reflect.ownKeys(target);
  for (const key of keys) {
    const desc = Object.getOwnPropertyDescriptor(target, key);
    if (desc && desc.enumerable) {
      cloneTarget[key] = deepClone(target[key], hash);
    }
  }

  return cloneTarget;
}
方案 3:成熟工业库(lodash.cloneDeep)
在企业级大型项目中,如果已经引入了 Lodash,直接使用 lodash.cloneDeep 是经过社区十余年考验的成熟选择。它兼顾了各种极端边界类型、TypedArray、Buffer 以及类数组对象的处理。
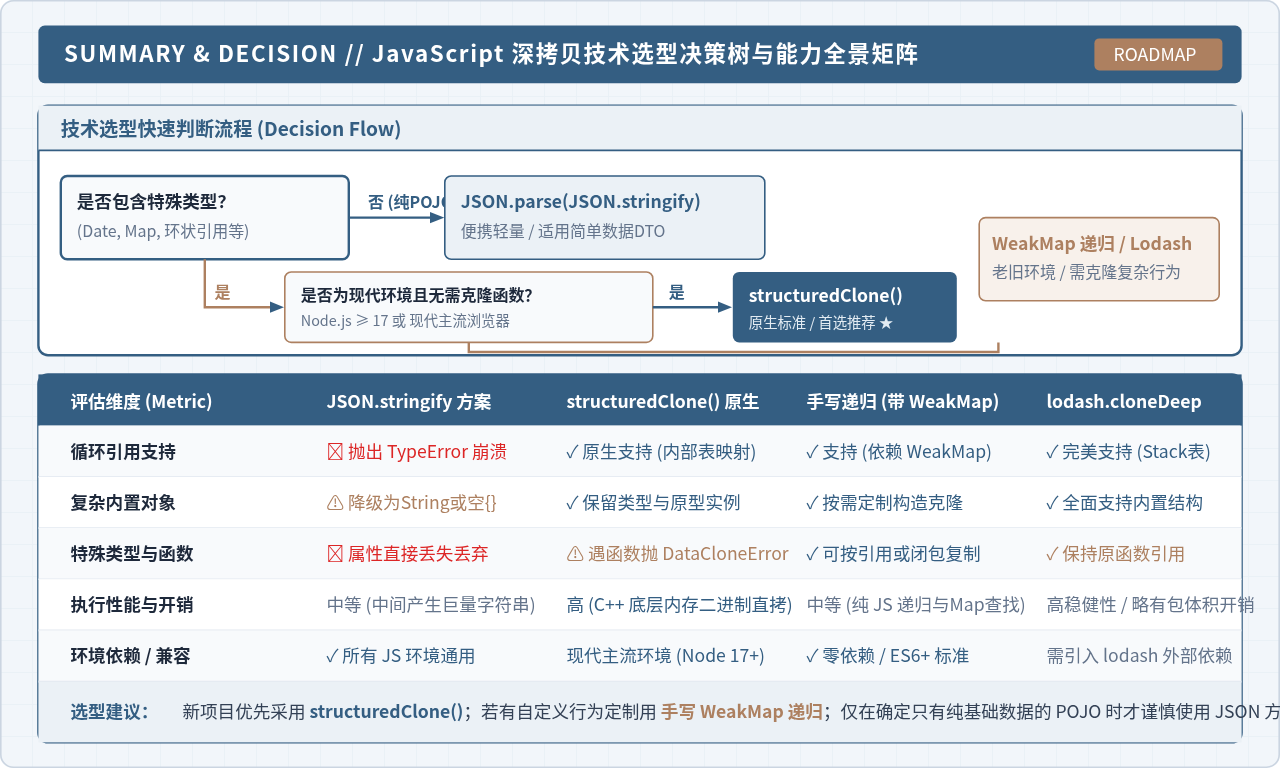 图 4:JavaScript 深拷贝技术选型决策树与能力全景矩阵
四、工程准则:什么时候依然可以使用 JSON 深拷贝?
虽然 JSON.parse(JSON.stringify) 无法胜任“万能深拷贝”,但并不意味着必须将其彻底废弃。只要开发者清晰掌握其适用边界,在满足以下条件的场景中,它依然具有语法简洁、无需依赖、零学习成本的实用价值:
| 核对条件 | 具体特征说明 | 判断结论 |
|---|---|---|
| 纯数据配置对象 | 仅由字符串、普通数字、布尔值及 null 组成的平铺结构(POJO) | 推荐使用 |
| 网络 API 响应副本 | 原本就是从后端接口接收到的标准 JSON 响应数据,需在前端进行无副作用修改 | 安全可用 |
| 包含计算逻辑的对象 | 对象内部附带方法函数、Getter 存取器或原型链挂载行为 | 严禁使用 (方法丢失) |
| 包含时序与集合对象 | 存在 Date 实例、Map、Set 或 RegExp | 禁止使用 (类型退化) |
| 树状双向或自引用 | 父子节点双向引用、状态机图状对象或 DOM 关联结构 | 绝对禁止 (抛错崩溃) |
总结而言,深拷贝的本质是“在独立内存空间中完整镜像源对象的状态与语义”。了解 JSON.parse(JSON.stringify) 的失真边界,既能帮助我们在遭遇数据异变、TypeError 时快速定位根因,也能促使我们在新项目中优先采用标准原生的 structuredClone(),写出更健壮、可维护的前端代码。
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13
相关标签: