

JS怎么从任意URL字符串中提取查询参数
全面介绍在现代 JavaScript 中如何从任意 URL 字符串(包含绝对路径、相对路径、SPA Hash 路由及纯查询参数串)中提取查询参数的具体方法、代码示例、边界考量与通用函数封装。
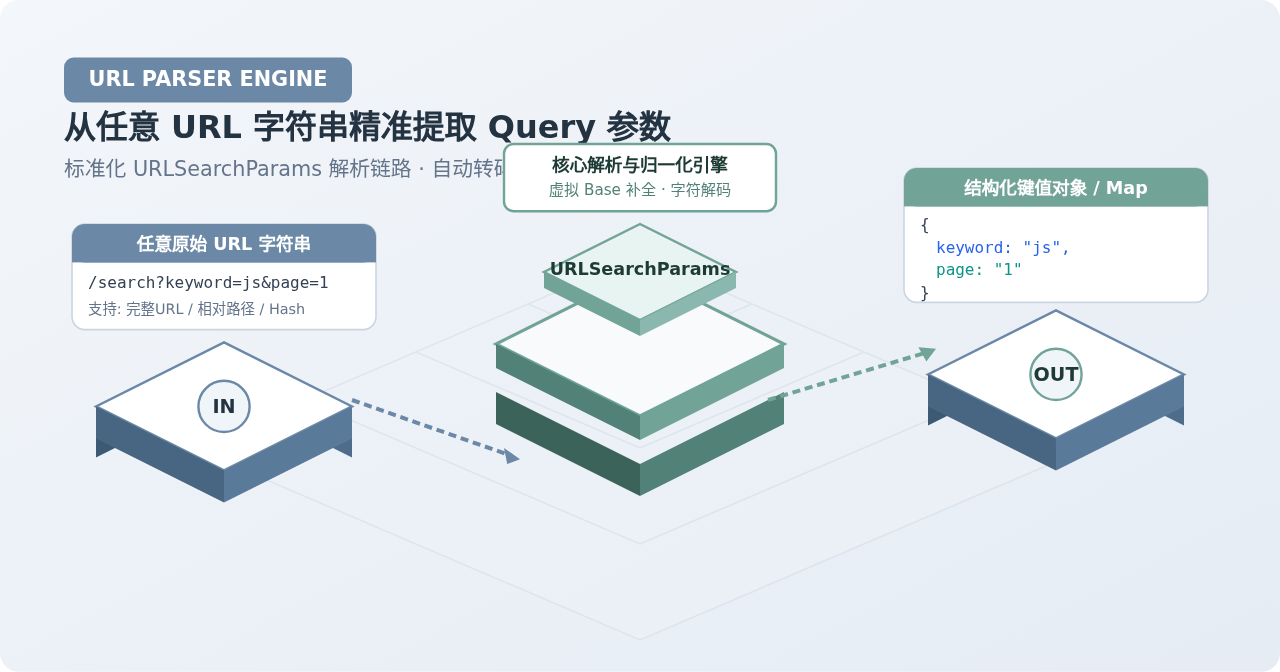
URL 和 URLSearchParams。无论传入的是完整网络地址、相对路径、仅有问号的参数片段,还是单页应用(SPA)的哈希路由,只要理清 URL 的结构分界,就能零外部依赖完成高精度解析。
一、核心基石:URL 与 URLSearchParams API
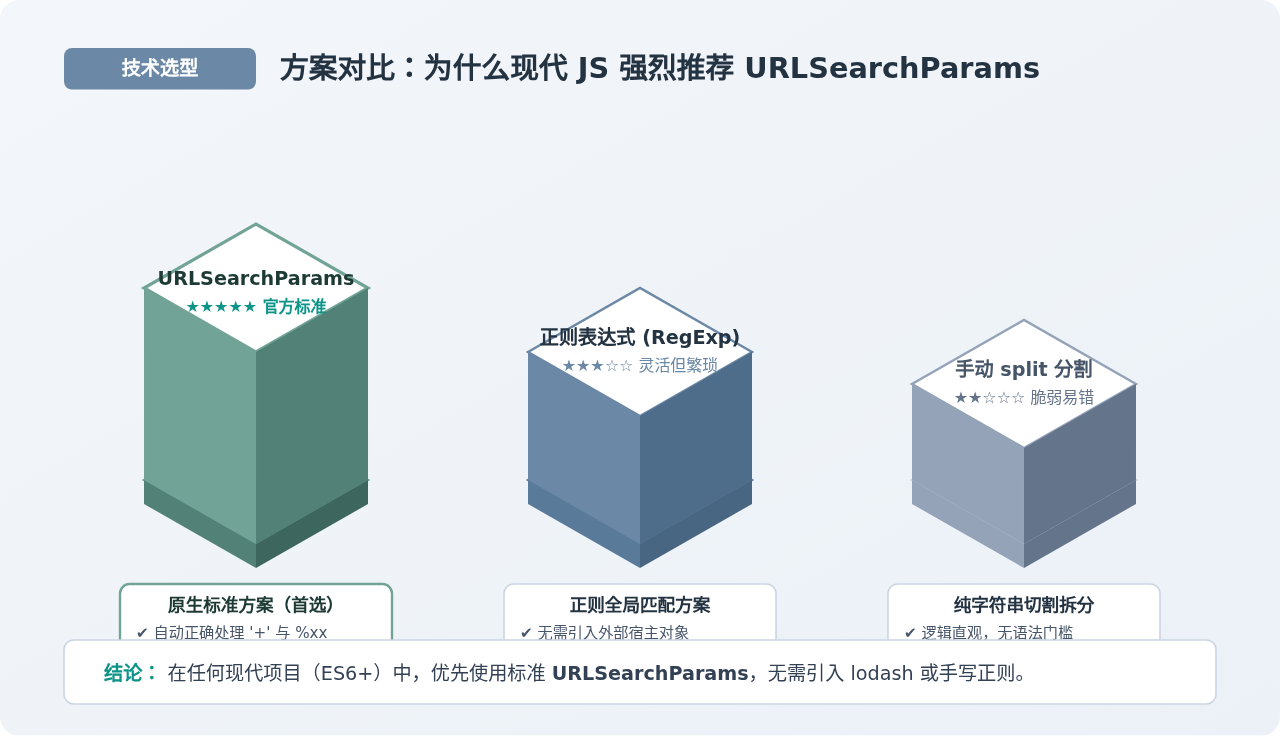
在现代浏览器以及 Node.js(v10+)环境中,处理 URL 参数已经无需手写复杂的正则表达式或自行字符串切分。标准库提供了两个专门处理此类场景的全局对象:
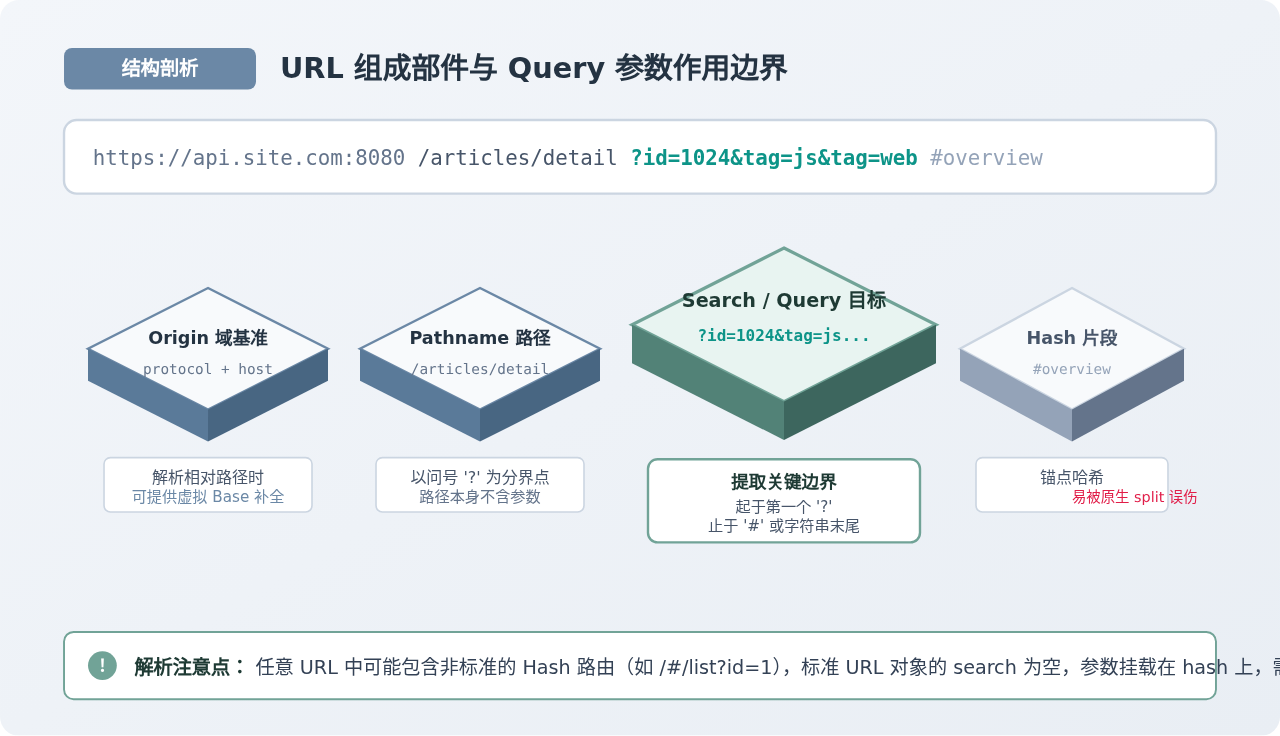
URL:负责解析合法的完整 URL 字符串,将协议(protocol)、域名(host)、路径(pathname)、查询参数(search)与哈希片段(hash)解构成独立的属性。URLSearchParams:专门用于读取、遍历和操作查询字符串(Query String),原生支持编码还原、同名多值获取以及键值对遍历。
1. 针对标准绝对 URL 的基本用法
如果手头拿到的是形如 https://example.com/api?id=1024&type=article 的完整绝对 URL,直接调用 new URL(urlStr) 即可通过其实例的 searchParams 属性进行操作:
// 示例 1:解析标准绝对 URL
const rawUrl = "https://example.com/search?keyword=javascript&page=2&tag=web&tag=frontend";
const parsed = new URL(rawUrl);

// 1. 获取单个参数值(若存在多个同名参数,get() 只返回第一个)
const keyword = parsed.searchParams.get("keyword");
const page = parsed.searchParams.get("page");

// 2. 获取同名参数数组
const tags = parsed.searchParams.getAll("tag");

// 3. 判断某个参数是否存在
const hasSort = parsed.searchParams.has("sort");page: "2"
tags: ["web", "frontend"]
hasSort: false
二、面对“任意”URL 字符串时的四种场景与解决方案
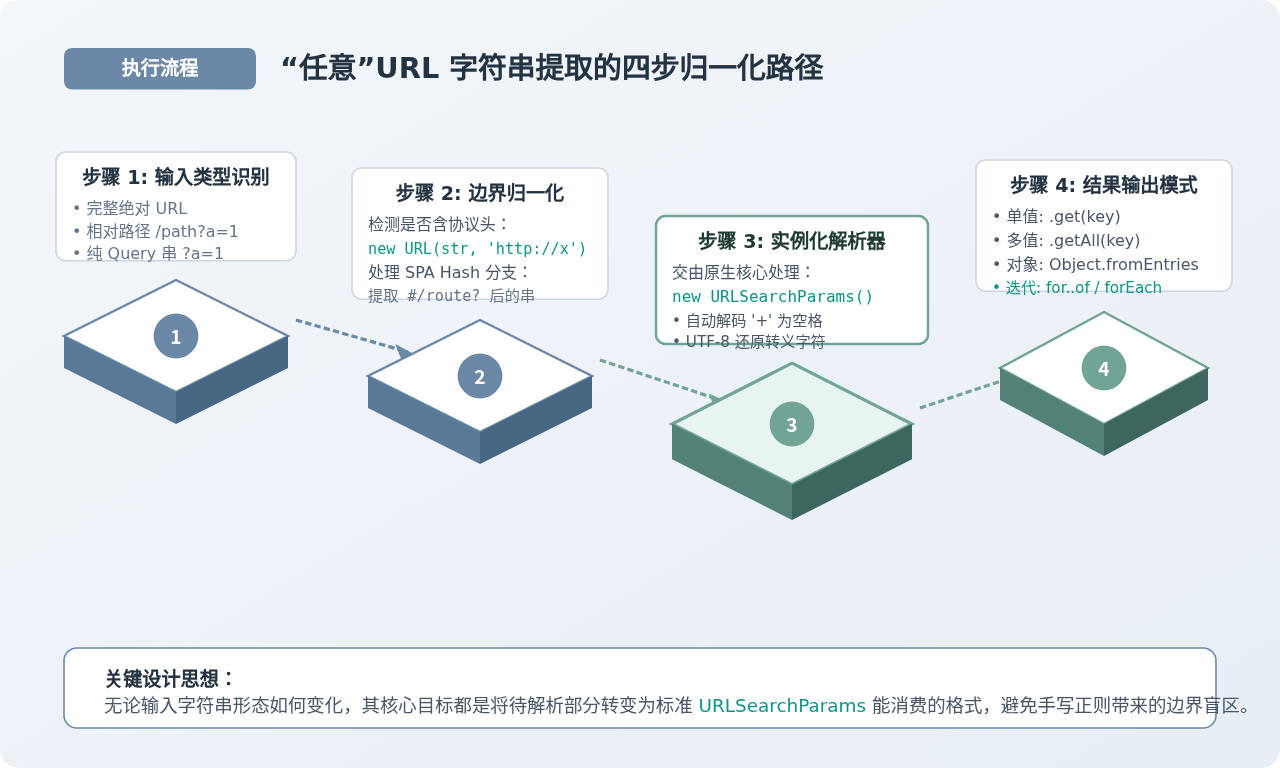
在实际项目开发中,后端接口、本地缓存或第三方回传的字符串往往并不都是合规的绝对 URL。标题中所强调的“任意 URL 字符串”,常见的变体包括:相对路径、纯参数串、带 Hash 锚点的地址,以及同名参数。
场景 1:相对路径或缺少协议前缀(例如 /detail?id=10)
直接对相对路径执行 new URL("/detail?id=10") 会立即抛出 TypeError: Invalid URL 异常,因为 URL 构造函数强制要求提供协议和域名。
解决方案:为构造函数传入第二个参数 base。通过注入一个虚拟的基础域(如 http://dummy.local),使构造函数能够正常实例化,而这完全不影响对路径中 searchParams 的解析:
const relativePath = "/articles/view?cat=tech&mode=compact";

// 传入虚拟 base 域名进行适配
const urlObj = new URL(relativePath, "http://dummy.base");
console.log(urlObj.searchParams.get("cat")); // 输出: tech
场景 2:纯查询字符串(例如 ?a=1&b=2 或 a=1&b=2)
如果输入的字符串本身就是查询参数片段,无需经过 URL 对象包装,可以直接将其直接传给 URLSearchParams。
URLSearchParams 会自动忽略开头的问号 ?:
const queryStringWithQuestion = "?source=google&campaign=spring";
const params1 = new URLSearchParams(queryStringWithQuestion);
console.log(params1.get("source")); // 输出: google

const queryStringPlain = "status=active&limit=50";
const params2 = new URLSearchParams(queryStringPlain);
console.log(params2.get("limit")); // 输出: 50
场景 3:单页应用(SPA)Hash 路由中的参数
在使用 Vue Router 或 React Router 的 Hash 模式(形如 https://site.com/#/user/profile?userId=8848&from=dash)时,很多开发者会发现 new URL(url).search 竟然是空字符串 ""。
这是因为在 W3C 标准中,# 号后面的所有字符全部归属于 hash,浏览器的 URL 解析器不会将 # 后出现的 ? 视作全局 search。
解决方案:提取 hash 中问号之后的部分,再交给 URLSearchParams:
const hashUrl = "https://app.com/#/dashboard?theme=dark&lang=zh";
const url = new URL(hashUrl);

// 此时 url.search 是空字符串,参数被包含在 url.hash 中
const hashQueryIndex = url.hash.indexOf("?");
const hashQuery = hashQueryIndex !== -1
  ? url.hash.slice(hashQueryIndex + 1)
  : "";

const hashParams = new URLSearchParams(hashQuery);
console.log(hashParams.get("theme")); // 输出: dark
场景 4:将提取结果转换为通用 Plain Object 对象
在业务代码中,我们通常希望获得一个常规的 JavaScript 对象(如 { id: '10', type: 'article' }),便于后续解构或传参。
对于没有同名键的常规场景,Object.fromEntries(params.entries()) 是最快捷的代码写法:
const params = new URLSearchParams("name=tom&role=admin");
const obj = Object.fromEntries(params.entries());
// 结果: { name: "tom", role: "admin" }Object.fromEntries 在遇到同名参数(例如 ?tag=a&tag=b)时,只会保留最后一个值。若业务中存在同名参数收集为数组的需求,请使用后文介绍的通用提取函数。
三、通用封装:开箱即用的参数提取函数
综合上述各种现实环境中的不确定性,下面提供一个经过严格容错验证的通用工具函数 getQueryParams。
该函数能够通吃绝对地址、相对路径、纯参数串、SPA Hash 路径,并对同名参数自动聚合为数组返回:
/**
 * 从任意 URL 字符串中提取查询参数为结构化对象
 * @param {string} url - 任意 URL 字符串或 query 字符串
 * @returns {Record<string, string | string[]>} 提取出的参数键值对象
 */
function getQueryParams(url) {
  if (!url || typeof url !== "string") {
    return {};
  }

  let searchString = "";

  // 1. 若字符串以 ? 开头或不含常见 URL 路径标识,优先尝试作为纯查询串
  if (url.startsWith("?")) {
    searchString = url.slice(1);
  } else {
    try {
      // 2. 使用虚拟基准域名构建 URL 对象,自动支持相对路径与绝对地址
      const parsed = new URL(url, "http://dummy.base");

      // 优先取标准 search
      searchString = parsed.search.slice(1);

      // 3. 如果 search 为空但 hash 中含有问号,处理 SPA Hash 路由场景
      if (!searchString && parsed.hash.includes("?")) {
        searchString = parsed.hash.split("?")[1] || "";
      }
    } catch (err) {
      // 4. 极端异常格式降级:截取第一个 ? 到 # 之间的内容
      const qIndex = url.indexOf("?");
      if (qIndex !== -1) {
        const rawPart = url.slice(qIndex + 1);
        searchString = rawPart.split("#")[0];
      } else {
        searchString = url;
      }
    }
  }

  const params = new URLSearchParams(searchString);
  const result = {};

  // 5. 遍历并智能处理同名键(转为数组)
  for (const [key, value] of params.entries()) {
    if (!Object.prototype.hasOwnProperty.call(result, key)) {
      result[key] = value;
    } else if (Array.isArray(result[key])) {
      result[key].push(value);
    } else {
      result[key] = [result[key], value];
    }
  }

  return result;
}
测试用例与验证结果
// 用例 1:带同名重复参数的绝对 URL
getQueryParams("https://example.com/api?tag=js&tag=node&status=1");
// 示例输出: { tag: ['js', 'node'], status: '1' }

// 用例 2:带特殊字符编码与加号的相对路径
getQueryParams("/search?q=hello+world&lang=%E4%B8%AD%E6%96%87");
// 示例输出: { q: 'hello world', lang: '中文' }

// 用例 3:SPA Hash 路由地址
getQueryParams("https://site.org/#/user?userId=998&role=editor");
// 示例输出: { userId: '998', role: 'editor' }

// 用例 4:纯 Query 片段
getQueryParams("?single=true");
// 示例输出: { single: 'true' }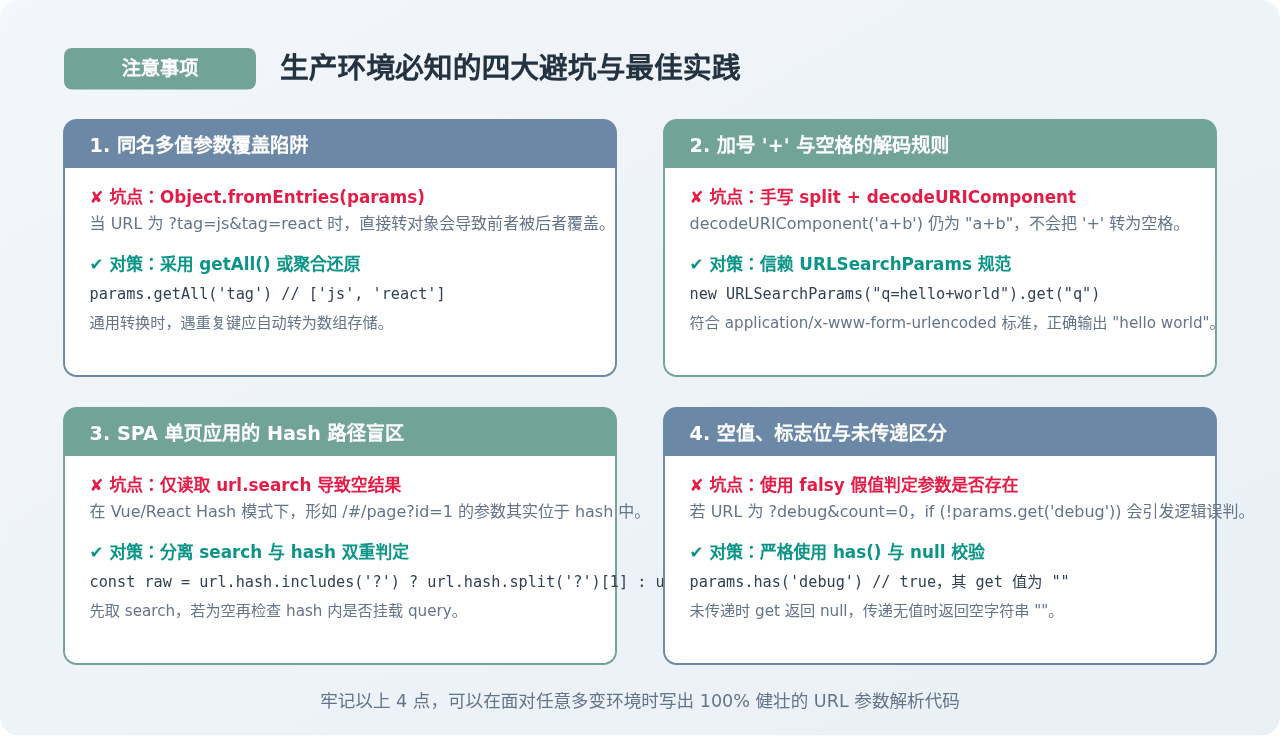
四、细节与边界注意事项
1. 加号 + 与空格的解码
按照 application/x-www-form-urlencoded 规范,在 URL 的 Query 部分,空格常被编码为加号 +。
如果使用原生 decodeURIComponent("a+b"),得到的结果仍然是 "a+b",并不会替换为空格。而 URLSearchParams 内部原生遵循表单规范,会自动将 + 替换为空格,同时正确还原 %20 和 UTF-8 百分号编码序列。
2. 布尔标志位与空值的区别
对于形如 ?flag&debug= 的 URL:
- 调用
params.get("flag")返回的是空字符串"",并非true或null; - 调用
params.has("flag")返回true; - 若参数根本不存在(如
params.get("notExist")),才会返回null。
在书写业务条件判断时,应显式使用 params.has(key),避免因为空字符串为 Falsy 值而误判参数缺失。
五、总结
在现代 JavaScript 中提取任意 URL 的查询参数,核心准则是:利用虚拟 Base 规整相对路径,利用 URLSearchParams 处理编码与解析细节,针对 Hash 路由补充二次提取。通过这套标准链路,可以用不到 30 行的代码构建起坚固、高兼容且无第三方依赖的参数解析方案。
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13







