

为什么 JS Set 无法直接去重对象?引用类型处理陷阱
深入解析 JavaScript 中使用 Set 无法直接去重对象的根本原因,剖析 ECMAScript SameValueZero 判等算法与堆栈内存指针模型,并提供基于 Map、复合键与哈希的高效 O(N) 解决方案与避坑指南。
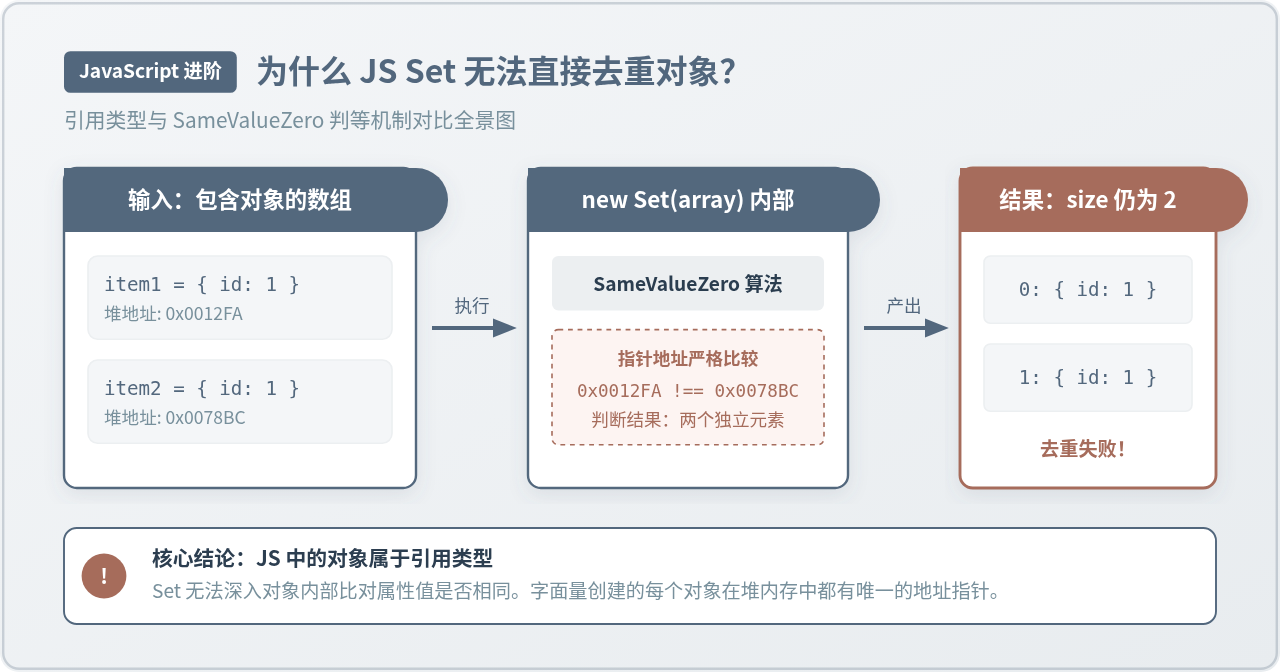
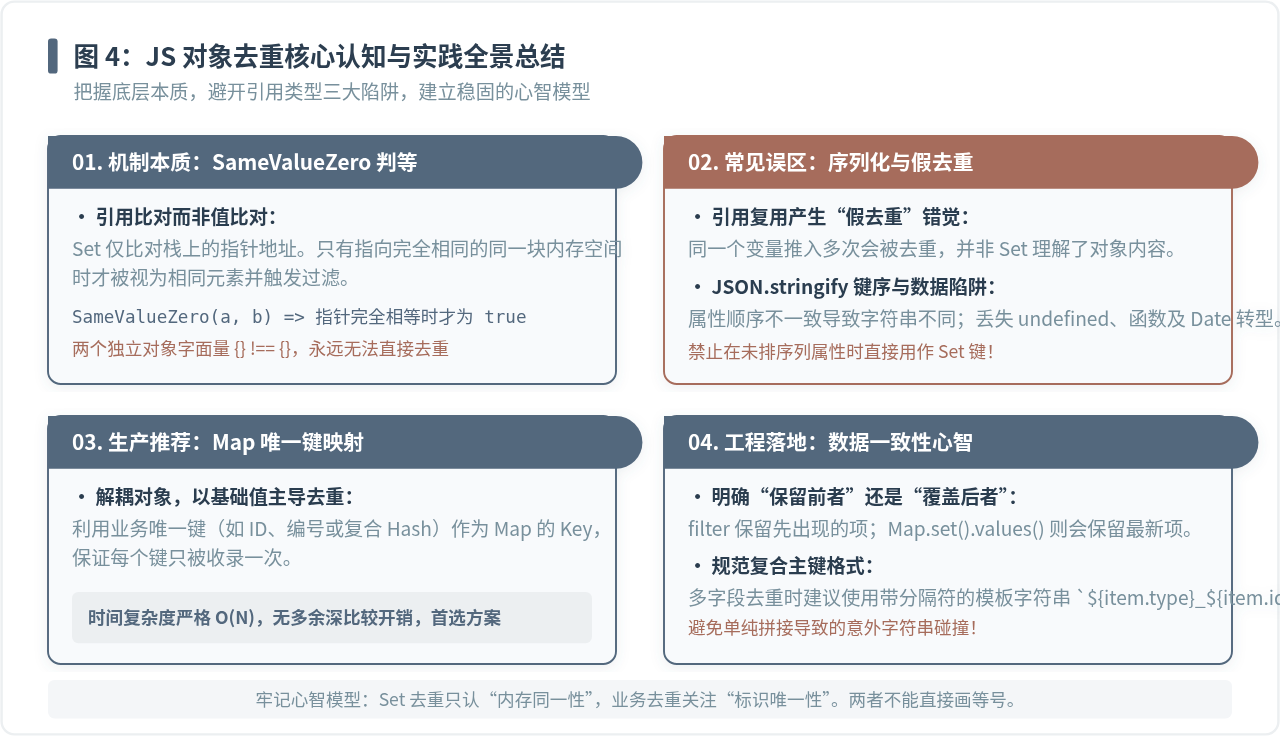
在 JavaScript 中,对基础类型数组执行 new Set([1, 1, 2]) 可以瞬间完成去重;但如果传入对象数组 new Set([{ id: 1 }, { id: 1 }]),集合长度却依旧是 2。这个现象的核心原因在于:Set 底层使用 ECMAScript 规范的 SameValueZero 判等算法,对于对象等引用类型,它比较的是栈内存中的堆地址指针,而不是对象内部的属性与键值。即使两个对象内部属性完全一致,只要它们由独立的字面量或构造调用生成,各自的引用指针便不同,Set 就会将其判定为互不相关的两个独立元素。
一、Set 集合的底层判等基石:SameValueZero 算法
要彻底搞清楚 Set 为什么“对对象失效”,首先要看 ECMAScript 官方规范对 Set.prototype.add(value) 的定义。Set 在检索已有元素是否存在时,既没有使用弱相等的 ==,也不是完全等同于严格全等的 ===,而是采用了一个名为 SameValueZero 的内部抽象操作。
为了理解 SameValueZero,我们可以将其与日常使用的严格全等(===)以及 Object.is()(即 SameValue 算法)进行对比:
| 判等场景 | 严格全等 (===) | SameValue (Object.is) | SameValueZero (Set / Map 采用) |
|---|---|---|---|
+0 与 -0 |
true | false(严格区分正负符号) | true(视为零值相同) |
NaN 与 NaN |
false | true | true(可正确对 NaN 排重) |
| 基础类型数值/字符串 | 值相等即 true | 值相等即 true | 值相等即 true |
| 引用类型(对象/数组) | 引用指针相同才为 true | 引用指针相同才为 true | 引用指针相同才为 true |
从上表可以清楚看到:SameValueZero 优化了基础类型中 NaN 的识别问题(在普通数组中 [NaN].indexOf(NaN) 会返回 -1,而 Set 能正确将多个 NaN 归纳为一个)。但是,在处理引用类型时,SameValueZero 完全沿用了指针比对逻辑。
// 基础类型值比对:通过
const numSet = new Set([1, 1, 2]);
console.log(numSet.size); // 输出: 2 (已去重)

// 引用类型字面量比对:失败
const objSet = new Set([{ id: 1 }, { id: 1 }]);
console.log(objSet.size); // 输出: 2 (未能去重!)
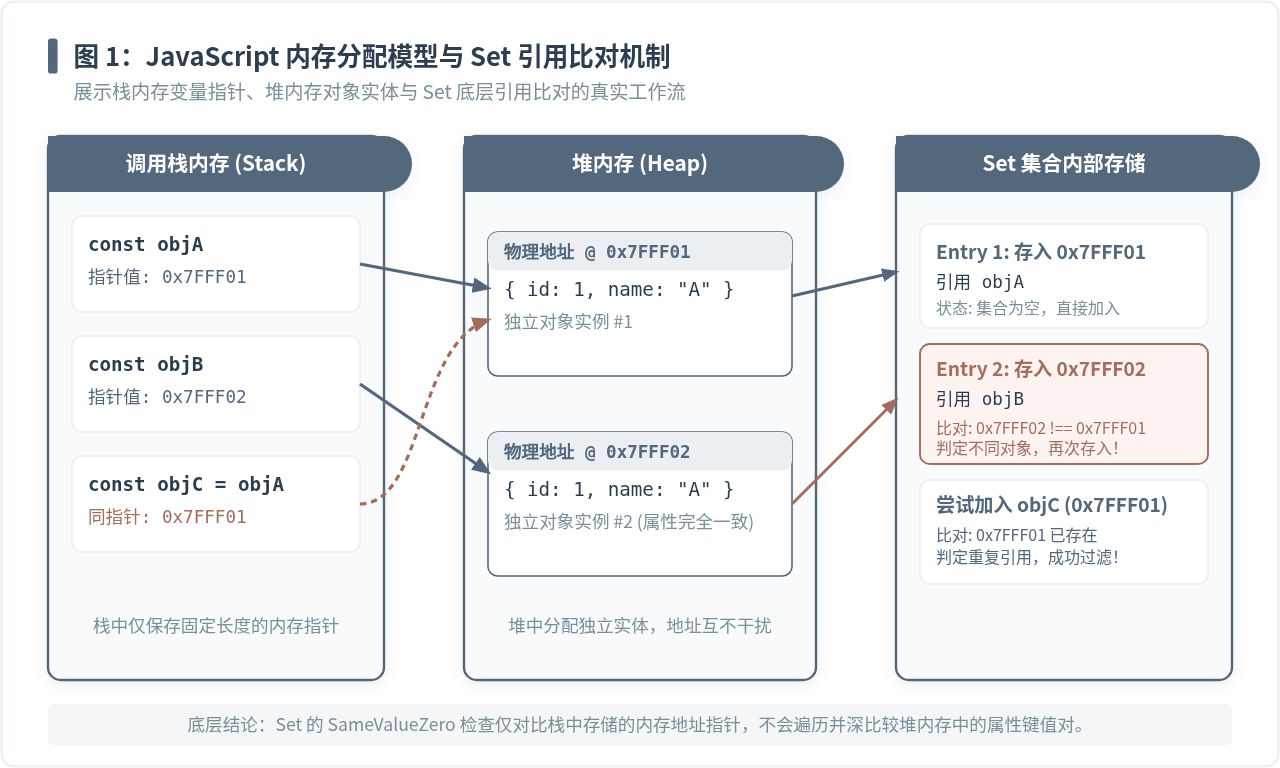
每次在代码中书写 { id: 1 } 时,JavaScript 引擎都会在堆内存中申请一块崭新的存储空间,并返回对应这块空间的内存地址指针。两次字面量声明虽然属性名和属性值肉眼看来相同,但指针是完全独立的。
二、开发中常见的对象引用误区与陷阱
了解了内存机制之后,我们可以进一步剖析几类在业务开发中最容易让人产生困惑的边界情况。
陷阱 1:变量复用产生的“去重假象”
部分开发者在调试时写过类似下方的测试代码,并误以为 Set “有时候可以去重对象”:
const item = { id: 100, name: "Config" };
const list = [item, item, item];

const result = new Set(list);
console.log(result.size); // 输出: 1
这里的 size 为 1,并不是因为 Set 深度解析了 id: 100,而是因为数组中的三个元素全部指向同一个变量 item 的栈内存指针(例如 0x7FFF01)。在进行 SameValueZero(0x7FFF01, 0x7FFF01) 时判定命中,因而被去重。一旦对象是由后端接口分页返回、或者通过 .map() 浅拷贝重新构造生成的,这个假设就会立刻瓦解。
陷阱 2:直接使用 JSON.stringify 序列化的暗礁
为了绕过引用判等,很多初学者尝试使用 JSON.stringify 将对象转为字符串再放入 Set:
// 看似可行的粗暴做法
const raw = [{ a: 1, b: 2 }, { b: 2, a: 1 }];
const deduplicated = Array.from(
  new Set(raw.map(o => JSON.stringify(o)))
).map(s => JSON.parse(s));

console.log(deduplicated.length); // 依然输出: 2!去重失败
- 属性顺序敏感:JavaScript 规范中普通对象的键值迭代虽然有特定顺序,但跨平台或手动构造的对象若属性赋值顺序不同,生成的 JSON 字符串(例如
'{"a":1,"b":2}'与'{"b":2,"a":1}')并不相等。 - 特殊类型数据丢失:值为
undefined、函数或Symbol的属性在序列化时会被直接忽略;NaN和Infinity会被转为null;Date会被转为 ISO 字符串从而失去 Date 实例类型。 - 循环引用报错:如果对象存在环形引用,
JSON.stringify会直接抛出TypeError: Converting circular structure to JSON。 - 序列化性能开销:在大数组下频繁进行字符串序列化和反序列化,执行耗时往往是线性哈希映射的数倍。
三、行之有效的高效解决方案
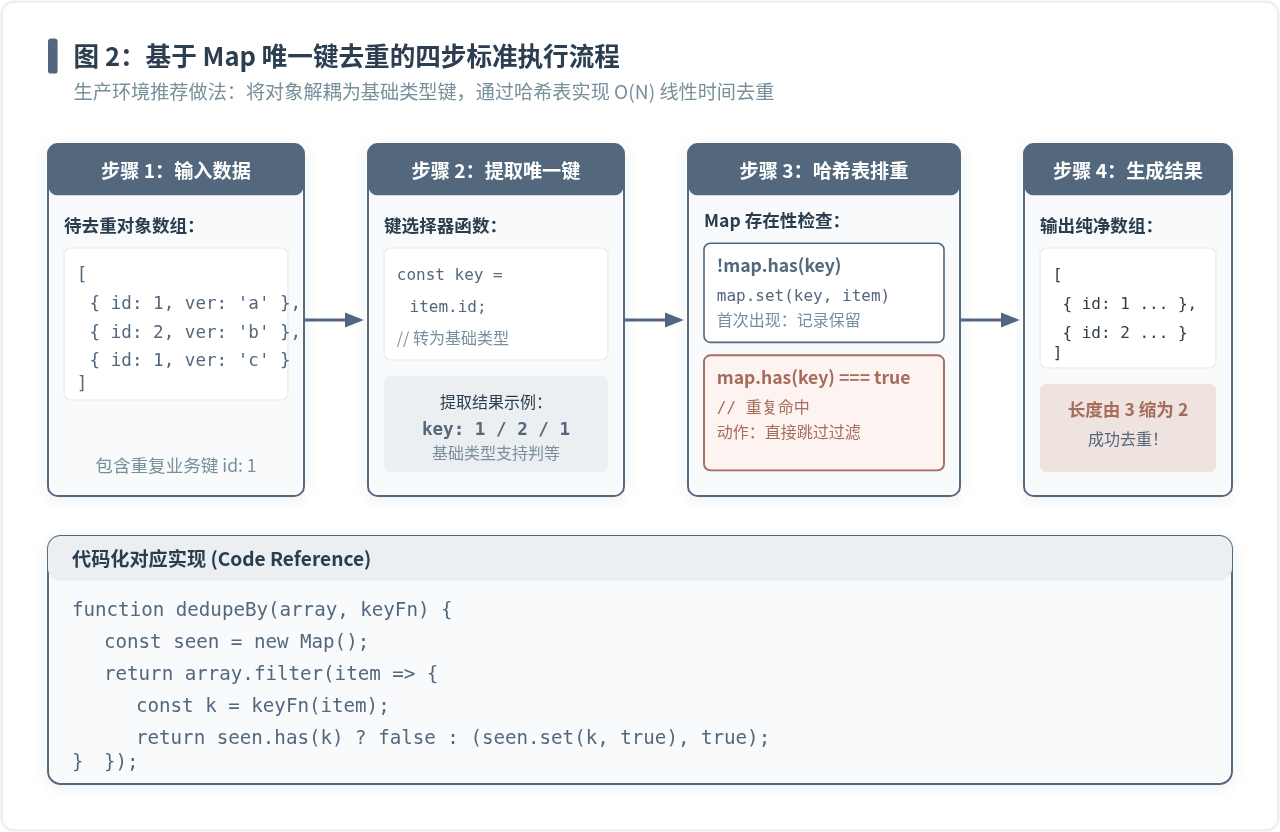
在实际生产中,业务数组往往存在某种主键或唯一特征。解决对象去重最稳健的核心思路是:将对象解耦,提取其稳定的原始类型标识(Primitive Key),基于标识进行碰撞过滤,同时保留原对象实体。
方案一:基于业务唯一标识(Map 方案,首选推荐)
在绝大部分业务数据中,对象都有 id、code 或复合主键。利用 ES6 Map 的键值映射特性,可以在单次遍历中完成排重,时间复杂度为 O(N),空间复杂度为 O(N)。
/**
 * 通用对象数组去重函数(基于指定主键或提取函数)
 * @param array 待去重的对象数组
 * @param keyExtractor 提取唯一标识的函数
 */
function dedupeByKey(array, keyExtractor) {
  const seen = new Map();
  return array.filter(item => {
    const key = keyExtractor(item);
    if (seen.has(key)) {
      return false; // 已存在,过滤抛弃
    }
    seen.set(key, true);
    return true; // 首次出现,保留当前项
  });
}

// 使用示例:
const users = [
  { id: 1, name: "张三", role: "admin" },
  { id: 2, name: "李四", role: "editor" },
  { id: 1, name: "张三(重复)", role: "user" }
];

const uniqueUsers = dedupeByKey(users, u => u.id);
console.log(uniqueUsers.length); // 输出: 2
方案二:处理复合主键场景
当单一字段无法界定唯一性时(例如需要根据 tenantId 和 userId 组合确定唯一项),可以构建复合字符串键。为防止潜在的拼接歧义(例如 1 与 23 拼接成 "123",与 12 与 3 冲突),务必添加安全分隔符:
const records = [
  { tenantId: 1, userId: 23, score: 90 },
  { tenantId: 12, userId: 3, score: 85 },
  { tenantId: 1, userId: 23, score: 92 } // 复合重复项
];

// 使用安全的分隔符生成复合基础类型 Key
const uniqueRecords = dedupeByKey(records, r => `__${r.tenantId}##${r.userId}__`);
console.log(uniqueRecords.length); // 准确输出: 2
方案三:无唯一键时的规范化序列化方案
若对象确实没有任何唯一主键,且确定数据量不大(几百条以内)、属性皆为纯数据类型,可以通过先将对象的属性键按字母排序,再进行哈希比对:
function getNormalizedSignature(obj) {
  if (obj === null || typeof obj !== 'object') {
    return String(obj);
  }
  const sortedKeys = Object.keys(obj).sort();
  return "{" + sortedKeys.map(k => `"${k}":${getNormalizedSignature(obj[k])}`).join(",") + "}";
}

function dedupeByContent(array) {
  const seen = new Set();
  return array.filter(item => {
    const sig = getNormalizedSignature(item);
    if (seen.has(sig)) return false;
    seen.add(sig);
    return true;
  });
}
四、核心方案横向综合评估
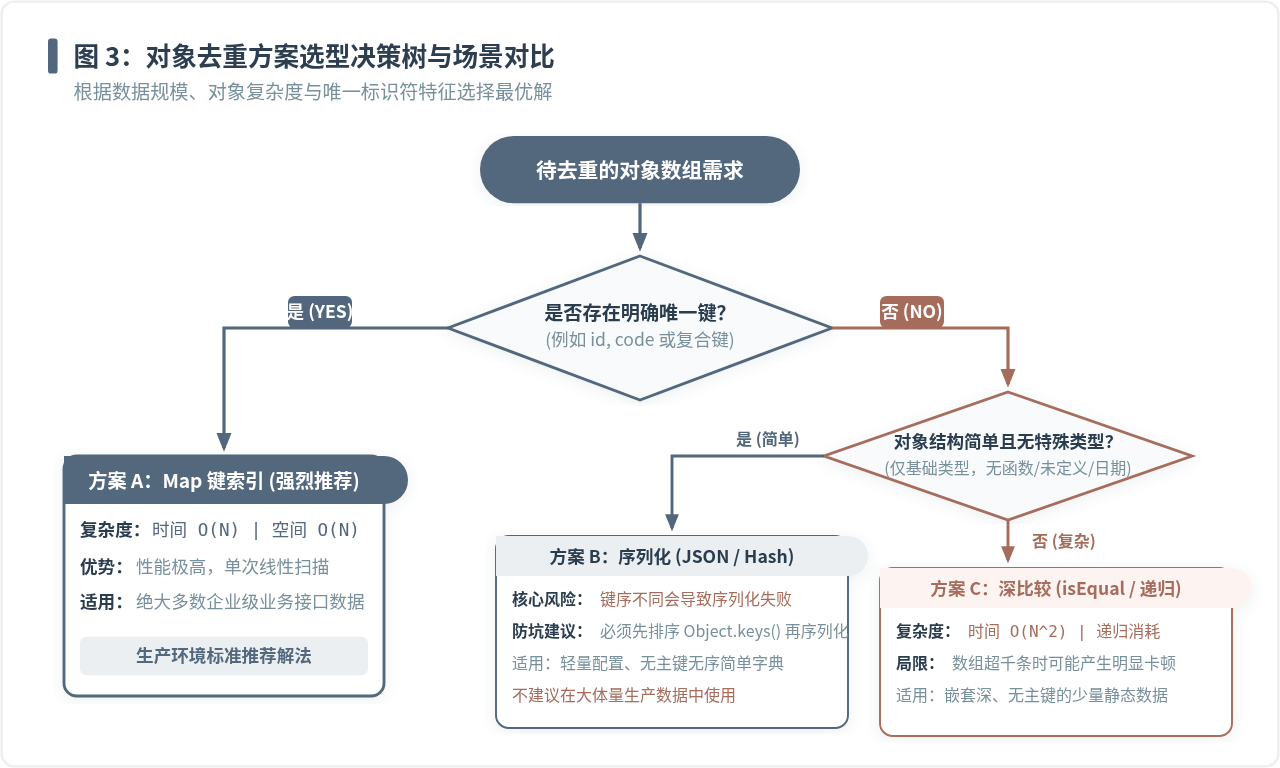
面对不同的业务体量和场景,选择方案时需要综合评估时间复杂度、健壮性以及维护成本:
| 去重方案 | 时间复杂度 | 空间复杂度 | 健壮性与边界安全性 | 推荐使用场景 |
|---|---|---|---|---|
| Map / 业务主键 | O(N) |
O(N) |
极高,不惧任何对象内部嵌套与类型变化 | 绝大多数常规业务数据(接口列表、表单选项) |
| filter + findIndex | O(N²) |
O(1) |
中,两层循环,元素超过 1000 条时容易产生掉帧卡顿 | 小型临时数组(数十条以内)且不想引入额外结构 |
| 未排序 JSON.stringify | O(N × M) |
O(N × M) |
极低,键序错乱即失效,且丢失特殊类型 | 不推荐在生产业务逻辑中使用 |
| 规范化键序签名 | O(N × M log M) |
O(N × M) |
较高,解决键无序问题,但递归遍历深对象仍有性能损耗 | 无主键、纯属性比对的小规模静态配置数组 |
五、总结
JavaScript 的 Set 之所以无法直接去重对象,是语言底层设计与规范使然:Set 追求的是极高的存取效率与严格的规范一致性,因此选择依赖比对内存指针的 SameValueZero 算法。它不会、也不应该在底层替开发者假设“哪些内部属性相同就代表是同一个对象”。
在实际工程开发中,请始终牢记以下两个准则:
- 建立清晰的判等预期:当操作包含对象的集合时,时刻提醒自己“比对的是引用指针还是业务内容”。
- 主键优先,解耦去重:优先为数据提炼出唯一的基础类型标识符(如 ID 或规范化的字符串复合键),借助
Map在O(N)线性耗时内稳妥完成去重,兼顾代码的可读性、稳定性与卓越性能。
D3.js 比例尺与坐标轴的配置详解
2026-11-05 16:54:46
JavaScript怎么遍历对象的Symbol键和不可枚举属性
2026-11-05 13:13:39
封装一个健壮的JS字符串判空工具函数
2026-11-05 12:16:14
JavaScript合并数组的三种常用方法:concat、扩展运算符与push
2026-11-05 11:22:29
JavaScript立即执行函数(IIFE)是什么及基本语法
2026-11-05 10:51:19
相关标签:







