JS生成不重复随机数序列的实现方案
深入解析在JavaScript中生成不重复随机数序列的多种实用实现方案,涵盖Fisher-Yates洗牌算法、O(k)局部抽取交换法、Set集合查重机制及大数稀疏映射,提供无偏数学保证与工程选型建议。
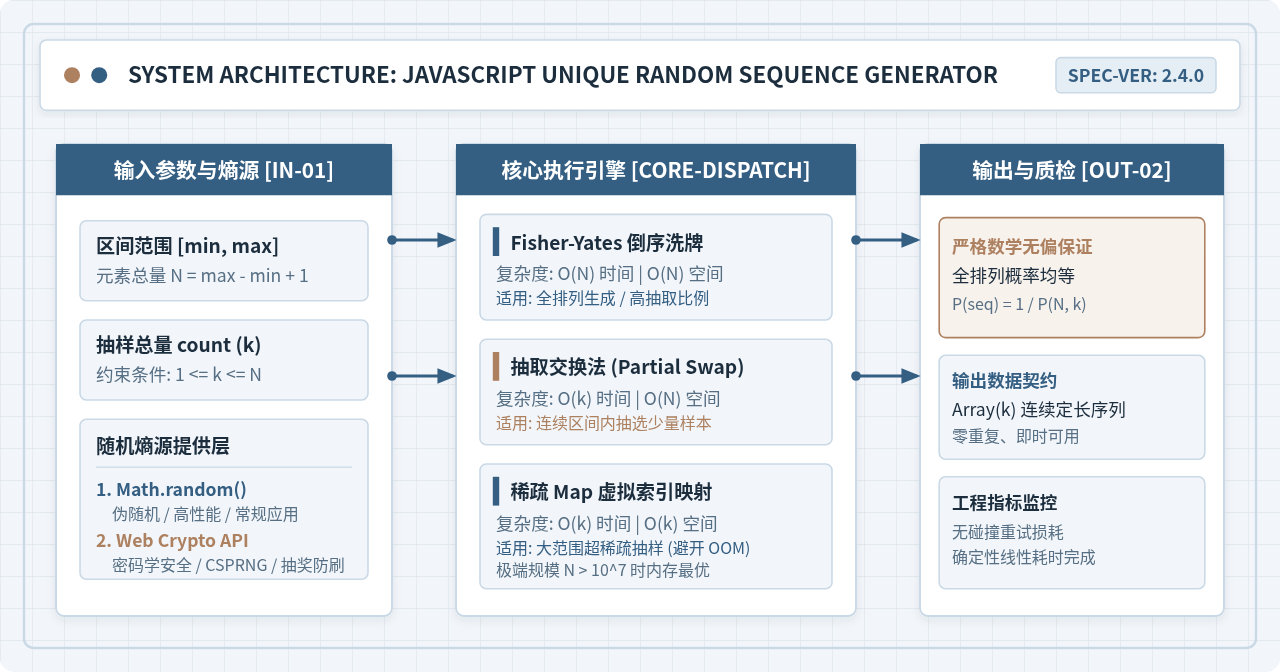
在 JavaScript 中生成指定范围内不重复的随机数序列,核心途径可分为两类:一是“先建池后洗牌”(如 Fisher-Yates 算法),从根本上保证无偏性并彻底杜绝重复碰撞;二是“按需提取并记录已选”(如 Set 集合查重或稀疏 Map 原地重定向)。选择方案的关键在于数据范围大小 $N$ 与抽取数量 $k$ 的比例关系。本文将针对不同实际开发场景,依次解析各方案的具体实现代码、执行原理、复杂度差异与避坑要点。
一、基于 Fisher-Yates 洗牌算法的全量打乱(通用基准方案)
当需要生成某个区间内全部元素的随机序列(即全排列),或者抽取数量 $k$ 接近区间总数 $N$ 时,Fisher-Yates 洗牌算法(也称 Knuth 洗牌算法)是最优解。它的核心逻辑是按顺序创建包含所有数字的数组,然后从最后一个元素开始向前遍历,每次从尚未锁定的前序区域中随机挑选一个位置进行原地交换。
1. 算法执行步骤
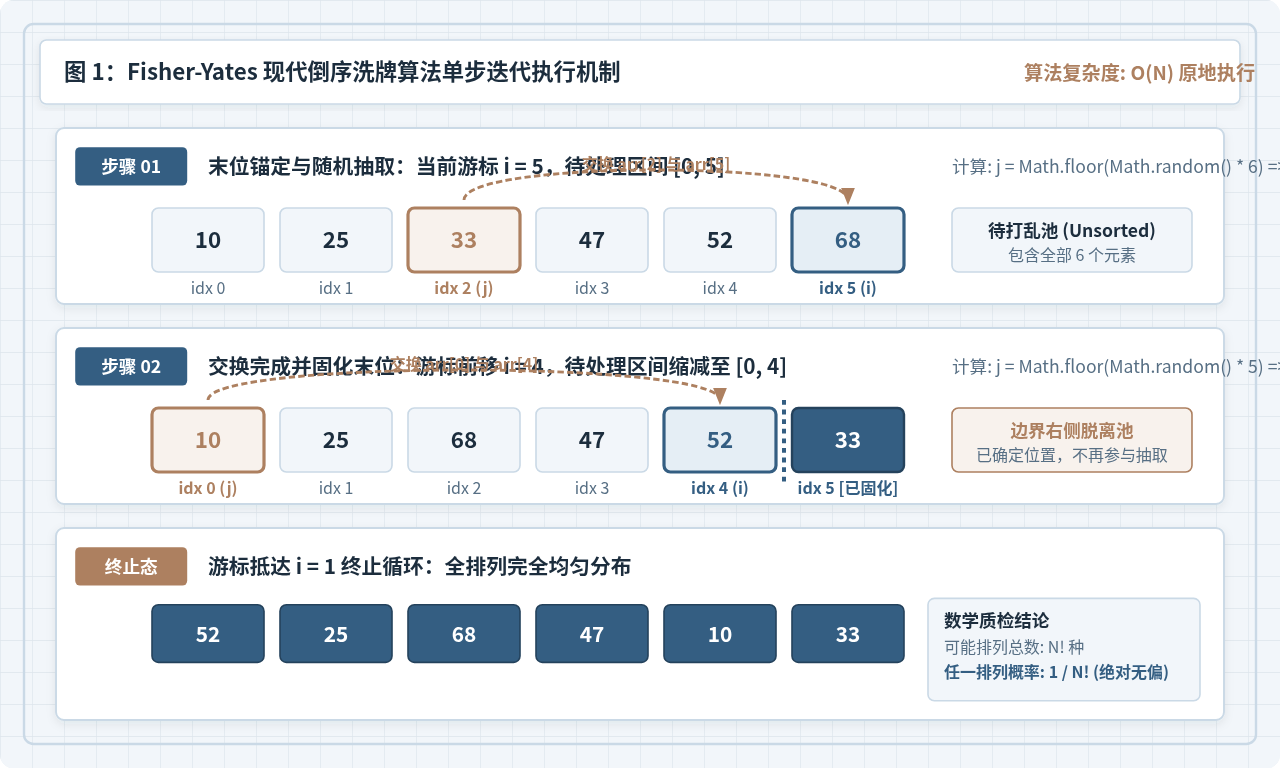
- 初始化序列池:开辟长度为 $N = max - min + 1$ 的数组,填充升序整数。
- 倒序双指针交换:设定循环索引 $i$ 从 $N - 1$ 递减至 $1$。在每一步循环中,生成随机整数 $j \in [0, i]$。
- 交换与固化:将索引 $i$ 与索引 $j$ 处的元素互换。互换后,索引 $i$ 处的数值即告最终固化,不再参与后续随机抽取。
- 截取输出:若仅需前 $k$ 个数,直接执行
pool.slice(0, count)即可。
2. 完整实现代码
以下为经过边界防御校验的通用实现,支持指定闭区间 $[min, max]$ 和提取数量 $count$:
/**
 * 使用 Fisher-Yates 洗牌算法生成指定范围内的不重复随机数序列
 * @param {number} min 闭区间起始最小值
 * @param {number} max 闭区间结束最大值
 * @param {number} count 需要生成的数量 (k)
 * @returns {number[]} 不重复随机数数组
 */
function generateByFisherYates(min, max, count) {
  const total = max - min + 1;
  if (count > total) {
    throw new RangeError(`抽取数量 count (${count}) 不能大于区间总量 total (${total})`);
  }
  if (count <= 0) {
    return [];
  }

  // 1. 预先分配连续数组并填充连续数值
  const pool = new Array(total);
  for (let i = 0; i < total; i++) {
    pool[i] = min + i;
  }

  // 2. 原地倒序洗牌
  for (let i = pool.length - 1; i > 0; i--) {
    // 生成 [0, i] 范围内的随机整数
    const j = Math.floor(Math.random() * (i + 1));
    // 原地元素交换 (ES6 解构语法或临时变量)
    const temp = pool[i];
    pool[i] = pool[j];
    pool[j] = temp;
  }

  // 3. 返回前 count 个随机数
  return count === total ? pool : pool.slice(0, count);
}

// 运行示例
const result = generateByFisherYates(1, 10, 5);
console.log('洗牌结果:', result); // 输出形如: [7, 2, 9, 1, 4]很多初学者会尝试使用 arr.sort(() => Math.random() - 0.5) 进行乱序,这是严重错误的。V8 引擎内部的 Timsort 算法在比较元素时依赖传递性假定,sort 打乱会导致某些排列出现的概率远高于其他排列(出现严重的概率倾斜)。而 Fisher-Yates 在数学上严格保证了全部 $N!$ 种可能排列的出现概率均等为 $1 / N!$。
二、抽取交换法:小采样量下的 $O(k)$ 局部打乱优化
如果区间总数 $N$ 并不大(例如 $N = 1000$),但我们仅需要抽取极少量的数据(例如 $k = 5$),那么完整打乱整个数组的 $N - 1$ 次循环就存在计算冗余。此时可以对洗牌算法进行前向局部优化:只需要循环 $k$ 次,每次将当前游标 $i$ 与剩余未选区域中的随机项交换即可。
1. 代码实现与执行原理
/**
 * 局部抽取交换法:仅执行 count 次循环,时间复杂度 O(k)
 */
function sampleByPartialSwap(min, max, count) {
  const total = max - min + 1;
  if (count > total) {
    throw new RangeError('抽取数量超出区间总数');
  }

  const pool = Array.from({ length: total }, (_, idx) => min + idx);
  const result = new Array(count);

  for (let i = 0; i < count; i++) {
    // 从剩余区间 [i, total - 1] 中挑选一个索引
    const randomIndex = i + Math.floor(Math.random() * (total - i));

    // 将挑选出的数存入结果列表
    result[i] = pool[randomIndex];

    // 将挑出的位置用当前头部位置 i 的数值填补,避免后续被再次挑中
    pool[randomIndex] = pool[i];
  }

  return result;
}
该方法的时间消耗只与目标抽取数量 $k$ 呈线性关系,不需要遍历完整个数组。但请注意,它依然在内存中开辟了包含 $N$ 个元素的候选池,因此其空间复杂度仍为 $O(N)$。
三、Set 集合查重法:适用边界与碰撞退化陷阱
在日常业务脚本中,最直观的想法往往是:利用 Set 的唯一性,在 while 循环中不断生成随机数并存入集合,直到 Set.size === count 为止。这种写法代码极短,但背后存在着严重的概率碰撞退化隐患。
1. 实现代码与使用限制
/**
 * Set 集合去重循环法 (仅适用于 k << N 的低抽样率场景)
 */
function generateBySet(min, max, count) {
  const total = max - min + 1;
  if (count > total) {
    throw new RangeError('抽取数量超出区间大小');
  }

  // 严格防御:当抽取比例超过 50% 时禁止使用,避免事件循环卡死
  if (count / total > 0.5) {
    console.warn('检测到抽样比例高于 50%,建议切换为 Fisher-Yates 算法以防碰撞卡顿');
  }

  const set = new Set();
  while (set.size < count) {
    const num = min + Math.floor(Math.random() * total);
    set.add(num);
  }

  return Array.from(set);
}
2. 为什么高抽样比下不能使用 Set?
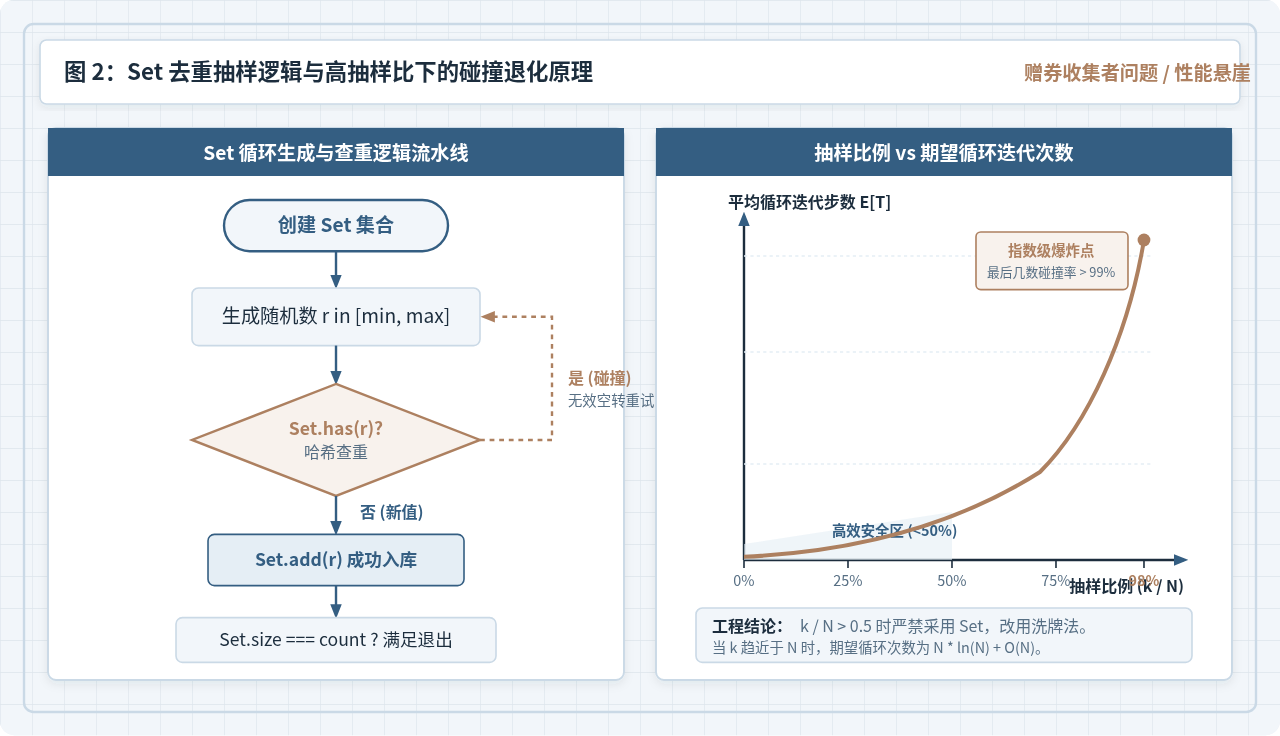
Set 查重法的本质是有放回抽样模拟无放回抽样。随着集合内数字增多,每次随机命中“已有数字”的概率直线上升:
- 当抽取第 $1$ 个数字时,碰撞概率为 $0$。
- 当集合中已经有 $N - 1$ 个数字,只剩最后 $1$ 个空位时,单次抽中新数字的成功率仅为 $1 / N$。此时为了填满最后一个数字,期望的循环重试次数高达 $N$ 次!
- 根据概率论中的赠券收集者问题(Coupon Collector's Problem),当 $k = N$ 时,总期望循环尝试次数将达到 $N \cdot \ln(N) + O(N)$。若 $N = 10^5$,生成全量数据需要进行上百万次无效随机数计算与哈希查找,极易造成 Node.js 单线程假死或前端浏览器页面冻结。
四、大数区间下的稀疏映射抽样(防止内存溢出 OOM)
如果面临一个特殊场景:要求在区间 $[1, 10^9]$(十亿)中随机抽取 $100$ 个不重复数字。此时前文所有需要初始化长度为 $N$ 数组的方法都会立刻导致程序崩溃,因为 V8 引擎无法分配容纳十亿级元素的连续物理内存(触发 RangeError: Invalid array length)。
为了兼顾“$O(k)$ 的绝对执行效率”与“杜绝碰撞重复”,可以采用基于 Map 的虚拟洗牌重定向算法。该算法在逻辑上模拟数组交换,但实际只记录发生过变动的索引。
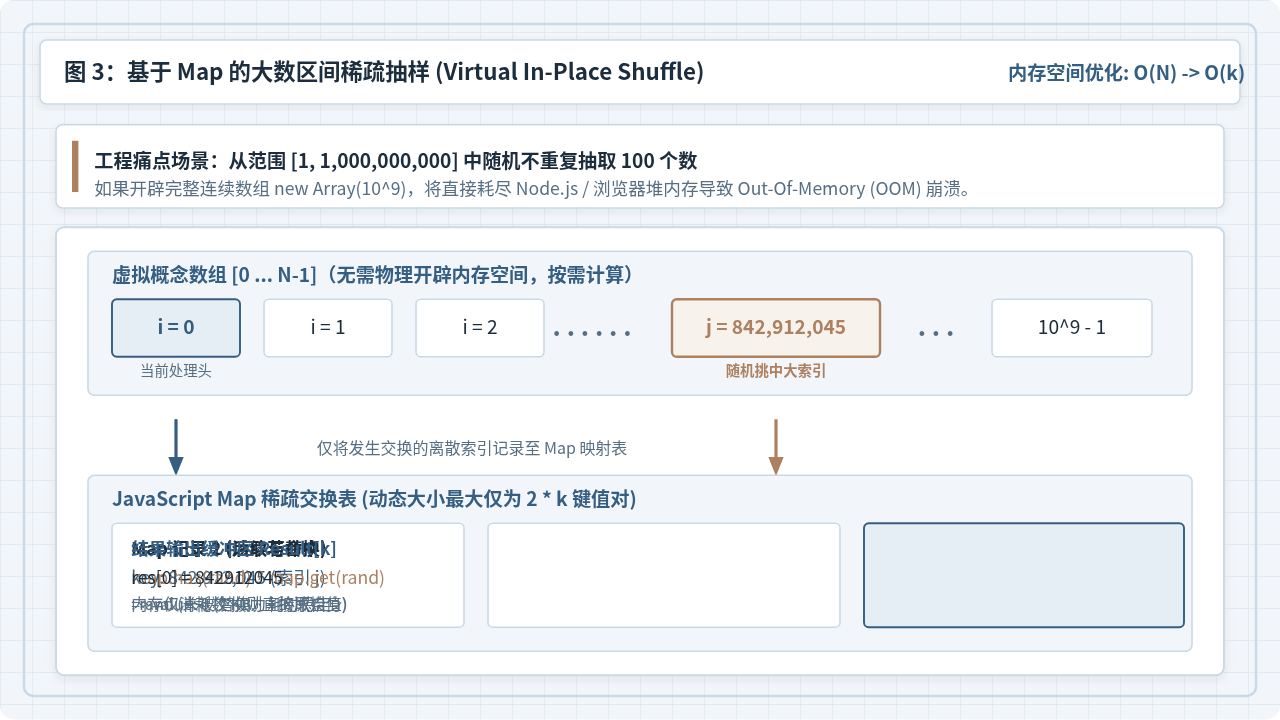
1. 稀疏虚拟映射代码实现
/**
 * 稀疏大区间无偏抽样算法
 * 空间复杂度仅为 O(k),时间复杂度 O(k),彻底杜绝 OOM
 */
function sampleLargeRangeSparse(min, max, count) {
  const total = max - min + 1;
  if (count > total) {
    throw new RangeError('抽取数量超出区间总数');
  }

  // 使用 Map 记录被交换过的虚拟位置,最大仅保存 k 组键值对
  const map = new Map();
  const result = new Array(count);

  for (let i = 0; i < count; i++) {
    // 剩余候选范围为 [i, total - 1]
    const rand = i + Math.floor(Math.random() * (total - i));

    // 若 rand 已经存在于映射表中,说明该位置之前被覆盖过,取出映射值;否则使用原始偏移
    const valAtRand = map.has(rand) ? map.get(rand) : (min + rand);
    // 同理获取位置 i 的当前有效值
    const valAtI = map.has(i) ? map.get(i) : (min + i);

    // 记录抽中的数值
    result[i] = valAtRand;

    // 将位置 i 的数值转移到 rand 位置,完成虚拟原地置换
    map.set(rand, valAtI);
  }

  return result;
}

// 实测:从 1 到 10 亿中秒级提取 5 个不重复随机数
const bigResult = sampleLargeRangeSparse(1, 1000000000, 5);
console.log('大区间稀疏抽取结果:', bigResult);
五、密码学安全随机序列(Web Crypto API)
在涉及优惠券发放、抽奖活动、验证码生成或敏感令牌分配的业务场景中,标准 Math.random() 的伪随机数生成器(PRNG,通常基于 xorshift128+)存在内部状态可预测的风险。攻击者通过收集连续输出的随机数,有可能反推出内部种子状态,从而预测下一轮序列。
在此类场景下,必须使用系统底层的密码学安全伪随机数生成器(CSPRNG)。现代浏览器与 Node.js 均内置支持标准的 Web Crypto API。
1. 安全随机数发生器封装
/**
 * 获取密码学安全的无偏随机浮点数 [0, 1)
 * 兼容现代浏览器 (window.crypto) 与 Node.js 16+ (globalThis.crypto)
 */
function secureRandomFloat() {
  const buffer = new Uint32Array(1);
  crypto.getRandomValues(buffer);
  // 2^32 = 4294967296,将其均匀映射到 [0, 1) 区间
  return buffer[0] / 4294967296;
}

/**
 * 生成密码学安全的不重复随机整数序列
 */
function generateSecureSequence(min, max, count) {
  const total = max - min + 1;
  if (count > total) throw new RangeError('数量溢出');

  const pool = Array.from({ length: total }, (_, i) => min + i);
  for (let i = pool.length - 1; i > 0; i--) {
    // 替换原有的 Math.random()
    const j = Math.floor(secureRandomFloat() * (i + 1));
    const temp = pool[i];
    pool[i] = pool[j];
    pool[j] = temp;
  }

  return pool.slice(0, count);
}
六、方案综合对比与工程选型指南
为了在实际项目中快速确定最合适的实现方案,以下梳理了四大方案的技术特征矩阵与决策路径:
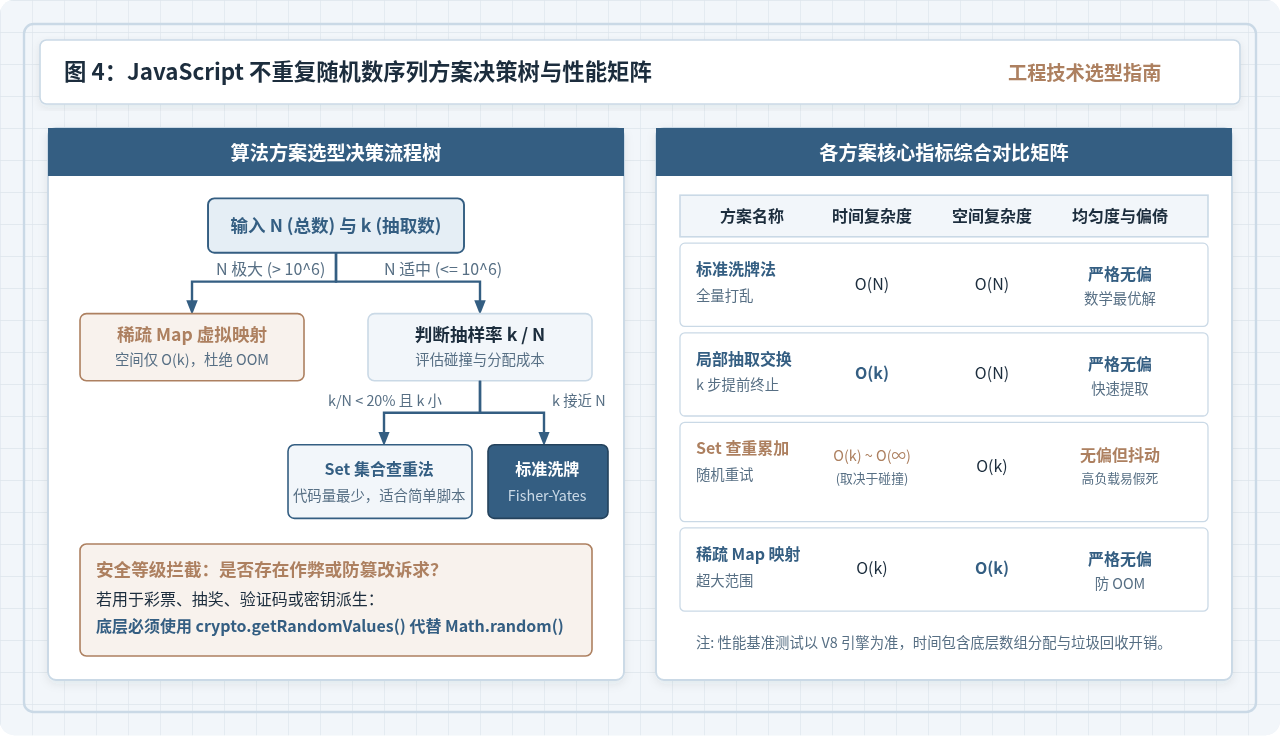
| 实现方案 | 时间复杂度 | 空间复杂度 | 适用区间规模 $N$ | 抽样比 ($k/N$) 推荐值 | 典型业务场景 |
|---|---|---|---|---|---|
| Fisher-Yates 倒序洗牌 | $O(N)$ | $O(N)$ | $N \le 10^6$ | $50\% \sim 100\%$ | 发牌模拟、问卷题目乱序、全排列生成 |
| 局部抽取交换法 | $O(k)$ | $O(N)$ | $N \le 10^6$ | $< 20\%$ | 班级随机点名、从小题库中抽取 $5$ 道题 |
| Set 集合查重法 | $O(k) \sim O(\infty)$ | $O(k)$ | 不限 | $< 5\%$ (且 $k \le 100$) | 轻量级小脚本、生成验证码字符集 |
| 稀疏 Map 虚拟映射 | $O(k)$ | $O(k)$ | $N > 10^7$ (超大规模) | 极低抽样率 | 全国用户 ID 抽奖、大数哈希采样 |
凡是需要打乱既有数组、或者抽取元素占总容量大半的场景,无需犹豫,直接使用成熟规范的 Fisher-Yates 倒序算法,其时间确定性与空间稳定性均属最优。
严禁在抽取比例超过 $50\%$ 的情况下使用 while(set.size < count) 模式,避免末尾元素在生日悖论影响下频繁碰撞引发的性能滑坡。
当数值区间达到数千万乃至数亿级别时,绝对不要创建完整数组,应优先采用稀疏 Map 虚拟重定向,在仅消耗几十 KB 内存的前提下获得确定性结果。
JS大数值转字符串出现科学计数法怎么办
2026-11-05 17:09:21
JS split切割后出现空字符串怎么过滤
2026-11-05 16:00:30
在 React 或 Vue 项目中封装使用 JS 节流防抖
2026-11-05 15:27:29
JavaScript中怎么将带小数的字符串转为整数?
2026-11-05 14:32:38
怎么用JavaScript策略模式重构电商促销计算逻辑?
2026-11-05 14:01:09
相关标签: