

JS数组去重时NaN和undefined怎么处理
深入讲解JavaScript数组去重中NaN与undefined的正确处理机制。剖析严格相等、SameValueZero以及对象哈希在处理特殊类型时的表现差异,提供现代化与向下兼容的稳妥方案。
NaN、undefined 或稀疏数组空位(empty slots)时,不少传统写法都会出现“将所有 NaN 漏滤丢弃”或“让重复的 NaN 全部堆积”的异常情况。现代 JavaScript (ES6+) 中处理这两个特殊值的核心结论非常明确:直接优先使用 [...new Set(arr)] 或 Array.from(new Set(arr))。因为 Set 原生依赖 ECMAScript 规范的 SameValueZero 比较算法,能够把多个 NaN 视作相等并仅保留单个实例,同时也能对多个 undefined 稳定实现单值保留。本文将系统剖析常见去重方案对特殊值的处理差异,并提供兼顾现代标准与旧环境兼容的落地实现。
一、为什么 NaN 与 undefined 容易在去重中出错
日常业务中数组包含的基本是数字、字符串或布尔值,这些类型在比较时行为符合直觉。但在处理 NaN 与 undefined 时,去重逻辑往往因底层判定算法的差异而失效:
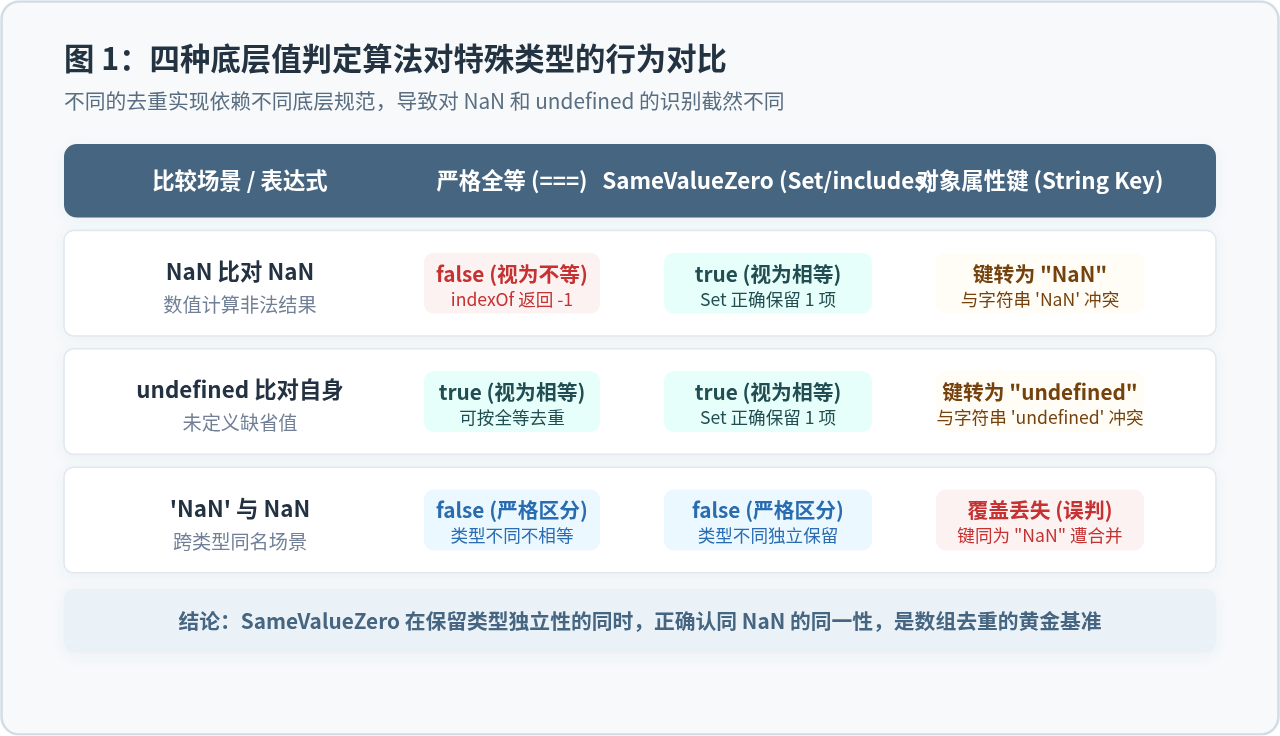
- NaN 的非自反性(Non-reflexive):在 IEEE 754 浮点数规范与 ECMAScript 严格全等(
===)规范中,NaN === NaN永远为false。这是语言设计上的特性,却成了传统去重逻辑的软肋。任何依赖===或indexOf进行查重的方案,都无法通过自身与自身的比对判定相等。 - indexOf 的底层限制:
Array.prototype.indexOf严格遵循全等比对。由于NaN === NaN恒为false,执行arr.indexOf(NaN)时不论数组中是否存在NaN,其返回值始终为-1。 - undefined 的全等与空位差异:
undefined === undefined恒为true,因此单纯的比对并不会丢失undefined。但如果数组是由new Array(3)等方式生成的稀疏数组,空位(empty slot)在不同高阶函数(如filter、forEach、map)与展开运算符[...arr]中的遍历行为完全不同。 - 对象键(Object Key)的类型退化:若使用普通 JavaScript 对象(如
obj[item] = true)作为哈希表去重,对象的键名会被隐式转换为字符串。数字NaN会退化为键名"NaN",undefined会退化为键名"undefined"。如果原数组同时存在字符串"NaN"和数字NaN,会导致跨类型合并覆盖。
二、经典去重方案实测与问题剖析
为了直观观察不同去重方案的实际表现,我们定义一个包含了重复数字、字符串、多个 NaN 以及多个 undefined 的标准测试数组:
// 测试基准数组:包含重复项、NaN 与 undefined
const testArr = [1, NaN, undefined, 'NaN', NaN, 1, undefined];
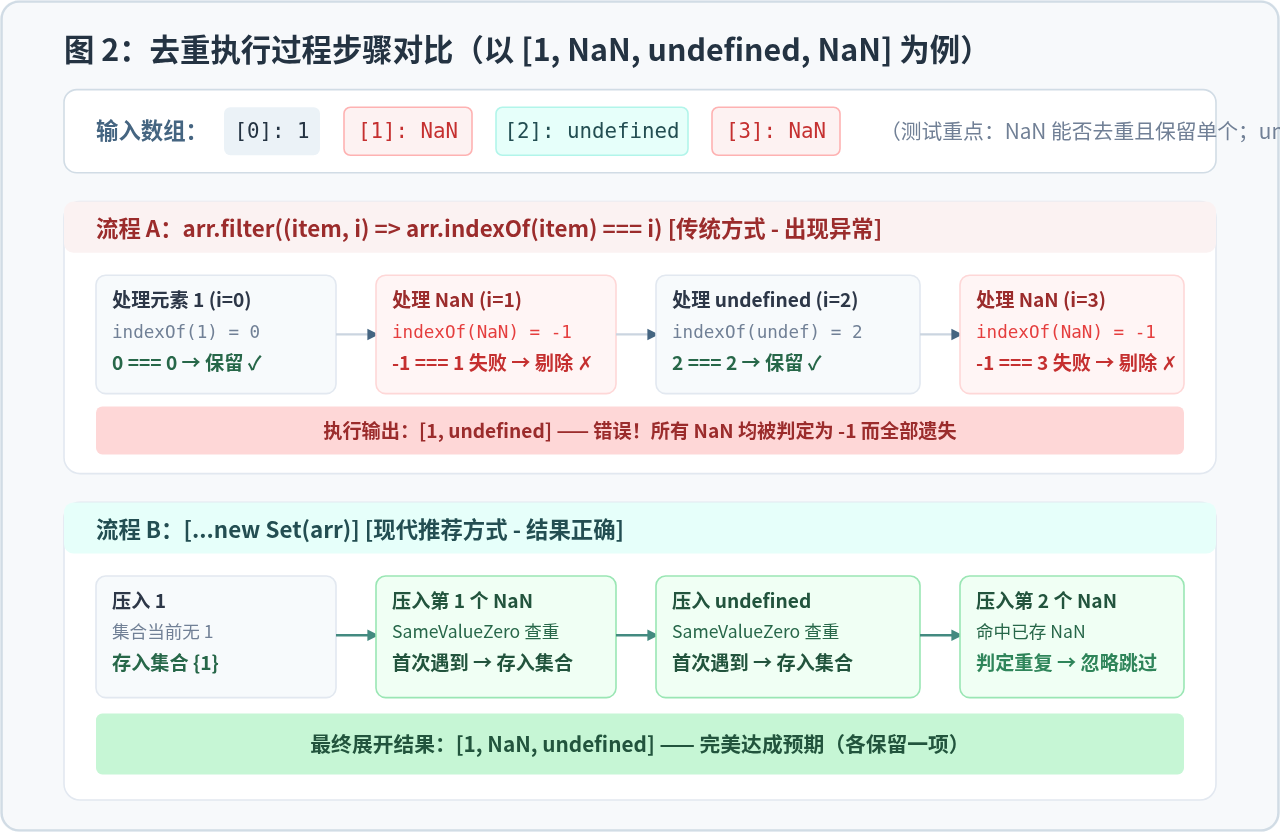
1. 陷阱方案:filter + indexOf
这是在 ES5 时代极为流行的一种单行去重技巧,原理是利用 indexOf 返回元素在数组中首次出现的索引。如果当前项的索引等于首次出现索引,则说明是首次访问,予以保留:
function dedupeByFilterIndexOf(arr) {
  return arr.filter((item, index) => arr.indexOf(item) === index);
}

const resultFilter = dedupeByFilterIndexOf(testArr);NaN 均被彻底移除了,一个都没有保留!原因分析:当遍历到数组第 1 项
NaN 时,执行 arr.indexOf(NaN) 返回 -1,判断条件 -1 === 1 为 false;同理遍历到第 4 项 NaN 时,-1 === 4 依然为 false。所有 NaN 均因找不到合法索引而被当成“无效项”过滤抛弃。
2. 异常方案:双重循环嵌套比对
初学者常用的另一种直觉写法是外层循环遍历元素,内层循环向前查找是否存在重复项:
function dedupeByNestedLoop(arr) {
  const result = [];
  for (let i = 0; i < arr.length; i++) {
    let isDuplicate = false;
    for (let j = 0; j < result.length; j++) {
      if (result[j] === arr[i]) {
        isDuplicate = true;
        break;
      }
    }
    if (!isDuplicate) {
      result.push(arr[i]);
    }
  }
  return result;
}

const resultNested = dedupeByNestedLoop(testArr);filter + indexOf 恰好相反,由于 NaN === NaN 恒为 false,内层循环在比对 result[j] === NaN 时永远无法成立,isDuplicate 永远是 false。结果是每一个重复的 NaN 都被当作不同元素压入了结果数组,完全失去了去重能力。
三、实用解决方案与针对性代码实现
针对 NaN 与 undefined 的特性,我们可以根据项目的运行环境采用不同层次的解决方案。
方案一:ES6+ 原生 Set 集合(推荐标准方案)
ECMAScript 2015 引入的 Set 数据结构,其成员的值都是唯一的。规范明确指定 Set 内部的判等依据是 SameValueZero 算法。在该算法下:
SameValueZero(NaN, NaN)判定为true,保证NaN仅会被记录一次;SameValueZero(undefined, undefined)判定为true,保证undefined仅会被记录一次;SameValueZero(NaN, 'NaN')判定为false,严格区分数值与字符串类型。
// 核心推荐写法:扩展运算符配合 Set
function dedupeBySet(arr) {
  return [...new Set(arr)];
}

// 亦可使用 Array.from
function dedupeByArrayFromSet(arr) {
  return Array.from(new Set(arr));
}

const resultSet = dedupeBySet(testArr);可以看到,重复的 NaN 被合并为一个,重复的 undefined 也被合并为一个,且保留了字符串 'NaN' 的独立性。时间复杂度为线性的 $O(n)$,执行效率高且代码最为简洁。
方案二:基于 Array.prototype.includes 进行条件累加
如果在某些流式过滤场景下需要配合 reduce 或 forEach 构造结果数组,请务必使用 includes 替代 indexOf。ES2016 引入的 includes 方法同样采用 SameValueZero 比对:
function dedupeByIncludes(arr) {
  return arr.reduce((accumulator, currentItem) => {
    if (!accumulator.includes(currentItem)) {
      accumulator.push(currentItem);
    }
    return accumulator;
  }, []);
}

const resultIncludes = dedupeByIncludes(testArr);includes 能正确识别 NaN,但由于在 reduce 中每次调用 includes 都会线性扫描累加器,整体时间复杂度为 $O(n^2)$。当数组长度超过数千项时,性能会明显落后于 Set。
方案三:ES5 环境下安全去重函数(向下兼容方案)
如果需要在无法引入 ES6 Polyfill 的旧版浏览器或运行环境中执行去重,必须手动封装一个符合 SameValueZero 规则的比对辅助函数:
// 安全的 SameValueZero 比对器(兼容 ES5)
function isSameValueZero(x, y) {
  if (x === y) {
    return true;
  }
  // 处理两个比较值均为 NaN 的场景
  // 注意:必须使用严格的 NaN 校验,避免全局 isNaN 的隐式类型转换
  return (typeof x === 'number' && isNaN(x)) && (typeof y === 'number' && isNaN(y));
}

function dedupeSafeES5(arr) {
  var result = [];
  for (var i = 0; i < arr.length; i++) {
    var item = arr[i];
    var isDuplicate = false;
    for (var j = 0; j < result.length; j++) {
      if (isSameValueZero(result[j], item)) {
        isDuplicate = true;
        break;
      }
    }
    if (!isDuplicate) {
      result.push(item);
    }
  }
  return result;
}

var resultES5 = dedupeSafeES5(testArr);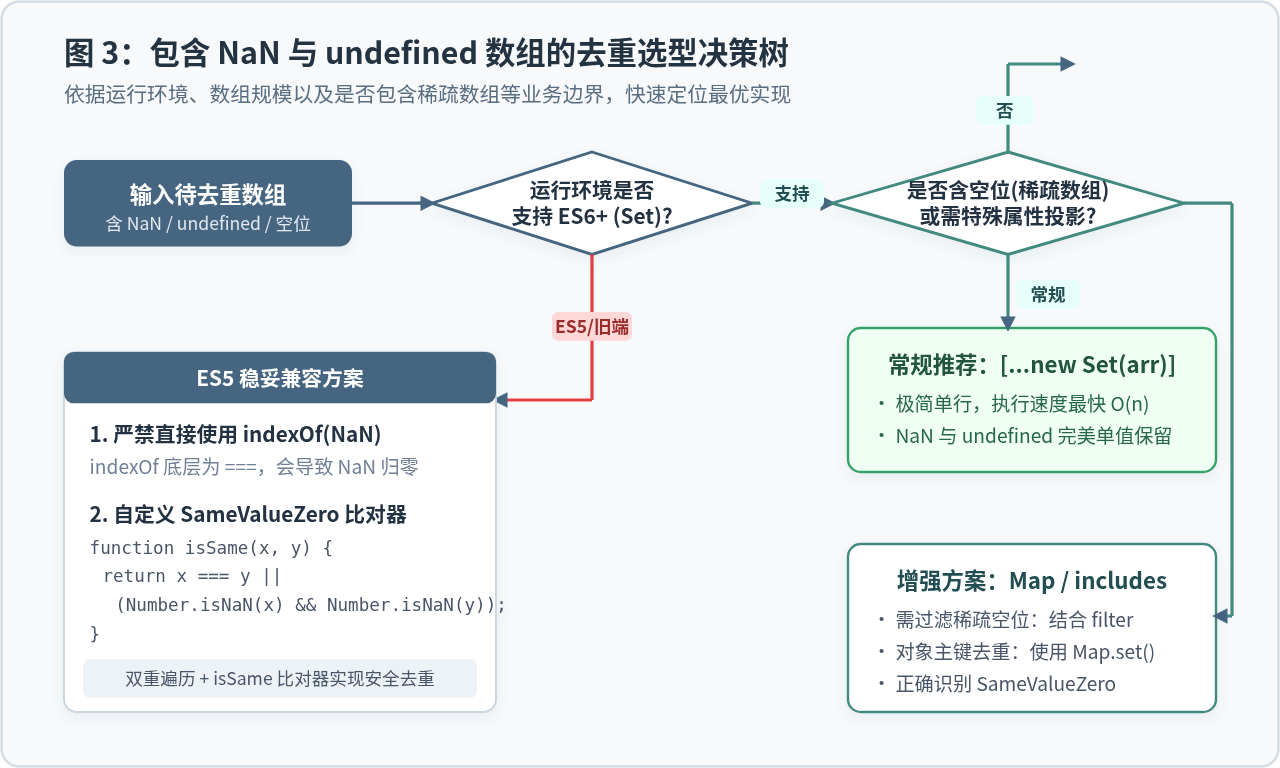
四、边界场景与常见陷阱排查
在工程实践中,除了基础的数据类型比较外,还需要注意以下三项容易导致生产故障的边界场景:
1. 警惕全局 isNaN 与 Number.isNaN 的差异
在编写自定义兼容逻辑时,切勿直接使用全局函数 isNaN():
// 错误用法演示:全局 isNaN 会触发隐式转换
console.log(isNaN('Hello'));       // 输出: true (字符串被强制转为 NaN)
console.log(isNaN(undefined));     // 输出: true (undefined 被转为 NaN)

// 正确用法:ES6 Number.isNaN 或类型前置判断
console.log(Number.isNaN('Hello'));   // 输出: false
console.log(Number.isNaN(undefined)); // 输出: false
console.log(Number.isNaN(NaN));       // 输出: true
如果直接使用 isNaN(item) 作为分支条件,那么传入字符串 'Hello' 或 undefined 时都会被错误归类为 NaN,造成严重的逻辑混乱。
2. 稀疏数组(空位 Holes)与显式 undefined 的去重差异
稀疏数组是指含有未初始化索引位置的数组。空位与显式赋值的 undefined 在去重时表现并不完全相同:
// 创建包含空位与显式 undefined 的数组
const sparseArr = [1, , undefined, 2];
console.log(sparseArr.length); // 4
console.log(0 in sparseArr);   // true (索引 0 存在值 1)
console.log(1 in sparseArr);   // false (索引 1 是空位,没有属性)
console.log(2 in sparseArr);   // true (索引 2 明确定义为 undefined)

// 行为 A:使用 Set 去重
const fromSet = [...new Set(sparseArr)];
// 结果: [ 1, undefined, 2 ] —— 展开运算符会将空位自动转为 undefined,合并为一个

// 行为 B:使用 filter 去重
const fromFilter = sparseArr.filter(() => true);
// 结果: [ 1, undefined, 2 ] —— filter 会直接跳过空位,但保留显式定义的 undefined
在绝大多数业务场景下,展开运算符配合 Set 将空位收拢为单个 undefined 是符合预期的安全处理方式。
3. 普通对象 Hash 键名冲突
部分开发者为了追求 $O(n)$ 复杂度,会使用 obj[item] = true 去重:
// 危险模式:对象属性名自动字符串化
const badHashDedupe = (arr) => {
  const seen = {};
  return arr.filter(item => seen.hasOwnProperty(item) ? false : (seen[item] = true));
};

console.log(badHashDedupe([NaN, 'NaN']));             // [ NaN ] (字符串 'NaN' 被吃掉)
console.log(badHashDedupe([undefined, 'undefined'])); // [ undefined ] (字符串 'undefined' 被吃掉)
由于普通对象的键名强制为字符串,导致数字 NaN 与字符串 'NaN' 发生了冲突。若需哈希映射,必须使用 ES6 的 Map(其键名比较遵循 SameValueZero,能准确区分不同的数据类型)。
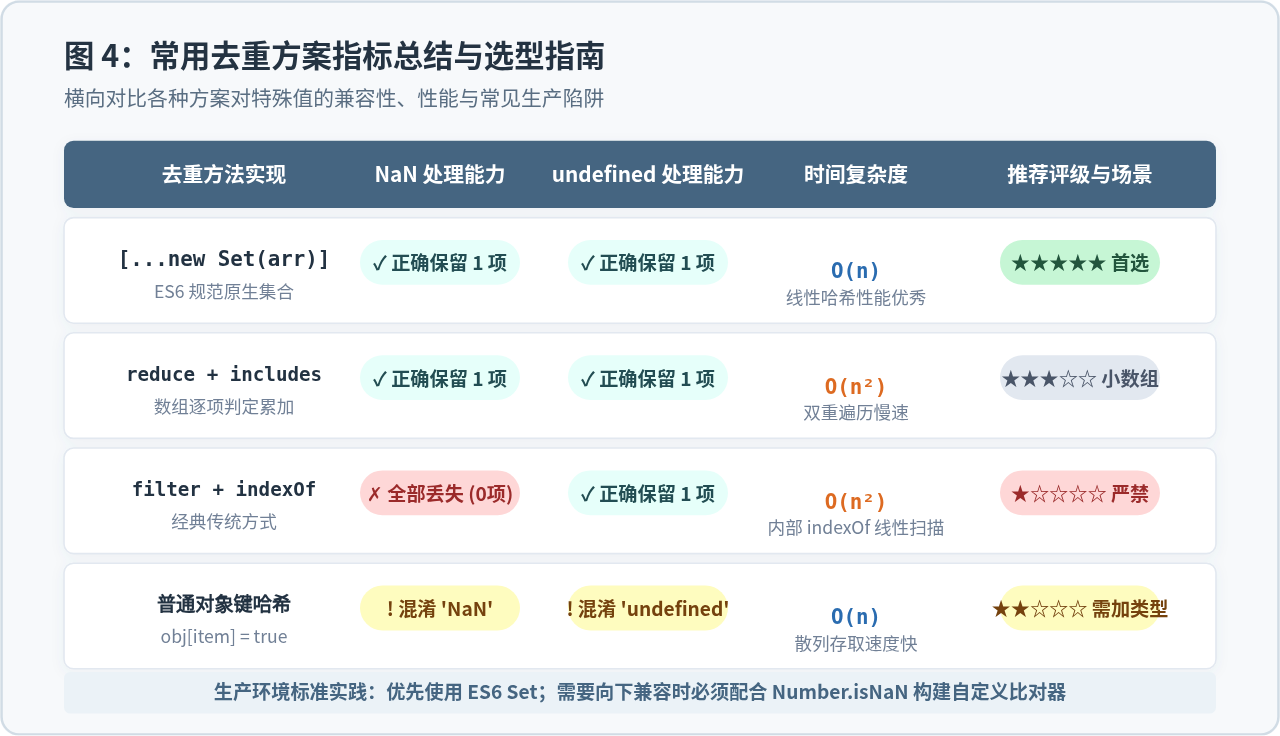
五、常见问题速查
| 疑难问题 | 根本原因 | 解决建议 |
|---|---|---|
为什么我的数组去重后,所有的 NaN 都不见了? |
代码中使用了 arr.filter((item, i) => arr.indexOf(item) === i)。indexOf(NaN) 始终返回 -1,条件判定永远失败。 |
将去重逻辑直接替换为 [...new Set(arr)]。 |
数组中有好几个 NaN,为什么去重后全部都在? |
使用了基于 === 或 == 的循环遍历查重。由于 NaN === NaN 为 false,查重逻辑误判它们各不相同。 |
在循环内使用 SameValueZero 判定或改用 includes。 |
既有数字 NaN 又有字符串 "NaN",如何保证两者都保留? |
使用 Set 或 Map,它们不会将元素转换为字符串键,能够严格保留原始类型与引用。 |
直接调用 [...new Set(arr)] 即可天然支持。 |
| 低版本打包工具不支持 ES6 怎么办? | 旧项目构建链缺少 core-js 或 @babel/polyfill。 |
采用本文第三节方案三的 ES5 兼容函数,配合显式类型检查与 isNaN 逻辑。 |
D3.js 比例尺与坐标轴的配置详解
2026-11-05 16:54:46
JavaScript怎么遍历对象的Symbol键和不可枚举属性
2026-11-05 13:13:39
封装一个健壮的JS字符串判空工具函数
2026-11-05 12:16:14
JavaScript合并数组的三种常用方法:concat、扩展运算符与push
2026-11-05 11:22:29
JavaScript立即执行函数(IIFE)是什么及基本语法
2026-11-05 10:51:19
相关标签:







