

qrcode.js API 详解:纠错级别与数据容量限制
深入解析 qrcode.js 中纠错级别(correctLevel)的 API 用法、底层纠错原理以及其对数据容量限制的具体影响,提供选型决策与容量溢出防御方案。
qrcode.js 生成二维码时,开发者经常会遇到“在中心放置 Logo 后二维码无法识别”或“传入长文本时直接抛出 code length overflow 异常”这两类典型问题。这两个问题的根源,均直接指向 qrcode.js 的核心配置项——纠错级别(correctLevel)与其对应的数据容量限制机制。本文将系统拆解该配置项的 API 细节、四个纠错级别的数学设计、数据容量在不同字符编码下的物理约束,并提供避免生产事故的选型与容错方案。
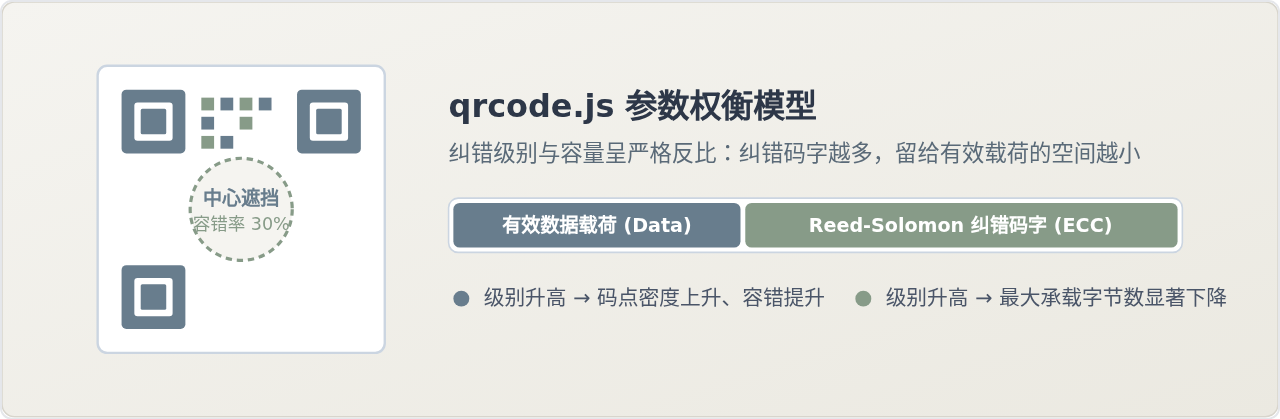
一、qrcode.js 纠错级别 API 详解与初始化配置
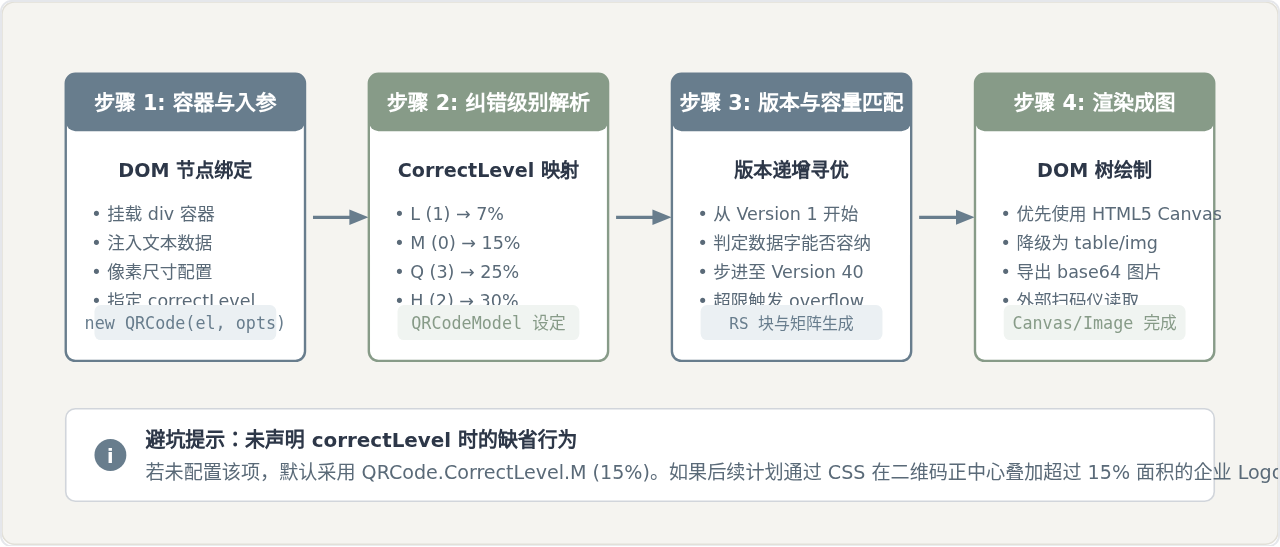
在纯前端场景中,qrcode.js 是一个轻量级、无第三方依赖的二维码生成库。其实例化构造函数 QRCode 接收两个参数:用于挂载的 DOM 节点(或容器元素 ID 字符串)以及一个配置项字典对象。纠错级别由配置项中的 correctLevel 属性指定。
1. 纠错级别枚举值映射
qrcode.js 在全局挂载的 QRCode 对象上预设了静态枚举字典 QRCode.CorrectLevel。在标准源码实现中,其键值映射如下:
QRCode.CorrectLevel = {
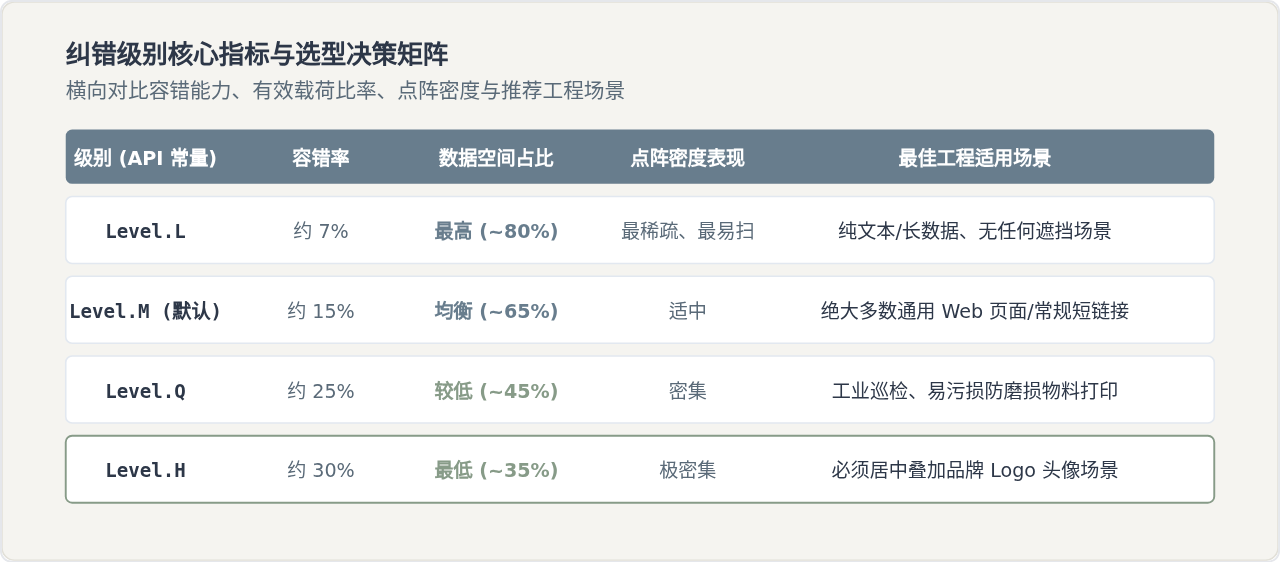
    L : 1, // 容错率约 7% (Low)
    M : 0, // 容错率约 15% (Medium - 默认值)
    Q : 3, // 容错率约 25% (Quartile)
    H : 2  // 容错率约 30% (High)
};
值得注意的是,枚举属性值(1, 0, 3, 2)是二维码标准规范中对应纠错级别指示符(2 位指示位)的内部编码,而非简单的从低到高递增序号。因此,在日常代码编写时,严禁直接传数值字面量(如误以为 1 是最低、4 是最高),而必须始终使用语义明确的 QRCode.CorrectLevel.X 常量。
2. 完整初始化与动态更新示例
以下是配置指定纠错级别并在后续业务流中动态更新二维码的完整代码实现:
// 1. 获取容器元素
var container = document.getElementById("qrcode-box");

// 2. 实例化并显式声明纠错级别
var qrcode = new QRCode(container, {
    text: "https://example.com/pay?order=20261101",
    width: 256,
    height: 256,
    colorDark: "#000000",
    colorLight: "#FFFFFF",
    correctLevel: QRCode.CorrectLevel.H // 指定最高纠错级别 (30%)
});

// 3. 动态更新内容(保持当前纠错级别)
function updateQRCode(newUrl) {
    qrcode.clear(); // 清理当前 Canvas/Img 状态
    qrcode.makeCode(newUrl); // 重新计算矩阵并渲染
}
二、纠错级别的底层原理:Reed-Solomon 纠错与码字分配
二维码(QR Code)之所以能够在部分污损、遮挡或磨损的情况下依然被完整识别,核心在于其引入了 里德-所罗门纠错算法(Reed-Solomon Error Correction)。
在二维码的数据结构中,所有信息被切分为固定长度的 8 位(1 Byte)单元,称为 码字(Codeword)。一个二维码所拥有的总物理码字数,完全由当前的 版本(Version,从 1 到 40) 决定。例如:
- Version 1:尺寸为 21×21 矩阵,总容量为 26 个码字;
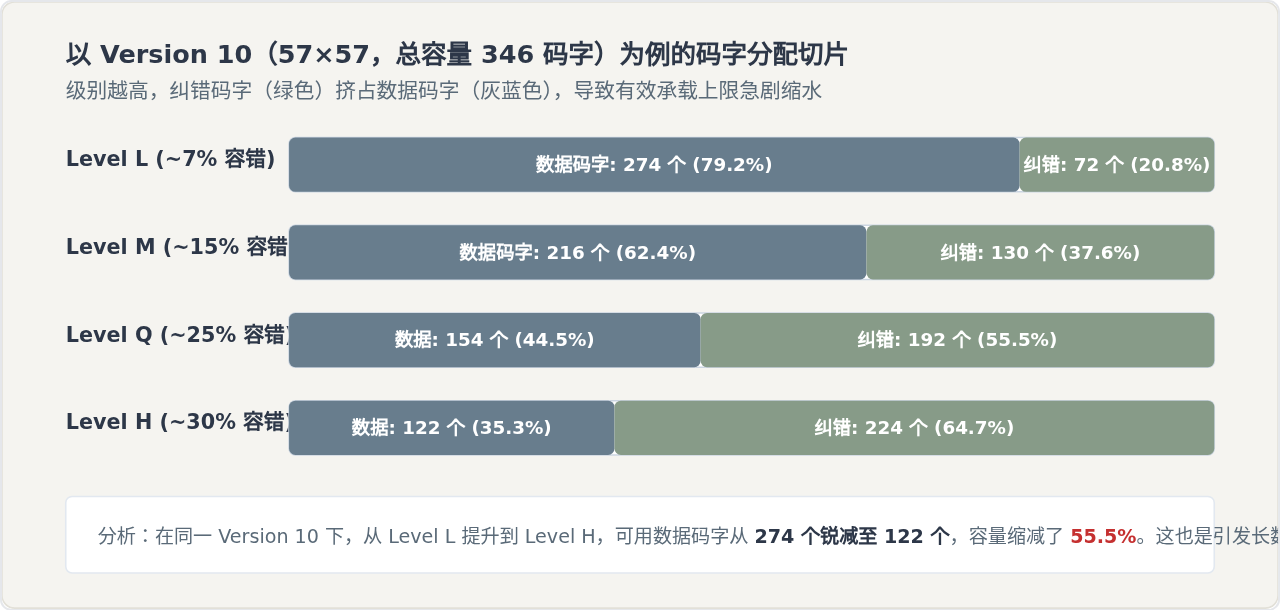
- Version 10:尺寸为 57×57 矩阵,总容量为 346 个码字;
- Version 40:尺寸为 177×177 矩阵,总容量为 3706 个码字。
对于任何固定版本的二维码,其 总码字数是恒定不变的。总码字数被严密划分为两大部分:
总码字(Total Codewords) = 数据码字(Data Codewords) + 纠错码字(EC Codewords)
纠错级别的高低,本质上就是纠错码字在总码字中所占的比例分配。当纠错级别从 L 提升到 H 时,系统会强制要求生成更多的 Reed-Solomon 冗余校验码字。由于总空间有限,留给实际有效载荷的数据码字数量便被剧烈压缩。
三、数据容量限制与字符编码模式
qrcode.js 在接收字符串并进行编码时,首先会依据字符集确定编码模式(Encoding Mode)。二维码标准支持四种基础模式:
- 数字模式(Numeric Mode):只包含
0-9,每 3 个数字仅占用 10 位二进制(压缩率极高); - 字母数字模式(Alphanumeric Mode):包含数字、大写英文字母和 9 个特殊符号(
$ % * + - . / : 空格),每 2 个字符压缩占用 11 位; - 8位字节模式(Byte Mode / Binary):每字符按 8 位存储,主要用于 ASCII 与 UTF-8 字节串;
- 日文汉字模式(Kanji Mode):专门针对双字节 Shift JIS 进行 13 位压缩。
二维码的最大理论上限出现在 Version 40(177×177 矩阵)。以下为不同纠错级别在 Version 40 下能够承载的最大字符数量边界:
| 纠错级别 (correctLevel) | 理论容错率 | 纯数字最大容量 (Numeric) | 字母数字容量 (Alphanumeric) | 8位字节容量 (Byte / ASCII) | UTF-8 中文汉字估算 |
|---|---|---|---|---|---|
| QRCode.CorrectLevel.L | ~7% | 7,089 字符 | 4,296 字符 | 2,953 字节 | ~984 汉字 |
| QRCode.CorrectLevel.M | ~15% | 5,596 字符 | 3,391 字符 | 2,331 字节 | ~777 汉字 |
| QRCode.CorrectLevel.Q | ~25% | 3,993 字符 | 2,420 字符 | 1,663 字节 | ~554 汉字 |
| QRCode.CorrectLevel.H | ~30% | 3,057 字符 | 1,852 字符 | 1,273 字节 | ~424 汉字 |
标准
qrcode.js 内部默认采用 8-bit Byte 模式。对于标准的英文字符和网址,一个字符仅占 1 个字节。然而,对于常用汉字,经由 UTF-8 编码转换后,每个汉字通常占据 3 个字节。这意味着,在 Level H 纠错模式下,即便采用庞大的 Version 40,二维码也仅仅能容纳 420 多个中文汉字!如果使用了更常见、更便于手机对焦扫描的低版本(如 Version 5 或 10),容纳 30-80 个汉字就会逼近容量极限。
四、选型与容量超限防御最佳实践
当开发者向 qrcode.js 传入的数据长度超过当前纠错级别与 Version 40 允许的上限时,库内部会直接抛出未捕获的运行时异常:
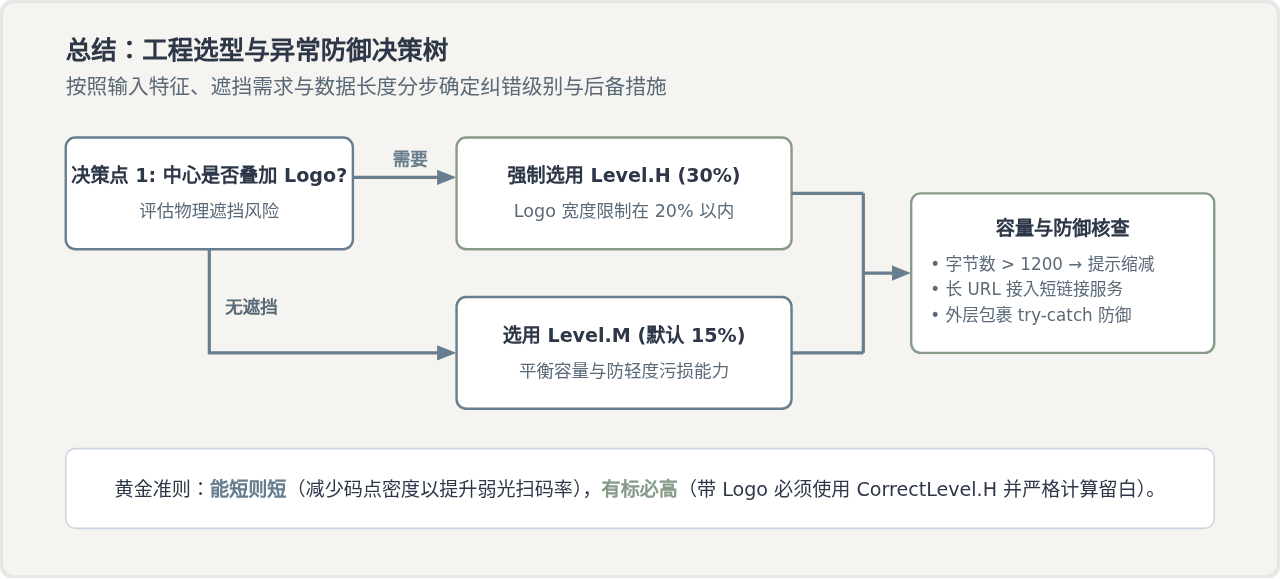
Error: code length overflow. (1850>1273)如果未对入参进行防御与长度控制,会导致前端页面脚本报错中断,二维码区域空白。因此,在企业级工程中,建议采用以下三套协同策略:
1. 动态自适应纠错级别(降级机制)
当业务数据具有不确定性(例如动态 URL 附带复杂的追踪 query 参数)时,若优先保证二维码能够成功生成,可预先检测字节长度。如果高纠错级别无法满足容量,程序应平滑降级到 Level.M 或 Level.L。
function createSafeQRCode(element, text, hasLogo) {
    // 1. 采用 Blob 计算真实的 UTF-8 字节长度
    var byteLength = new Blob([text]).size;

    // 2. 默认纠错级别
    var targetLevel = hasLogo ? QRCode.CorrectLevel.H : QRCode.CorrectLevel.M;

    // 3. 防御降级:若在 H 级别下字节超出阈值,平滑降级至 M 或 L
    if (hasLogo && byteLength > 1200) {
        console.warn("数据量接近 H 级别极限,已自动降级为 Level.Q 并缩小 Logo 占比");
        targetLevel = QRCode.CorrectLevel.Q;
    }
    if (byteLength > 1600) {
        targetLevel = QRCode.CorrectLevel.M;
    }
    if (byteLength > 2300) {
        targetLevel = QRCode.CorrectLevel.L;
    }

    try {
        return new QRCode(element, {
            text: text,
            width: 256,
            height: 256,
            correctLevel: targetLevel
        });
    } catch (err) {
        console.error("生成二维码失败,数据严重超限:", err);
        element.innerHTML = "<div class='qr-fallback'>二维码数据超限,请缩短文本内容</div>";
    }
}
2. Logo 尺寸与纠错级别的面积对应法则
许多开发者有一个误区:“只要设置了 Level.H(30% 容错),我就可以在二维码中心放一个占据 30% 宽高的 Logo”。
这是致命的计算错误! 面积占比是按宽高的平方计算的:若 Logo 的宽高各占二维码的 30%,其遮挡面积其实仅为 30% × 30% = 9%。若将 Logo 的宽高设为二维码的 50%,遮挡面积则高达 50% × 50% = 25%,此时在 Level.H 下已逼近识别瘫痪的临界点;一旦镜头反光或打印稍微模糊,即可造成扫码失败。
工业级安全建议:
- 使用
Level.H时,中心 Logo 的宽高比例不宜超过二维码总宽高的 20% ~ 22%(面积占比约 4% ~ 5%); - 切勿遮挡二维码四角的三个“回”字形位置探测图形(Position Detection Patterns)和校正图形;
- Logo 边缘务必保留 2~4px 的纯白边框,隔绝与周围数据码点的粘连。
五、总结与注意事项清单
在实际项目中使用 qrcode.js 时,可对照以下清单排查潜在隐患:
- 不要传递数值字面量给 correctLevel:尽管
QRCode.CorrectLevel.M的底层值恰好是0,但H的底层值是2、Q是3。直接传递0, 1, 2, 3极易记混导致非预期行为。 - 长链接优先转为短链接:无论纠错级别如何,字符越多,二维码的 Version 就越高,矩阵点阵就会成倍变密。在移动端屏幕(如 200px 宽度的弹窗中),过密的二维码极难被低端机型或夜间微距镜头识别。将超过 100 字符的长链接缩短至 20 字符以内,可以显著提升扫码成功率。
- UTF-8 中文转码预处理:标准
qrcode.js如果遇到直接传入的中文字符串,在部分浏览器中可能触发异常。常规解决方案是在传入前使用encodeURIComponent进行百分号编码,或确保页面及脚本构建工具采用统一的 UTF-8 标准。
JS语法错误会阻止加载吗?区分SyntaxError与资源加载失败
2026-11-05 16:08:46
JavaScript常见SyntaxError语法错误排查与修复方法
2026-11-05 13:58:44
JS中slice、substring和substr截取字符串的区别
2026-11-05 13:43:47
JS 转 TS 手动迁移最佳实践:从配置 tsconfig 到消除 any 类型
2026-11-05 11:53:32
为什么JS数组push后得到的是数字而不是数组?
2026-11-05 09:59:18
相关标签:







