JavaScript下载的文件名乱码或默认名为unknown,怎么指定文件名
针对JavaScript在前端触发文件下载时出现的默认名称为unknown或中文乱码问题,详细梳理浏览器同源限制、Content-Disposition响应头编码规范及前端Blob动态创建标签的核心机制,并给出前后端完整的解决方案。
在前端使用 JavaScript 触发文件下载时,文件名变成 unknown(或 download、无扩展名)以及中文乱码,本质上只有两个源头:文件名传递链断裂(浏览器未读到有效名称,退回兜底值)与字符编码协议不匹配(HTTP 标头编码规范与客户端解码方式不一致)。本文直接说明这两种现象的排查逻辑、前后端标准配置,以及如何编写健壮的客户端代码稳定指定文件名。
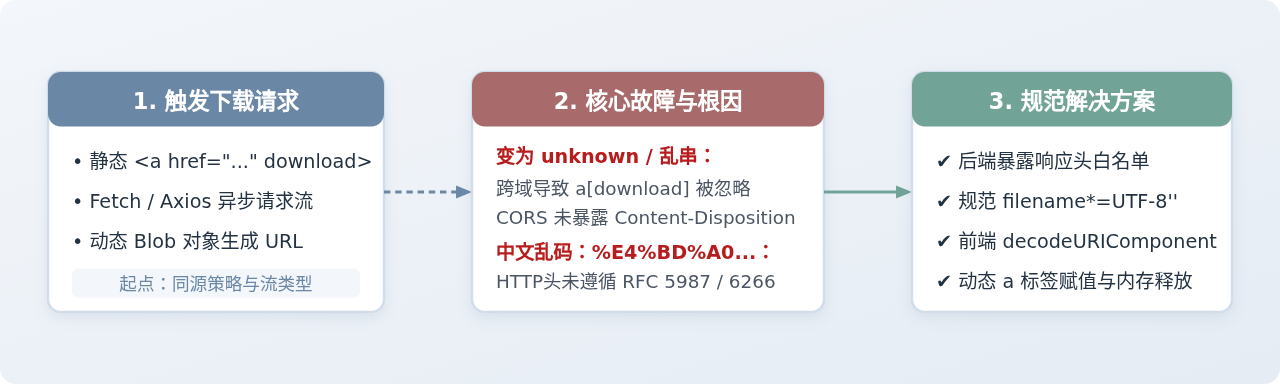
一、现象与根因:为什么文件名会变成 unknown?
在实际业务中,当用户点击“下载导出”按钮时,浏览器下载栏显示的文件名常常退化为 unknown、download 或者一段随机哈希串,这主要由以下三种情况引起:
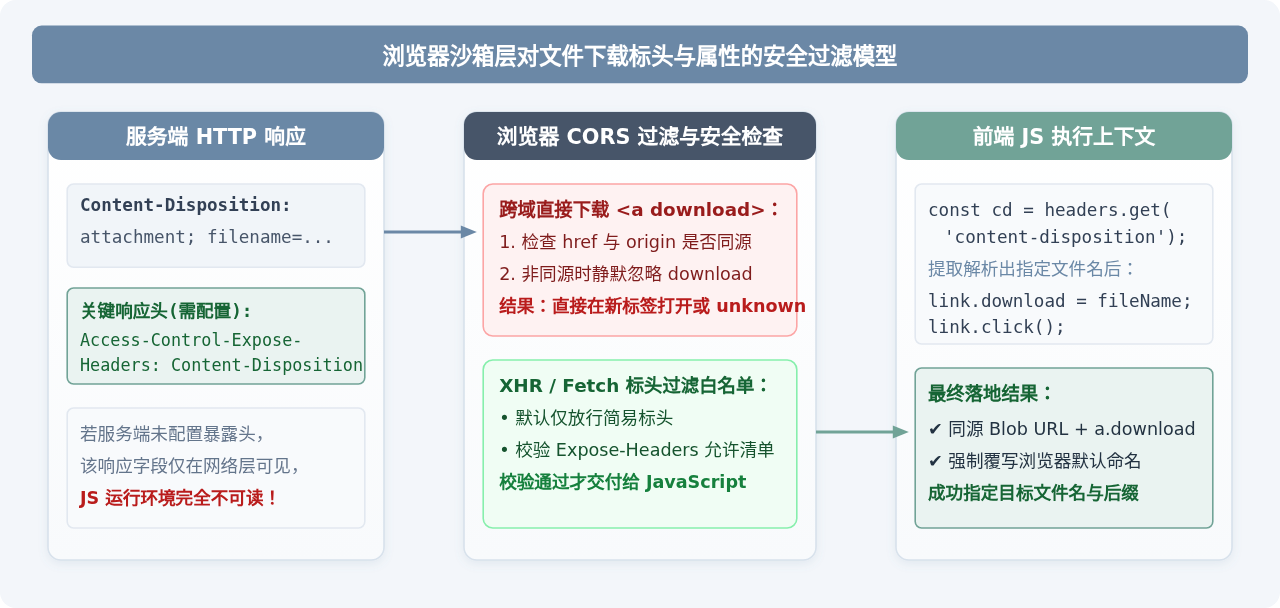
1. 静态超链接的 download 属性受跨域(CORS)策略限制
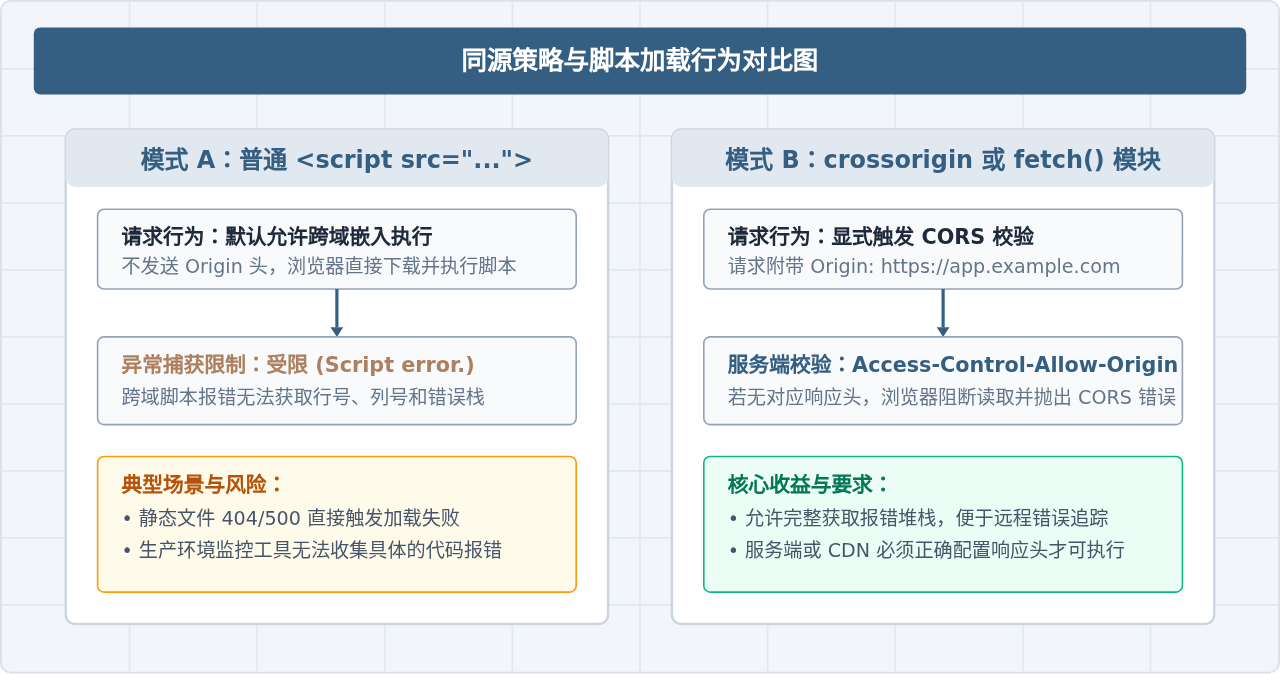
最简便的下载方式是直接在 HTML 中编写 <a href="https://oss.example.com/file.pdf" download="统计报表.pdf">。然而,现代浏览器的安全规范明确规定:当 href 指向的资源与当前页面不同源时,download 属性直接被忽略。此时浏览器直接按照跨域目标服务器的默认规则发起导航或下载,由于无法干预跨域响应,指定的名称完全失效,若资源 URL 结尾没有明确的文件名与后缀,浏览器便会以 unknown 命名。
2. 前端异步请求拿不到 Content-Disposition 响应头
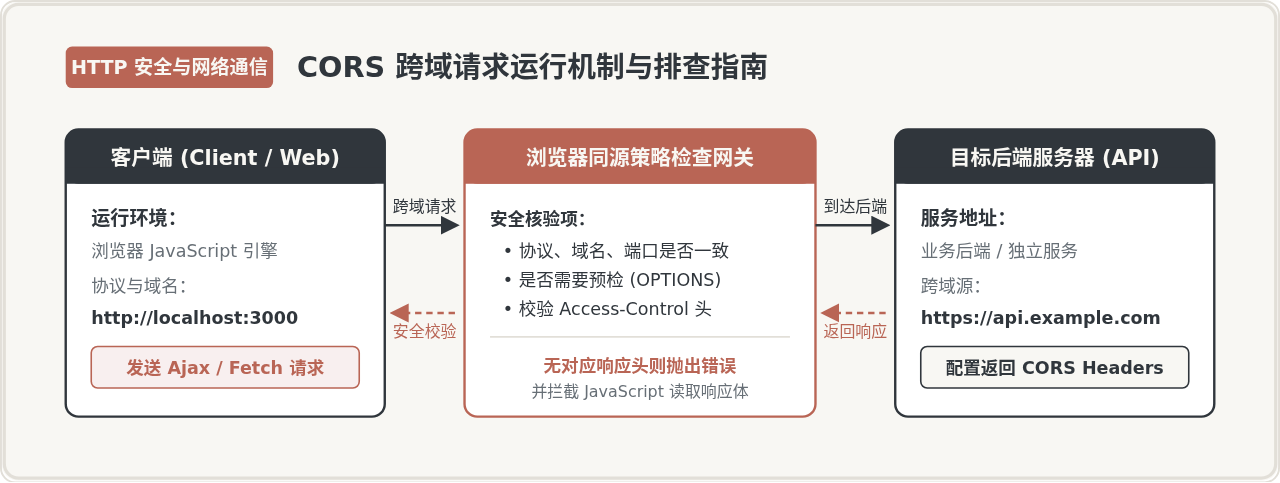
当我们通过 fetch 或 axios 请求后端二进制流(Blob)时,通常需要从服务器返回的 Content-Disposition 响应头中读取原始文件名。但在跨域请求下,浏览器受 CORS 规范限制,默认只向 JavaScript 脚本暴露 6 个基础标头(如 Cache-Control、Content-Language 等)。即使服务端在网络包里输出了 Content-Disposition: attachment; filename=report.xlsx,前端调用 response.headers.get('content-disposition') 拿到的仍然是 null。前端没有做非空兜底或将 null 传给了临时对象,文件名即被写入为 unknown。
3. Blob 对象生成临时链接时遗漏了 download 赋值
使用 URL.createObjectURL(blob) 生成的虚拟地址形式如 blob:https://example.com/8c2a4f...。Blob URL 本身并不携带任何文件名或文件类型后缀元数据。若动态创建 <a> 标签时未显式给 a.download 设置有效字符串,或者赋值了异步未完成的变量(即 undefined),浏览器无法从虚拟 URL 获知任何语义信息,只能将其保存为 download 或 unknown。
二、现象与根因:为什么文件名会出现中文乱码?
另一个顽疾是下载的文件包含中文时出现乱码。常见的乱码形态主要有两类:一种是形如 %E4%B8%AD%E6%96%87.xlsx 的 URL 百分号编码字符串;另一种是形如 ????.xlsx 或 ä¸æ.xlsx 的乱码字符。产生这类问题的原因是 HTTP 标头编码规范历史演进导致的不一致:
- HTTP/1.1 基础规范限制:早期的 RFC 2616 规定 HTTP Header 仅支持 US-ASCII 编码字符。如果服务端代码直接在 Header 中拼接中文(例如
Content-Disposition: attachment; filename="中文测试.xlsx"),服务端运行时通常会将其以ISO-8859-1截断编码,或者抛出非法字符异常。浏览器收到后按单字节解析,就会呈现为双字节错乱的“乱字符”。 - 简单的 URL 编码但未告知客户端:很多后端开发者为避免上述报错,对文件名执行了
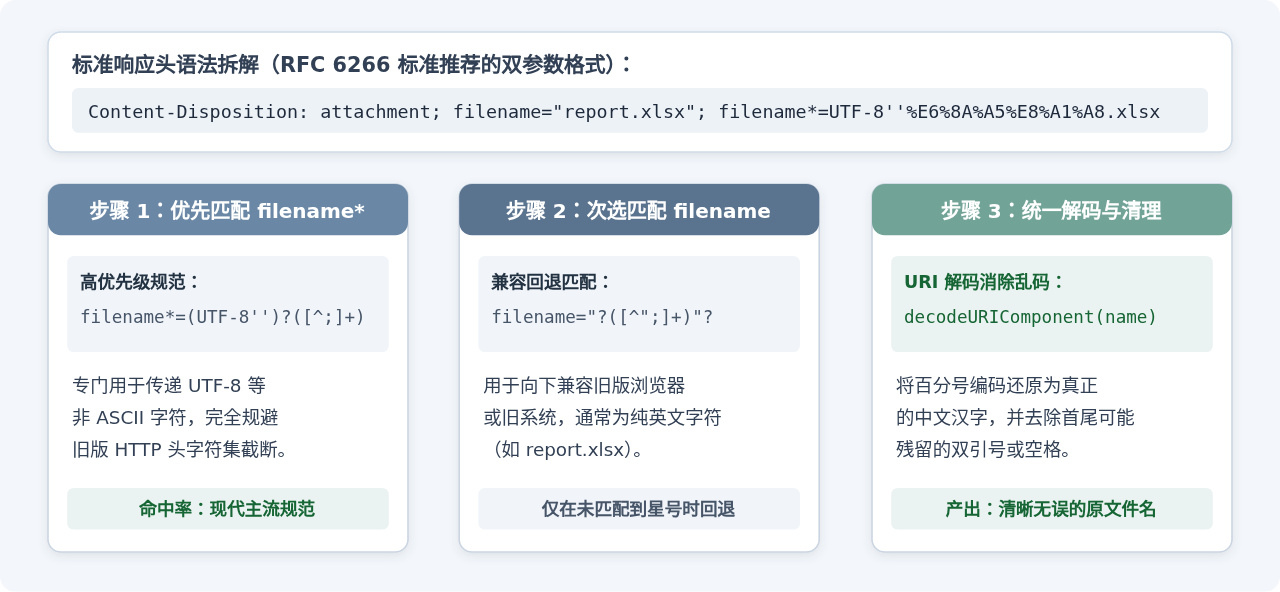
URLEncoder.encode("中文测试.xlsx", "UTF-8"),使得 Header 输出为filename="%E4%B8%AD%E6%96%87%E6%B5%8B%E8%AF%95.xlsx"。然而,普通的filename=参数在标准中并不要求客户端进行 URL 反编码,浏览器直接将其当作纯文本字面量写入本地磁盘,用户看到的就是包含大量百分号的未解码字符串。 - 现代 RFC 5987 / RFC 6266 标准语法支持不全:为了彻底解决非 ASCII 字符传输问题,现代标准引入了扩展参数语法:
filename*=UTF-8''<URL编码内容>。注意其中的星号(*)以及UTF-8''前缀。若服务端仅输出该扩展参数,而前端解析 Header 的正则表达式只匹配传统的filename="...",前端就会提取失败并回退到unknown。反之,若前端未按标准对filename*中的编码部分执行decodeURIComponent,同样会出现乱码。
三、核心解决步骤与前端落地实现
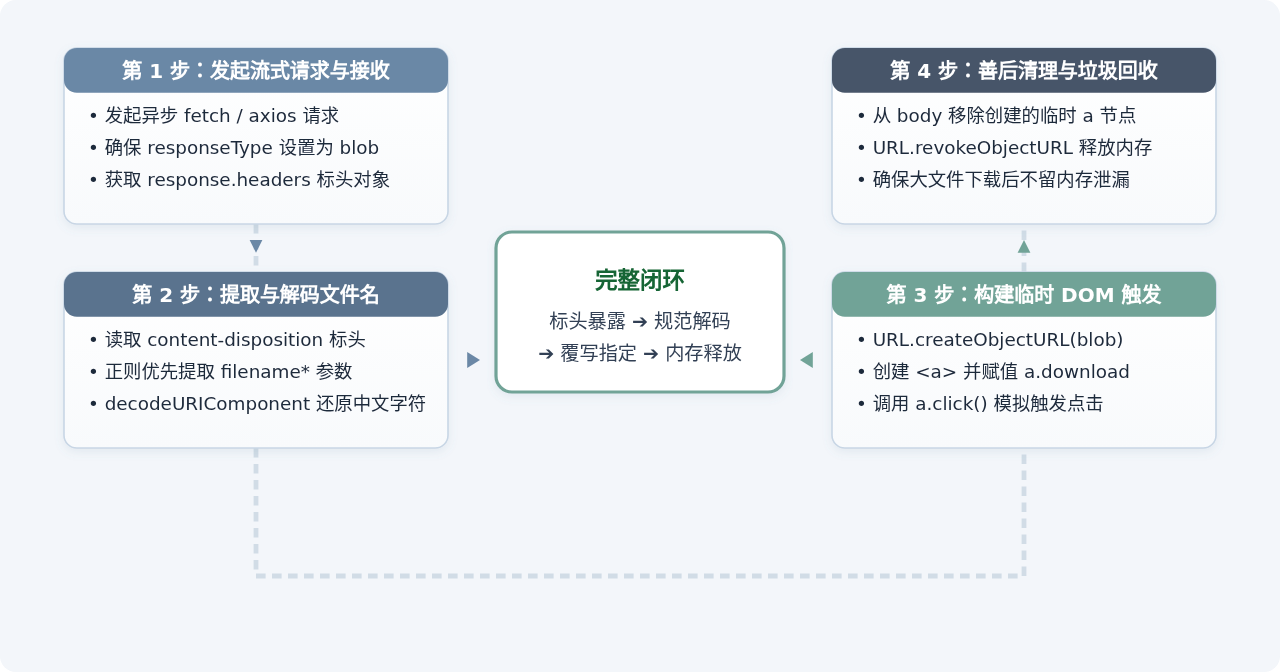
为了同时解决文件名 unknown 和中文乱码,应当遵循一套标准化处理流程:服务端正确输出响应头并配置跨域暴露清单,前端通过通用解析函数提取真实文件名,最后使用动态 <a> 标签完成下载和内存清理。
1. 编写健壮的文件名提取函数
在解析 Content-Disposition 时,必须兼顾兼容性和标准语法。以下函数优先提取 filename*,其次提取普通的 filename,并自动去除包裹的引号与进行百分号反编码:
/**
 * 从 Content-Disposition 响应头中提取安全解码的文件名
 * @param {string | null} dispositionHeader 服务端返回的 content-disposition 字符串
 * @param {string} defaultName 当提取失败时的默认保底文件名
 * @returns {string} 最终指定的文件名
 */
function extractFileNameFromHeader(dispositionHeader, defaultName = 'download_file') {
  if (!dispositionHeader) {
    return defaultName;
  }

  // 1. 优先匹配 RFC 5987 / RFC 6266 标准的 filename*=UTF-8''xxx 或 filename*=utf-8'zh_cn'xxx
  const rfc5987Regex = /filename\*=(?:UTF-8|utf-8)?''?([^;]+)/i;
  const rfcMatch = dispositionHeader.match(rfc5987Regex);
  if (rfcMatch && rfcMatch[1]) {
    try {
      return decodeURIComponent(rfcMatch[1].trim());
    } catch (e) {
      return rfcMatch[1].trim();
    }
  }

  // 2. 次选匹配传统 filename="xxx" 或 filename=xxx
  const fallbackRegex = /filename="?([^";]+)"?/i;
  const fallbackMatch = dispositionHeader.match(fallbackRegex);
  if (fallbackMatch && fallbackMatch[1]) {
    const rawName = fallbackMatch[1].trim();
    try {
      // 若服务端错误地在普通 filename 里使用了 encodeURIComponent,此处尝试还原
      return decodeURIComponent(rawName);
    } catch (e) {
      return rawName;
    }
  }

  return defaultName;
}
2. 使用 Fetch / Axios 触发流下载的标准代码模板
无论接口底层是 Node.js、Java、Go 还是 Python,前端在接收到 Blob 数据流后,使用内存临时链接(Object URL)赋予临时标签 download 属性下载是通用性最高的方案:
/**
 * 完整标准的异步下载文件函数
 * @param {string} url 下载接口地址
 * @param {string} fallbackFileName 备选兜底文件名
 */
async function downloadFileWithCustomName(url, fallbackFileName = '未命名文件.xlsx') {
  try {
    const response = await fetch(url, {
      method: 'GET',
      headers: {
        'Accept': 'application/octet-stream'
      }
    });

    if (!response.ok) {
      throw new Error(`下载失败,HTTP状态码: ${response.status}`);
    }

    // 从响应标头提取服务端指定的名称
    const disposition = response.headers.get('content-disposition');
    const finalFileName = extractFileNameFromHeader(disposition, fallbackFileName);

    // 将二进制流转为内存 Blob 对象
    const blob = await response.blob();
    const objectUrl = window.URL.createObjectURL(blob);

    // 创建隐藏的临时 a 标签触发保存
    const link = document.createElement('a');
    link.href = objectUrl;
    link.download = finalFileName; // 此处强制覆写下载文件名
    link.style.display = 'none';
    document.body.appendChild(link);

    link.click();

    // 善后清理:移除 DOM 并释放浏览器内存
    document.body.removeChild(link);
    window.URL.revokeObjectURL(objectUrl);
  } catch (error) {
    console.error('下载过程发生异常:', error);
  }
}注意内存清理:URL.createObjectURL() 会在当前页面的内存堆中持续保留对 Blob 的引用,若频繁下载大文件而未调用 URL.revokeObjectURL(objectUrl),容易导致浏览器内存泄漏。
四、服务端配合要点与常见框架配置
要让客户端顺利拿到并解析文件名,服务端必须完成两件事:1. 在跨域配置中暴露 Content-Disposition;2. 按照 RFC 6266 输出标准标头。以下是主流服务端环境的具体配置方式:
1. Node.js (Express / Koa)
// Express 示例
app.get('/api/export', (req, res) => {
  const fileName = '月度营收报表.xlsx';
  const encodedName = encodeURIComponent(fileName);

  // 1. 允许跨域客户端读取该标头
  res.setHeader('Access-Control-Expose-Headers', 'Content-Disposition');

  // 2. 写入符合规范的 Content-Disposition
  res.setHeader(
    'Content-Disposition',
    `attachment; filename="fallback.xlsx"; filename*=UTF-8''${encodedName}`
  );
  res.setHeader('Content-Type', 'application/vnd.openxmlformats-officedocument.spreadsheetml.sheet');

  fileStream.pipe(res);
});
2. Nginx 反向代理层统一配置
如果接口经过 Nginx 转发,常常因为网关未透传或重写 Header 导致丢失。可以在 location 块添加配置:
location /api/ {
    # 代理传递后端响应头
    proxy_pass http://backend_server;

    # 确保暴露 Content-Disposition 给跨域前端
    add_header 'Access-Control-Expose-Headers' 'Content-Disposition' always;
}
3. Java (Spring Boot)
@GetMapping("/export")
public ResponseEntity<Resource> exportFile() {
    String fileName = "用户数据表.xlsx";
    ContentDisposition contentDisposition = ContentDisposition.builder("attachment")
            .filename("fallback.xlsx", StandardCharsets.US_ASCII)
            .filename(fileName, StandardCharsets.UTF_8) // 自动构建 filename*=UTF-8''...
            .build();

    return ResponseEntity.ok()
            .header(HttpHeaders.ACCESS_CONTROL_EXPOSE_HEADERS, HttpHeaders.CONTENT_DISPOSITION)
            .header(HttpHeaders.CONTENT_DISPOSITION, contentDisposition.toString())
            .contentType(MediaType.APPLICATION_OCTET_STREAM)
            .body(fileResource);
}
五、常见问题排查与速查矩阵
当遇到下载异常时,打开浏览器的开发者工具(F12),切换到 Network(网络) 面板,点击对应的下载请求,按下表排查:
| 异常现象 | Network 响应头排查项 | 排查结论与修复动作 |
|---|---|---|
文件名变成 unknown 或随机串 |
查看 Response Headers 是否存在 Content-Disposition 以及 Access-Control-Expose-Headers |
若无 Expose-Headers,属于跨域标头被浏览器隔离。在后端添加暴露头配置,前端加默认兜底名称。 |
| 直接在新标签打开预览,未触发下载 | 查看当前点击的是否为跨域的 <a href="..." download> |
跨域 download 属性被浏览器忽略。改用 fetch 转为本地 Blob 后再触发下载。 |
文件名显示为 %E6%8A%A5%... |
查看 Content-Disposition 是否仅存在 filename= 且内容为 URL 编码 |
前端增加 decodeURIComponent 逻辑,或后端改为 filename*=UTF-8'' 标准写法。 |
文件名中文变成乱码字符(如 ???) |
查看服务端是否直接在 Header 拼接中文,编码为 ISO-8859-1 | 后端禁止在标头直接写入非 ASCII 字符,必须转为 UTF-8 并以 filename*= 传出。 |
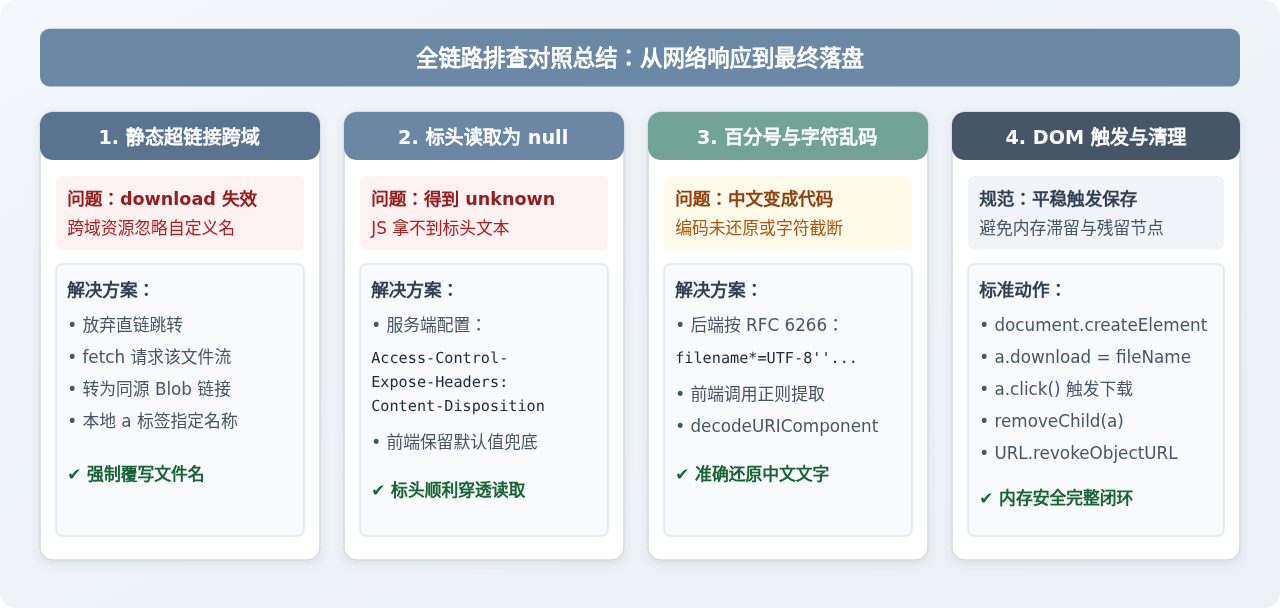
六、总结
指定 JavaScript 下载的文件名,核心在于保证文件名信息在传输和提取过程中不发生丢失与截断:
- 跨域直链下载无法指定文件名时,应改用
fetch将文件先读取为客户端同源Blob,再通过赋予<a>标签download属性触发下载; - 服务端传递文件名必须配置
Access-Control-Expose-Headers: Content-Disposition,并优先采用filename*=UTF-8''...遵循 RFC 6266 标准传递中文名称; - 前端在提取文件名时,使用正则双重匹配(优先
filename*,回退filename),配合decodeURIComponent还原中文字符,并在触发保存后及时调用URL.revokeObjectURL()释放资源。
JavaScript异步发送HTTP请求时怎么优雅地处理错误
2026-11-05 17:10:44
5款主流JS在线运行工具对比:CodePen、JSFiddle与StackBlitz怎么选
2026-11-05 17:04:04
JavaScript入门书籍避坑:这些书不适合初学者
2026-11-05 16:31:15
JS使用Math.round实现保留两位小数的原理与代码
2026-11-05 15:35:55
JavaScript 原生 Date 对象怎么实现日期加减
2026-11-05 14:30:00