

什么时候不该用JS reduce?简单场景的替代方案
系统剖析JavaScript中Array.prototype.reduce在简单场景下的误用痛点,提供map、filter、find、flatMap及Object.groupBy等语义化替代方案与代码重构指南。
JavaScript 中的 Array.prototype.reduce 堪称数组方法中的“瑞士军刀”,仅凭累加器与回调便能复刻几乎所有集合操作。然而在实际工程中,这种万能性常常诱导开发者写出晦涩难懂、心智负担沉重且潜藏性能陷阱的过度设计代码。在元素变换、子集筛选、首项检索、数组拍平与分类分组等常见简单场景下,使用语义明确的声明式 API(如 map、filter、find、flatMap、Object.groupBy)是远比 reduce 更清晰高效的选择。
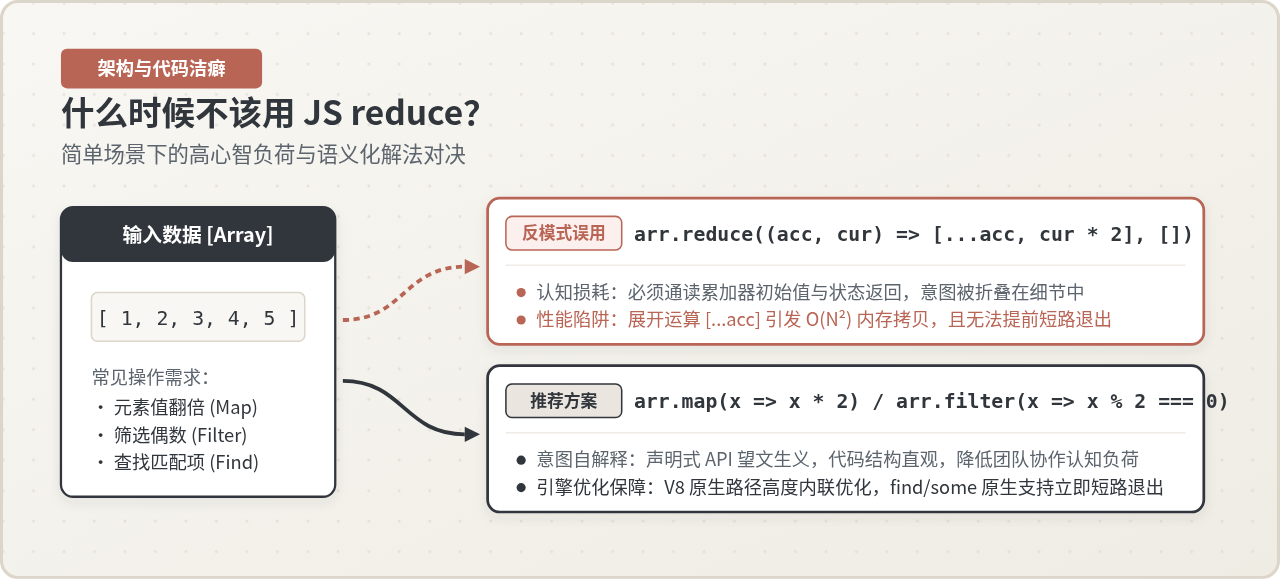
一、核心矛盾:为什么灵活性反噬了代码可读性?
在计算机科学与函数式编程中,reduce 对应着“折叠”(Fold 或 Catamorphism)概念。它的本质是接受一个初始状态,沿着集合的每个元素依次推演,并将前一步的返回值作为下一步的入参,最终收敛为一个单一产物。
正因为 reduce 的定义如此底层与抽象,它在赋予开发者无穷自由度的同时,也剥离了操作本身的“领域意图”。当你看到 arr.map(...) 时,你的大脑会立即建立起“输入与输出元素数量严格相等的一对一映射”模型;当你看到 arr.filter(...) 时,你明确知道这是“按条件剔除元素的子集过滤”;而当你看到 arr.reduce(...) 时,你无法做任何预设假定——你必须从头读到尾,探查初始值是空数组、对象还是数值,再逐行解析回调内部到底是在变异引用还是在构建新集合。
reduce 模拟简单的内置操作,无异于每次乘法运算都要手写循环累加——虽然逻辑等价,但极大地消耗了团队的代码审查与维护心智。
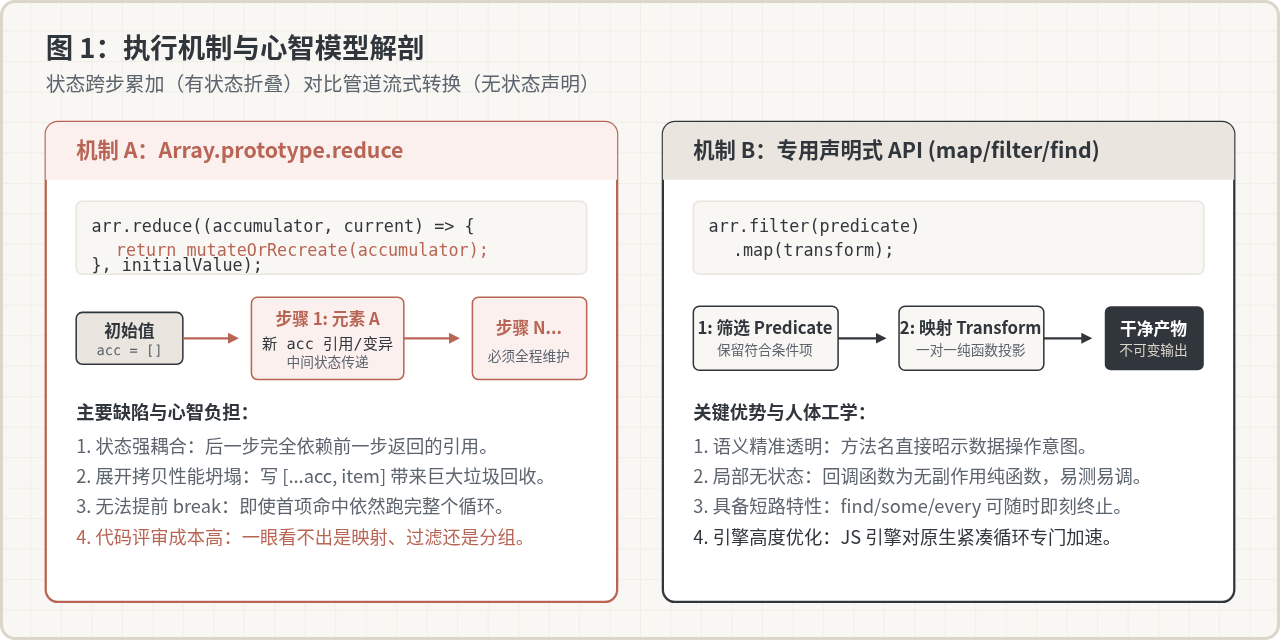
如图 1 所示,reduce 在执行过程中具有高度的状态连续性,前后的累加变量强力耦合。一旦在回调中混入浅拷贝展开运算或隐蔽的副作用,其心智负荷与性能消耗会成倍放大。
二、典型误用场景一:用 reduce 代替单阶段映射与过滤
1. 单纯的元素映射(应当使用 map)
许多刚掌握 reduce 的开发者喜欢用它来完成字段提取或数值翻倍。这种写法通常伴随着向累加器数组中压入新项的操作:
// ❌ 反模式:使用 reduce 进行单纯的元素映射
const rawUsers = [{ id: 1, name: 'Alice' }, { id: 2, name: 'Bob' }];

const userNames = rawUsers.reduce((acc, user) => {
  acc.push(user.name);
  return acc;
}, []);
更危险的变体是追求所谓的“纯函数不可变性”,在每次迭代中使用展开运算符:
// ❌ 严重反模式:展开运算符引发 O(N²) 内存灾难
const userNames = rawUsers.reduce((acc, user) => [...acc, user.name], []);[...acc, user.name] 时,JavaScript 引擎都必须在内存中分配一个长度为 k + 1 的全新数组,并将前 k 个元素完整复制一遍。当数组有 10,000 个元素时,这一操作将发生约 5000 万次内存复制,并产生海量的垃圾回收(GC)标记与暂停,导致原本微秒级的任务耗时数秒。
标准替代方案:直接使用 map
// ✅ 推荐:语义明确且高效
const userNames = rawUsers.map(user => user.name);
map 清晰告知所有阅读者:输出数组与原数组长度完全相同,且每个元素均为纯函数映射,无任何副作用与状态依赖。
2. 单纯的条件过滤(应当使用 filter)
同理,使用 reduce 配合 if 分支剔除无效元素也是常见反模式:
// ❌ 反模式:使用 reduce 进行条件筛选
const activeUsers = rawUsers.reduce((acc, user) => {
  if (user.active) {
    acc.push(user);
  }
  return acc;
}, []);

// ✅ 推荐:使用 filter
const activeUsers = rawUsers.filter(user => user.active);
3. “先过滤后映射”的权衡:filter().map() vs flatMap
不少开发者为 reduce 辩护的核心理由是:“如果我既要 filter 又要 map,用 reduce 只需要遍历一次数组,而链式调用要遍历两次,性能更高”。
这种直觉在现代 JavaScript 引擎面前往往是不成立的伪优化。在通常的前端业务数据体量(几十至几万条数据)下,两次高度紧凑的单指令原生遍历与一次包含复杂闭包环境及条件分支的 reduce 相比,执行耗时差距几乎在 0.1 毫秒以内,而代码的声明式美感却荡然无存。
如果你确实处理极端庞大数据集且追求单次遍历,现代 JavaScript 提供了原生的 flatMap 方法:
// ✅ 现代方案:利用 flatMap 实现单次遍历过滤并映射
const activeNames = rawUsers.flatMap(user =>
  user.active ? [user.name] : []
);
当回调返回空数组 [] 时,该项被自动剔除;当返回包含单值的数组时,元素被展开保留。这种方式兼顾了单次遍历的特性与函数式纯粹性。
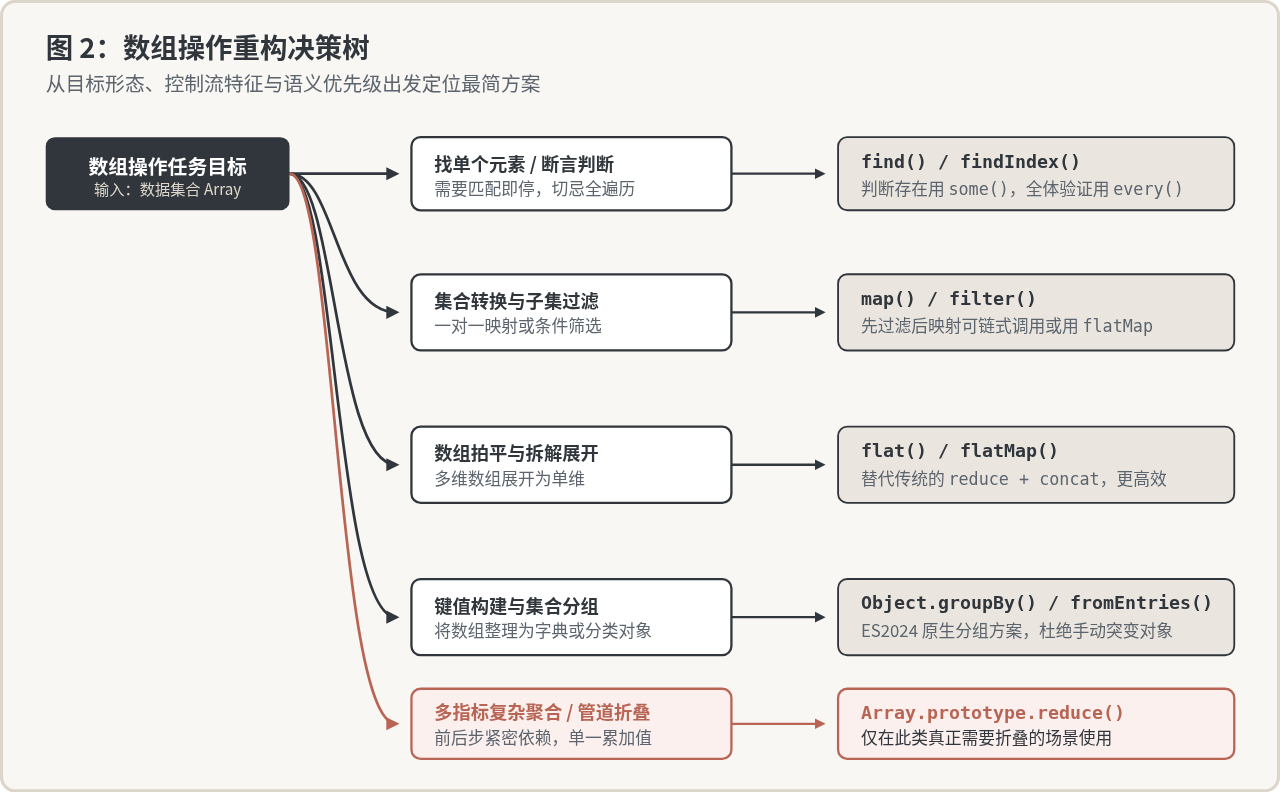
三、典型误用场景二:查找、断言与极值计算
1. 寻找匹配元素(应当使用 find / findIndex)
这是 reduce 最具危害性的使用场景之一。reduce 在规范中被定义为必须完整遍历数组的每一个索引(除非手动抛出异常),它不支持短路(Short-circuit)机制。
// ❌ 严重反模式:无法提前退出的查找操作
const target = items.reduce((found, item) => {
  if (found) return found;
  return item.id === targetId ? item : null;
}, null);
如果 items 中有 100,000 个元素,即便目标项恰好位于索引 0,上述 reduce 仍会固执地执行完剩余的 99,999 次空转循环。
// ✅ 推荐:命中即停的 find
const target = items.find(item => item.id === targetId);
find 与 findIndex 一旦回调返回 truthy,底层迭代器立即短路终止,时间复杂度直接从固定的 $O(N)$ 降至最优 $O(1)$。
2. 条件存在性断言(应当使用 some / every)
检查集合中是否存在或全部满足某种状态时,使用 reduce 计算布尔值同样会丧失短路加速能力:
// ❌ 反模式:全量计算布尔断言
const hasAdmin = users.reduce((acc, u) => acc || u.role === 'admin', false);

// ✅ 推荐:支持短路判定的 some 与 every
const hasAdmin = users.some(u => u.role === 'admin');
const allActive = users.every(u => u.active);
3. 计算极值(应当使用 Math.max / Math.min)
// ❌ 过于繁琐的极值计算
const maxVal = numbers.reduce((max, cur) => cur > max ? cur : max, numbers[0]);

// ✅ 推荐:简短直观的标准内置函数
const maxVal = Math.max(...numbers);
注:若数组包含数十万量级元素,直接展开可能触及调用栈参数限制,此时应采用简单的 for...of 循环,不仅不会爆栈,性能也远高于闭包回调。
四、典型误用场景三:集合拍平与对象字典化
1. 扁平化嵌套数组(应当使用 flat)
在 ES2019 之前,由于缺乏原生展平 API,开发者不得不依靠 reduce + concat 递归拍平数组。然而在现代运行时中,这种技巧已经成为过去式:
// ❌ 传统兼容写法:性能低下的 concat 折叠
const matrix = [[1, 2], [3, 4], [5, 6]];
const flattened = matrix.reduce((acc, cur) => acc.concat(cur), []);

// ✅ 现代原生方案:Array.prototype.flat
const flattened = matrix.flat();
flat() 支持传入深度参数(如 flat(2) 或 flat(Infinity)),由 V8 引擎在底层 C++ 层面直接执行内存搬移,相比 JS 作用域内的逐层拼接速度快数倍。
2. 将数组转换为字典对象(应当使用 Object.fromEntries 或 Object.groupBy)
将对象数组根据 id 转为 Hash Map 映射表是前端非常频繁的操作:
// ❌ 反模式:在 reduce 内部手动突变累加器对象
const userMap = users.reduce((map, user) => {
  map[user.id] = user;
  return map;
}, {});

// ✅ 推荐方案 1:Object.fromEntries 声明式构建
const userMap = Object.fromEntries(users.map(u => [u.id, u]));
若场景是按照分类(Category)对数据进行多项分组(Grouping),在 ECMAScript 2024 中,官方已经正式纳入了 Object.groupBy(Node.js 21+ 与所有现代主流浏览器均已全面支持):
// ❌ 冗长且容易遗漏初始空数组判断的 reduce 分组写法
const grouped = inventory.reduce((acc, item) => {
  (acc[item.type] = acc[item.type] || []).push(item);
  return acc;
}, {});

// ✅ 现代标准推荐:Object.groupBy (ES2024 原生特性)
const grouped = Object.groupBy(inventory, item => item.type);
Object.groupBy 返回一个原型为 null 的无污染字典对象,不仅免去了手动检查属性初始化的样板代码,还消除了意外原型污染的安全隐患。
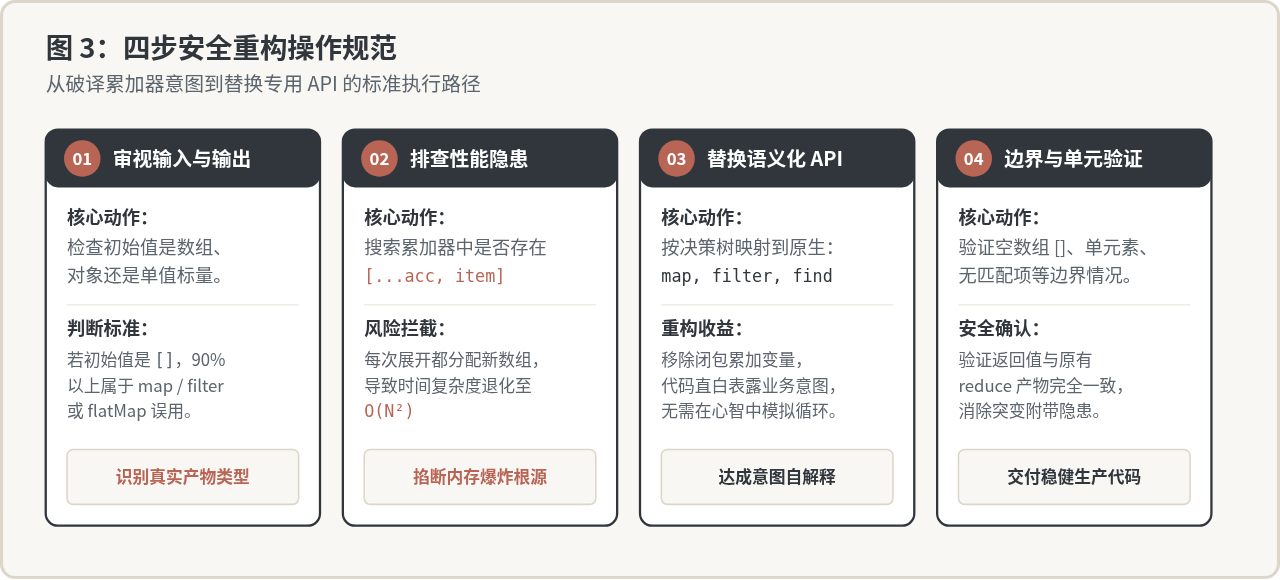
五、实战重构示范:拆解购物车结算的“万能”臃肿函数
为了更深刻地体会重构带来的可读性飞跃,我们来看一段在业务中极为典型的过度工程化代码。某位开发者试图用一个 reduce 同时完成商品的过滤、折扣计算、总金额累加和礼品赠送标记:
// ❌ 重构前:企图用单个 reduce 吞下所有业务责任
const checkoutResult = cartItems.reduce((summary, item) => {
  // 步骤包含:过滤下架商品、校验库存、根据 VIP 打折、分类累计
  if (!item.isAvailable || item.stock <= 0) {
    return summary;
  }
  const finalPrice = isVip ? item.price * 0.9 : item.price;
  summary.totalPrice += finalPrice * item.quantity;
  summary.totalCount += item.quantity;
  summary.validItemIds.push(item.id);
  return summary;
}, { totalPrice: 0, totalCount: 0, validItemIds: [] });
这段代码虽然“只遍历了一次数组”,但存在明显的架构缺陷:
- 职责过度耦合(Single Responsibility Principle 破坏):过滤、价格计算和 ID 提取混合在一个回调闭包中,任何一处需求变动都需要小心翼翼地修改这个臃肿状态。
- 单元测试困难:你无法单独测试“库存有效性判定”或“VIP 定价公式”,必须构造一个庞大的购物车 mock 对象。
运用本文的四步重构法进行责任分离:
// ✅ 重构后:职责单一、流水线清晰、各环节可独立复用测试

// 1. 独立过滤函数:纯业务谓词
const isValidCartItem = item => item.isAvailable && item.stock > 0;

// 2. 计算有效商品集合
const validItems = cartItems.filter(isValidCartItem);

// 3. 提取有效商品 ID(语义透明)
const validItemIds = validItems.map(item => item.id);

// 4. 计算数值总计(专用朴素累加)
const totalCount = validItems.reduce((sum, item) => sum + item.quantity, 0);

const totalPrice = validItems.reduce((sum, item) => {
  const unitPrice = isVip ? item.price * 0.9 : item.price;
  return sum + unitPrice * item.quantity;
}, 0);
重构后的代码在执行效率上依然保持在数微秒内,但可维护性迎来了质的提升:业务逻辑从一团混沌的累加器变异,变成了清晰易懂的声明式数据流。
六、什么时候才真正应该用 JS reduce?
反对滥用并不等于全盘否定。在某些特定的计算场景中,reduce 依然是唯一或者最自然的选择。满足以下条件时,reduce 能够发挥其最大威力:
-
严格的数值单一规约(Fold to Scalar):
如计算纯数值序列的总和、加权平均分,或者向量点乘。此时累加器是一个纯粹的不可变基元类型(Primitive Number),不存在引用变异与垃圾回收惩罚:
const sum = prices.reduce((acc, val) => acc + val, 0); -
函数组合(Pipeline / Compose):
在构建中间件调用链或函数式管道时,将前一个函数的输出作为下一个函数的输入:
const pipe = (...fns) => x => fns.reduce((v, f) => f(v), x); -
前后步骤强依赖的算法推导:
例如解析有限状态机(FSM)的迁移序列、根据路径数组逐步深层解构复杂嵌套对象(
path.reduce((obj, key) => obj?.[key], data))。
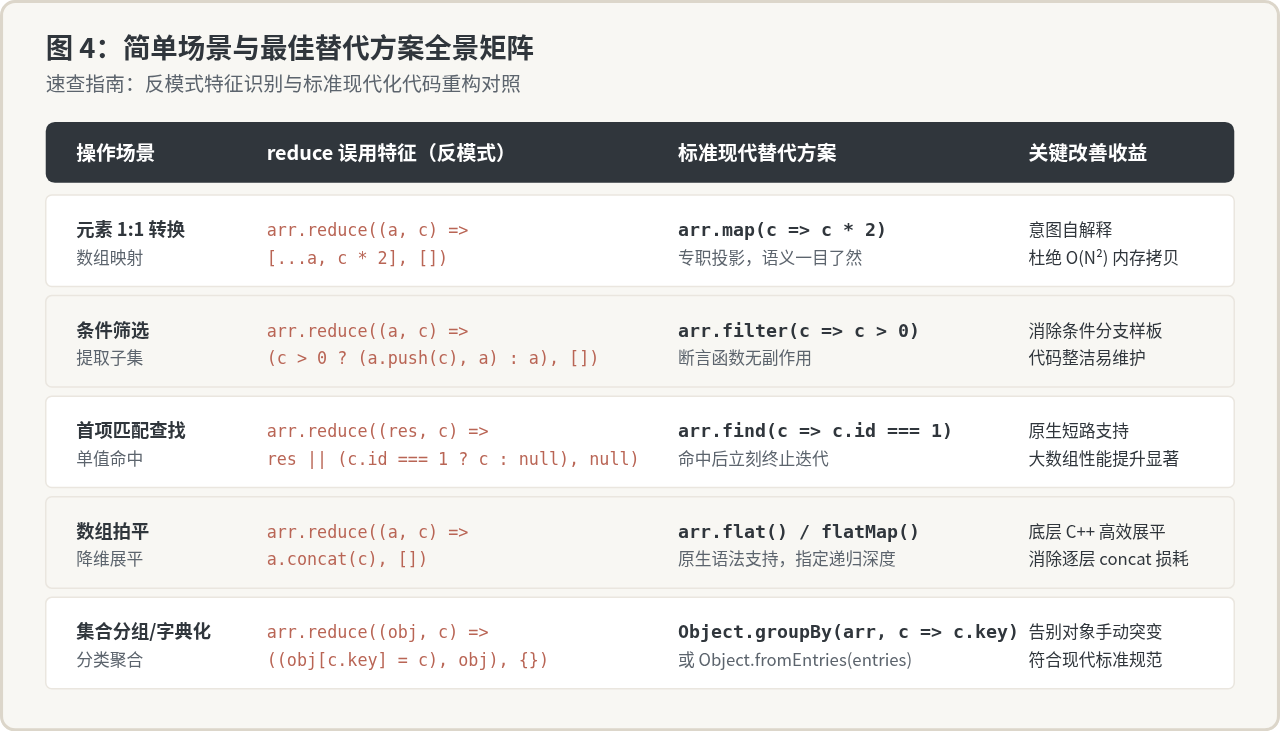
七、总结与对照速查
评价一段代码优劣的标准,绝非“使用了多么高深复杂的通用函数”,而是团队成员能否在三秒钟之内准确理解它的输入、输出与意图。
| 业务诉求 | 不推荐的做法 (reduce 误用) | 首选推荐方案 | 主要优势 |
|---|---|---|---|
| 一对一数据变换 | reduce((acc, x) => [...acc, fn(x)], []) |
arr.map(fn) |
语义自解释,规避 O(N²) 内存拷贝 |
| 筛选符合条件子集 | reduce((acc, x) => if/push, []) |
arr.filter(predicate) |
消除手动状态维护,符合纯函数规范 |
| 寻找特定首个元素 | reduce((res, x) => res || match, null) |
arr.find(predicate) |
原生短路,跳过剩余遍历,性能最优 |
| 检查是否存在/全部满足 | reduce((flag, x) => flag || check(x), false) |
arr.some() / every() |
原生短路,意图极其鲜明 |
| 扁平化嵌套数组 | reduce((a, b) => a.concat(b), []) |
arr.flat() / flatMap() |
C++ 引擎层直接优化,支持递归深度 |
| 根据键名分类分组 | reduce((obj, x) => mutate obj, {}) |
Object.groupBy(arr, fn) |
ES2024 规范原生支持,杜绝对象变异 |
| 多维数值求和与复合折叠 | — | arr.reduce() |
正统应用场景,无可争议的规约利器 |
map、filter、find、some、flat 和 Object.groupBy 中寻找最匹配语义的原生工具。只有当且仅当数据流动具有“跨步状态强关联”或“最终必须折叠为单一复杂标量”时,才将 reduce 请出武器库。克制的使用,才是编写高品质 JavaScript 代码的真正精髓。
D3.js 比例尺与坐标轴的配置详解
2026-11-05 16:54:46
JavaScript怎么遍历对象的Symbol键和不可枚举属性
2026-11-05 13:13:39
封装一个健壮的JS字符串判空工具函数
2026-11-05 12:16:14
JavaScript合并数组的三种常用方法:concat、扩展运算符与push
2026-11-05 11:22:29
JavaScript立即执行函数(IIFE)是什么及基本语法
2026-11-05 10:51:19
相关标签:







