

前端 JS 解压 zip 文件:JSZip 库使用指南
深入讲解如何在前端使用 JSZip 库解压 zip 文件。涵盖环境配置、ArrayBuffer 数据流解析、目录遍历、多类型文件提取、中文文件名乱码修复及性能优化实战。
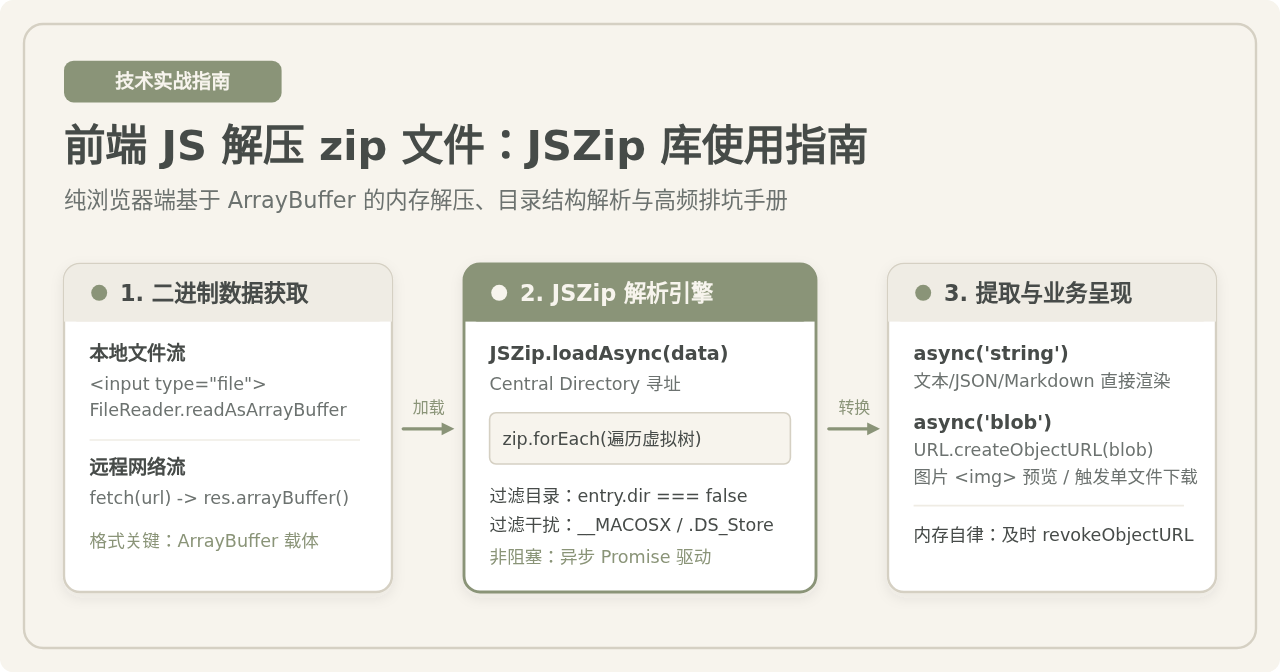
在现代浏览器前端,解压 zip 压缩包最通用且成熟的方案是使用纯 JavaScript 开发的开源库 JSZip。通过将本地用户上传或远程请求下载的 zip 文件转换为二进制 ArrayBuffer,JSZip 可以在前端运行内存中解析压缩包的中央目录结构,并按需提取出纯文本、图片、音频或特定二进制文件。本文将完整梳理在浏览器端引入并使用 JSZip 解压文件的核心原理、规范步骤、各种目标格式的转换方法,并针对开发中经常出现的中文文件名乱码、系统冗余目录干扰以及大文件性能瓶颈等问题提供切实可行的解决方案。
一、核心认知:前端解压 zip 的运作机制与边界
许多初学者在刚接触前端解压时,容易产生一种直觉性误解,认为“前端解压”会像桌面解压软件那样,直接在用户的操作系统中新建一个文件夹并将解压出来的所有文件写到本地磁盘里。
这种认知在逻辑上看似合理,但在浏览器安全沙箱的约束下并不成立。由于浏览器的安全限制,前端脚本无法未经用户逐次授权直接静默修改或写入操作系统的本地文件系统。因此,前端解压本质上是在浏览器分配给当前页面的 V8 堆内存中,对二进制字节流进行解析与还原的过程。
整个链路非常清晰:zip 文件首先被读入为一段连续的二进制内存缓冲区(ArrayBuffer);接着,JSZip 读取 zip 文件末尾的中央目录记录(Central Directory),在内存中建立起压缩包内的虚拟文件目录树;最后,当开发者指定解压某个文件时,JSZip 才会调用解压算法对该条目的压缩字节进行 Deflate 解压,并输出为指定的 JavaScript 内存对象(如 String 或 Blob)。
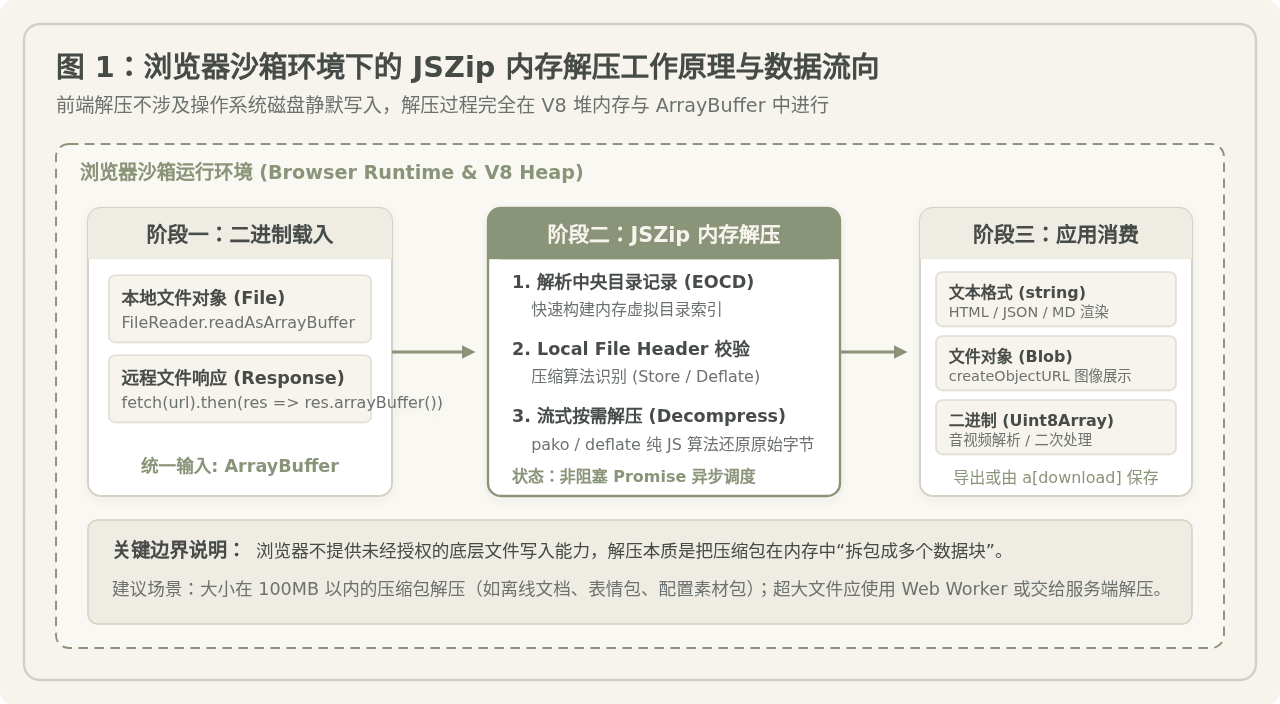
明确这种“内存解压”机制后,我们就能清晰确定前端解压的适用边界:
- 适用场景:文件体量在几十兆以内、需要在前端即时预览展示的场景。例如:Web 端在线预览电子书(EPUB/ZIP)、批量预览图标与照片压缩包、解析富文本模板包或在离线应用中加载配置资源。
- 不适用场景:数百兆乃至数吉字节的特大文件解压。因为解压后的实际数据会膨胀数倍,全量放在前端内存中极易触发浏览器的垃圾回收卡顿(GC Pause)甚至是进程崩溃(Out of Memory)。超大文件应优先交给服务端解压,或通过流式方案由后端切片下发。
二、准备工作:引入与安装 JSZip
JSZip 拥有良好的打包与模块化支持,开发者可以根据当前项目的构建技术栈灵活选择引入方式。
1. 现代化工程构建引入(npm / pnpm / yarn)
在基于 Vite、Webpack 或 Rollup 等现代打包工具的项目中,推荐使用包管理器安装稳定版 JSZip:
npm install jszip
# 或使用 pnpm / yarn
pnpm add jszip
yarn add jszip
在业务代码中通过 ES Module 语法导入使用:
import JSZip from 'jszip';

// 验证库已就绪
const zip = new JSZip();
2. 原生 HTML 或 CDN 脚本引入
对于轻量级的静态页面或无需构建工具的小型项目,可以直接在 HTML 文档的 <head> 或 <body> 底部通过 <script> 标签从公共 CDN 加载:
<!-- 引入 JSZip 3.x 压缩版本 -->
<script src="https://cdn.jsdelivr.net/npm/jszip@3.10.1/dist/jszip.min.js"></script>
<script>
  // CDN 载入后会在全局 window 对象下挂载 JSZip 构造函数
  console.log('JSZip 版本:', window.JSZip.version);
</script>
三、核心实战:前端解压 zip 文件的 5 个标准步骤
解压 zip 文件的核心逻辑可以分为读取、载入、遍历、转换和渲染 5 个标准步骤。为了让读者能够直接落地应用,以下分别提供从本地文件选择器读取与从远程 URL 请求下载两种常见输入源的完整实现。
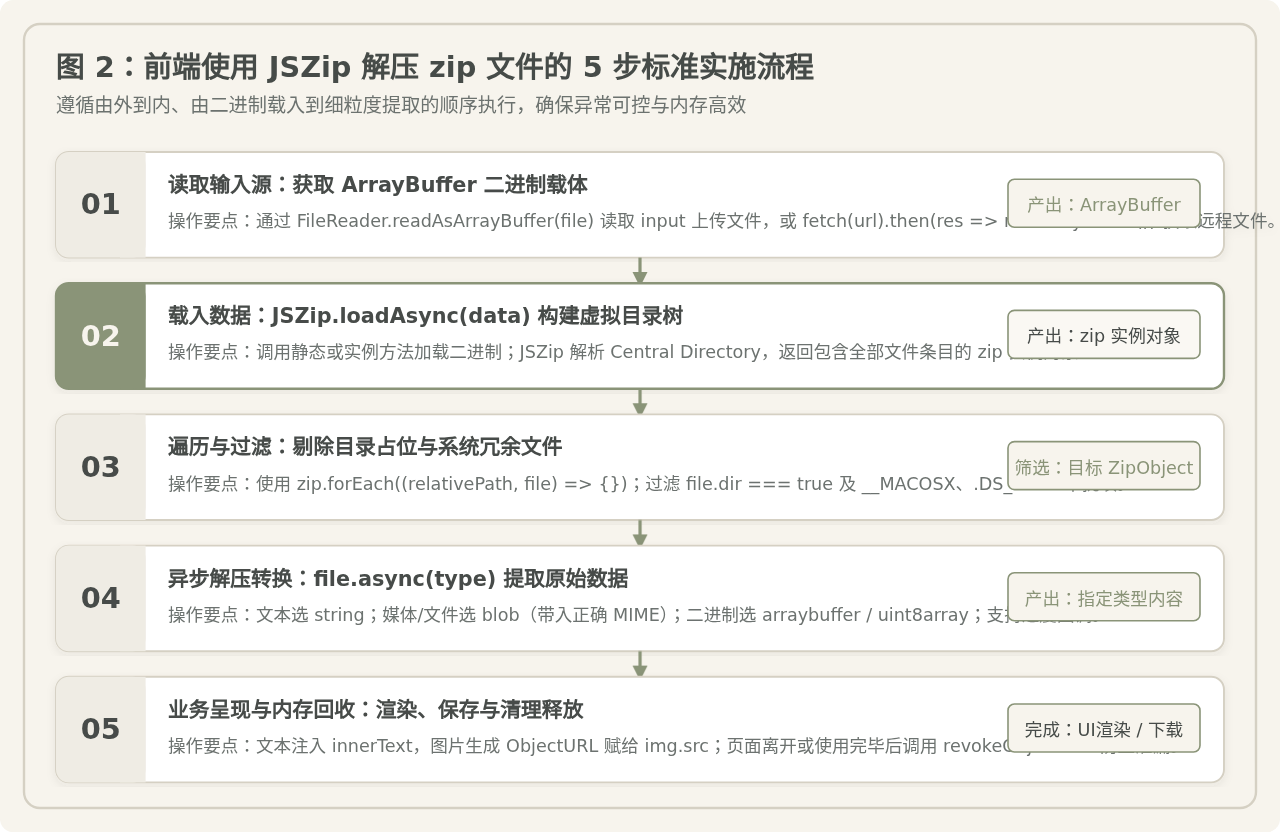
步骤 1:获取源文件的二进制数据(ArrayBuffer)
JSZip 的解析入口 loadAsync 接收多种类型的入参(如 Blob、ArrayBuffer、Uint8Array 或 Base64)。但在浏览器环境中,最稳妥且开销最小的数据载体是 ArrayBuffer。
场景 A:用户通过文件输入框上传本地 zip 文件
// 监听文件选择框改变事件
function getArrayBufferFromFile(fileInput) {
  return new Promise((resolve, reject) => {
    const file = fileInput.files[0];
    if (!file) {
      return reject(new Error('未选择任何文件'));
    }

    const reader = new FileReader();
    reader.onload = (e) => resolve(e.target.result); // 获得 ArrayBuffer
    reader.onerror = (err) => reject(err);
    reader.readAsArrayBuffer(file);
  });
}
场景 B:通过网络请求获取远端服务器上的 zip 文件
async function getArrayBufferFromUrl(url) {
  const response = await fetch(url);
  if (!response.ok) {
    throw new Error(`网络请求失败: ${response.status} ${response.statusText}`);
  }
  // 务必使用 .arrayBuffer() 转换为二进制缓冲区,不能直接传 response
  return await response.arrayBuffer();
}
步骤 2:初始化并载入数据包(JSZip.loadAsync)
得到 ArrayBuffer 后,调用 JSZip.loadAsync(data) 进行异步解析。该方法会快速读取 zip 包末尾的中央目录并返回一个包含完整包信息的 zip 实例。
async function loadZip(arrayBuffer) {
  try {
    const zip = await JSZip.loadAsync(arrayBuffer);
    console.log('zip 文件解析成功,开始遍历内容...');
    return zip;
  } catch (error) {
    console.error('zip 文件损坏或格式不正确:', error);
    throw error;
  }
}
步骤 3:遍历并过滤 zip 包内的文件结构
一个合法的 zip 压缩包内部既包含普通文件,也包含用来维持层级关系的“目录占位项”。此外,macOS 等系统在打包时还会自动注入诸如 __MACOSX/ 以及 .DS_Store 等系统隐藏文件。在提取实际文件前,必须进行过滤。
通过 zip.forEach((relativePath, zipEntry) => ...) 可以遍历压缩包中的每一个条目。条目对象(zipEntry)具有 dir 布尔属性,用来标识该项是否为目录。
function inspectZipEntries(zip) {
  const validFiles = [];

  zip.forEach((relativePath, zipEntry) => {
    // 1. 过滤文件夹占位条目
    if (zipEntry.dir) {
      return;
    }

    // 2. 过滤 macOS 自动生成的资源分支与隐藏文件
    if (relativePath.startsWith('__MACOSX/') || relativePath.endsWith('.DS_Store')) {
      return;
    }

    validFiles.push({
      path: relativePath,
      entry: zipEntry
    });
  });

  return validFiles;
}
步骤 4:解压指定内容为目标类型(zipEntry.async)
定位到具体的 zipEntry 后,调用其 async(type) 方法提取解压后的实际内容。JSZip 提供了多种输出格式,开发者应根据业务用途精准匹配:
| 目标类型标识 | 返回的 JavaScript 对象 | 适用业务场景 |
|---|---|---|
'string' |
String 字符串 |
文本文件、JSON 配置文件、Markdown 笔记、HTML/XML 源码 |
'blob' |
Blob 二进制对象 |
图片预览、音频/视频播放、PDF 渲染、构造单文件下载 |
'arraybuffer' |
ArrayBuffer 原生缓冲区 |
底层字节操作、传递给 WebAssembly、自定义加解密 |
'uint8array' |
Uint8Array 类型化数组 |
便于基于下标逐字节检查文件头魔数(Magic Number) |
'base64' |
String Base64 编码串 |
拼接 data:image/...;base64, 供行内直接展示极小图标 |
步骤 5:在前端展示或消费解压数据
提取出数据后,即可将其直接注入到 DOM 树中渲染,或触发单文件下载。以下是提取纯文本和图片文件的具体代码:
// 1. 提取并展示纯文本(如 readme.txt 或 config.json)
async function renderTextFile(zipEntry, targetDomElement) {
  const textContent = await zipEntry.async('string');
  targetDomElement.innerText = textContent;
}

// 2. 提取并展示图片文件(如 logo.png)
async function renderImageFile(zipEntry, targetImgElement) {
  // 根据后缀名匹配 MIME 类型,确保浏览器正确识别
  const mimeType = zipEntry.name.endsWith('.png') ? 'image/png' : 'image/jpeg';
  const blob = await zipEntry.async('blob');

  // 生成可供 <img> 消费的内部 Object URL
  const objectUrl = URL.createObjectURL(new Blob([blob], { type: mimeType }));
  targetImgElement.src = objectUrl;

  // 在图片加载完成后吊销该 URL 释放内存
  targetImgElement.onload = () => {
    URL.revokeObjectURL(objectUrl);
  };
}
四、进阶场景与高频技术难点攻克
在实际生产环境中,压缩包的来源极其复杂。不同操作系统打包工具的字符集差异、嵌套文件夹的相对路径还原,以及解压进度展示等,都是开发人员必须妥善应对的高频问题。
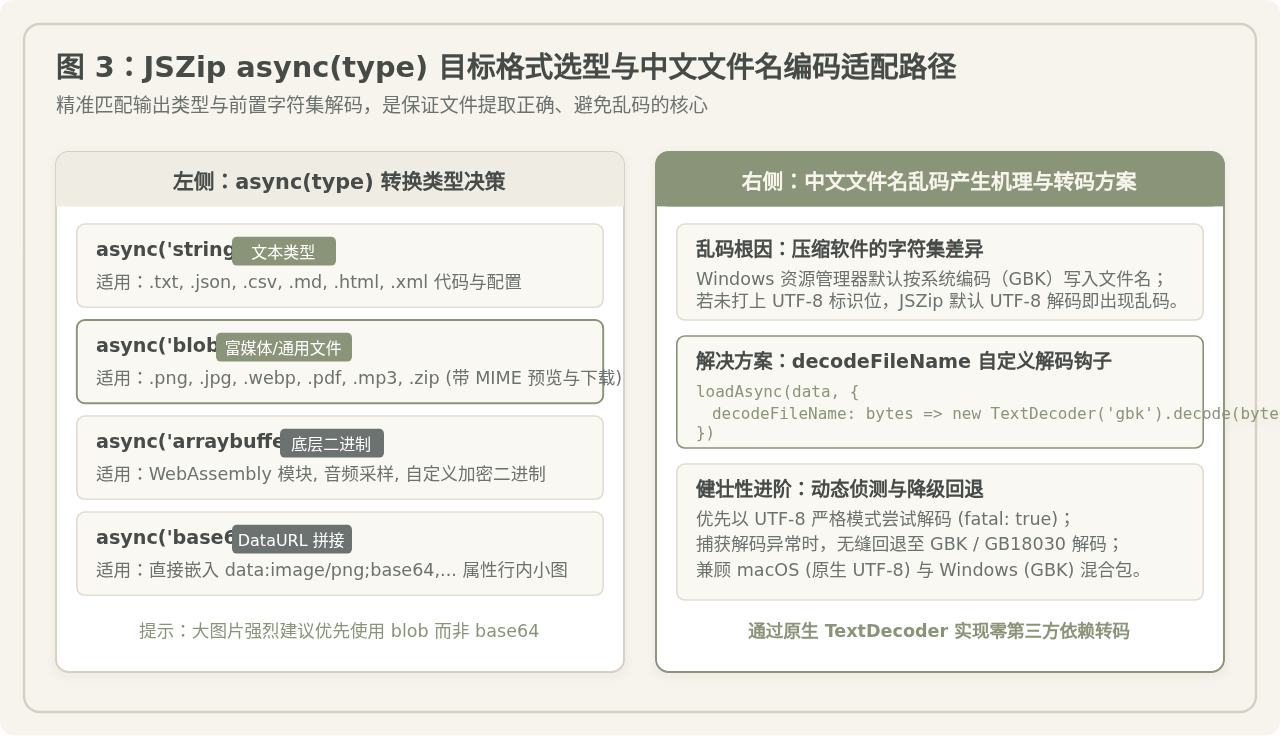
1. 中文文件名乱码问题与字符集解码
这是前端解压中最常见的问题之一:为什么同一个 zip 文件解压后,英文文件名正常,但包含中文的文件名全变成了类似 ââ... 的乱码?
其根源在于:早期的 ZIP 规范并未强制统一文件名编码。在 Windows 简体中文系统下,Windows 原生资源管理器压缩文件时默认使用系统的本地编码(即 GBK / CP936),且通常不会在文件头的通用标志位(General Purpose Bit Flag)第 11 位打上 UTF-8 标记。而 JSZip 默认遵循现代标准,始终优先按 UTF-8 进行字符串解码,于是产生乱码。
解决方案:JSZip 3.x 提供了 decodeFileName 自定义解码钩子函数。我们可以配合现代浏览器原生支持的 TextDecoder API,编写兼顾 UTF-8 与 GBK 的健壮解码逻辑:
// 健壮的中文文件名解码策略
function smartDecodeFileName(bytes) {
  // 1. 先尝试以严格模式使用 UTF-8 进行解码
  try {
    const utf8Decoder = new TextDecoder('utf-8', { fatal: true });
    return utf8Decoder.decode(bytes);
  } catch (e) {
    // 2. 若 UTF-8 解码失败,说明极可能是 Windows 下 GBK 编码打包的文件
    try {
      const gbkDecoder = new TextDecoder('gbk', { fatal: false });
      return gbkDecoder.decode(bytes);
    } catch (err) {
      // 3. 最终保底方案:使用系统默认解码
      return new TextDecoder().decode(bytes);
    }
  }
}

// 在载入时传入解码配置
async function loadZipWithChineseSupport(arrayBuffer) {
  const zip = await JSZip.loadAsync(arrayBuffer, {
    decodeFileName: smartDecodeFileName
  });
  return zip;
}
2. 解压进度实时监控
当压缩包内单文件体量较大或总项数较多时,解压过程会有明显的耗时。如果页面没有任何状态反馈,用户很容易以为网页已经假死。zipEntry.async() 提供了第二个可选参数,允许我们传入一个监听函数来捕获解压百分比:
async function extractWithProgress(zipEntry, progressBarElement) {
  const blob = await zipEntry.async('blob', (metadata) => {
    // metadata.percent 为 0 到 100 之间的浮点数
    const percent = metadata.percent.toFixed(1);
    progressBarElement.style.width = `${percent}%`;
    progressBarElement.innerText = `解压中: ${percent}%`;
  });
  return blob;
}
3. 重建多层级目录与打包导出
zip 文件内条目的 relativePath 字段记录了文件的相对路径(例如 assets/icons/home.png)。如果需要把解压出的内容重组为层次化的数据结构(例如在树形控件 TreeView 中展示),可以依据斜杠 / 进行路径切分:
function buildDirectoryTree(zip) {
  const root = { name: 'root', isDirectory: true, children: {} };

  zip.forEach((relativePath, entry) => {
    if (relativePath.startsWith('__MACOSX/')) return;

    const segments = relativePath.split('/').filter(Boolean);
    let current = root;

    segments.forEach((seg, index) => {
      const isLast = index === segments.length - 1;
      if (isLast && !entry.dir) {
        // 文件节点
        current.children[seg] = { name: seg, isDirectory: false, entry };
      } else {
        // 目录节点
        if (!current.children[seg]) {
          current.children[seg] = { name: seg, isDirectory: true, children: {} };
        }
        current = current.children[seg];
      }
    });
  });

  return root;
}
五、常见报错排查与工程防坑指南
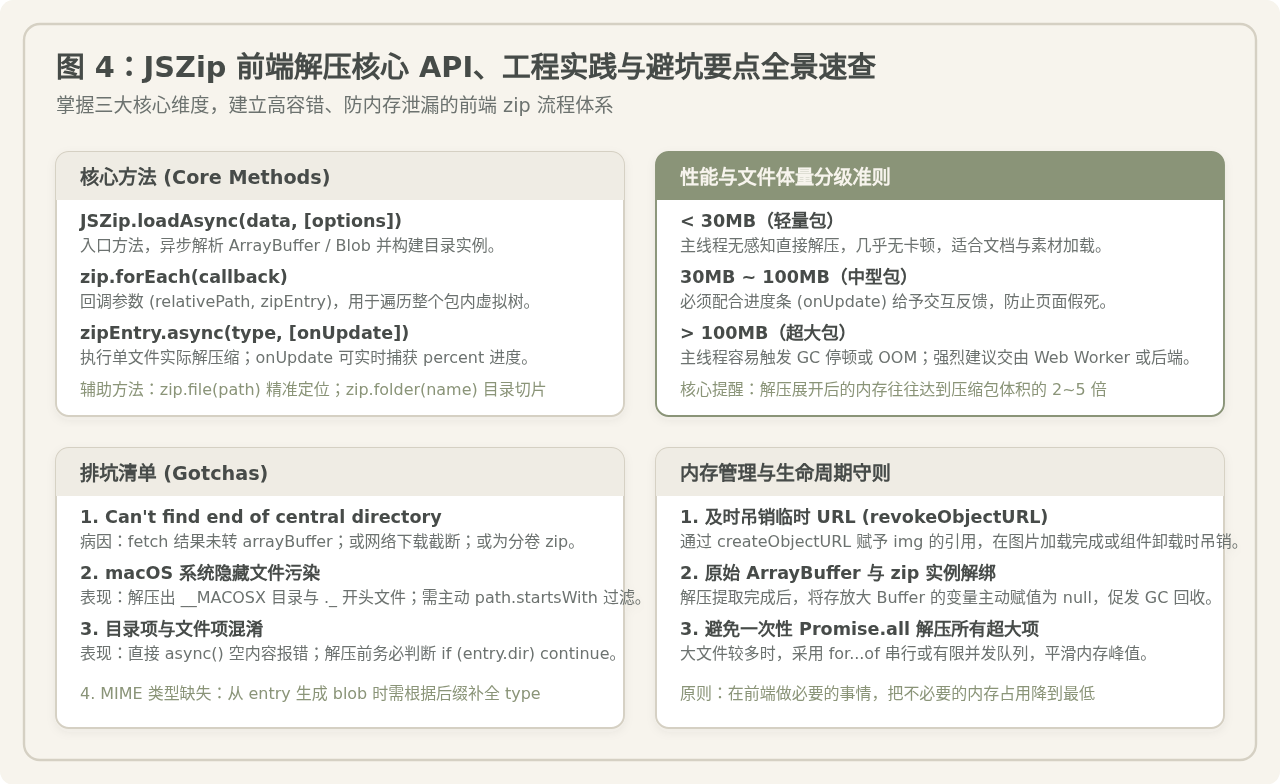
1. 报错:Corrupted zip: can't find end of central directory
原因排查:
- 数据类型传错:最常见的错误是直接把
fetch()返回的Response对象直接传给了loadAsync,而没有等待response.arrayBuffer()执行完毕。 - 网络下载未完成:若网络传输中途中断,文件末尾的 Central Directory 记录丢失,JSZip 就无法找到文件入口。
- 分卷压缩或伪 ZIP 文件:该文件可能是
.tar.gz、.7z、.rar等格式被强行改名为.zip,或者属于多卷分卷压缩包(JSZip 不支持多卷 zip)。
2. 避免内存泄漏:严格管理 Object URL 生命周期
当通过 URL.createObjectURL(blob) 生成临时资源链接时,浏览器会在内部保持对该 Blob 的引用,直到当前文档被卸载或开发者显式调用 URL.revokeObjectURL(url)。如果一个 zip 包内有上百张高清图片,且解压预览后从未释放,页面内存会急剧攀升。
<img> 标签触发 onload 回调后立即释放该 URL;如果要在 Vue/React 等单页框架中长期缓存,务必在组件销毁钩子(beforeUnmount 或 useEffect cleanup)中集中批量调用 revokeObjectURL。
3. 单文件并发解压的平滑处理
在提取包含大量文件的 zip 包时,许多开发者喜欢直接写:
// 慎用:全部并发可能瞬间击穿主线程内存
await Promise.all(validFiles.map(f => f.entry.async('blob')));
如果 zip 包内包含几十个几十兆的文件,Promise.all 会在同一瞬间启动数十个 Deflate 解压任务,瞬间导致 CPU 满载与内存骤增。更稳妥的工程策略是采用 for...of 顺序提取,或者使用带并发限制的执行器(并发度控制在 2~3 个):
// 推荐:采用控制并发或顺序串行提取
async function extractSequentially(files) {
  const results = [];
  for (const item of files) {
    const blob = await item.entry.async('blob');
    results.push({ path: item.path, blob });
  }
  return results;
}
六、总结
在前端处理 zip 文件时,JSZip 凭借其纯 JavaScript 实现的跨平台兼容性与清晰的 Promise 异步 API,成为了前端解压领域的行业事实标准。掌握其核心逻辑只需抓住三点:
- 认清数据流转本质:始终以
ArrayBuffer为承载媒介进行装载,明确解压发生于前端沙箱内存中。 - 规范数据提取路径:遍历条目时规范剔除目录占位与系统干扰项,根据业务需要按需转换
string或blob。 - 做好边界防御:利用
TextDecoder的decodeFileName钩子彻底规避 GBK 中文乱码,并严守内存释放与并发控制准则。
遵循这套规范,即可在前端应用中构建出稳健、高效且用户体验良好的文件解压处理模块。
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02
p5.js 中 setup() 和 draw() 函数的执行机制详解
2026-11-05 12:32:38







