

JS数组去重的几种常见代码实现方式对比
深入对比JavaScript中常见的五种数组去重实现方式,从底层原理、时间复杂度、边界值处理(如NaN与对象)到业务选型进行全面解析。
NaN、null、undefined 以及引用类型的对象。不同的去重实现方式在执行机制、时间复杂度以及对特殊值的判等规则上差异明显。本文选取日常开发中最典型的五种代码实现,从源码、底层判定机制到运行效率进行横向对比,给出切实可行的选型建议。
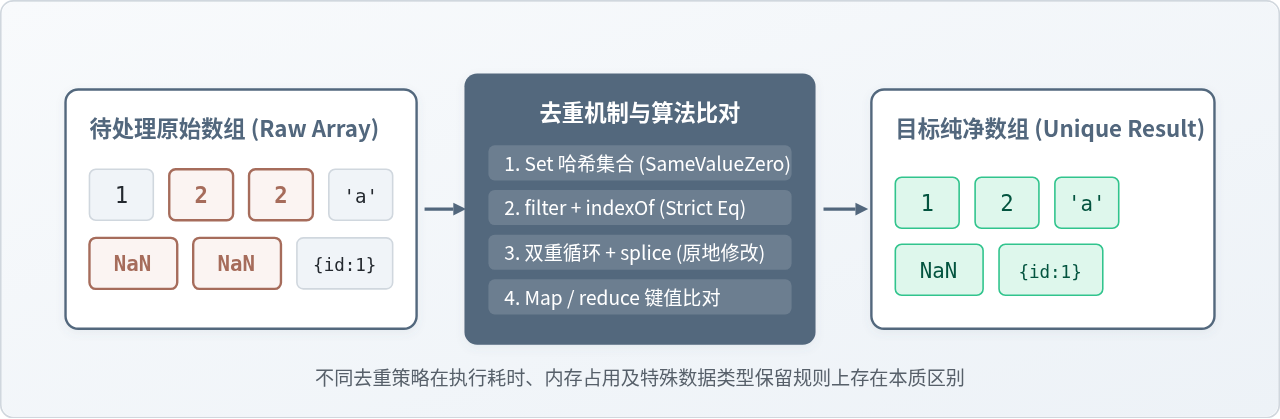
一、去重前必须明确的“相等”标准与边界值
在编写去重函数前,必须首先界定什么是“重复”。在 JavaScript 中,比较两个值是否相同并非只有 === 这一种规则:
- 严格全等(Strict Equality,===):
1 === 1为true,但NaN === NaN恒为false。这意味着基于严格全等的方案(如indexOf)在遇到NaN时会直接失效。 - 零值相等(SameValueZero):ES6 集合类型(
Set、Map)及includes方法采用该规则。它与全等基本一致,唯一例外是认为NaN等于NaN,且+0等于-0。 - 引用类型比较:对于对象
{}或数组[],比较的是内存中的引用地址而非内部键值。字面量{} === {}始终为false。如果业务要求“键值内容相同的对象视为重复”,必须采用自定义哈希或属性比对,常规基础去重算法均无法直接处理。
为了验证不同算法的健壮性,下文所有实现均统一使用以下包含多种边界类型的测试数组作为输入:
const testList = [
  1, 2, 2, '1', 'a', 'a',
  true, true, false,
  null, null, undefined, undefined,
  NaN, NaN,
  { id: 1 }, { id: 1 }
];
二、五种常见代码实现方式详解
1. ES6 Set 结合扩展运算符(现代工程推荐)
Set 是 ES6 引入的一种新的集合数据结构,其内部元素唯一。利用 new Set(arr) 可以直接剔除重复项,再通过扩展运算符 ... 或 Array.from() 还原为数组。
function uniqueBySet(arr) {
  return [...new Set(arr)];
}

// 运行结果:
// [1, 2, '1', 'a', true, false, null, undefined, NaN, { id: 1 }, { id: 1 }]
实现原理与特征:Set 内部基于哈希表实现,时间复杂度为 \(O(n)\),查询效率极高。其比对逻辑采用 SameValueZero,因此可以准确去重 NaN。但两个 { id: 1 } 属于不同引用,会被原样保留。
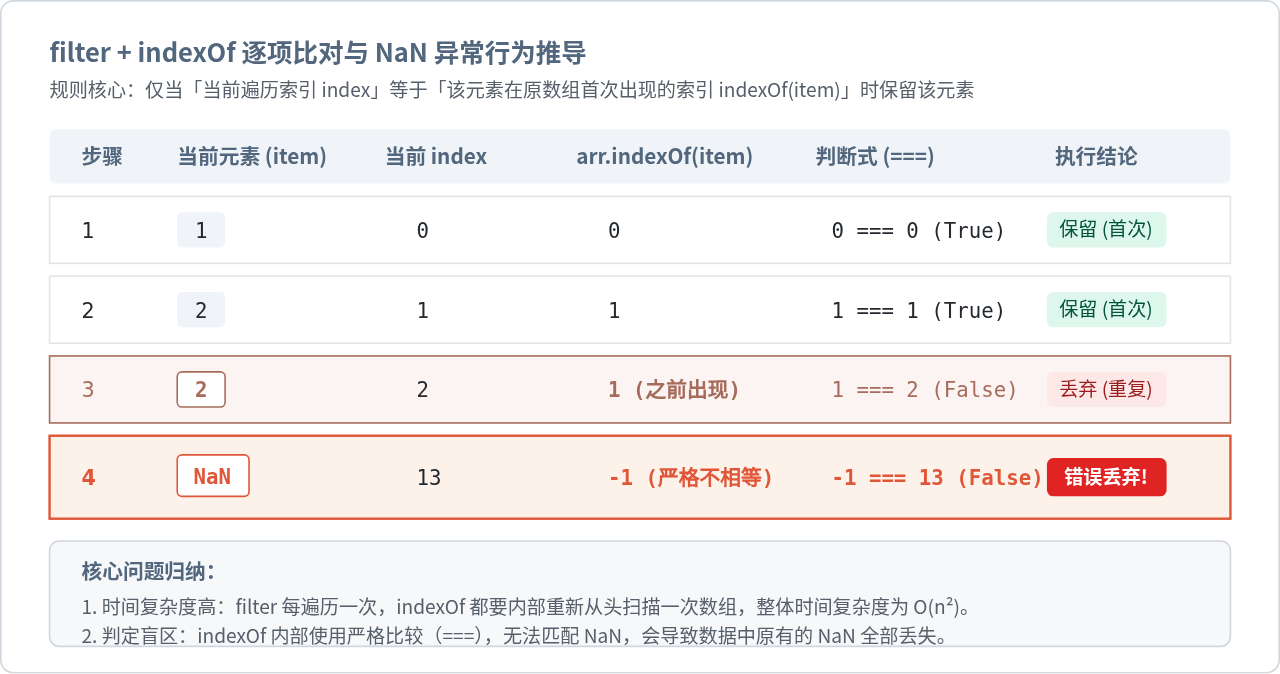
2. Array.prototype.filter 结合 indexOf(经典函数式写法)
在 ES6 普及之前,利用 filter 遍历数组并借助 indexOf 校验当前元素的首次出现索引是最常见的写法。
function uniqueByFilterIndexOf(arr) {
  return arr.filter((item, index) => {
    return arr.indexOf(item) === index;
  });
}

// 运行结果:
// [1, 2, '1', 'a', true, false, null, undefined, { id: 1 }, { id: 1 }]
// 注意:数组中原有的两个 NaN 全部丢失!indexOf 底层使用严格全等 ===。由于 NaN === NaN 返回 false,执行 arr.indexOf(NaN) 时永远返回 -1。因此 -1 === index 永远不成立,导致输入中的所有 NaN 都会被直接过滤丢弃!
3. 双重循环配合 splice(原地修改方案)
在没有额外可用辅助空间或必须在原数组上直接修改时,可以通过双层循环遍历:外层循环固定当前元素,内层循环从外层后一位开始扫描,发现重复即通过 splice 将其移除。
function uniqueBySplice(arr) {
  for (let i = 0; i < arr.length; i++) {
    for (let j = i + 1; j < arr.length; j++) {
      if (arr[i] === arr[j]) {
        arr.splice(j, 1);
        j--; // 关键:修正因删除元素导致的索引前移
      }
    }
  }
  return arr;
}
注意事项与代价:该方案直接修改了原数组,这在推崇纯函数与不可变数据的现代开发中通常需要避免;其次,splice 每次删除元素都会引起后续所有元素的内存位移,时间复杂度同样为 \(O(n^2)\) 且实际耗时更长;同时由于使用了 ===,它完全无法去重 NaN(两个 NaN 会被同时保留下来)。
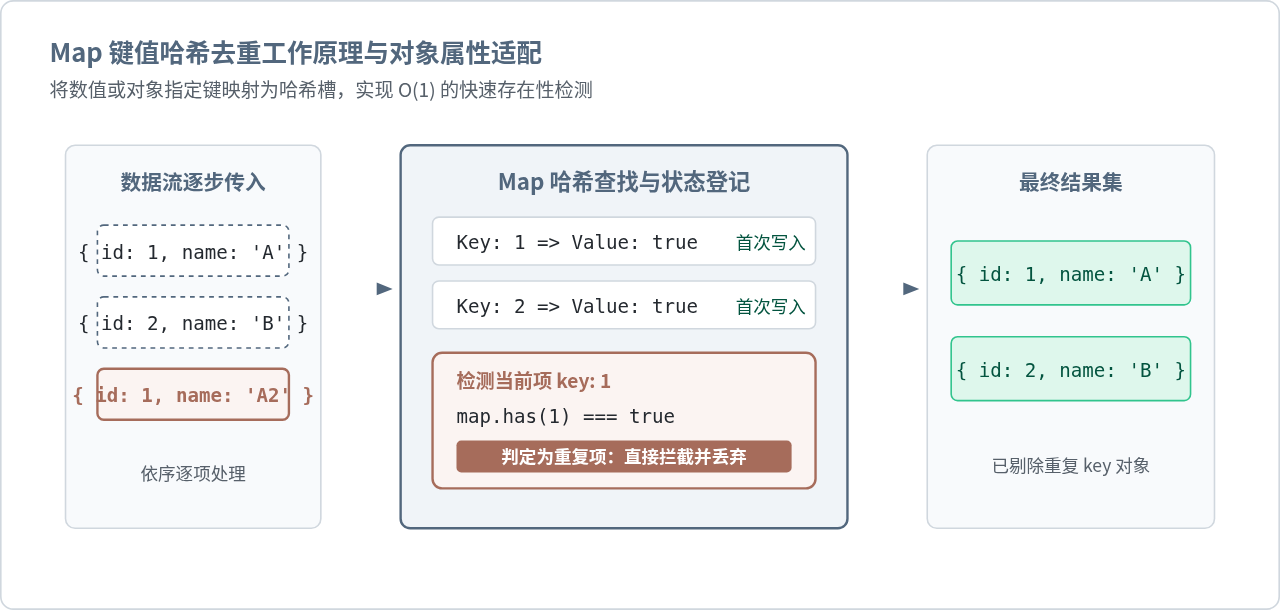
4. Map 键值缓存(兼容性好且支持对象字段去重)
利用 ES6 Map 的 has() 与 set() 维护已见过的元素,可以实现线性的 \(O(n)\) 复杂度。不仅能正确处理 NaN,更重要的是,只要稍微调整提取 key 的逻辑,就能非常自然地扩展为“根据对象某个字段去重”。
// 基础通用版:适用于原始类型
function uniqueByMap(arr) {
  const seen = new Map();
  return arr.filter(item => !seen.has(item) && seen.set(item, true));
}

// 业务常用版:按对象的指定属性 key 去重
function uniqueByProperty(arr, propKey) {
  const map = new Map();
  return arr.filter(item => {
    const key = item ? item[propKey] : item;
    if (!map.has(key)) {
      map.set(key, true);
      return true;
    }
    return false;
  });
}
5. Array.prototype.reduce 结合 includes
如果不想使用额外的 Set,又希望代码保持声明式风格且避开 indexOf 丢失 NaN 的问题,可以使用 reduce 配合 includes。
function uniqueByReduce(arr) {
  return arr.reduce((accumulator, current) => {
    if (!accumulator.includes(current)) {
      accumulator.push(current);
    }
    return accumulator;
  }, []);
}

// 运行结果:
// [1, 2, '1', 'a', true, false, null, undefined, NaN, { id: 1 }, { id: 1 }]
与 filter + indexOf 的关键差异:Array.prototype.includes 同样采用 SameValueZero 比对规则,因此能够正确识别 NaN,不会出现 NaN 被无故丢弃的问题。不过其内部依然需要对累加数组进行逐一遍历,因此总体时间复杂度仍然是 \(O(n^2)\)。
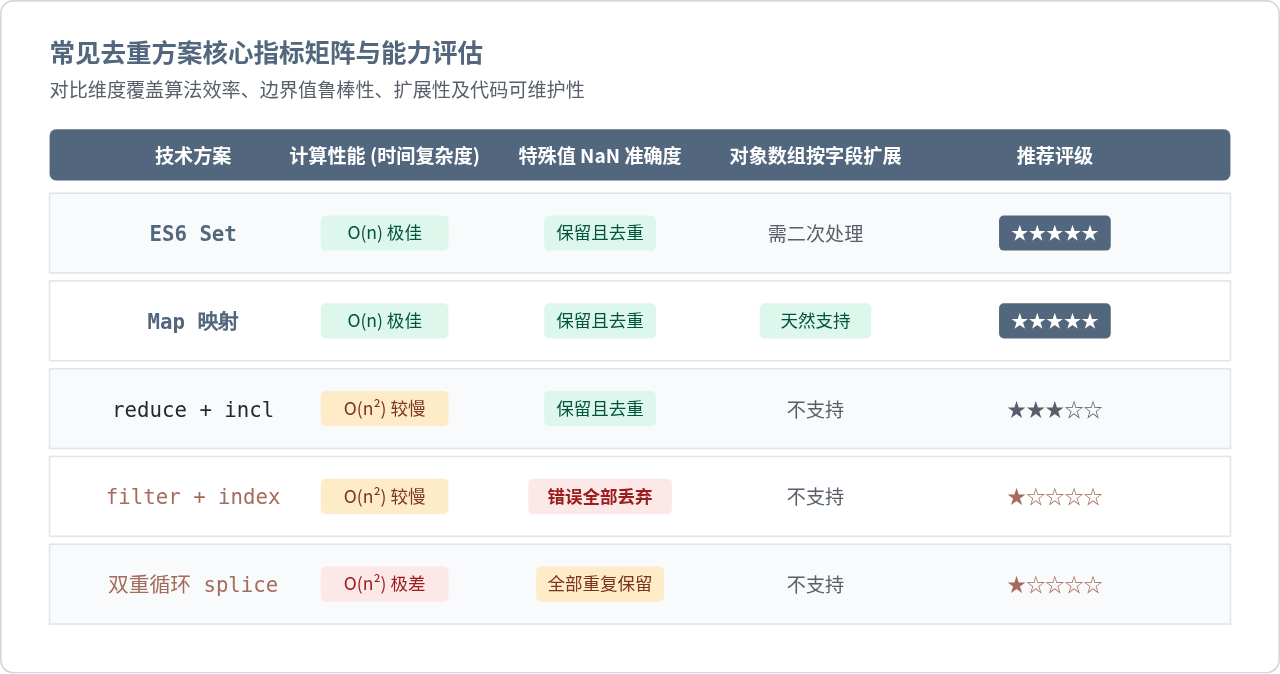
三、五种去重方式全维度特性与性能对比
为了给实际技术选型提供清晰客观的参考,我们将上述五种方案在各项关键指标上的表现总结如下表:
| 实现方式 | 时间复杂度 | 空间复杂度 | 修改原数组 | NaN 去重表现 | 对象数组去重支持 | 代码精简度 |
|---|---|---|---|---|---|---|
| ES6 Set | O(n) | O(n) | 否 | 完美去重 | 需额外映射 | 极简 (单行) |
| filter + indexOf | O(n²) | O(n) | 否 | 完全丢失 NaN | 不支持 | 中等 |
| 双重循环 + splice | O(n²) | O(1) | 直接修改原数组 | 无法去重 NaN (全保留) | 不支持 | 繁琐 |
| Map 键值映射 | O(n) | O(n) | 否 | 完美去重 | 原生友好 (按 key) | 良好 |
| reduce + includes | O(n²) | O(n) | 否 | 完美去重 | 不支持 | 较简洁 |
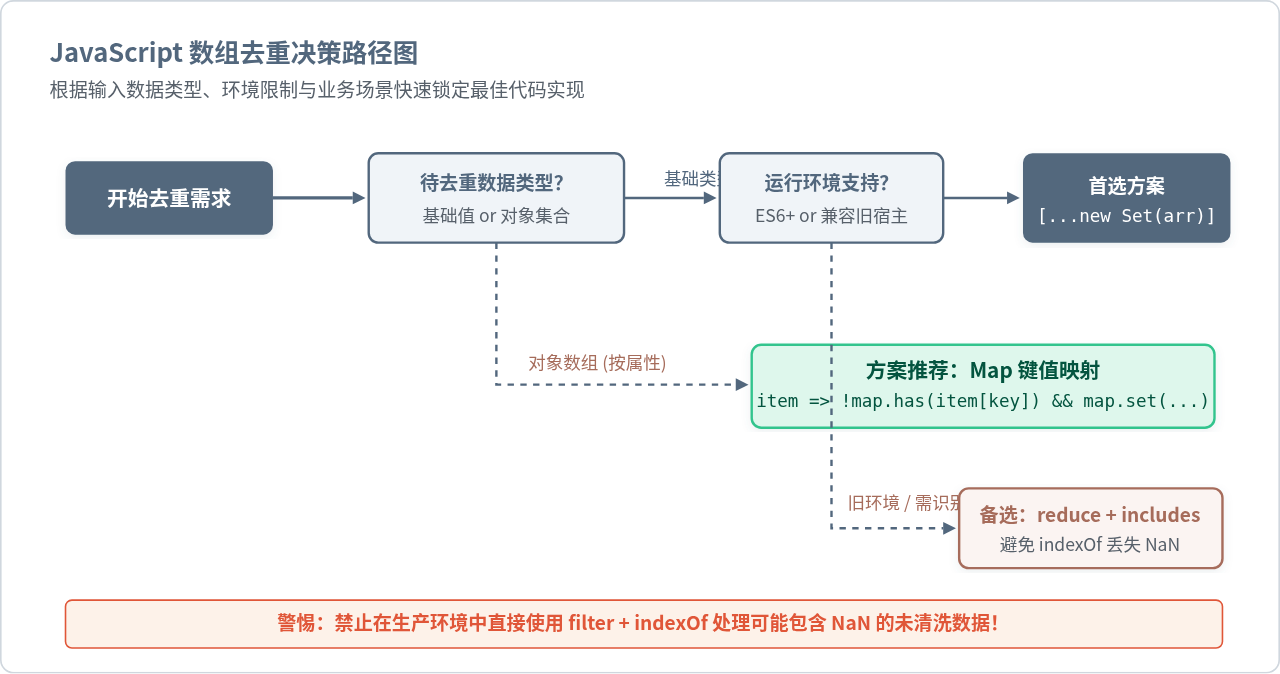
四、实际业务中的选型决策流程
选择哪种去重方案,应当依据待处理数据的类型以及项目对环境支持的具体要求来决定:
- 普通基础类型数组(无特殊对象):首选
[...new Set(arr)]。代码量仅一行,语义明确,底层为 \(O(n)\) 原生实现,且能正确保留唯一的NaN。 - 对象数组去重(按指定业务字段,如 id、code):首选
Map结合filter。通过对象的唯一键构建哈希表,既能保证代码可读性,又不会引入多重循环带来的性能损耗。 - 严苛旧环境兼容(无 Babel / polyfill 且需处理特殊值):若无法直接使用
Set,优先选用reduce + includes替代filter + indexOf,以避免后者把NaN全部剔除的逻辑错误。 - 坚决避开的方案:在非极其严苛的零内存原地操作场景下,坚决避免使用双重循环加
splice,其在数组长度过万时会导致主线程出现明显卡顿。
五、总结
在 JavaScript 中实现数组去重,选择方案的关键并不在于代码行数的多少,而在于对数据特征与底层机制的理解:
- 日常开发中 95% 以上的基础数据去重场景,直接使用
[...new Set(arr)]是兼顾执行效率与代码清晰度的最优解。 - 涉及后端接口返回的对象列表去重时,建立在
Map基础上的属性缓存过滤是性能与扩展性最均衡的工程实践。 - 历史遗留代码中经常见到的
filter + indexOf,虽然书写简短,但因其 \(O(n^2)\) 的耗时和对NaN的误杀行为,已不建议在新的生产业务中继续使用。
ES6模块化中js文件怎么用import和export交互
2026-11-05 17:00:48
JS读取本地文件时报错或无响应的常见原因
2026-11-05 16:32:31
let、const与var的区别:JavaScript变量声明最佳实践
2026-11-05 14:16:38
JS中直接定义静态二维数组的字面量写法
2026-11-05 14:16:08
JS 怎么查找字符串中所有匹配项的位置
2026-11-05 14:15:53







