

JS字符串判断包含:includes与indexOf的区别及用法
深入解析 JavaScript 中 includes 与 indexOf 判断字符串包含的区别与用法,从返回值类型、参数机制、零索引陷阱到工程选型实践,提供详实的图解与示例。
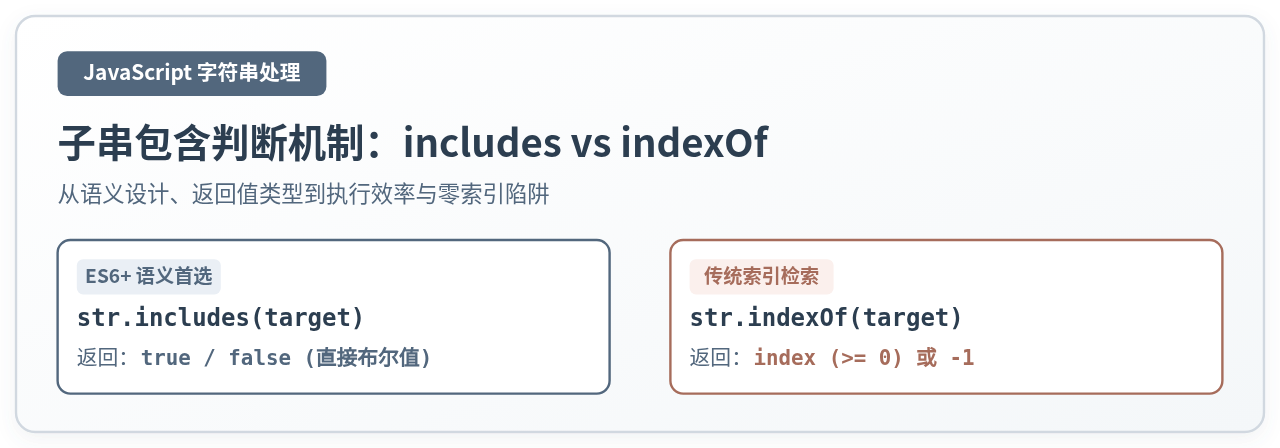
String.prototype.includes(),它直接返回布尔值 true 或 false;而在需要获取子串所在具体位置索引,或者需要兼容旧版执行环境时,则应使用传统的 String.prototype.indexOf()。两者虽都能达成“判断包含”的目的,但在返回值类型、语义设计、参数规则以及作为 if 条件表达式时的潜在陷阱上,存在显著的技术差异。
一、核心机制概览:两个方法的语法与基本用法
在日常开发中,诸如验证 URL 协议、解析文件后缀、过滤关键词等场景,都需要对字符串做包含关系检测。JavaScript 标准库先后提供了 indexOf 和 includes 两种内置方法。
1. String.prototype.includes()
includes() 随 ECMAScript 2015 (ES6) 成为标准,专门用于进行“存在性检测”。它的设计目标非常单一且明确:只回答“有”还是“没有”。
// 语法规范
str.includes(searchString[, position])

// 实用示例
const message = "System status: connection established";

console.log(message.includes("status"));      // 示例输出: true
console.log(message.includes("error"));       // 示例输出: false
console.log(message.includes("Status"));      // 示例输出: false(严格区分大小写)
2. String.prototype.indexOf()
indexOf() 是 JavaScript 早期规范(ECMAScript 1)就已存在的经典方法。它的主要任务是“位置检索”:返回指定子串第一次出现的字符索引。如果整个字符串中不存在该子串,则约定返回 -1。
// 语法规范
str.indexOf(searchValue[, fromIndex])

// 实用示例
const message = "System status: connection established";

console.log(message.indexOf("status"));       // 示例输出: 7(匹配的首字母索引)
console.log(message.indexOf("error"));        // 示例输出: -1(未找到)
console.log(message.indexOf("status") !== -1);// 示例输出: true(通过与 -1 比较得出布尔结果)
二、返回值与语义差异:布尔值与数值索引
两者最直观的区别在于返回值类型。includes() 返回纯布尔类型(Boolean),而 indexOf() 返回整型数值(Number)。这种差异直接影响了代码的可读性与意图表达。
当业务代码只需要回答“字符串是否包含某个字符”时,str.includes('foo') 是一句完整的断言语句,阅读代码时无需进行二次心智转换。而如果使用 str.indexOf('foo') !== -1,阅读者必须先理解 indexOf 寻找下标的逻辑,再通过 !== -1 的否定式比较推导出“存在”的含义。
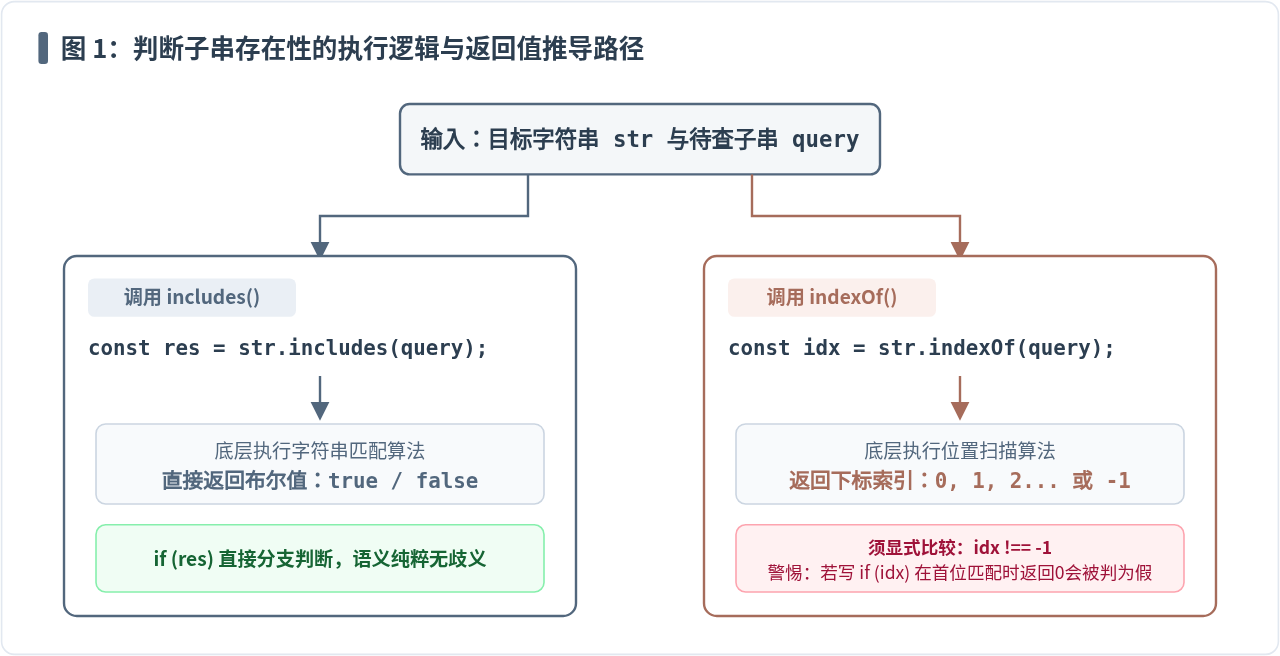
从底层执行路径来看,includes() 在内部匹配成功后,可以直接终结检索并返回 true;而在语义层面,它避免了在业务逻辑中暴露无用的数字下标。只有在确实需要根据具体位置执行截取操作(如 slice 或 substring)时,数值索引才具有真正的业务价值。
三、检索偏移参数(position 与 fromIndex)的执行机制与步骤
这两个方法都接收一个可选的第二参数(includes 命名为 position,indexOf 命名为 fromIndex),用于指定开始搜索的字符索引位置。了解该参数的执行机制,有助于更精确地控制搜索范围。
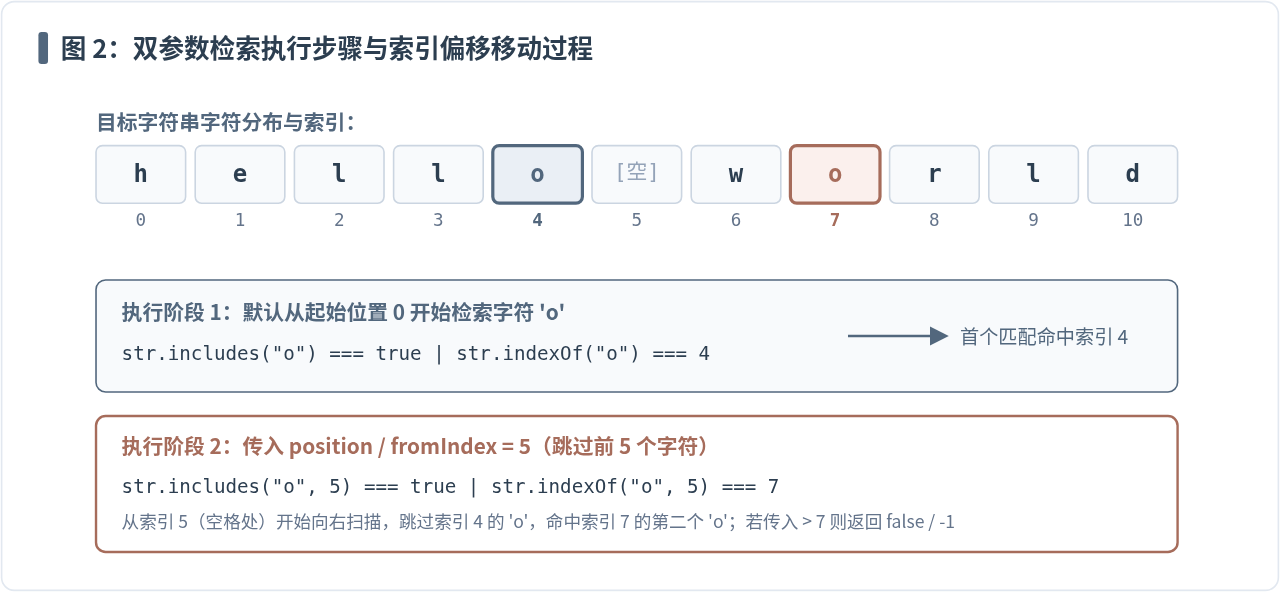
执行步骤详解:
- 确定检索起点:若未传入第二参数,默认从索引
0(字符串首字符)开始自左向右扫描;若传入具体整数pos,引擎将直接跳过前pos个字符,从下标为pos的位置开始比对。 - 向右线性扫描:算法按顺序比对后续字符序列,直到找到完全匹配的子串或到达字符串尾部。
- 边界处理(超出长度):如果传入的起始索引大于或等于字符串本身的长度(
position >= str.length),两者都不会触发运行时报错,而是直接判定未找到(includes返回false,indexOf返回-1)。 - 边界处理(负数索引):在字符串原型方法中,如果传入负数,ECMAScript 规范会将负数约束(clamp)为
0,即依然从字符串开头检索(注意:这与数组的Array.prototype.includes将负数视为倒数偏移的机制不同)。
// 偏移参数实用对比示例
const text = "apple pie and apple cider";

// 从索引 0 开始检索
console.log(text.includes("apple", 0));  // 示例输出: true
console.log(text.indexOf("apple", 0));   // 示例输出: 0

// 从索引 5 开始检索(跳过开头的 "apple")
console.log(text.includes("apple", 5));  // 示例输出: true
console.log(text.indexOf("apple", 5));   // 示例输出: 14

// 传入超出长度的索引
console.log(text.includes("apple", 100));// 示例输出: false
console.log(text.indexOf("apple", 100)); // 示例输出: -1

// 传入负数索引(按 0 处理)
console.log(text.indexOf("apple", -5));  // 示例输出: 0
四、常见陷阱与边缘情况:防范经典的“零索引陷阱”
在使用 indexOf 判断包含关系时,前端开发中最著名、也最容易引发线上缺陷的当属“零索引陷阱(Zero-index Trap)”。
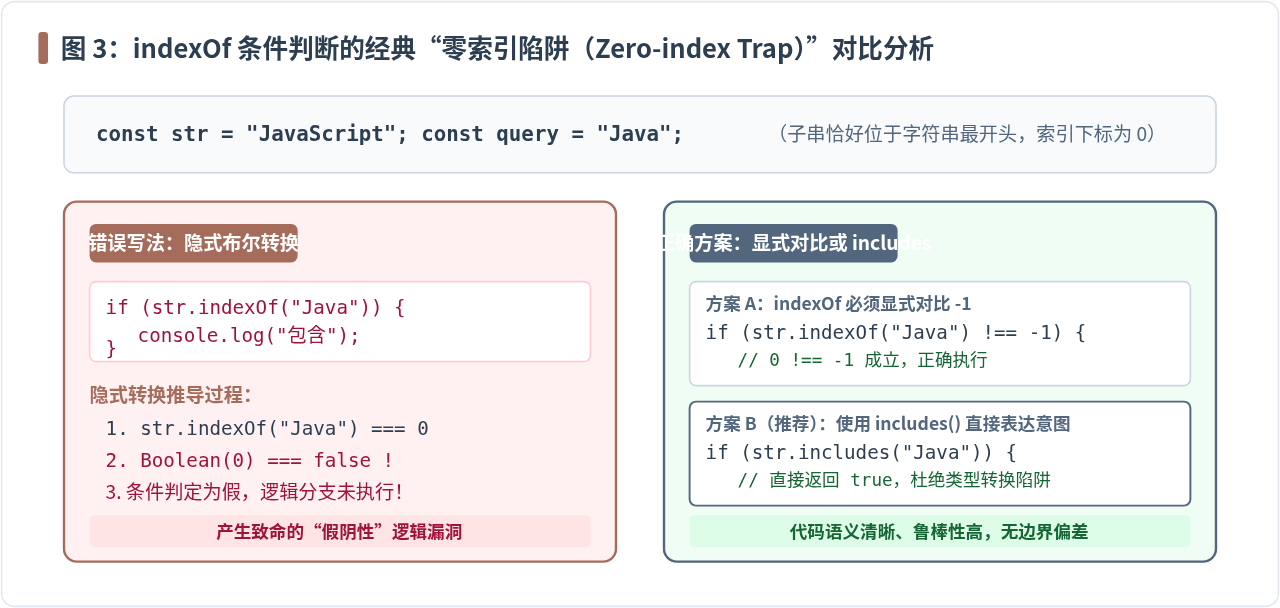
1. 为什么 if (str.indexOf(...)) 会导致逻辑灾难?
在 JavaScript 中,数值 0 在进行条件判断隐式类型转换时会被视作假值(Falsy),而 -1 以及所有正整数都会被视作真值(Truthy)。
当目标子串恰好位于字符串的最开头时,indexOf 返回索引 0。如果开发者图省事写成 if (str.indexOf("query")),0 被强制转换为 false,导致该分支直接被跳过;反之,若子串完全不存在,返回的 -1 在布尔上下文中反而是 true,导致条件成立!这完全逆转了业务逻辑。
const protocol = "https://domain.com";if (protocol.indexOf("https")) { /* 永远不会执行!因为结果是 0,被转换为 false */ }if (protocol.indexOf("ftp")) { /* 会错误执行!因为结果是 -1,在 JS 中是 truthy */ }
使用 includes() 则彻底在语言层面根除了此类隐患,因为它的返回值本身就是纯净的布尔值,杜绝了一切由于数值类型转换带来的假阴性或假阳性判断。
2. 空字符串与大小写边界
- 空字符串检索:无论源字符串内容为何,
str.includes("")与str.indexOf("")均返回有效结果。在有效偏移范围内,str.includes("")始终返回true,str.indexOf("")返回传入的起始位置或0。 - 大小写敏感性:两个方法均遵循严格的字符编码匹配(Case-sensitive)。若业务需求为不区分大小写,常见且可靠的做法是在比对前统一转换为小写:
str.toLowerCase().includes(query.toLowerCase())。
五、选型建议与总结:何时用 includes,何时用 indexOf
在实际工程实践中,选择使用哪一个方法应当遵循清晰的技术准则:
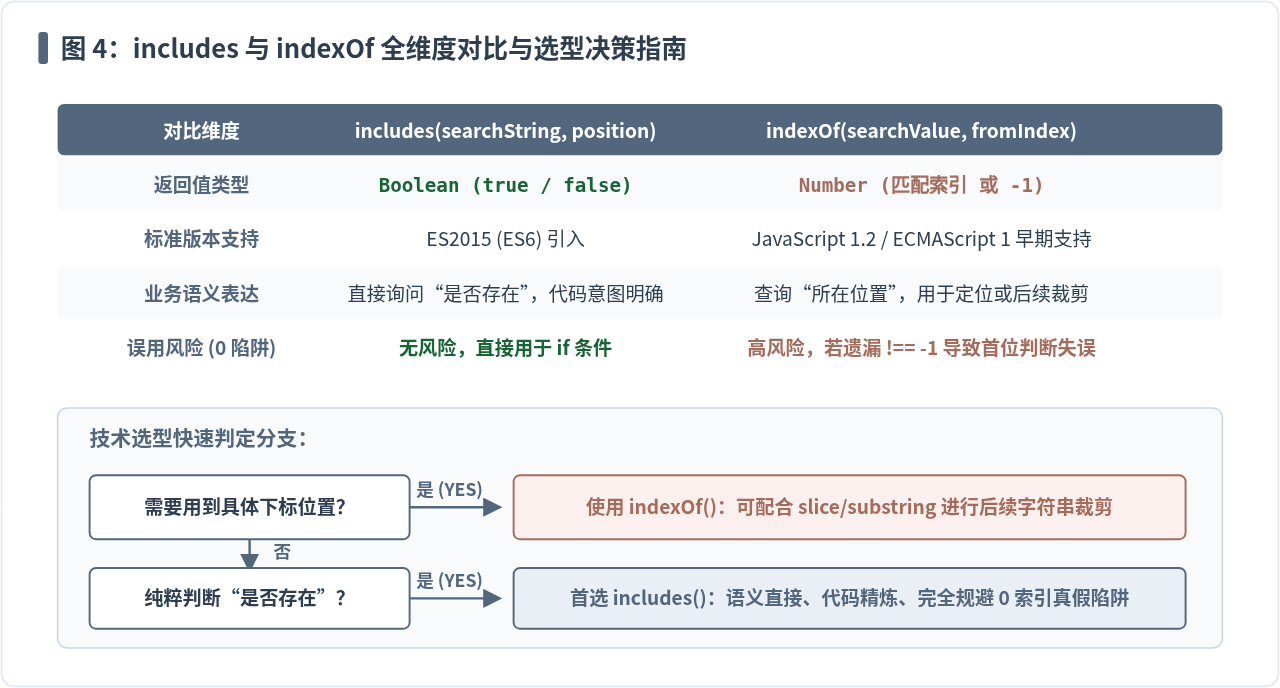
| 对比维度 | String.prototype.includes | String.prototype.indexOf |
|---|---|---|
| 返回值 | true 或 false(布尔类型) |
匹配的首字符下标(>= 0)或 -1 |
| 语言标准 | ECMAScript 2015 (ES6) | ECMAScript 1 (经典标准) |
| 代码语义 | 表达“是否包含”,语义直接直观 | 表达“定位索引”,用于获取位置或截取 |
| 条件判断安全性 | 天然安全,可直接用于 if 分支 |
若未显式与 -1 比较,极易触发零索引假值陷阱 |
| 遗留浏览器支持 | 旧版 IE(如 IE11)原生不支持,需 Polyfill | 所有现代与历史环境原生支持 |
选型决策建议:
- 纯判断场景默认用
includes():只要目标是验证子串是否存在,无条件优先使用includes()。它不仅代码简洁,更重要的是消除了数值判断的歧义,提升了团队代码的可维护性。 - 需要截取或利用位置时使用
indexOf():如果后续需要通过str.slice(idx)、str.substring(0, idx)等方法按位置分割字符串,必须使用indexOf()。 - 维护不支持 ES6 的极旧系统时:如果项目运行在未配置 Babel / core-js 转译的古老浏览器宿主(如 IE 时代企业内部系统),使用
str.indexOf(query) !== -1是最安全的无依赖解法。
JavaScript怎么准确判断数据类型:typeof、instanceof与Object.prototype.toString
2026-11-05 17:09:21
JS中将数组和对象混合组装为JSON字符串
2026-11-05 16:41:42
JS运算符优先级与结合性的区别是什么?
2026-11-05 13:22:02
JS Map怎么只遍历Key或Value
2026-11-05 13:00:36
D3.js 与 ECharts 选型对比:灵活性 vs 开发效率
2026-11-05 09:45:01







