

JS中includes、indexOf和search判断包含的返回值差异
深入对比JavaScript中includes、indexOf和search在判断字符串包含时的返回值类型、取值范围、条件判断陷阱及适用场景差异。
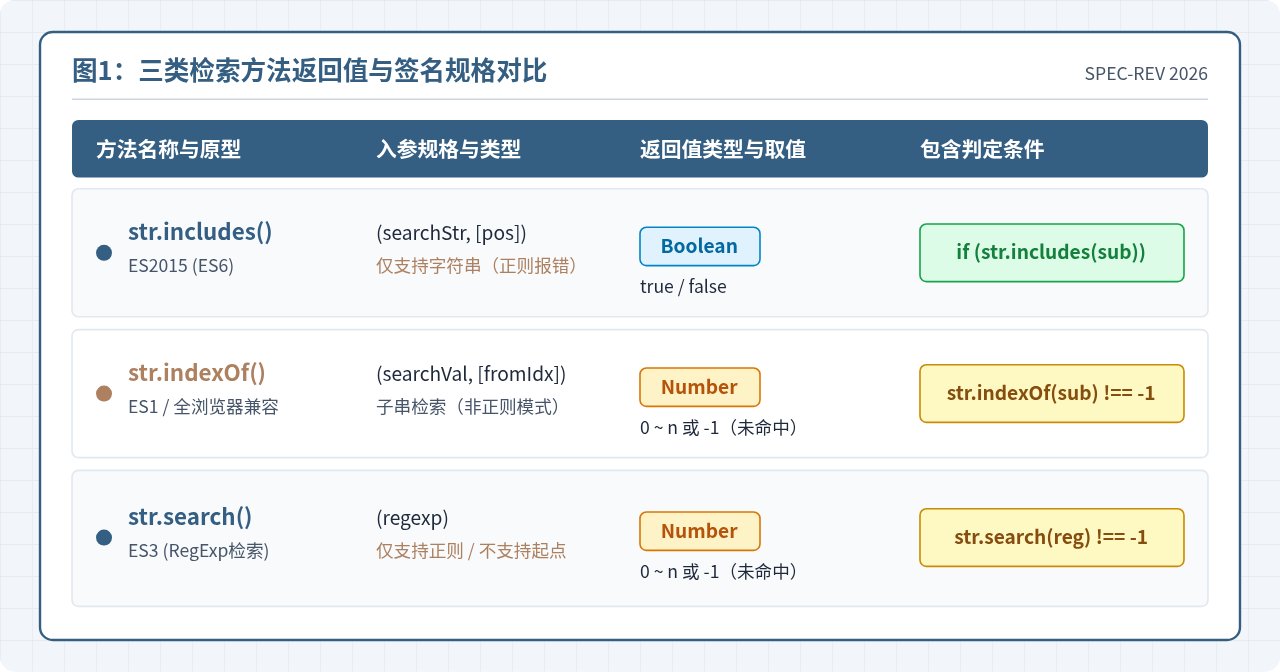
includes、indexOf 与 search 的首要差异在于返回值的类型与设计语义:includes 直接返回布尔值(true 或 false),专用于真假值条件校验;indexOf 返回目标首次出现的数字索引(0 ~ length-1,未找到返回 -1),用于精确定位;而 search 同样返回首次命中的数字索引(未命中返回 -1),但它底层专为正则表达式设计,不支持指定检索起点。
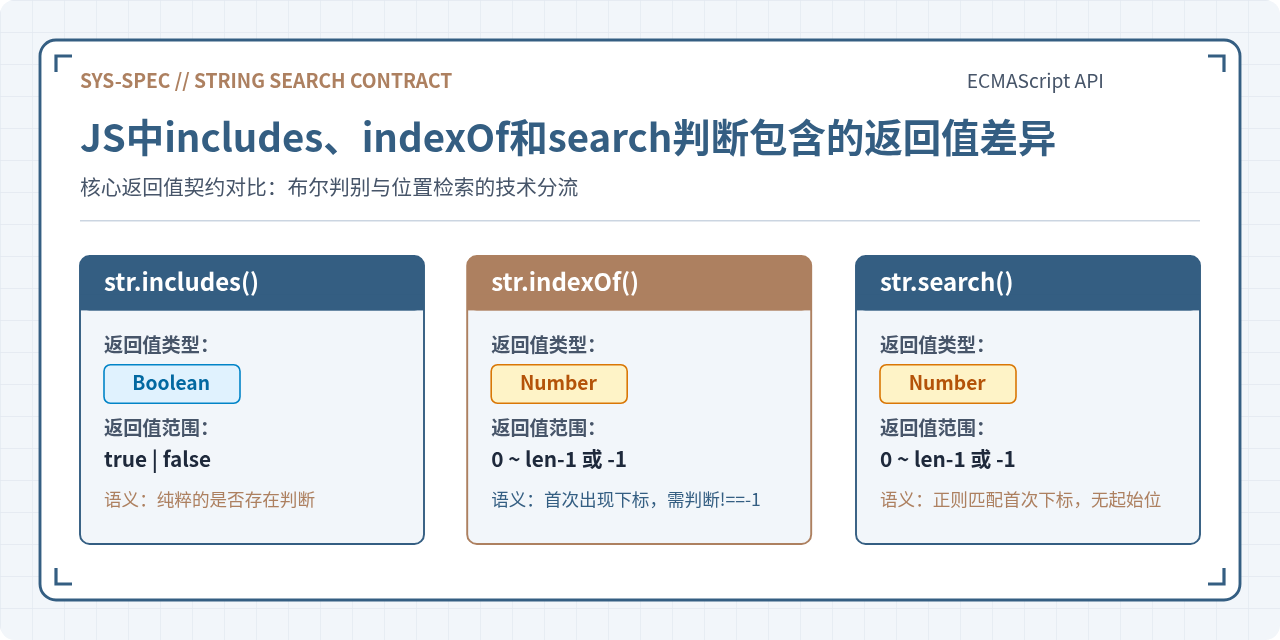
一、返回值类型与取值范围的本质差异
虽然这三个方法都可以用来确认字符串中是否存在某个片段,但它们在语言规范中被赋予了不同的使命,这直接决定了调用它们所获得的结果形式。
1. includes:布尔判定契约
includes() 是 ECMAScript 2015 (ES6) 引入的方法,函数原型为 str.includes(searchString[, position])。其返回值类型严格为 Boolean:
- 包含目标子串:返回
true; - 未包含目标子串:返回
false。
该方法只回答“有”还是“没有”,不透露目标子串出现在何处。由于返回的就是标准的布尔值,编写业务分支时无需进行任何二次比较。
2. indexOf:数值下标契约
indexOf() 自 ECMAScript 1 时代就已存在,函数原型为 str.indexOf(searchValue[, fromIndex])。其返回值类型为 Number(32位有符号整数):
- 包含目标子串:返回该子串在原字符串中首次出现的起始字符索引(范围为
0到str.length - 1); - 未包含目标子串:返回特定的哨兵值
-1。
indexOf 既回答了“是否存在”,又提供了“位置坐标”。如果仅需做包含判断,开发者必须显式将其与 -1 进行不等于比对。
3. search:正则匹配下标契约
search() 属于 ECMAScript 3 规范,原型为 str.search(regexp)。其返回值类型同样为 Number:
- 匹配成功:返回第一个匹配项在原字符串中的起始索引(
0到str.length - 1); - 匹配失败:返回
-1。
虽然返回值格式与 indexOf 相似,但 search 的入参会被隐式或显式解析为正则表达式。它的核心价值在于正则模式匹配,而非单纯的固定字符串比对。
我们可以通过一段标准代码直接验证三种方法对于同一输入字符串的返回值输出:
// 示例测试字符串
const sentence = "JavaScript is modern and powerful";

// 1. includes 返回布尔值
console.log(sentence.includes("modern"));  // 示例输出: true
console.log(sentence.includes("python"));  // 示例输出: false

// 2. indexOf 返回位置下标或 -1
console.log(sentence.indexOf("modern"));   // 示例输出: 14 (匹配在索引14处)
console.log(sentence.indexOf("python"));   // 示例输出: -1

// 3. search 返回正则匹配下标或 -1
console.log(sentence.search(/m[a-z]+n/));  // 示例输出: 14 (匹配 "modern")
console.log(sentence.search(/python/));    // 示例输出: -1
二、条件判断中的“0 假值陷阱”与执行逻辑
理解返回值差异的现实意义,最典型的体现就是在 if 条件分支语句中。初学者常常会将数字索引直接作为真假条件,从而引发极其隐蔽的线上逻辑错误。
1. 陷阱重现:为什么 if (str.indexOf(...)) 会失效
在 JavaScript 的类型转换机制中,数字 0 属于假值(Falsy),而所有非零数字(包括负数 -1)都属于真值(Truthy)。
如果子串恰好位于字符串的最开头,indexOf 会准确返回 0。在隐式布尔转换下,Boolean(0) 被判定为 false,导致本该执行的分支被完全跳过;相反,当子串不存在返回 -1 时,Boolean(-1) 却被判定为 true,导致分支错误执行!
if (str.indexOf("target")) 或 if (str.search("target"))。当目标位于第0个字符时逻辑反转,未找到时同样逻辑反转。
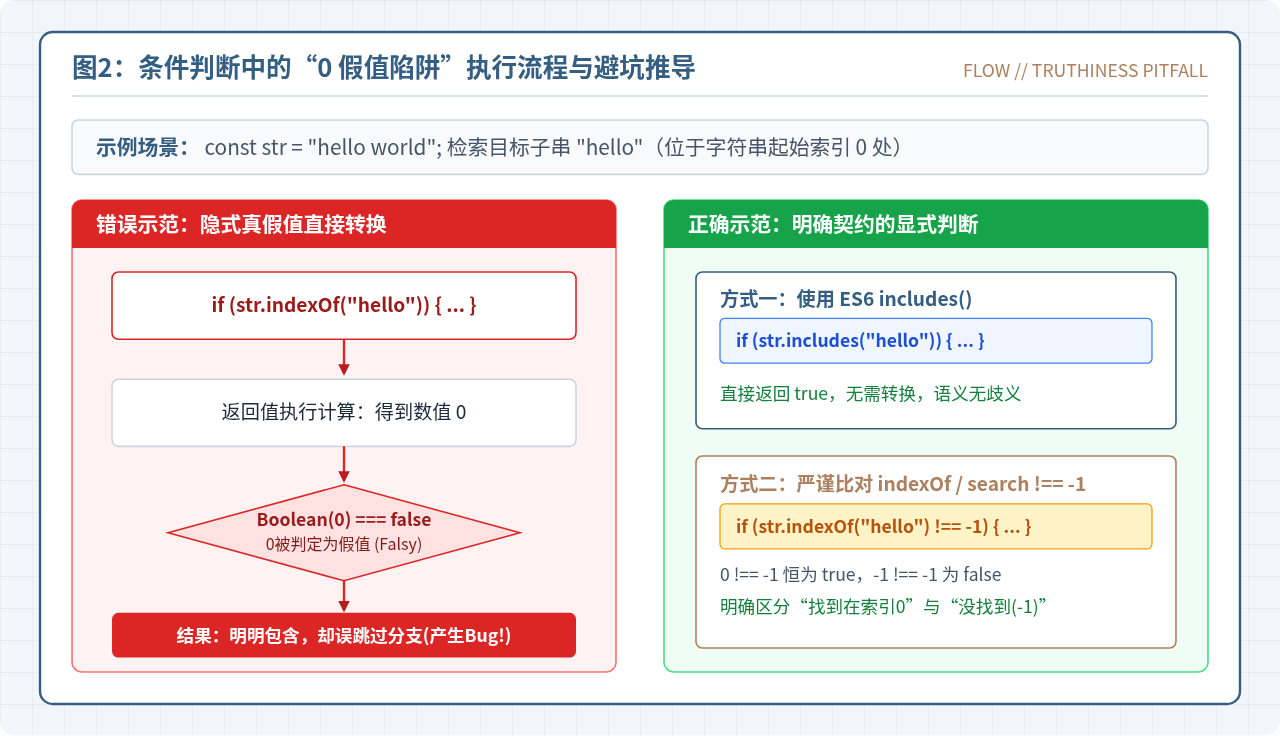
请看以下对比代码:
const url = "https://example.com/api";

// ---------------- 错误示范 (千万不要这么写) ----------------
if (url.indexOf("https")) {
  // 预期:如果是 https 开头则执行
  // 实际:url.indexOf("https") 返回 0
  // Boolean(0) 为 false,此处代码永远不会被执行!
  console.log("检测到HTTPS");
}

if (url.indexOf("ftp")) {
  // 预期:未找到 ftp 不应执行
  // 实际:url.indexOf("ftp") 返回 -1
  // Boolean(-1) 为 true,此处代码会被错误执行!
  console.log("检测到FTP协议"); // 错误输出
}

// ---------------- 正确示范 ----------------
// 方案A:如果只需要判断包含关系,优先选用 includes()
if (url.includes("https")) {
  console.log("安全验证:确实包含 https"); // 正常执行
}

// 方案B:若使用 indexOf,必须显式与 -1 进行严格比对
if (url.indexOf("https") !== -1) {
  console.log("安全验证:通过下标不等于 -1 确认存在"); // 正常执行
}
三、参数类型、检索起点与正则特性的深层差异
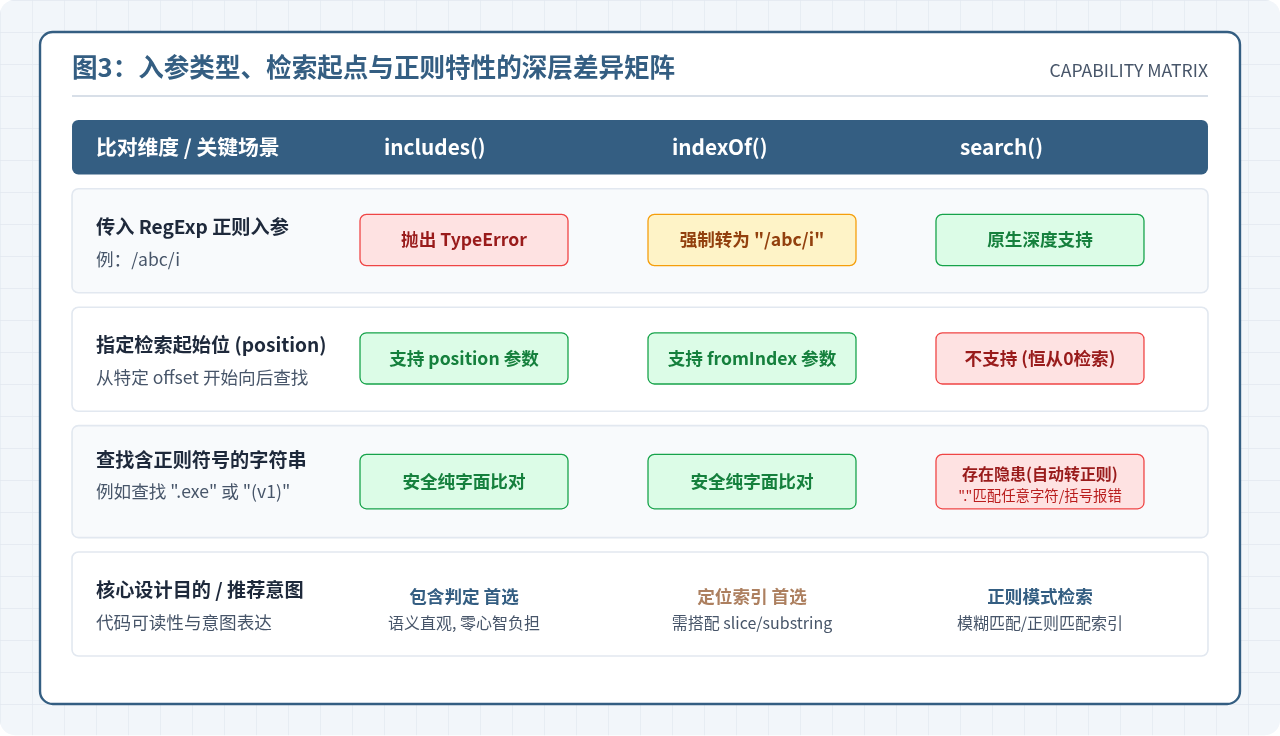
除了直接返回的类型不同,这三个方法在接收参数的类型限制、能否从指定偏移量检索以及底层匹配算法上也有着明确的分界线。
1. 对正则表达式参数的处理差异
这是三者在输入侧最严格的差别:
includes(searchString)坚决禁止传入正则:如果向includes传递一个正则表达式实例(如/abc/),JavaScript 运行时会直接抛出TypeError: First argument to String.prototype.includes must not be a regular expression。indexOf(searchValue)强行转字符串:如果向indexOf传入正则(例如/abc/),它不会报错,但也不会进行正则匹配,而是调用其toString()方法将其转换为字面量字符串"/abc/"进行无差别匹配。search(regexp)专为正则而生:它原生支持所有正则语法修饰符(如i忽略大小写)。即使传入普通字符串,它也会隐式调用new RegExp(searchValue)进行编译。
str.search() 传入带有正则特殊字符(如 ., *, ?, (, [)的字符串时需特别小心。例如 "file.txt".search(".txt") 中的 . 会被视作通配符匹配任意单字符;而 "func(a)".search("(a)") 则可能因未闭合或非法正则语法直接报 SyntaxError。纯文本包含判断切勿混用 search。
2. 起始位置检索(Offset Position)支持
当需要从字符串中间某一位置开始向后检索时:
includes(sub, position)支持第二个参数position(默认值为0)。如果指定了正数k,则从索引k开始向右搜索。indexOf(sub, fromIndex)支持第二个参数fromIndex(默认值为0)。从索引fromIndex处开始搜索。search(regexp)完全不支持指定起始位置。即便在传入的正则表达式上设置了g标志或修改了lastIndex属性,search每次都会从字符串的首字符(索引 0)开始匹配。
const text = "apple-banana-apple";

// 验证指定起始位置支持
console.log(text.includes("apple", 6));   // 示例输出: true (跳过了前6个字符,找到了第2个apple)
console.log(text.indexOf("apple", 6));    // 示例输出: 13 (第2个apple的起始索引)

// 验证 search 的行为
console.log(text.search(/apple/));        // 示例输出: 0
// search 不接受位置参数,始终从头开始匹配
四、方法选型决策与实战总结
在日常开发中,应当依据业务目的选择语义契合度最高的方法,而不是习惯性地在所有地方混用。
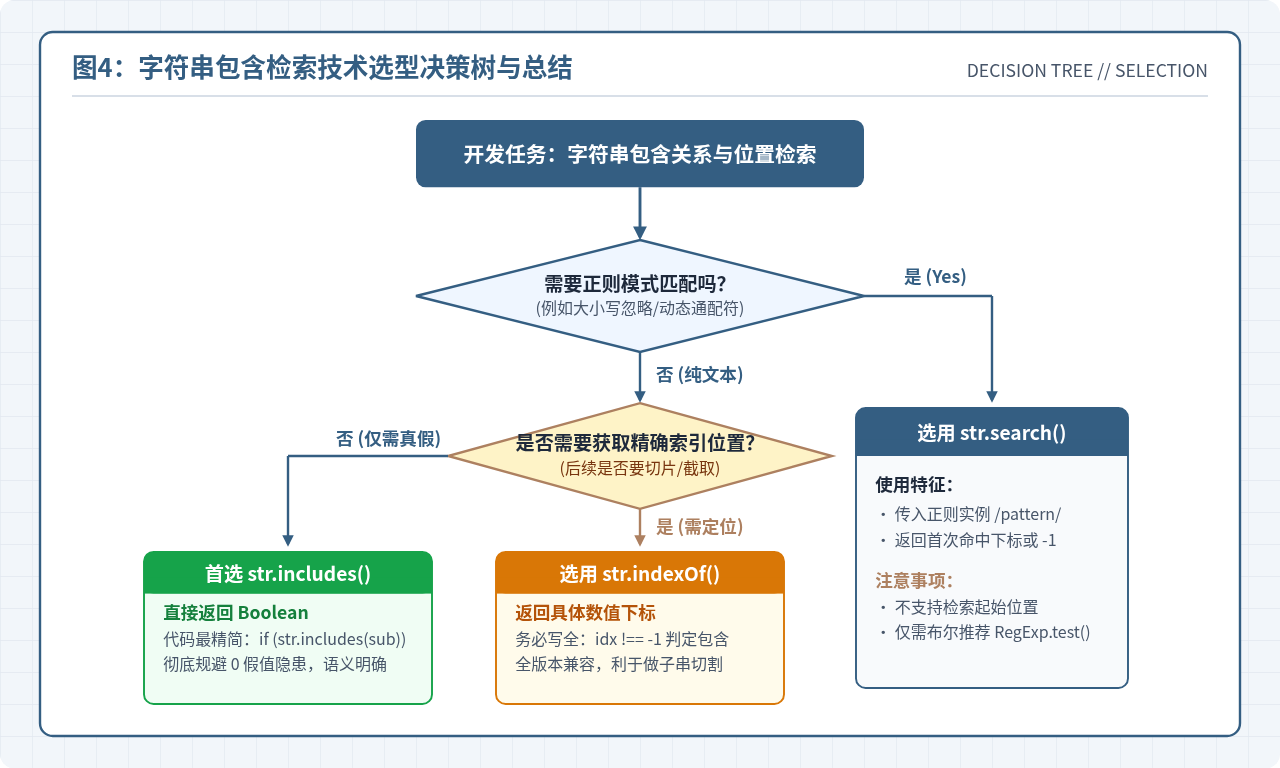
| 方法 | 返回值 | 典型使用场景 | 关键注意事项 |
|---|---|---|---|
| includes | Boolean (true / false) |
单纯检查字符串是否存在某片段、表单规则检查、权限校验 | 不能传正则;不提供具体位置;现代浏览器或打包器支持良好 |
| indexOf | Number (0..n / -1) |
需要基于索引进行截取(如配合 substring、slice),或维护旧版兼容项目 |
必须使用 !== -1 做包含判断,谨防 0 假值漏洞 |
| search | Number (0..n / -1) |
需要正则模糊匹配(如忽略大小写、通配符),且需要知道匹配首位索引 | 不支持指定起始位置;纯字符串检索不建议使用以防正则转义异常 |
总结来说:只问存不存在,首选 includes;要问在哪并做后续截取,选用 indexOf;需要正则规则定位,才使用 search。只要牢记 includes 返回布尔值、另外两者返回数字索引的本质差异,就能彻底规避条件分支中的隐式转换陷阱。
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13







