

JS嵌套对象数组去重:处理复杂结构的方法
深入剖析JavaScript嵌套对象数组去重失效的核心原因,提供基于嵌套属性路径提取、规范化键排序序列化及递归深度判等的多套实用解决方案与性能权衡指南。
在日常 JavaScript 开发中,数组去重是一项高频任务。基础数据类型可以通过 new Set(arr) 瞬间完成,但当数据变成包含深层嵌套的对象数组时,常规手段就会集体失效。这是因为对象基于堆内存引用地址判等,哪怕内部属性完全相同,两个独立对象的引用也互不相等;而原生 JSON.stringify 又极易受到对象键声明顺序不一致的干扰。本文针对这些复杂结构,由浅入深解析其背后的机制,并给出兼顾执行效率与严谨性的完整去重方案。
一、核心难点:为什么常规去重在嵌套结构中失效?
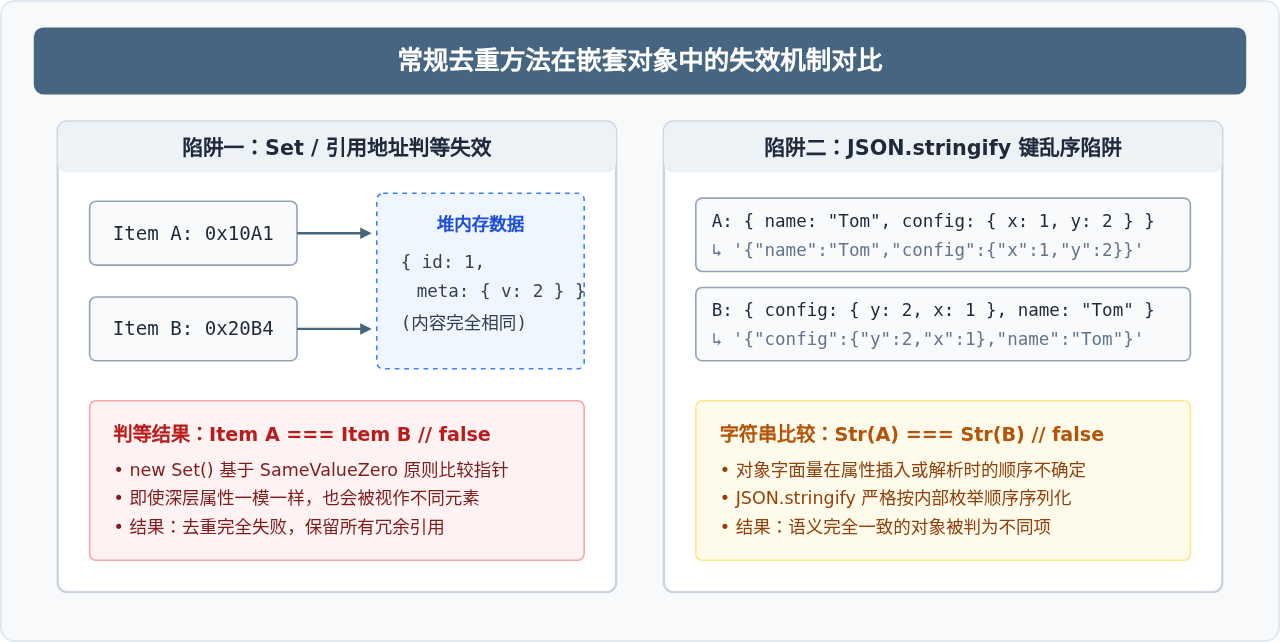
面对简单数组去重,开发者最习惯使用的是 Set、Array.prototype.filter 配套 indexOf,或者对单层对象做 JSON.stringify。但当数组元素具有多层嵌套属性时,会产生以下三个致命盲区:
- 内存引用差异:JavaScript 在比较对象时遵循引用相等原则(
===)。在内存中,{ a: 1 } !== { a: 1 },因为它们被分配在不同的堆内存地址上。因此无论是new Set([obj1, obj2])还是indexOf遍历,都无法识别深层内容相同的冗余项。 - JSON 序列化的键顺序陷阱:
JSON.stringify将对象转为字符串,但 ECMAScript 规范并不强制保证对象键字符串化的顺序与逻辑意图一致。例如{ id: 1, info: { name: "A", age: 20 } }与{ info: { age: 20, name: "A" }, id: 1 }表达完全相同的数据,但序列化出来的字符串完全不同,直接导致基于字符串哈希的去重逻辑漏判。 - 特殊类型与无序子数组丢失:原生
JSON.stringify会直接忽略值为undefined、函数或 Symbol 的键,并将Date转换为 ISO 字符串。若嵌套属性中还包含顺序无关的数组(如标签列表['vue', 'react']与['react', 'vue']),常规手段同样会判定为不相等。
二、方法一:基于嵌套路径唯一标识符的高效去重(O(n) 线性时间)
在实际业务开发中,绝大多数嵌套对象虽然结构深,但业务逻辑上都具备一个或一组代表唯一性的嵌套标识符(例如 item.user.profile.id 或 item.meta.code)。如果去重准则完全由该嵌套标识符决定,那么使用 Map 结合安全属性访问路径是最稳健且性能最高的方式。
1. 实现原理
我们通过一个安全的路径提取辅助函数按点分隔路径(如 "meta.id")读取嵌套值,然后以该值作为 Map 的键进行线性扫描遍历。未出现过的键存入 Map,重复项则直接过滤。
/**
 * 递归安全获取嵌套属性值
 * @param {Object} obj 目标对象
 * @param {string} path 属性路径,如 'user.detail.id'
 */
function getNestedValue(obj, path) {
  if (!obj || typeof path !== 'string') return undefined;
  return path.split('.').reduce((acc, key) => {
    return acc !== undefined && acc !== null ? acc[key] : undefined;
  }, obj);
}

/**
 * 依据嵌套属性路径进行数组去重
 * @param {Array<Object>} arr 输入数组
 * @param {string} keyPath 嵌套路径
 * @returns {Array<Object>} 去重后的数组
 */
function dedupByNestedKey(arr, keyPath) {
  if (!Array.isArray(arr)) return [];
  const seenMap = new Map();

  return arr.filter(item => {
    const uniqueVal = getNestedValue(item, keyPath);
    // 若未取到唯一值,按需决定保留或按对象引用兜底
    if (uniqueVal === undefined) return false;
    if (seenMap.has(uniqueVal)) {
      return false;
    }
    seenMap.set(uniqueVal, true);
    return true;
  });
}
2. 执行示例与验证
// 模拟测试数据(包含深层嵌套的重复项)
const mockList = [
  { group: 'A', user: { profile: { id: 101, name: 'Alice' } } },
  { group: 'B', user: { profile: { id: 102, name: 'Bob' } } },
  { group: 'A', user: { profile: { id: 101, name: 'Alice_Duplicate' } } }, // 重复ID
  { group: 'C', user: { profile: { id: 103, name: 'Charlie' } } }
];

const result = dedupByNestedKey(mockList, 'user.profile.id');
console.log(result.length); // 示例输出:3
console.log(result.map(i => i.user.profile.id)); // 示例输出:[101, 102, 103]O(n),空间复杂度为 O(n)。当能够明确界定核心唯一键时,这是最推荐的生产级写法。
三、方法二:规范化键排序递归序列化去重(Canonical JSON Hash)
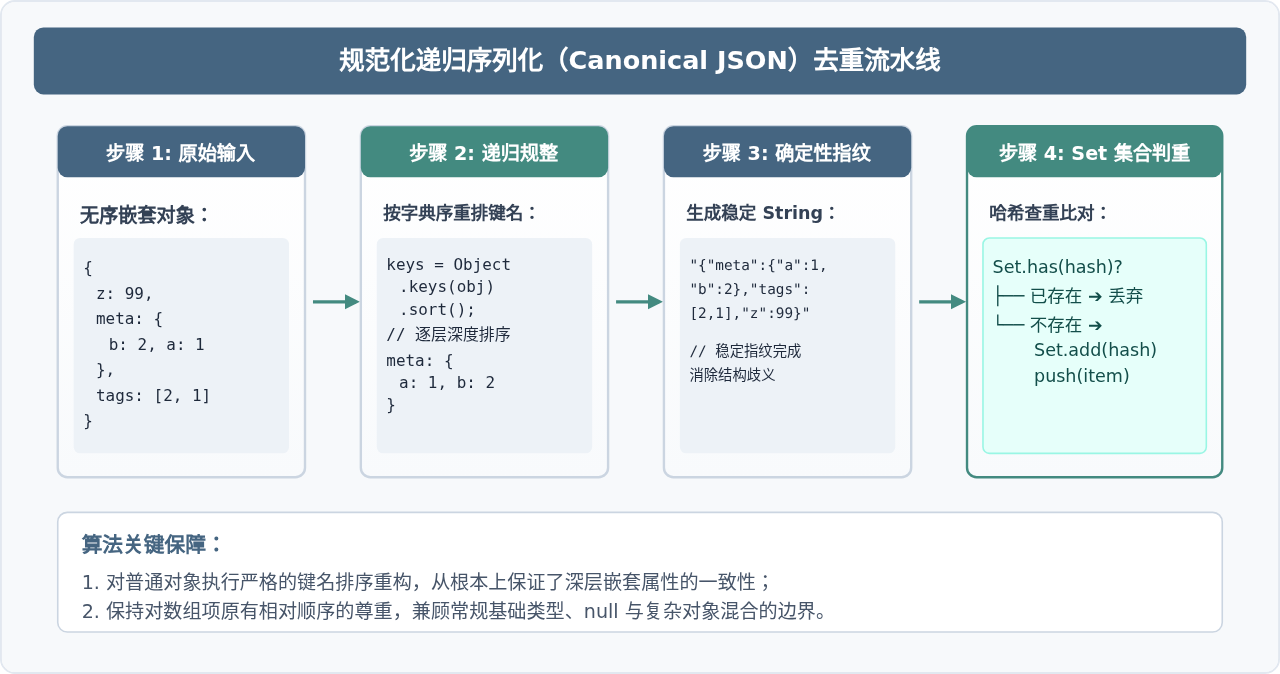
当嵌套对象没有固定业务唯一主键,必须通过全部字段内容的“深度全等”来去重,且前后端返回的对象属性书写顺序可能不一致时,我们需要采用规范化键排序序列化(Canonical Serialization)。
1. 算法工作流程
普通 JSON.stringify 失效的根源是对象属性遍历顺序不可控。因此,在序列化之前,我们通过递归遍历,把每一个普通对象的 Object.keys() 统一按照字典序升序排序,重新构造成属性顺序一致的新对象;对于数组,则保留原始元素顺序并对其子元素递归规范化。这样一来,无论原始对象的层级多么复杂、键名声明多么杂乱,只要内容一致,生成的字符串就必定完全一致。
2. 代码完整实现
/**
 * 递归规范化对象属性键名(按字典序排列)
 * @param {*} value 需要规整的目标值
 * @returns {*} 规范化后的数据结构
 */
function canonicalize(value) {
  // 1. 处理 null 或基本数据类型
  if (value === null || typeof value !== 'object') {
    return value;
  }

  // 2. 处理数组:递归规范化数组中的每一个元素
  if (Array.isArray(value)) {
    return value.map(canonicalize);
  }

  // 3. 处理普通对象:获取所有键并按字母升序排序
  const sortedKeys = Object.keys(value).sort();
  const normalizedObj = {};
  for (const key of sortedKeys) {
    normalizedObj[key] = canonicalize(value[key]);
  }
  return normalizedObj;
}

/**
 * 基于规范化序列化的深度对象数组去重
 * @param {Array<Object>} arr 输入数组
 * @returns {Array<Object>} 去重后的结果
 */
function dedupByCanonicalJson(arr) {
  if (!Array.isArray(arr)) return [];
  const seenSet = new Set();
  const result = [];

  for (const item of arr) {
    const canonicalObj = canonicalize(item);
    const hashKey = JSON.stringify(canonicalObj);

    if (!seenSet.has(hashKey)) {
      seenSet.add(hashKey);
      result.push(item); // 保留原对象引用
    }
  }

  return result;
}
3. 边界案例与测试输出
// 构造键名顺序颠倒、嵌套深度达到3层的测试数组
const complexList = [
  {
    title: 'Item 1',
    attributes: { color: 'red', size: 'M', detail: { stock: 10, batch: '2026A' } }
  },
  {
    // 故意打乱外层与内层属性的键顺序
    attributes: { size: 'M', detail: { batch: '2026A', stock: 10 }, color: 'red' },
    title: 'Item 1'
  },
  {
    title: 'Item 2',
    attributes: { color: 'blue', size: 'L', detail: { stock: 5, batch: '2026B' } }
  }
];

const deduped = dedupByCanonicalJson(complexList);
console.log(deduped.length); // 示例输出:2
console.log(deduped.map(item => item.title)); // 示例输出:['Item 1', 'Item 2']
通过规范化重构,原本在 JSON.stringify 下被判定为不同的两个对象成功被识别为重复项,只保留了首个出现的实例。
四、方法三:递归深度判等(Deep Equality)精确去重
序列化方法虽然通用,但在某些特定场景下存在局限:例如数据中包含 Date 对象(序列化后丢失原型变成字符串)、RegExp 实例、或者数据规模较小但希望避免频繁大字符串构建的内存消耗。此时,直接使用递归深度判等(Deep Equality)是更加原生的方式。
1. 递归判等算法执行流程
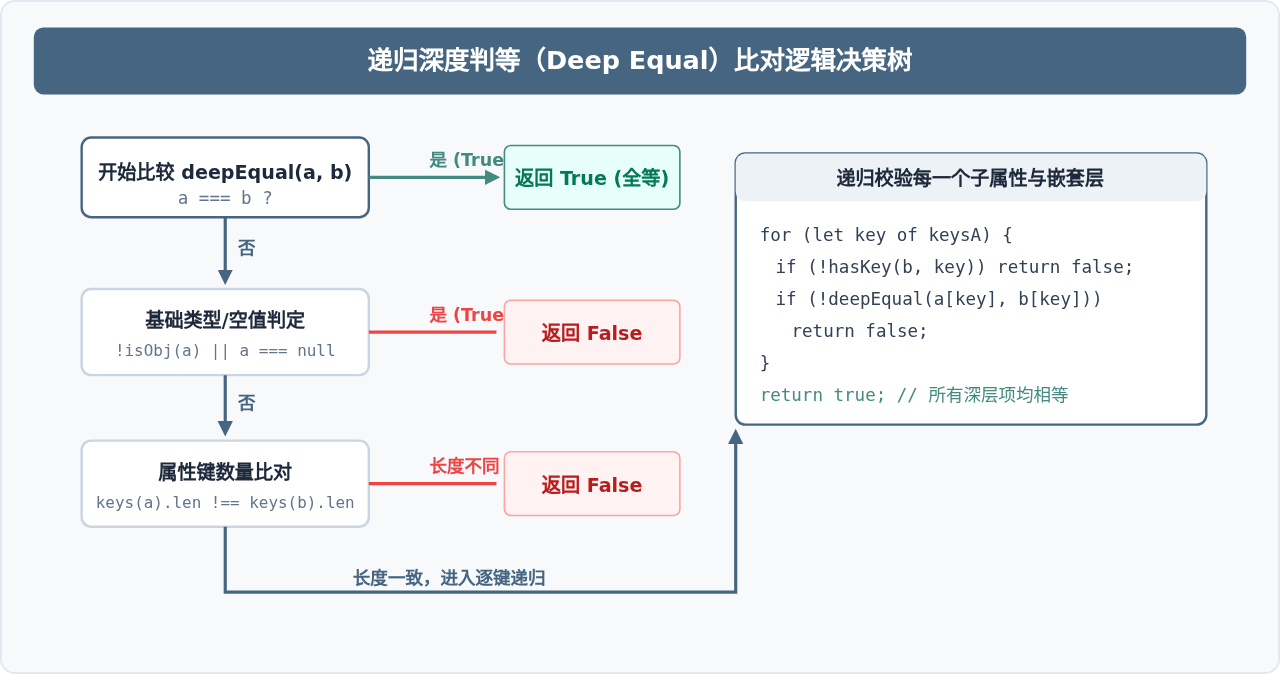
我们构建一个 isDeepEqual(a, b) 函数:
- 如果
a === b,直接返回true(处理相同引用或恒等基础类型); - 如果其中任意一个为
null或不是object,返回false; - 比对两者是否同为数组或同为对象;
- 比对两者的属性键数量是否完全相等;
- 遍历
a的所有键,递归验证b是否拥有相同的键且isDeepEqual(a[k], b[k])为true。
2. 代码完整实现
/**
 * 严格递归深度判等函数
 * @param {*} a 比较对象 A
 * @param {*} b 比较对象 B
 * @returns {boolean} 是否深度全等
 */
function isDeepEqual(a, b) {
  // 1. 引用恒等判定
  if (a === b) return true;

  // 2. 空值或非对象判定
  if (a === null || typeof a !== 'object' || b === null || typeof b !== 'object') {
    return false;
  }

  // 3. 数组类型匹配
  const isArrA = Array.isArray(a);
  const isArrB = Array.isArray(b);
  if (isArrA !== isArrB) return false;

  if (isArrA) {
    if (a.length !== b.length) return false;
    for (let i = 0; i < a.length; i++) {
      if (!isDeepEqual(a[i], b[i])) return false;
    }
    return true;
  }

  // 4. 特殊内置对象处理(例如 Date)
  if (a instanceof Date && b instanceof Date) {
    return a.getTime() === b.getTime();
  }

  // 5. 普通对象属性键比较
  const keysA = Object.keys(a);
  const keysB = Object.keys(b);
  if (keysA.length !== keysB.length) return false;

  for (const key of keysA) {
    if (!Object.prototype.hasOwnProperty.call(b, key)) return false;
    if (!isDeepEqual(a[key], b[key])) return false;
  }

  return true;
}

/**
 * 基于深度判等函数的数组去重
 * @param {Array<Object>} arr 输入数组
 * @returns {Array<Object>} 去重后的数组
 */
function dedupByDeepEqual(arr) {
  if (!Array.isArray(arr)) return [];
  const result = [];

  for (const currentItem of arr) {
    // 检查已存入的结果集中是否已存在与之深度相等的项
    const hasDuplicate = result.some(savedItem => isDeepEqual(savedItem, currentItem));
    if (!hasDuplicate) {
      result.push(currentItem);
    }
  }

  return result;
}dedupByDeepEqual 的时间复杂度为 O(n² × d)(其中 d 为平均深度与键数量)。对于长度在数百以内的中小数组,该方法表现优秀且无序列化字符串的内存开销;若数组长度达到上万级别,应优先使用方法一(键路径提取)或方法二(规范化哈希)。
五、特殊场景进阶:嵌套无序子数组的归一化处理
在复杂业务数据中,某些嵌套属性本身也是数组,例如用户的角色标签:roles: ['admin', 'audit'] 与 roles: ['audit', 'admin']。在许多业务设定中,标签的顺序并不代表差异,但对于上述规范化序列化和深度比较来说,它们默认会被视作顺序不同的两个不同数组。
针对这种“嵌套子数组项顺序无关”的场景,我们可以在规范化阶段对特定的数组属性(或纯基本类型的子数组)进行先排序、后比较的归一化处理:
/**
 * 针对无序数组属性进行归一化的序列化函数
 */
function canonicalizeWithOptions(value, options = {}) {
  const { sortPrimitivesArray = true } = options;

  if (value === null || typeof value !== 'object') {
    return value;
  }

  if (Array.isArray(value)) {
    let processed = value.map(v => canonicalizeWithOptions(v, options));
    // 若开启纯基础类型数组排序,消除如 ['tag2', 'tag1'] 的顺序差异
    if (sortPrimitivesArray && processed.every(x => typeof x !== 'object' || x === null)) {
      processed = [...processed].sort();
    }
    return processed;
  }

  const sortedKeys = Object.keys(value).sort();
  const result = {};
  for (const k of sortedKeys) {
    result[k] = canonicalizeWithOptions(value[k], options);
  }
  return result;
}
六、方案对比与选型决策指南
为了帮助你在实际业务场景中做出最合适的技术选型,我们将上述方案的适用边界、复杂度及特性整理如下:
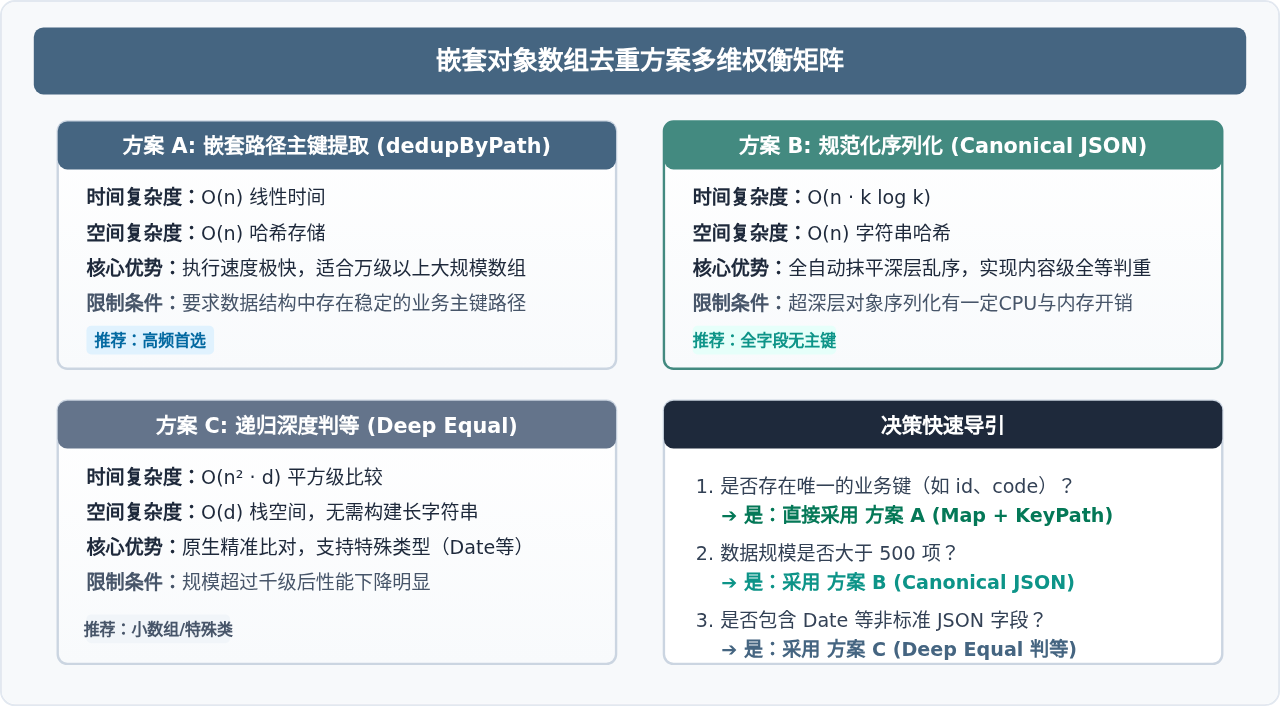
| 去重方案 | 时间复杂度 | 空间复杂度 | 消除键乱序 | 支持复杂类型 | 最适场景 |
|---|---|---|---|---|---|
| 基于嵌套路径 (Key Path) | O(n) | O(n) | 不涉及 | 是 (仅比对Key) | 中大型数据集、具有业务唯一键 |
| 规范化序列化 (Canonical JSON) | O(n · k log k) | O(n) | 完全支持 | 需转为JSON支持类型 | 无主键、内容全量深度去重 |
| 深度递归判等 (Deep Equal) | O(n² · d) | O(d) | 完全支持 | 完美支持 (Date/RegExp) | 小规模数据集、复杂对象实例 |
七、总结与工程落地建议
处理 JavaScript 嵌套对象数组去重时,不要盲目套用 new Set() 或直接 JSON.stringify。根据实际数据结构的特征匹配最适宜的算法,是保证代码鲁棒性与页面性能的关键:
- 优先寻找主键:只要业务上存在可提取的唯一路径,务必优先使用
Map配合路径查找,这是在大数据量下唯一能够保持毫秒级响应的线性方案; - 全量去重时务必规范化:在没有唯一键、需要全内容去重的场景中,务必引入递归排序规范化机制,消除属性书写顺序差异带来的误判;
- 控制深度比较的数据规模:针对
deepEqual等二次方时间复杂度的算法,在数据条数超过 1000 时应引起警惕,必要时可通过 Web Worker 在后台线程处理,避免阻塞主 UI 线程的渲染。
JS语法错误会阻止加载吗?区分SyntaxError与资源加载失败
2026-11-05 16:08:46
JavaScript常见SyntaxError语法错误排查与修复方法
2026-11-05 13:58:44
JS中slice、substring和substr截取字符串的区别
2026-11-05 13:43:47
JS 转 TS 手动迁移最佳实践:从配置 tsconfig 到消除 any 类型
2026-11-05 11:53:32
为什么JS数组push后得到的是数字而不是数组?
2026-11-05 09:59:18







