

JS按字符还是按字节截取字符串前几位
深入对比在 JavaScript 中按字符截取与按字节截取字符串的核心差异、业务场景与实现方法,解析 UTF-16 码元与 UTF-8 字节的本质不同,提供防截断乱码的高可用代码与选型决策指南。
\� 替代字符)。
一、核心原理:字符长度与字节长度为什么不相等?
很多开发者在初次接触字符串处理时,常习惯直接调用 str.length 来衡量长度。然而在 JavaScript 引擎中,str.length 返回的既不是“视觉上的字符个数”,也不是“物理存储所占用的字节数”,而是该字符串所包含的 UTF-16 码元(Code Unit)数量。
Unicode 标准定义了庞大的字符空间,被划分为不同的“平面(Planes)”:
- 基本多语言平面(BMP,U+0000 到 U+FFFF):包含所有常见 ASCII 字符以及大多数日常中日韩汉字。这些字符仅需 1 个 16 位的 UTF-16 码元即可表示,此时
str.length === 1。 - 辅助平面(Astral Planes,U+10000 到 U+10FFFF):包含大量 Emoji 表情、历史罕用字和特殊符号。UTF-16 无法用单个 16 位容纳,必须使用一对高低“代理对(Surrogate Pair)”共 2 个码元表示,因此
"😊".length === 2。 - 外部传输与存储编码(如 UTF-8):现代 Web 传输与主流数据库通常采用变长 UTF-8 编码。在 UTF-8 中,标准 ASCII 字符占 1 个字节,常见汉字占 3 个字节,而 Emoji 占 4 个字节。
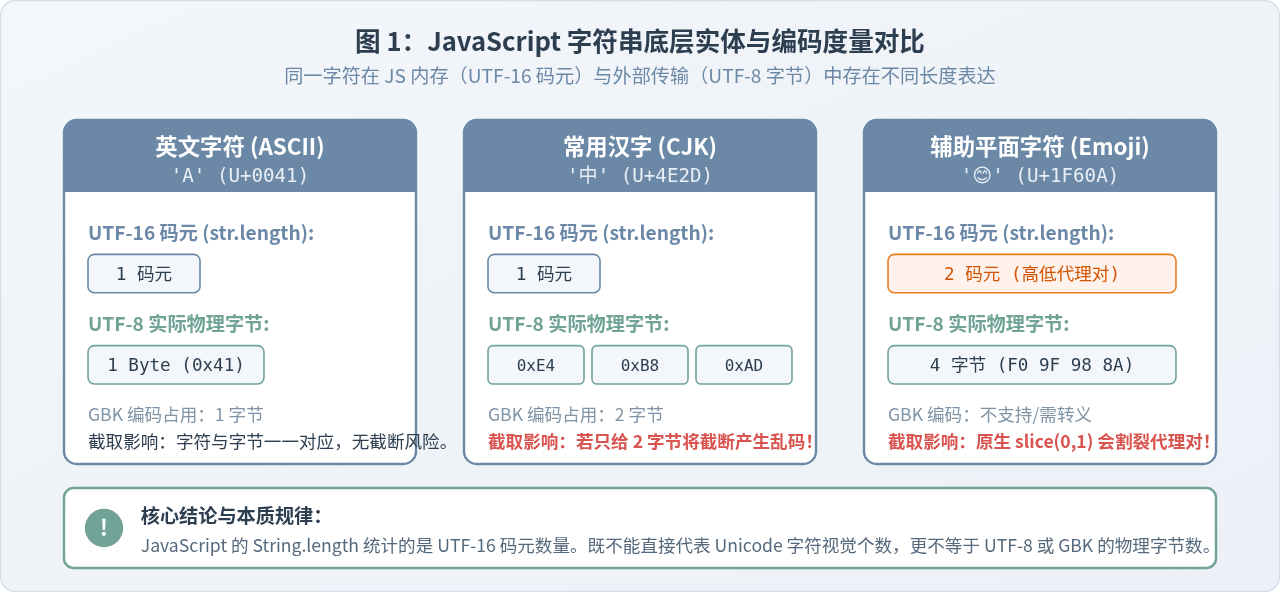
为了更直观地理解这种差异,我们对比三种典型字符在各维度的占用情况:
| 测试字符 | Unicode 码点 | JS str.length (UTF-16 码元) |
UTF-8 物理字节数 | 传统中文双字节 (全角算2) |
|---|---|---|---|---|
'A' |
U+0041 | 1 | 1 字节 | 1 字节 |
'中' |
U+4E2D | 1 | 3 字节 | 2 字节 |
'😊' |
U+1F60A | 2 (代理对) | 4 字节 |
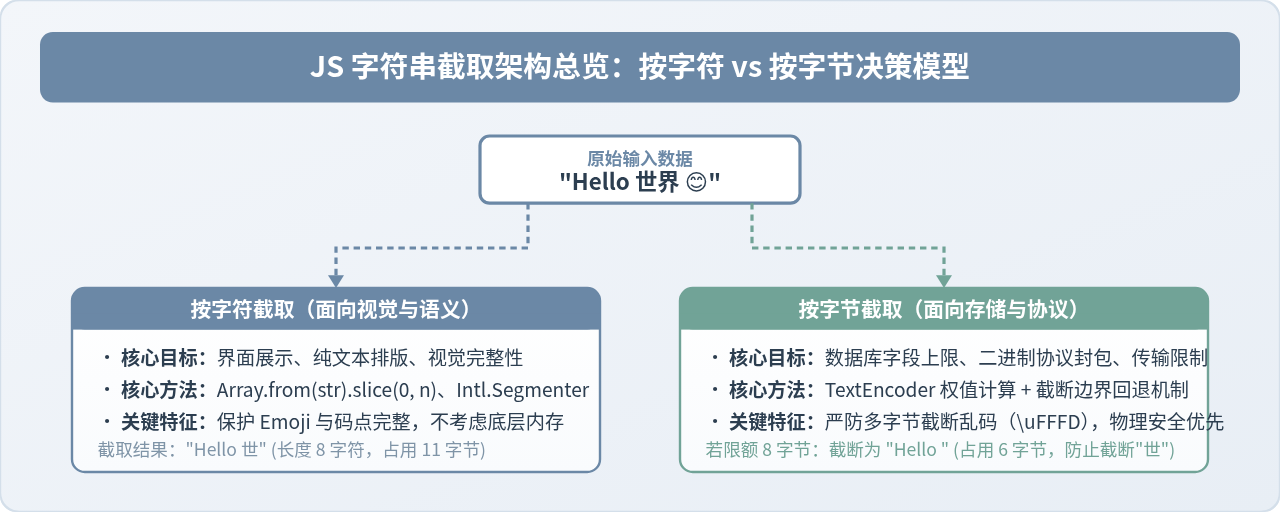
正是由于 1 个字符可能占用 1 到 4 个字节,且 1 个视觉字符可能对应 1 到 2 个码元,截取时才必须严格根据业务目标选择正确的截取策略。
二、场景一:什么情况下按字符截取?如何安全实现?
按字符截取的本质是面向人类的视觉与语言逻辑。当系统只关心“读者看到了几个字”,而不涉及底层二进制存储时,均属于按字符截取的范畴。
1. 典型适用场景
- UI 界面排版与防撑破:例如列表标题超出 10 个字显示省略号(
...)。 - 表单输入字数限制提示:用户端提示“最多输入 20 个字”,读者直觉认为输入一个汉字是一个字,输入一个 Emoji 也是一个字。
- 搜索结果列表摘要:提取文章前 50 个字作为高亮摘要。
2. 常见陷阱:原生 slice() 割裂代理对
初学者通常使用 str.slice(0, n)。对于纯英文字符或纯汉字,这没有问题。但如果目标字符串中包含辅助平面的字符(如 Emoji),原生 slice 会按照 UTF-16 码元进行暴力切割:
const title = "😊开心每一天";
// 试图截取前 1 个“字”
const broken = title.slice(0, 1);

console.log(broken); // 示例输出: "\uD83D" (高位代理,显示为乱码或空格)
console.log(title.slice(0, 2)); // 示例输出: "😊" (完整表情需要占用 2 个码元)
3. 安全按字符截取的推荐实现
在 ES6+ 环境下,使用展开运算符 [...str] 或 Array.from(str) 能够自动根据 Unicode 码点(Code Point)进行迭代,将高低代理对合并为单个完整字符:
/**
 * 按字符(Unicode 码点)安全截取前 n 位
 * @param {string} str - 原始字符串
 * @param {number} limit - 目标截取字符数
 * @returns {string} 截取后的完整字符串
 */
function truncateByChar(str, limit) {
  if (!str || limit <= 0) return "";
  // Array.from 会根据 Unicode 码点迭代,自动聚合代理对
  return Array.from(str).slice(0, limit).join("");
}

// 运行验证示例
const text1 = "😊开心每一天";
console.log(truncateByChar(text1, 1)); // 示例输出: "😊"
console.log(truncateByChar(text1, 3)); // 示例输出: "😊开心"\)拼合的复杂字符,可以使用现代浏览器的 Intl.Segmenter(..., { granularity: 'grapheme' }) 进行字位簇拆分,确保复杂表情不被拆解。
三、场景二:什么情况下按字节截取?核心痛点是什么?
按字节截取的本质是面向硬件存储、网络协议与外部系统契约。无论文字在屏幕上看起来多么简短,只要超过了物理分配的内存或缓冲区上限,就会造成系统故障。
1. 典型适用场景
- 关系型数据库字段硬限制:例如部分遗留数据库定长字段
VARCHAR(30)(按字节计算)、定长CHAR字段或 BLOB 数据块。 - 网络通讯与二进制封包:自定义网络协议或硬件设备通信报文中,协议头通常严格规定用户名、标题最多占用固定字节(如 32 字节),多余部分必须截断。
- 短信网关与电信服务接口:部分短信运营商接口严格按每条 70 字节或 140 字节分包计费,超长字节会被直接丢弃或强制拆包。
2. 核心挑战:多字节字符截断乱码
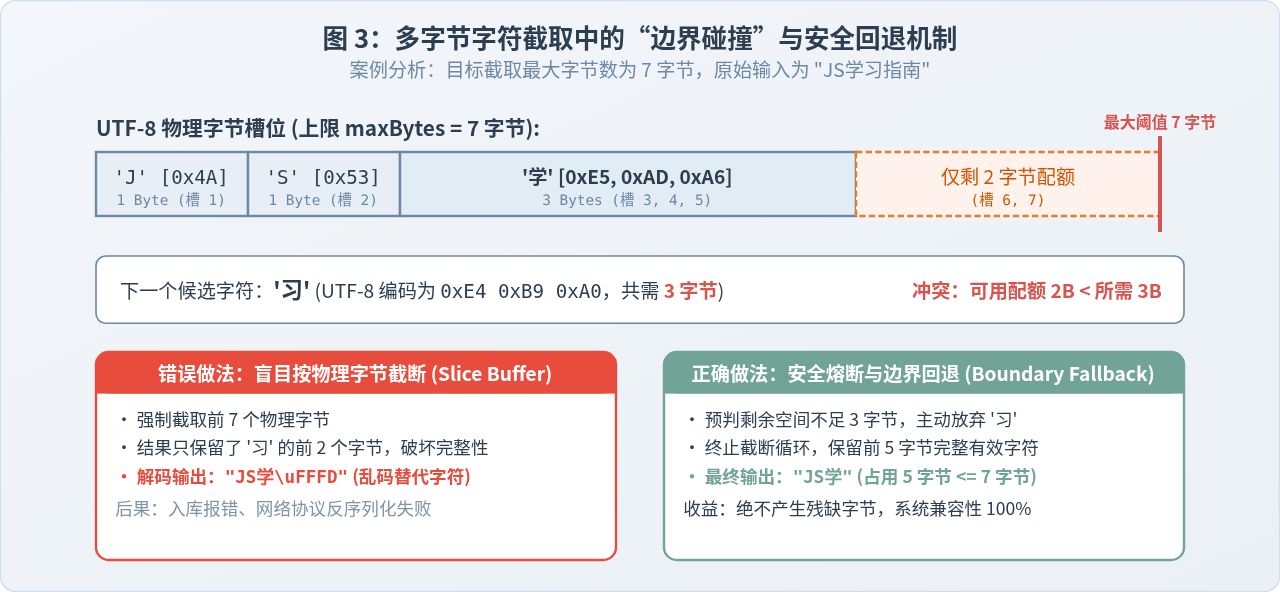
在 UTF-8 编码下,汉字由 3 个字节组成。假设数据库字段上限为 7 字节,若截取的字符串为 "JS学习指南":
'J'占 1 字节(累计 1)'S'占 1 字节(累计 2)'学'占 3 字节(累计 5)- 下一个字符
'习'同样需要 3 字节,若直接放入,累计将达到 8 字节,超过了 7 字节上限。
如果开发者简单地把字符串转成物理字节数组,然后强行切取前 7 个字节(buffer.slice(0, 7)),字符 '习' 就会被“腰斩”,只剩下前 2 个字节。当系统再次尝试以 UTF-8 解码这 7 个字节时,由于最后一个多字节序列不完整,解码器会判定其为非法序列,并将其替换为 \�(即乱码符号 )。
四、按字节截取的工程代码实现
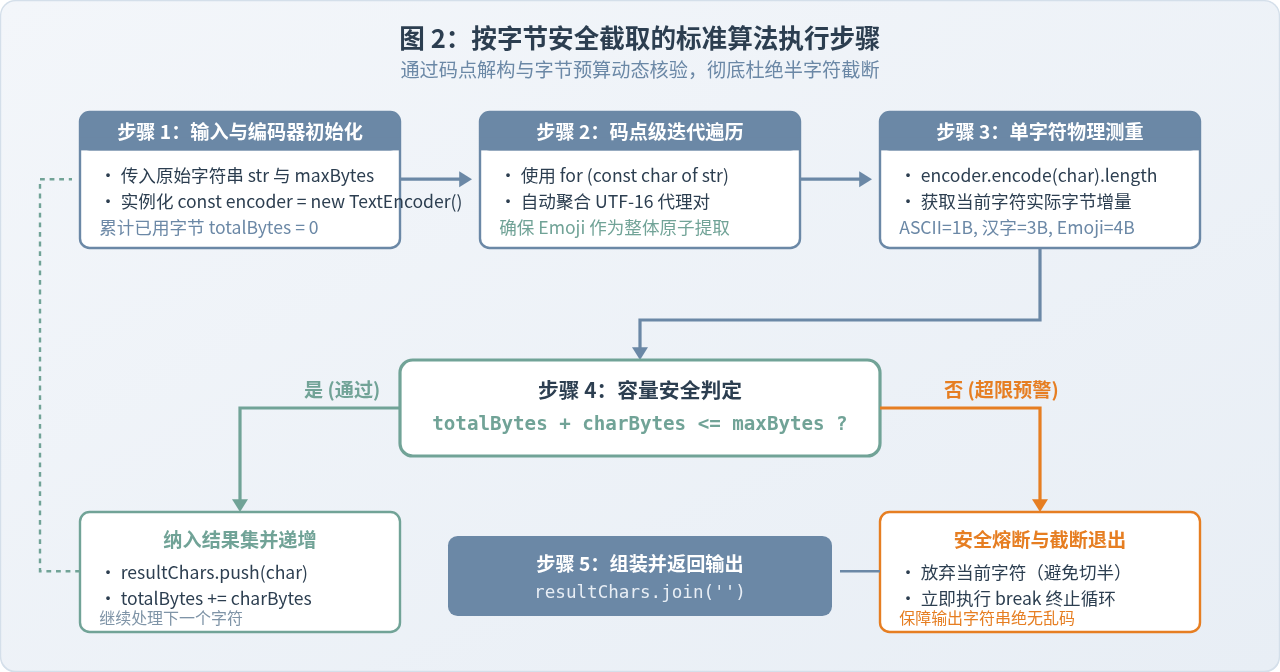
解决截断乱码的根本思路是:在迭代时提前预判单个字符所需的物理字节数,当剩余字节配额不足以容纳下一个完整字符时,主动触发安全熔断并放弃该字符。
1. 方案一:标准 UTF-8 字节安全截取(基于 TextEncoder)
现代浏览器与 Node.js 均原生支持 TextEncoder。我们可以遍历每个 Unicode 字符,动态计算该字符在 UTF-8 下的字节增量,确保任何字符都不会被拆分:
/**
 * 按 UTF-8 字节数安全截取字符串前几位(杜绝截断乱码)
 * @param {string} str - 原始输入字符串
 * @param {number} maxBytes - 允许占用的最大字节上限
 * @returns {string} 截取后的安全字符串
 */
function truncateByBytesUtf8(str, maxBytes) {
  if (!str || maxBytes <= 0) return "";

  const encoder = new TextEncoder();
  let totalBytes = 0;
  const safeChars = [];

  // 使用 for...of 按照 Unicode 码点迭代,确保 Emoji 等代理对不被拆散
  for (const char of str) {
    // 动态计算当前单个字符编码为 UTF-8 所需的实际字节数
    const charBytes = encoder.encode(char).length;

    // 边界碰撞检测:如果加上当前字符超过预算,立即终止
    if (totalBytes + charBytes > maxBytes) {
      break;
    }

    safeChars.push(char);
    totalBytes += charBytes;
  }

  return safeChars.join("");
}

// 示例验证 1:测试 7 字节边界截断
const testStr1 = "JS学习指南";
const result1 = truncateByBytesUtf8(testStr1, 7);
console.log(result1);
// 示例输出: "JS学" (占用 5 字节,未截取"习",避免了产生乱码)

// 示例验证 2:包含 Emoji 的边界截断 (Emoji 占 4 字节)
const testStr2 = "Hi😊世界";
// 'H'=1, 'i'=1, '😊'=4, '世'=3
console.log(truncateByBytesUtf8(testStr2, 5));
// 示例输出: "Hi" (因为 2 + 4 = 6 > 5,'😊' 放不下,安全回退)

console.log(truncateByBytesUtf8(testStr2, 6));
// 示例输出: "Hi😊" (刚好占用 6 字节)
2. 方案二:传统规则(汉字/全角算 2 字节,英文算 1 字节)
在很多国内传统系统、OA 报表或早期 GBK 编码接口中,往往不采用 UTF-8 的 3 字节规则,而是规定“全角/汉字算 2 字节,半角/英文算 1 字节”。此时我们可以利用正则进行权值计算:
/**
 * 按传统双字节规则(汉字/全角算2字节,ASCII算1字节)安全截取
 * @param {string} str - 原始字符串
 * @param {number} maxBytes - 最大字节限额
 * @returns {string} 截断结果
 */
function truncateByCustomBytes(str, maxBytes) {
  if (!str || maxBytes <= 0) return "";

  let currentBytes = 0;
  const result = [];

  for (const char of str) {
    // 匹配双字节字符(非 ASCII 范围)
    const isDoubleByte = /[^ -ÿ]/.test(char);
    const weight = isDoubleByte ? 2 : 1;

    if (currentBytes + weight > maxBytes) {
      break;
    }

    result.push(char);
    currentBytes += weight;
  }

  return result.join("");
}

// 示例验证
const testStr3 = "JavaScript编程";
console.log(truncateByCustomBytes(testStr3, 12));
// 示例输出: "JavaScript编" (10个英文字符=10字节,'编'=2字节,刚好12字节)
五、综合对比与选型决策指南
在实际项目落地时,应该按照以下决策矩阵快速确立截断策略:
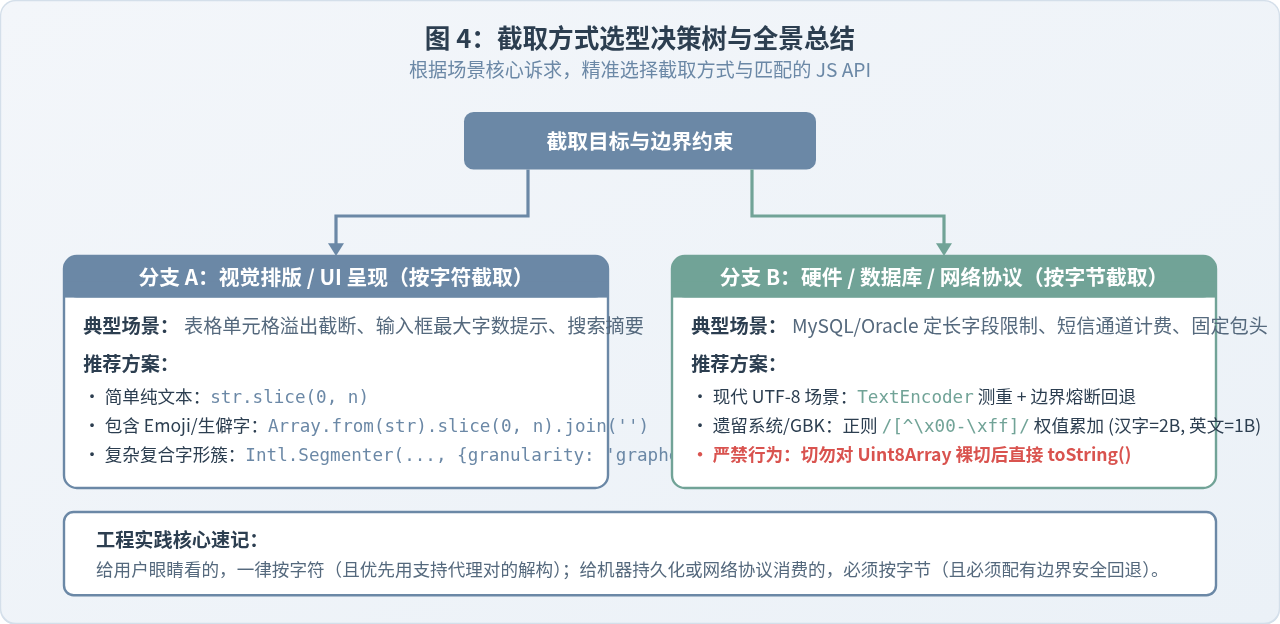
| 对比维度 | 按字符截取 | 按 UTF-8 字节截取 | 按传统双字节截取 |
|---|---|---|---|
| 核心受众 | 最终用户(人眼视觉阅读) | 现代网络传输、UTF-8 存储介质 | GBK 系统、旧版打印机、部分短信网关 |
| 计算基准 | Unicode 码点 / 字符簇 | UTF-8 物理字节流 (1~4 字节) | 单字节 / 双字节权值划分 |
| 推荐实现 | Array.from(str).slice(0, n) |
TextEncoder + 边界回退 |
正则 /[^ -ÿ]/ 累加 |
| Emoji 兼容性 | 需防范代理对撕裂 | 完整保留 4 字节,超限安全丢弃 | 通常会按双字节拆分或过滤 |
| 截断失败后果 | 显示不美观,排版溢出 | 多字节乱码、数据库入库报错 | 通信校验失败、文字折行失常 |
- 切勿裸切二进制 Buffer:直接对
Buffer.from(str).subarray(0, n)截取后转回字符串,如果切断了多字节编码序列,解码结果必现乱码。必须在字符边界处进行回退。 - 明确确认数据库字段语义:MySQL 5.0 之后,
VARCHAR(20)代表可以存储 20 个“字符”,无论中文还是英文;但在 Oracle 或更早版本的 MySQL 中,VARCHAR2(20)默认代表 20 个“字节”。在对接数据库前必须先核对列定义是按 CHAR 还是 BYTE 限制。 - 前后端校验规则保持绝对一致:如果前端表单按字符校验(例如限制 10 个字),而后端接口限制为 20 个字节,当用户输入 10 个汉字(在 UTF-8 下占用 30 字节)提交时,前端校验通过但后端将抛出溢出异常。因此涉及物理落库的字段,前端输入提示应明确注明“最多可输入 N 个英文字符或 M 个汉字”,并在提交前按字节进行兜底。
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02
p5.js 中 setup() 和 draw() 函数的执行机制详解
2026-11-05 12:32:38







