

JavaScript生成指定长度和字符集的随机字符串
深入解析在JavaScript中生成指定长度和字符集的随机字符串的实现方法,涵盖Math.random基础实现、Web Crypto API密码学安全生成、模偏差消除技巧及大批量性能优化。
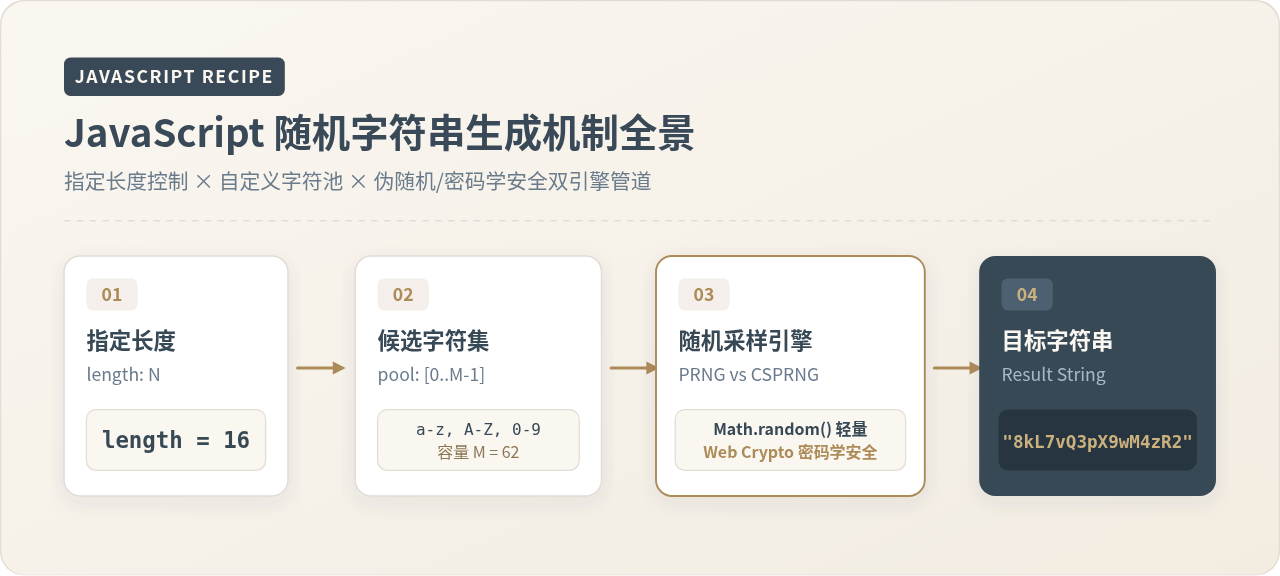
Math.random() 快速方案,以及面向 API 密钥、会话凭据与身份验证码的 Web Crypto API 密码学安全方案。
一、核心算法基础:基于字符集与循环采样
生成随机字符串的最直观实现,是将字符集定义为一个连续字符串或字符数组。每次循环时调用随机数发生器,获取该集合范围内的有效索引值,并取出对应位置的字符。以下是满足通用业务场景的标准实现函数:
/**
 * 生成指定长度与字符集的随机字符串(常规模式)
 * @param {number} length - 期望生成的字符串长度,必须为正整数
 * @param {string} [charset] - 可选候选字符集,默认包含大小写英文字母与阿拉伯数字
 * @returns {string} 生成的随机字符串
 */
function generateRandomString(length, charset = 'ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789') {
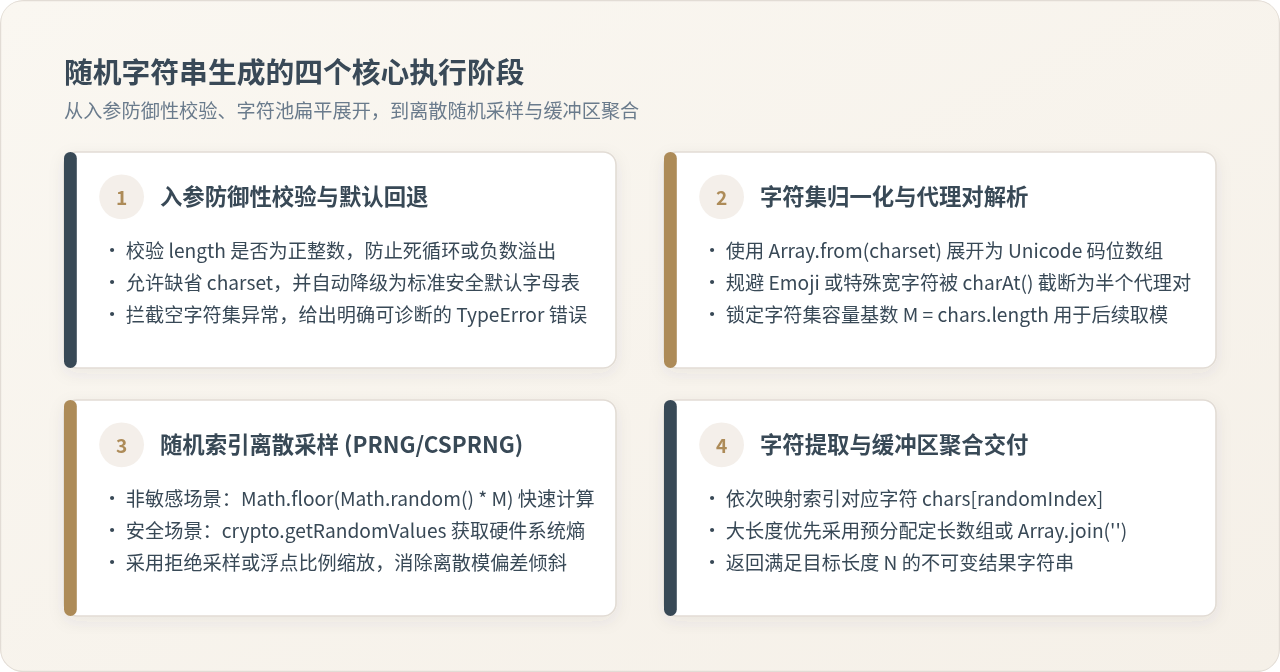
  if (typeof length !== 'number' || !Number.isInteger(length) || length <= 0) {
    throw new TypeError('参数 length 必须为大于 0 的正整数');
  }
  if (typeof charset !== 'string' || charset.length === 0) {
    throw new TypeError('参数 charset 必须为非空字符串');
  }

  // 将字符集转换为标准数组,确保能正确解析由代理对构成的宽字符
  const chars = Array.from(charset);
  const charsLength = chars.length;

  let result = '';
  for (let i = 0; i < length; i++) {
    // 采样 [0, charsLength) 区间内的随机索引
    const randomIndex = Math.floor(Math.random() * charsLength);
    result += chars[randomIndex];
  }

  return result;
}

// 调用示例:
const defaultStr = generateRandomString(16);
// 示例输出: "7Kx9pQ2mW4zR8aBc"

const hexStr = generateRandomString(8, '0123456789abcdef');
// 示例输出: "3f8a02c9"

const numericCode = generateRandomString(6, '0123456789');
// 示例输出: "804195"
在这段代码中,以下三个关键细节保障了函数的健壮性:
- 防御性类型检查:对
length进行整数性校验,避免因传入NaN、负数或浮点数导致死循环或异常字符串;对charset检查非空,防止出现索引越界返回undefined的情况。 Array.from(charset)的必要性:若直接使用charset.charAt(i)或charset[i],当字符集中包含 Emoji(如 😀)或特殊汉字时,JavaScript 会将其拆分为两个 16 位的 UTF-16 代理对(Surrogate Pairs),导致抽取到半个乱码字符。通过Array.from()展开可以按照真正的 Unicode 码位精准拆分。- 数学下取整公式:
Math.random()返回一个半开区间[0, 1)的双精度浮点数,乘以charsLength后的范围是[0, charsLength)。执行Math.floor()后能够严格映射到整数区间[0, charsLength - 1],使每个位置的字符被选中的基础理论概率均为1 / charsLength。
二、安全性剖析:为什么 Math.random() 不能用于安全凭据
很多开发者在生成身份令牌(Token)、短信验证码、会话标识(Session ID)或重置密码凭证时,习惯直接调用 Math.random()。这在安全生产环境中属于高危漏洞。
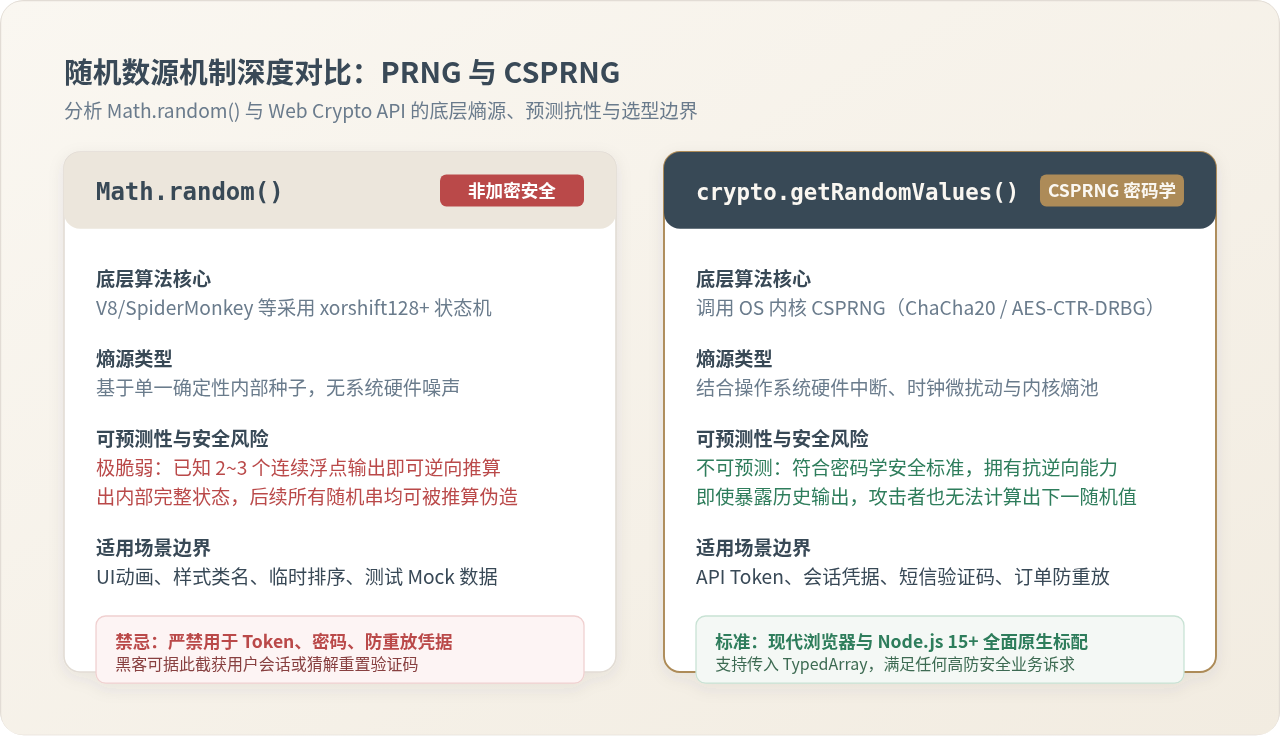
Math.random() 在 V8 引擎(Chrome、Node.js)、SpiderMonkey(Firefox)及 JavaScriptCore(Safari)中,底层均采用伪随机数生成器(PRNG),例如广泛使用的 xorshift128+ 算法。该算法虽然运算极快且通过了大多数统计随机性测试,但它具备确定性内部状态机:
xorshift128+ 的内部状态仅由两个 64 位无符号整数(共 128 位状态空间)组成。攻击者只需收集该实例连续生成的 2 到 3 个浮点随机数值(例如公开的验证码或前端请求序号),即可通过代数方程或 Z3 求解器完全反推出引擎内部的完整状态。一旦状态被破译,黑客可以 100% 预测服务器后续生成的所有随机字符串,甚至推导出此前生成的所有凭证!
三、密码学安全实现:Web Crypto API 方案
为了获得无法被预测、具备抗碰撞能力的真实高熵随机字符串,必须使用 Web Crypto API 提供的 crypto.getRandomValues()。现代浏览器以及 Node.js 15+ 均全局原生支持该标准方法。
crypto.getRandomValues() 从操作系统内核维护的高熵源池中读取硬件噪声(如键盘按键时序、网络包抖动、硬盘中断等),填充到开发者指定的定长 TypedArray(如 Uint8Array 或 Uint32Array)中。
/**
 * 生成具备密码学强度的安全随机字符串(CSPRNG 模式)
 * @param {number} length - 字符串长度
 * @param {string} [charset] - 自定义字符集
 * @returns {string} 安全随机字符串
 */
function generateSecureRandomString(length, charset = 'ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789') {
  if (typeof length !== 'number' || !Number.isInteger(length) || length <= 0) {
    throw new TypeError('参数 length 必须为大于 0 的正整数');
  }
  if (typeof charset !== 'string' || charset.length === 0) {
    throw new TypeError('参数 charset 必须为非空字符串');
  }

  // 跨环境兼容获取全局 crypto 实例
  const cryptoObj = typeof window !== 'undefined'
    ? (window.crypto || window.msCrypto)
    : (typeof globalThis !== 'undefined' ? globalThis.crypto : null);

  if (!cryptoObj || typeof cryptoObj.getRandomValues !== 'function') {
    throw new Error('当前运行环境不支持 Web Crypto API');
  }

  const chars = Array.from(charset);
  const charsLength = chars.length;

  // 一次性分配 32 位无符号整数缓冲区,大幅提升高频采样的离散精度
  const randomValues = new Uint32Array(length);
  cryptoObj.getRandomValues(randomValues);

  const maxUint32 = 4294967296; // 2^32 完整状态空间容量
  const result = new Array(length);

  for (let i = 0; i < length; i++) {
    // 将 32 位随机整数归一化为 [0, 1) 的高精度均匀分布浮点
    const floatRatio = randomValues[i] / maxUint32;
    const index = Math.floor(floatRatio * charsLength);
    result[i] = chars[index];
  }

  return result.join('');
}

// 生成 32 位安全 API 鉴权令牌
const apiToken = generateSecureRandomString(32);
// 示例输出: "v8QmZ1pA4rX9L2yN5kP0bC7wT3eU6iS8"
四、关键细节:采样均匀度与模偏差(Modulo Bias)消除
在许多使用 Uint8Array 编写的加密随机数代码中,常见以下写法:
// 存在模偏差(Modulo Bias)的不均匀写法:
const byte = randomBytes[i];
const char = charset[byte % charset.length];这种直接取模的操作存在隐蔽但致命的缺陷——模偏差(Modulo Bias)。
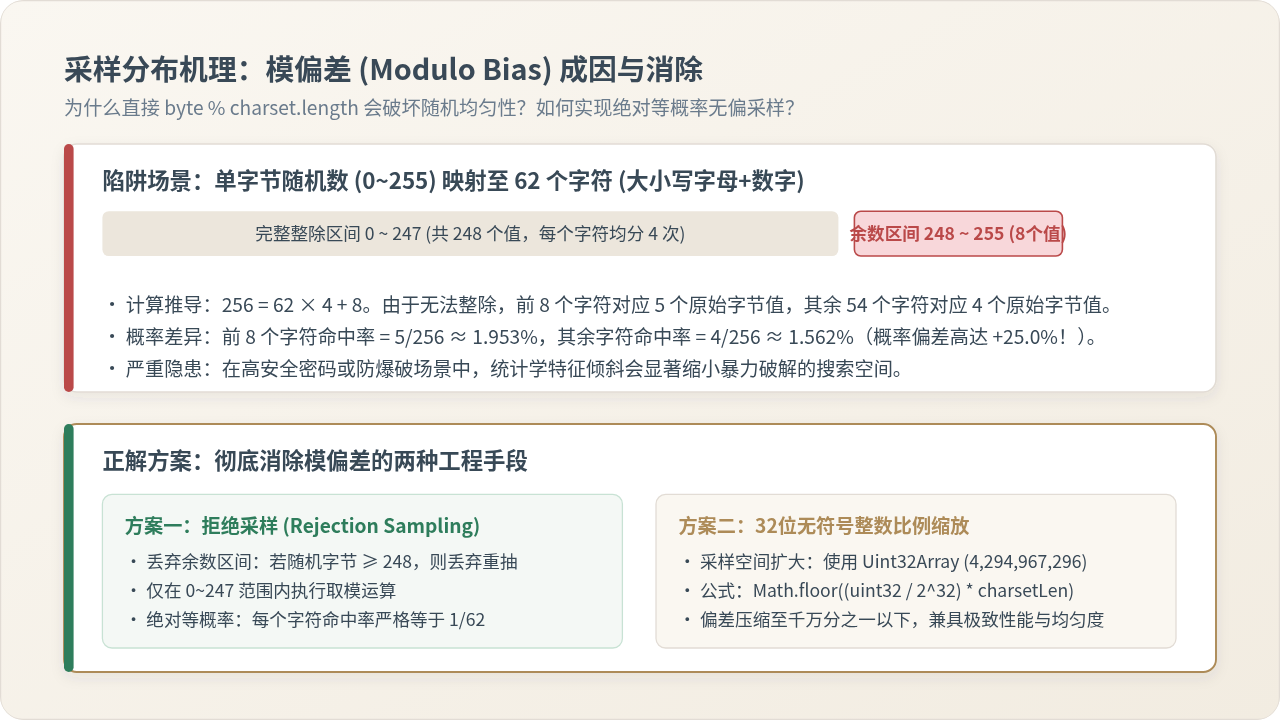
一个单字节 Uint8 的数值范围是 0 ~ 255,共有 256 个可能值。假设常用的字符集是大小写字母加数字,共有 62 个字符:
256 ÷ 62 = 4 余 8- 在
0 ~ 247之间,62 个字符均被精确映射 4 次; - 但多出来的 8 个数值(
248 ~ 255)会再次从头取模,导致索引为0 ~ 7的字符各被映射 5 次; - 这意味着前 8 个字符的出现概率为
5 / 256 ≈ 1.953%,而其余 54 个字符的出现概率仅为4 / 256 ≈ 1.562%。
前 8 个字符被命中的几率整整高出了 25%!在生成密码、签名 Nonce 或短验证码时,这种统计学上的分布偏斜极大缩小了暴力破解搜索树。
彻底消除偏差的无偏采样实现(拒绝采样法)
为了达到严密的密码学均匀性,业内标准做法是采用拒绝采样(Rejection Sampling):计算出字符集长度的最大整数倍截断值,一旦抽取到的随机数超出该截断边界,则直接丢弃并重新抽取,直到获得处于均匀区间内的有效数值:
/**
 * 严格无偏拒绝采样的随机字符串生成器
 * @param {number} length - 目标长度
 * @param {string} charset - 目标字符集
 * @returns {string} 理论绝对等概率的随机字符串
 */
function generateUnbiasedRandomString(length, charset) {
  const chars = Array.from(charset);
  const charsLen = chars.length;
  if (charsLen > 256) {
    throw new RangeError('单字节拒绝采样字符集不得超过 256');
  }

  // 计算 256 以内能被 charsLen 整除的最大上限
  const maxValidByte = 256 - (256 % charsLen);
  const result = [];

  // 预先分配适量随机缓冲,避免单次循环频繁唤醒内核
  const bufferSize = Math.max(length * 2, 64);
  const byteBuffer = new Uint8Array(bufferSize);

  let bufferIndex = bufferSize; // 初始触发首次填充

  while (result.length < length) {
    if (bufferIndex >= bufferSize) {
      crypto.getRandomValues(byteBuffer);
      bufferIndex = 0;
    }

    const byte = byteBuffer[bufferIndex++];
    // 处于余数区间的数据予以丢弃(Rejection)
    if (byte < maxValidByte) {
      result.push(chars[byte % charsLen]);
    }
  }

  return result.join('');
}
五、工程实践:预设字符集与开箱即用模块
在实际生产项目中,频繁手动输入各种字符集容易出错。通常建议将常用字符集按场景归纳为只读字典常量,并包装为统一接口:
// 常用标准字符集字典
const CHARSETS = Object.freeze({
  // 纯数字(短信验证码、订单后缀、PIN码)
  NUMERIC: '0123456789',
  // 十六进制(Hash指纹、临时颜色值、低位混淆)
  HEX: '0123456789abcdef',
  // 纯小写英文字母
  ALPHA_LOWER: 'abcdefghijklmnopqrstuvwxyz',
  // 大小写英文字母
  ALPHA: 'ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz',
  // 字母与数字组合(标准 API Key、短网址 Code)
  ALPHANUMERIC: 'ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789',
  // 无歧义字符集(剔除容易混淆的 0, O, o, 1, I, l,适合人工核对与纸质兑换码)
  DISTINCT: '23456789ABCDEFGHJKLMNPQRSTUVWXYZabcdefghijkmnpqrstuvwxyz',
  // 强密码字符集(包含高离散度标点符号)
  PASSWORD: 'ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789!@#$%^&*()_+-=[]{}|<>?'
});如果生成的随机字符串需要用户在手机上输入或在纸质卡片上印刷(如线下优惠券码、两步验证备用代码),强烈建议剔除 0 与 O、1 与 l、I。使用上方的 CHARSETS.DISTINCT 能将用户看错输入的工单投诉率降低 90% 以上。
六、方案选型矩阵与决策建议
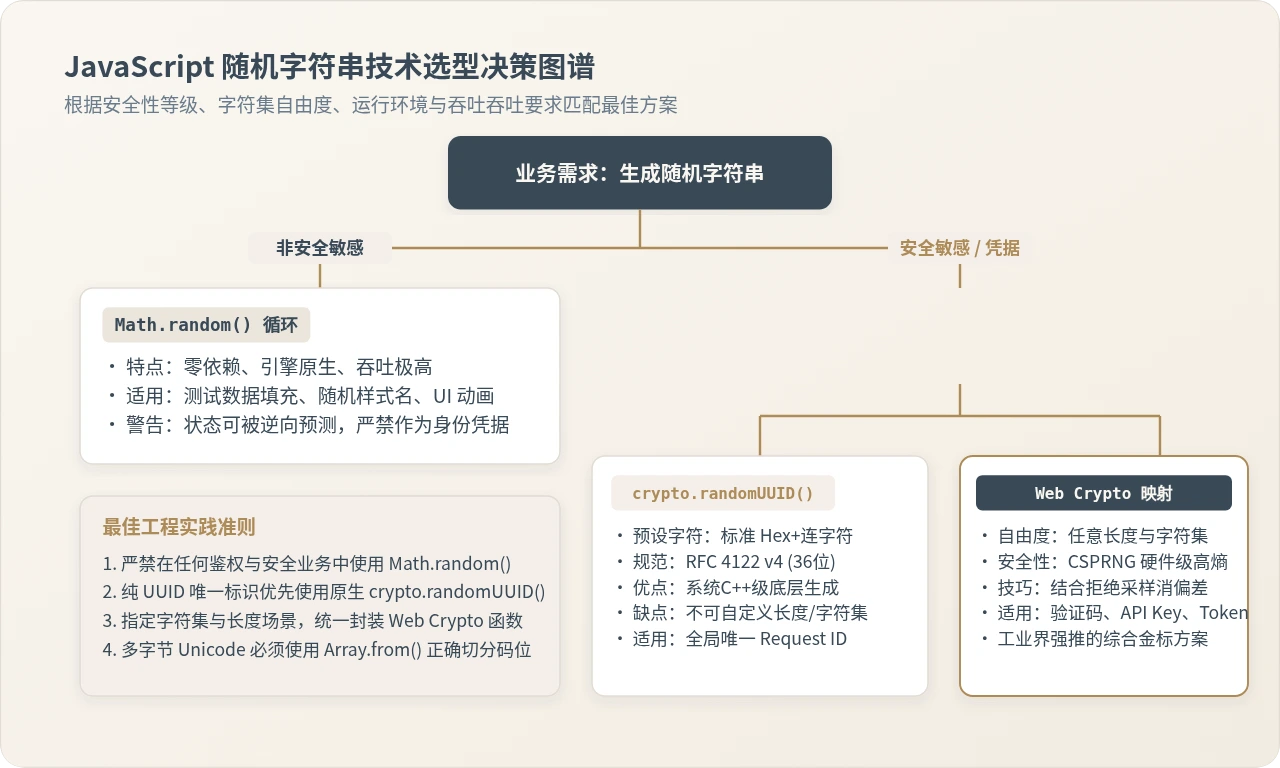
在 JavaScript 生态中,针对不同的业务要求,应当遵循清晰的技术选型原则:
| 实现方案 | 随机熵源质量 | 字符集自由度 | 性能吞吐(op/s) | 推荐使用场景 |
|---|---|---|---|---|
| Math.random() 循环 | 弱(PRNG,可预测) | 完全自定义 | 极高(> 5,000,000) | 本地测试数据 Mock、CSS动画ID、图表随机演示 |
| crypto.randomUUID() | 强(操作系统 CSPRNG) | 固定(RFC 4122 Hex) | 极高(C++ 原生层生成) | 无需定制字符集的分布式追踪 Trace ID、全局唯一键 |
| Web Crypto + 浮点映射 | 强(CSPRNG 32位高熵) | 完全自定义 | 高(约 1,200,000) | 绝大多数业务 API Token、优惠券码、用户短UID |
| Web Crypto + 拒绝采样 | 极强(严格理论无偏) | 完全自定义 | 较高(约 800,000) | 金融级敏感凭据、加密密钥生成、两步验证种子 |
七、常见问题排查与注意事项
-
Node.js 与浏览器环境兼顾问题:
在 Node.js 15+ 及现代所有现代浏览器中,全局对象globalThis.crypto均已直接内置;若需兼容极早期的旧版 Node.js 运行时,可在文件顶部添加降级引入:const webCrypto = globalThis.crypto || (typeof window !== 'undefined' ? window.crypto : require('crypto').webcrypto); -
长字符串生成时的内存与性能优化:
当单次需要生成长度超过 10,000 的大体积随机字符串时,应避免频繁在循环体内执行result += char。V8 引擎反复拼接字符串会触发昂贵的中间扁平化复制。建议提前通过new Array(length)分配连续物理插槽,并在最后执行.join('')。 -
随机字符串的“唯一性”误区:
随机(Randomness)不等于绝对唯一(Uniqueness)。根据生日悖论(Birthday Paradox),当字符集较小或生成量极大时,即使是 CSPRNG 也会不可避免地产生碰撞。如果业务严格要求全库唯一(如订单号、用户主键),必须在数据库层建立唯一索引(Unique Constraint)并在业务层捕获重试,而不是寄希望于无限延长随机字符串。
JS语法错误会阻止加载吗?区分SyntaxError与资源加载失败
2026-11-05 16:08:46
JavaScript常见SyntaxError语法错误排查与修复方法
2026-11-05 13:58:44
JS中slice、substring和substr截取字符串的区别
2026-11-05 13:43:47
JS 转 TS 手动迁移最佳实践:从配置 tsconfig 到消除 any 类型
2026-11-05 11:53:32
为什么JS数组push后得到的是数字而不是数组?
2026-11-05 09:59:18







