怎么用 JavaScript Set 实现数组的交集、并集和差集
详细讲解如何利用 JavaScript 原生 Set 与扩展运算符、filter 方法高效实现数组的交集、并集、差集与对称差集,解析底层哈希检索原理、ECMAScript 2025 原生方法及对象数组避坑方案。
在 JavaScript 中,处理数组的交集、并集和差集,最直接且高效的方法是借助 ES6 引入的 Set(集合)数据结构。Set 原生保证了集合内成员的唯一性,并通过底层的哈希表提供了平均时间复杂度为 O(1) 的 has() 成员检测能力。通过结合数组扩展运算符(...)与高阶过滤方法(filter),或者直接调用现代 ECMAScript 2025 规范内建的原生集合方法,我们可以用简洁且高性能的代码完成数组间的集合代数运算。本文将逐一给出标准实现、底层检索原理解析以及处理对象数组时的边界避坑指南。
一、集合运算的数学模型与核心概念
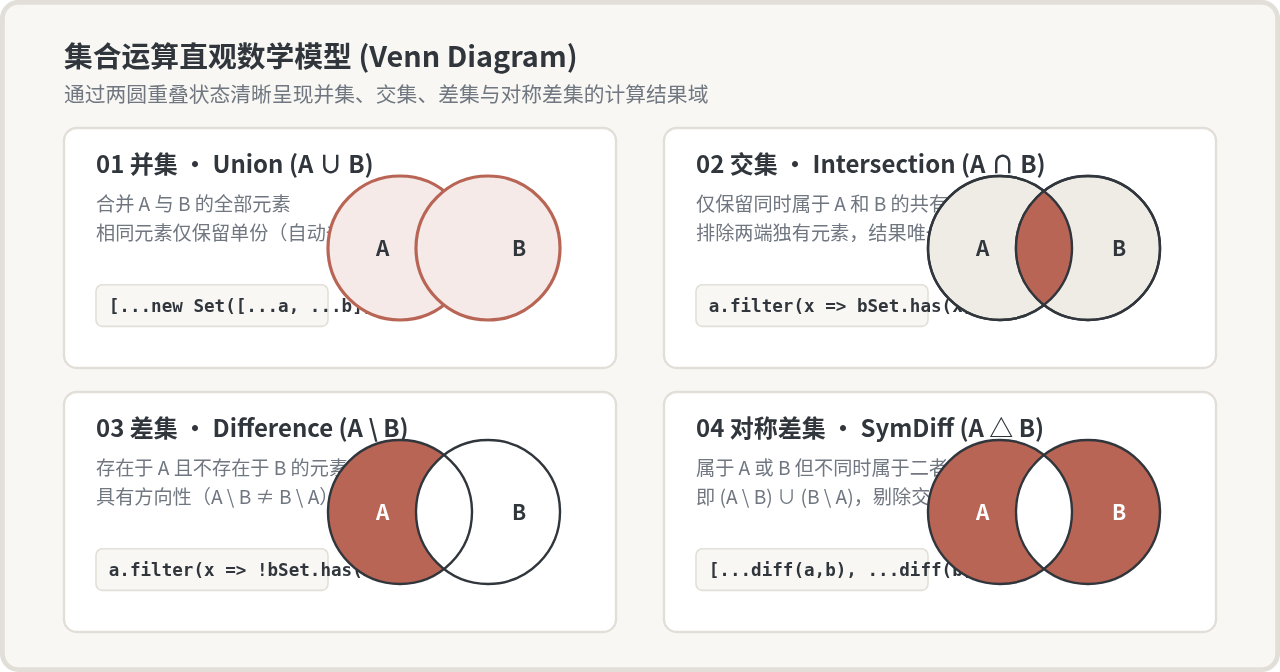
在进入代码实现之前,需要明确数组之间四大核心集合运算的输入与预期输出定义。假设存在两个输入数组 arrA 与 arrB:
- 并集(Union,A ∪ B):包含数组 A 与数组 B 中出现的所有元素,重复元素仅保留一份。
- 交集(Intersection,A ∩ B):仅包含同时出现在数组 A 与数组 B 中的共有元素。
- 差集(Difference,A \ B):仅包含存在于数组 A 中、但不存在于数组 B 中的元素。差集运算具有严格的方向性,
A \ B与B \ A的结果通常不同。 - 对称差集(Symmetric Difference,A △ B):属于数组 A 或属于数组 B,但不同时存在于二者之中的元素合集。数学上等价于
(A \ B) ∪ (B \ A)。
二、数组并集(Union)的实现与去重机制
并集的目标是合并多个序列的所有元素,并剔除重复值。使用 Set 实现并集最为简洁,只需利用扩展运算符将两个数组展开至新数组中,随后传入 new Set() 自动去重,再将 Set 展开回常规数组即可。
1. 基础双数组并集
// 实现两个数组的并集
const union = (arrA, arrB) => [...new Set([...arrA, ...arrB])];

// 测试示例
const numsA = [1, 2, 3, 4];
const numsB = [3, 4, 5, 6];
const result = union(numsA, numsB);
console.log(result);
原理解析:[...arrA, ...arrB] 首先将两个数组连接为一个包含 8 个元素的过渡数组 [1, 2, 3, 4, 3, 4, 5, 6]。当该数组传入 new Set(...) 构造函数时,集合底层依据 SameValueZero 判等机制遍历每个元素,重复出现的 3 和 4 在第二次插入时会被自动忽略。最外层的 [...] 操作符则重新将 Set 实例转换为纯净的 JavaScript 数组。
2. 多数组并集扩展
如果需要求三个或更多数组的并集,可以使用剩余参数结合 flat() 方法:
// 多个数组求并集
const unionMultiple = (...arrays) => [...new Set(arrays.flat())];

const resMulti = unionMultiple([1, 2], [2, 3], [3, 4, 5]);
console.log(resMulti);三、数组交集与差集的经典实现
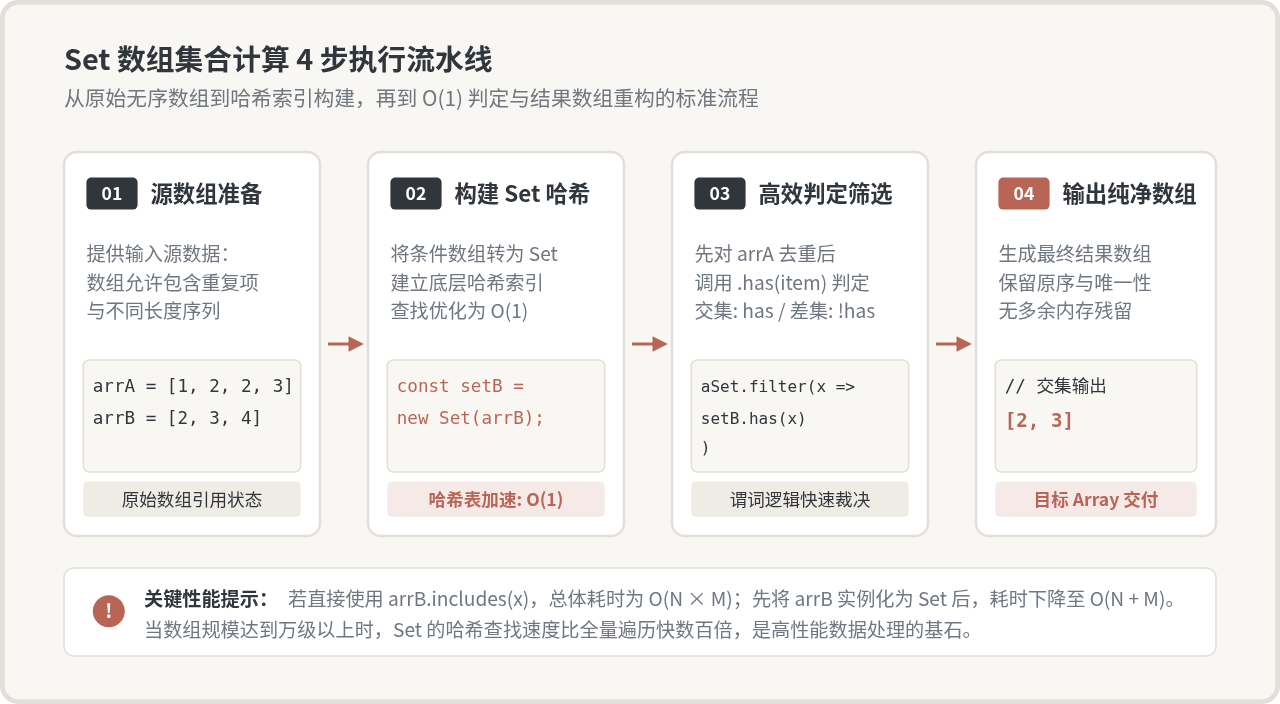
初学者在实现交集或差集时,常习惯使用 arrA.filter(item => arrB.includes(item))。这种写法虽然简短,但存在严重的性能隐患:includes() 在底层是线性扫描,时间复杂度为 O(M),嵌套在 filter() 中会导致总耗时恶化为 O(N × M)。当数组规模达数万条记录时,页面或服务会出现明显的卡顿。
正确的优化做法是:先将对比基准数组实例化为 Set。由于 Set.prototype.has() 采用哈希寻址,时间复杂度仅为 O(1),整体运算时间由此降至线性的 O(N + M)。
1. 数组交集(Intersection)的标准写法
在提取两数组共有元素时,务必注意输入源数组本身可能带有重复项。如果直接对未去重的 arrA 执行 filter,结果中可能会残留重复值。因此,严谨的交集函数应当对主遍历数组同步完成去重:
// 规范的数组交集函数
const intersection = (arrA, arrB) => {
  const setB = new Set(arrB);
  // 先通过 new Set(arrA) 阻断 arrA 自身的重复值
  return [...new Set(arrA)].filter(item => setB.has(item));
};

// 测试示例(含重复值场景)
const listA = [2, 2, 3, 4, 5];
const listB = [3, 4, 4, 6];
console.log(intersection(listA, listB));2. 数组单向差集(Difference)
差集用于筛选“存在于 A、但在 B 中未曾出现”的元素。逻辑上只需将交集的断言条件取反即可:
// 单向差集 (arrA \ arrB)
const difference = (arrA, arrB) => {
  const setB = new Set(arrB);
  return [...new Set(arrA)].filter(item => !setB.has(item));
};

const baseA = [1, 2, 3, 4];
const baseB = [3, 4, 5, 6];

console.log("A 差 B:", difference(baseA, baseB));
console.log("B 差 A:", difference(baseB, baseA));3. 对称差集(Symmetric Difference)
对称差集是两个单向差集的并集。最直接的实现方式是分别计算 A \ B 和 B \ A 并将其合并:
// 对称差集:属于 A 或 B 但不同时属于二者
const symmetricDifference = (arrA, arrB) => {
  const setA = new Set(arrA);
  const setB = new Set(arrB);

  const diffA = [...setA].filter(x => !setB.has(x));
  const diffB = [...setB].filter(x => !setA.has(x));

  return [...diffA, ...diffB];
};

const group1 = [1, 2, 3];
const group2 = [2, 3, 4, 5];
console.log(symmetricDifference(group1, group2));四、现代 ECMAScript 2025 原生 Set 集合方法
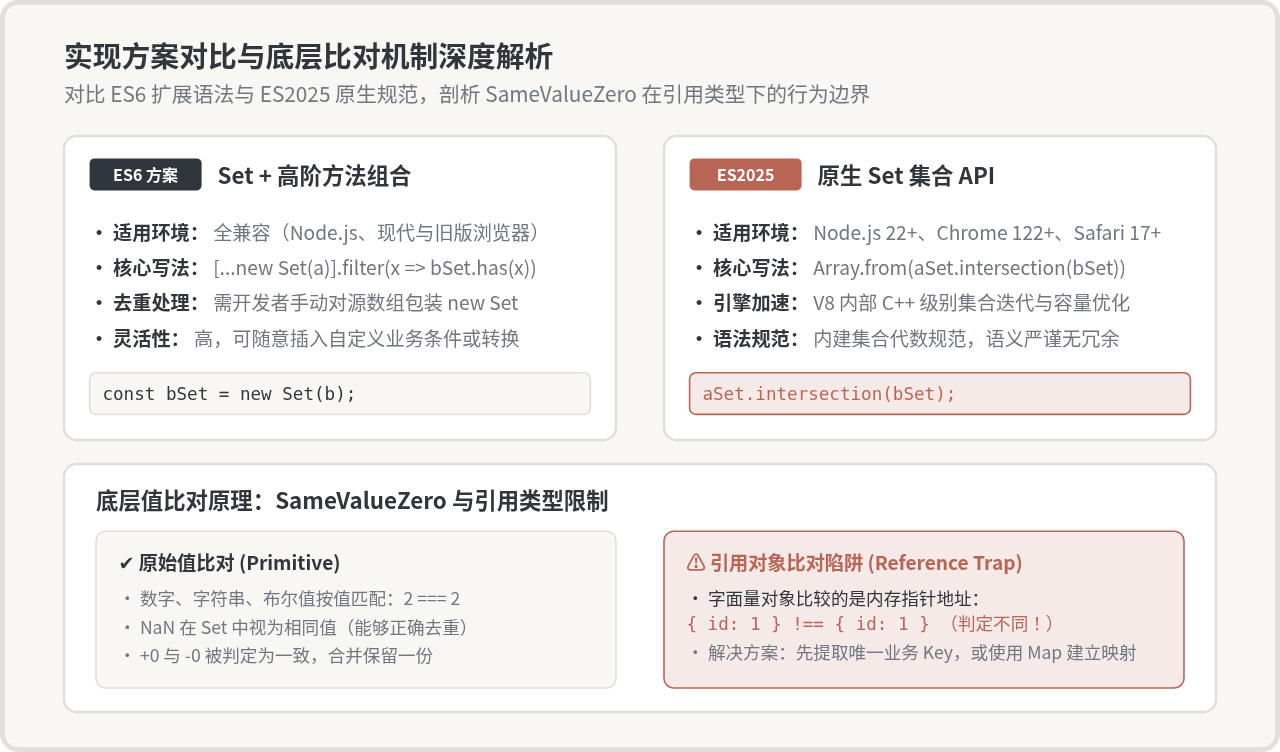
随着 ECMAScript 规范的演进,原生 Set 对象已经正式支持内建的集合代数操作(Set Methods 提案)。现代 JavaScript 运行时无需再手动手写 filter 和 has 的组合,可以直接调用语言级别优化的高性能原生方法。
1. 原生 API 使用方式
新规范为 Set.prototype 新增了以下方法:
setA.intersection(setB):返回两集合的交集 Set。setA.union(setB):返回两集合的并集 Set。setA.difference(setB):返回两集合的差集 Set。setA.symmetricDifference(setB):返回两集合的对称差集 Set。
将原生 API 包装为数组操作函数非常直观:
// 基于 ES2025 原生集合 API 的数组运算封装
const nativeIntersect = (a, b) => Array.from(new Set(a).intersection(new Set(b)));
const nativeUnion     = (a, b) => Array.from(new Set(a).union(new Set(b)));
const nativeDiff      = (a, b) => Array.from(new Set(a).difference(new Set(b)));
const nativeSymDiff   = (a, b) => Array.from(new Set(a).symmetricDifference(new Set(b)));

// 运行验证
const arrX = [10, 20, 30];
const arrY = [20, 30, 40];

console.log("原生交集:", nativeIntersect(arrX, arrY));
console.log("原生差集:", nativeDiff(arrX, arrY));core-js 对应的 Polyfill。
五、高频陷阱与边界场景处理
1. 引用类型(对象数组)的判等陷阱
Set 内部基于 ECMAScript 规范的 SameValueZero 算法判断两个元素是否一致。对于数字、字符串、布尔值等原始类型(Primitives),比较的是值本身;但对于对象、数组或函数等引用类型,比较的是内存引用地址。
// 常见错误示范:对象数组直接使用 Set 交集
const usersA = [{ id: 1, name: "Alice" }, { id: 2, name: "Bob" }];
const usersB = [{ id: 1, name: "Alice" }, { id: 3, name: "Charlie" }];

const badResult = usersA.filter(u => new Set(usersB).has(u));
console.log(badResult); // 输出为空 []!因为内存地址不同
解决方案:基于业务主键(Key)建立 Set 索引。对于对象数组,应提取能够代表唯一身份的属性(如 id)构建哈希集合:
// 正确的对象数组求交集方案
const intersectByProperty = (arrA, arrB, key) => {
  const allowedKeys = new Set(arrB.map(item => item[key]));
  return arrA.filter(item => allowedKeys.has(item[key]));
};

const validResult = intersectByProperty(usersA, usersB, "id");
console.log(validResult);2. NaN 与正负零(+0 / -0)的特殊判等
在纯 JavaScript 中,NaN === NaN 返回 false。然而在 Set 中,依照 SameValueZero 规定,所有 NaN 被视作同一个元素,且 +0 与 -0 完全等价。这意味着在含有 NaN 的数组中求并集或交集时,Set 能够正确去重,不会出现因 NaN !== NaN 导致的异常重复。
3. 结果元素的排列顺序
JavaScript 的 Set 保证按照元素的插入顺序进行迭代。因此,使用 [...new Set(arrA)].filter(...) 求交集或差集时,生成的结果数组将严格保留元素在 arrA 中首次出现时的相对顺序,这在处理具备时间或优先级序列的列表时非常安全。
六、全场景总结与选型速查
为了方便日常开发查阅,下表与图表归纳了不同集合运算的通用实现范式与运行特征:
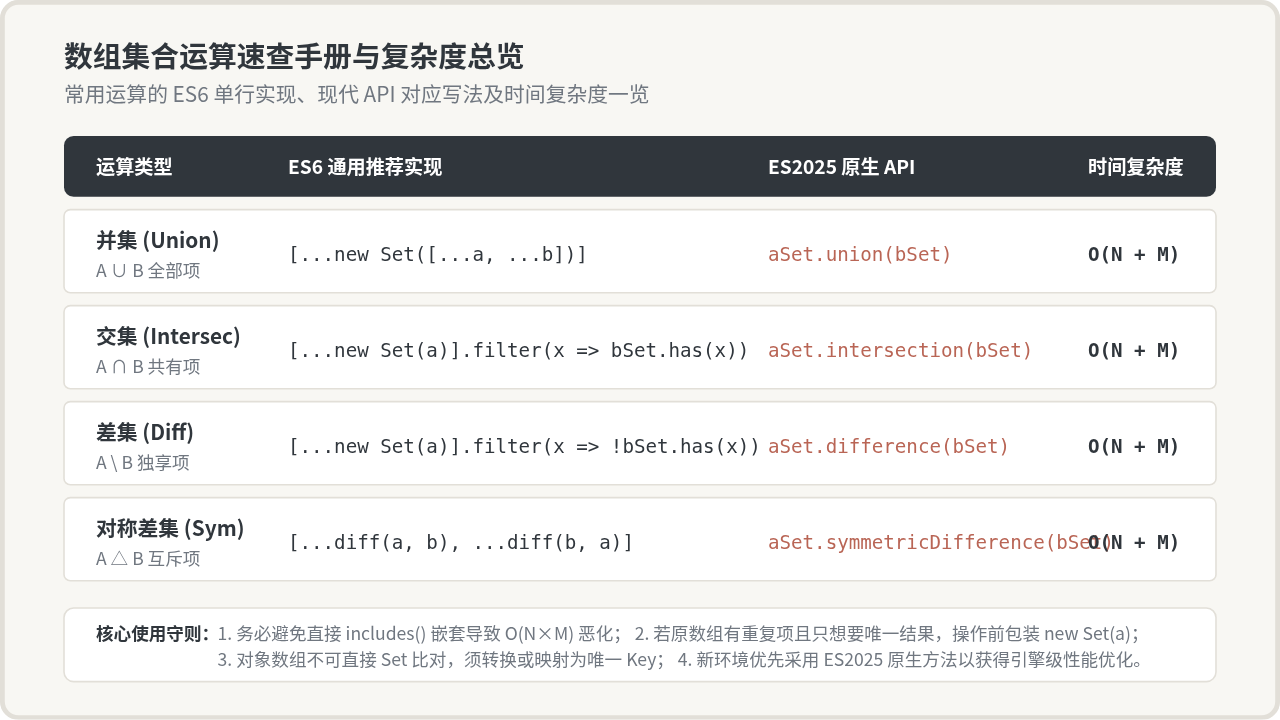
| 运算类型 | ES6 通用兼容写法 | ES2025 原生方法 | 时间复杂度 |
|---|---|---|---|
| 并集 (Union) | [...new Set([...a, ...b])] |
Array.from(aSet.union(bSet)) |
O(N + M) |
| 交集 (Intersection) | [...new Set(a)].filter(x => bSet.has(x)) |
Array.from(aSet.intersection(bSet)) |
O(N + M) |
| 差集 (Difference) | [...new Set(a)].filter(x => !bSet.has(x)) |
Array.from(aSet.difference(bSet)) |
O(N + M) |
| 对称差集 (SymDiff) | [...diff(a, b), ...diff(b, a)] |
Array.from(aSet.symmetricDifference(bSet)) |
O(N + M) |
在实际工程开发中:
- 对于基本类型数据(数字、字符串),优先选择
Set.prototype.has()结合filter的组合模式,代码量极少且兼备最优执行性能; - 在新一代服务端(Node.js 22+)或现代现代桌面端环境中,可直接启用 ES2025 原生 Set 方法,获得更具声明式风格的集合运算能力;
- 处理业务对象数组时,始终警惕引用地址不同引发的判等失效问题,通过提取主键 Key 建立中间辅助集合即可稳妥解决。
JS读取本地文件时报错或无响应的常见原因
2026-11-05 16:32:31
let、const与var的区别:JavaScript变量声明最佳实践
2026-11-05 14:16:38
JS中直接定义静态二维数组的字面量写法
2026-11-05 14:16:08
JS 怎么查找字符串中所有匹配项的位置
2026-11-05 14:15:53
JavaScript新手常犯的编码错误与最佳实践指南
2026-11-04 22:12:38
相关标签: