JavaScript Map 与 Object 的对比:键类型与遍历顺序
深入对比 JavaScript 中 Map 与 Object 在键类型支持机制与属性遍历顺序上的根本差异,结合底层原理、代码实例与选型指南,帮助开发者准确选择最适合的数据结构。
Object)和映射集合(Map)都是 JavaScript 中用于存储“键值对”的核心数据结构。对于刚接触这一区别的开发者而言,最常遇到的两个困惑是:为什么某些类型存进对象后被转成了相同键名?为什么遍历对象时属性打印出来的次序和声明时的顺序不一致?本文直接围绕键类型的支持机制与遍历输出的确定性规则展开深入剖析,并提供实用的架构选型指引。
一、键类型支持:强制字符串转换与引用保持
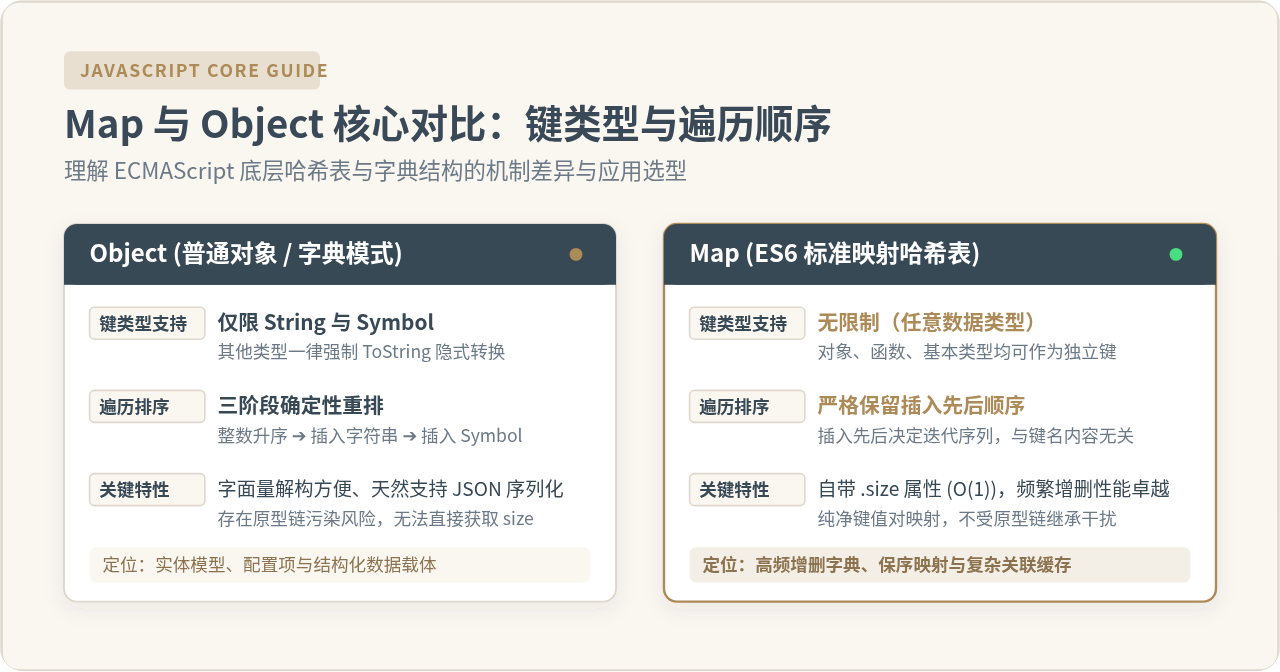
在 ES6 引入 Map 之前,Object 承担了所有字典与哈希表的职责。但 ECMAScript 规范对普通对象的键类型施加了强硬的限制:一个普通对象的属性键(Property Key)只能是字符串(String)或符号(Symbol)。当传入其他类型的参数时,JavaScript 引擎会悄然进行类型转换。
1. Object 的隐式 ToString 陷阱与键名冲突
当开发者使用方括号语法 obj[key] = value 给对象赋值时,如果 key 既不是字符串也不是 Symbol,引擎会在底层自动调用抽象操作 ToString(key) 将其塑形为字符串。这会导致两类常见的意外结果:
- 数字与字符串数字等价:数值
123与字符串'123'在对象中会被解析为完全相同的属性键。 - 复杂引用类型全部坍缩:无论是一个包含多层数据的复杂对象
{ id: 1 },还是空对象{},默认的toString()返回结果均为"[object Object]"。多次使用不同对象作为键,后存入的值会直接将前一个值覆盖。
const dataObj = {};

// 场景 1:数字与字符串键互相覆盖
dataObj[100] = '数值键';
dataObj['100'] = '字符串键';
console.log(dataObj[100]); // 示例输出: '字符串键'(后写入的字符串覆盖了数值)

// 场景 2:对象作为键的坍缩覆盖
const userA = { name: '张三' };
const userB = { name: '李四' };

dataObj[userA] = '张三的档案';
dataObj[userB] = '李四的档案';

console.log(Object.keys(dataObj));
// 示例输出: ['100', '[object Object]']
console.log(dataObj[userA]);
// 示例输出: '李四的档案'(由于 userA 和 userB 都转换成了 "[object Object]")
2. Map 的任意键支持与 SameValueZero 判定
与普通对象不同,Map 是真正的通用映射结构。它允许将任何 JavaScript 数据类型(包括基本类型、普通对象、数组、函数乃至 DOM 元素)直接用作键,且在存储过程中绝对不会触发强制类型转换。
在键的比对逻辑上,Map 内部采用 ECMAScript 的 SameValueZero 规范算法:
- 对于基本类型,严格校验类型与数值,例如数字
100与字符串'100'属于完全独立的两个槽位。 - 特殊值处理:在
SameValueZero规则下,NaN与NaN被视为相等,因此多次设置map.set(NaN, val)会指向同一个键;而+0与-0同样被视为完全相等。 - 对于引用类型(对象、函数、数组),比较的是内存地址引用,而非对象内部的属性内容。两个结构相同但内存地址不同的对象字面量,在
Map中是两个互不相干的独立键。
const map = new Map();

// 场景 1:数字与字符串明确隔离
map.set(100, '数值 100');
map.set('100', '字符串 100');

console.log(map.get(100));   // 示例输出: '数值 100'
console.log(map.get('100')); // 示例输出: '字符串 100'

// 场景 2:独立引用对象互不干扰
const clientA = { id: 1 };
const clientB = { id: 1 }; // 结构相同,但内存地址独立

map.set(clientA, 'VIP 客户数据');
map.set(clientB, '普通客户数据');

console.log(map.get(clientA)); // 示例输出: 'VIP 客户数据'
console.log(map.get(clientB)); // 示例输出: '普通客户数据'
console.log(map.size);         // 示例输出: 4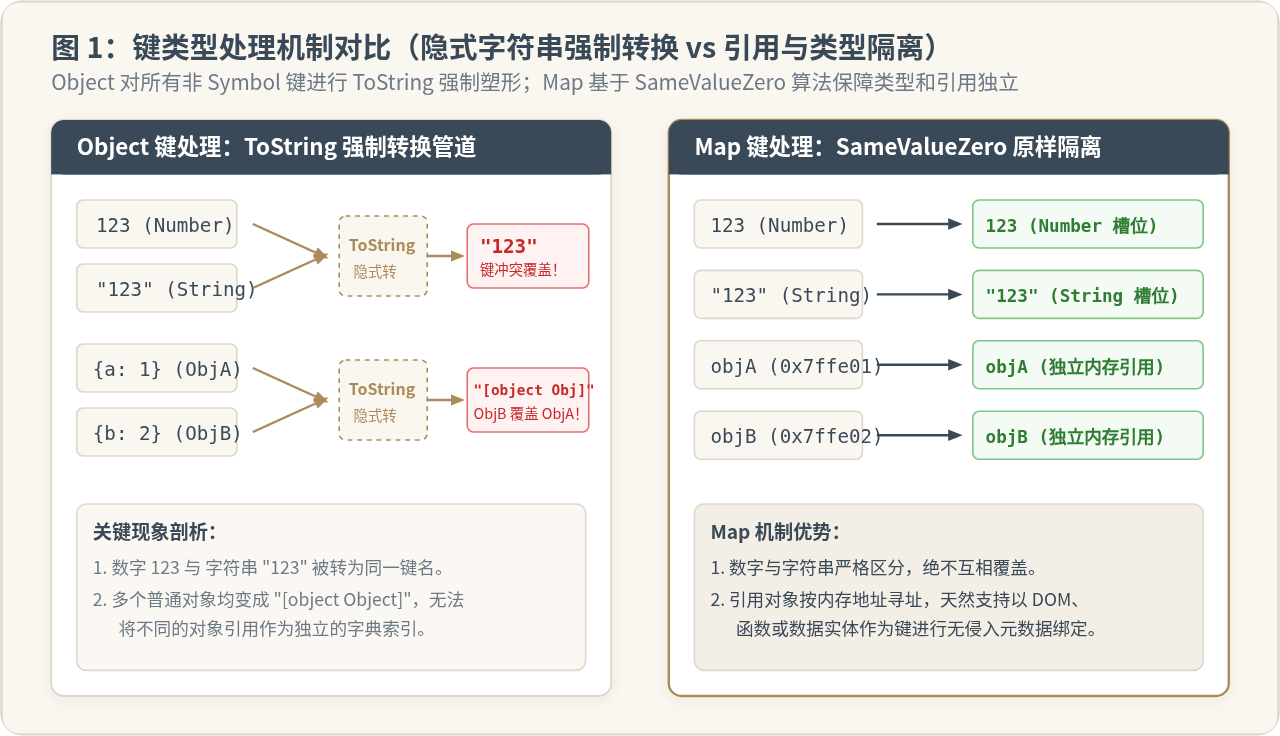
因为 Map 对引用类型依靠内存指针判断,所以如果执行 map.set({}, 'value'),后续通过 map.get({}) 是无法取到值的。因为两次声明的 {} 在堆内存中开辟了不同的空间,地址不一致。若要以对象作为键,必须保留该对象的引用变量。
二、遍历顺序规则:三阶段排序算法 vs 严格插入顺序
“JavaScript 遍历属性时是否保证顺序?”是前端工程中最容易引起 Bug 的问题之一。在 ECMAScript 2015 (ES6) 之前,规范并未硬性规定普通对象的属性遍历顺序,不同引擎行为各有差异。自 ES2015 起,规范在 OrdinaryOwnPropertyKeys 内部方法中对属性顺序做出了确定性定义;而 Map 则从设计之初就确立了纯粹的插入顺序。
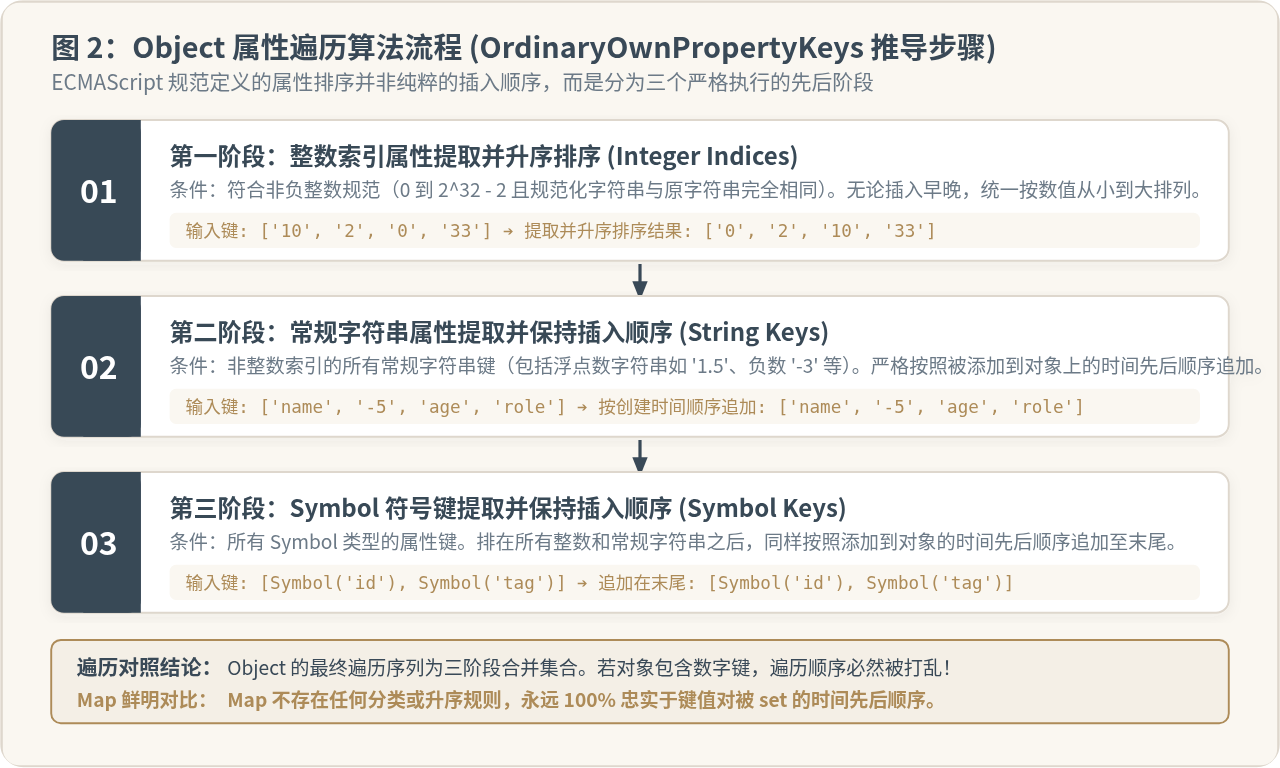
1. Object 的 OrdinaryOwnPropertyKeys 三阶段排序规范
当调用 Reflect.ownKeys(obj)、Object.keys(obj)、Object.entries(obj) 或执行 for...in 循环时,底层都会依循规范规定的算法对属性进行分类重排。该算法固定分为以下三个步骤:
- 第一阶段:非负整数索引升序排序
所有能被解析为 0 到 $2^{32} - 2$ 范围内的非负整数索引键,无论在代码中是先创建还是后创建,都会被优先提取并严格按照数值从小到大排序。 - 第二阶段:普通字符串键按插入时间追加
除去整数索引外的其余所有常规字符串属性(例如浮点数字符串"1.5"、负整数字符串"-2"、英文字符串等),按照它们被首次赋值到对象上的先后顺序依次追加。 - 第三阶段:Symbol 符号键按插入时间追加
所有 Symbol 类型的键排在最后,同样严格依据其被添加到对象上的先后顺序进行追加。
const mixedObj = {};

// 刻意打乱顺序存入不同类型的键
mixedObj['b'] = '字符串 b';
mixedObj[10] = '整数 10';
mixedObj['a'] = '字符串 a';
mixedObj[1] = '整数 1';
mixedObj['0'] = '整数 0';
mixedObj['-3'] = '非整数负数字符串';

const sym1 = Symbol('first');
mixedObj[sym1] = '符号键 1';

// 获取对象自身全部键名
console.log(Reflect.ownKeys(mixedObj));
// 示例输出:
// [
//   '0', '1', '10',          // 第一阶段:整数索引按升序排在前列
//   'b', 'a', '-3',          // 第二阶段:常规字符串按写入时间保序
//   Symbol(first)            // 第三阶段:Symbol 键排在末尾
// ]上述结果清楚地展示了:如果你在普通对象中存储了带有数字特性的键,遍历顺序必然会被数值大小强制打乱,绝不会按照你书写或插入的时间执行。这在实现诸如按时间戳排列的数据字典时,极易诱发隐蔽的数据展示错误。
2. Map 的严格插入顺序与链表维护机制
相比于对象的复杂三阶段排序,Map 的遍历表现极为直观、可预测:Map 内部维护着一条键值对双向链表,迭代时 100% 忠实于键值对加入集合的先后顺序(First-In-First-Iterated)。
无论是使用 for...of、map.keys()、map.values()、map.entries() 还是 map.forEach(),元素的遍历序列与其键名内容完全解耦,只取决于插入动作的时序。
const orderedMap = new Map();

// 同样按照与前面 Object 完全一致的乱序插入
orderedMap.set('b', '字符串 b');
orderedMap.set(10, '整数 10');
orderedMap.set('a', '字符串 a');
orderedMap.set(1, '整数 1');
orderedMap.set('0', '整数 0');

console.log(Array.from(orderedMap.keys()));
// 示例输出: ['b', 10, 'a', 1, '0'] (完全与插入顺序一致,没有任何数字升序重排)
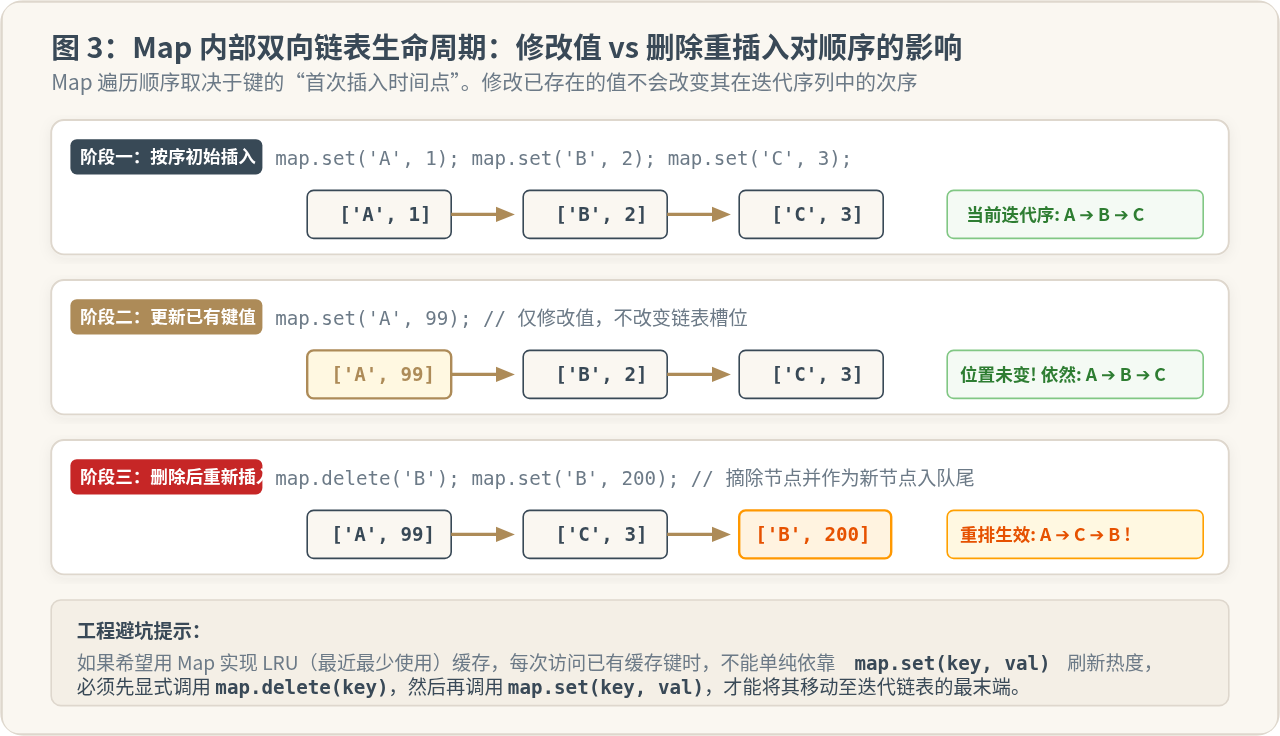
3. 状态更新 vs 删除重插入对顺序的影响
在长期运行的应用中,字典项经常面临修改和删除。这里有一个至关重要的机制区别:
- 更新已有键的值:调用
map.set(existingKey, newValue)时,底层仅仅是修改了该节点存储的值,其在迭代链表中的位置保持原位不动。 - 删除后重新插入:显式执行
map.delete(existingKey)会将该节点彻底从链表中摘除;后续如果再次调用map.set(existingKey, value),该节点会被作为一个全新的末尾节点追加到链表最尾端。
三、核心差异全景对比与技术选型
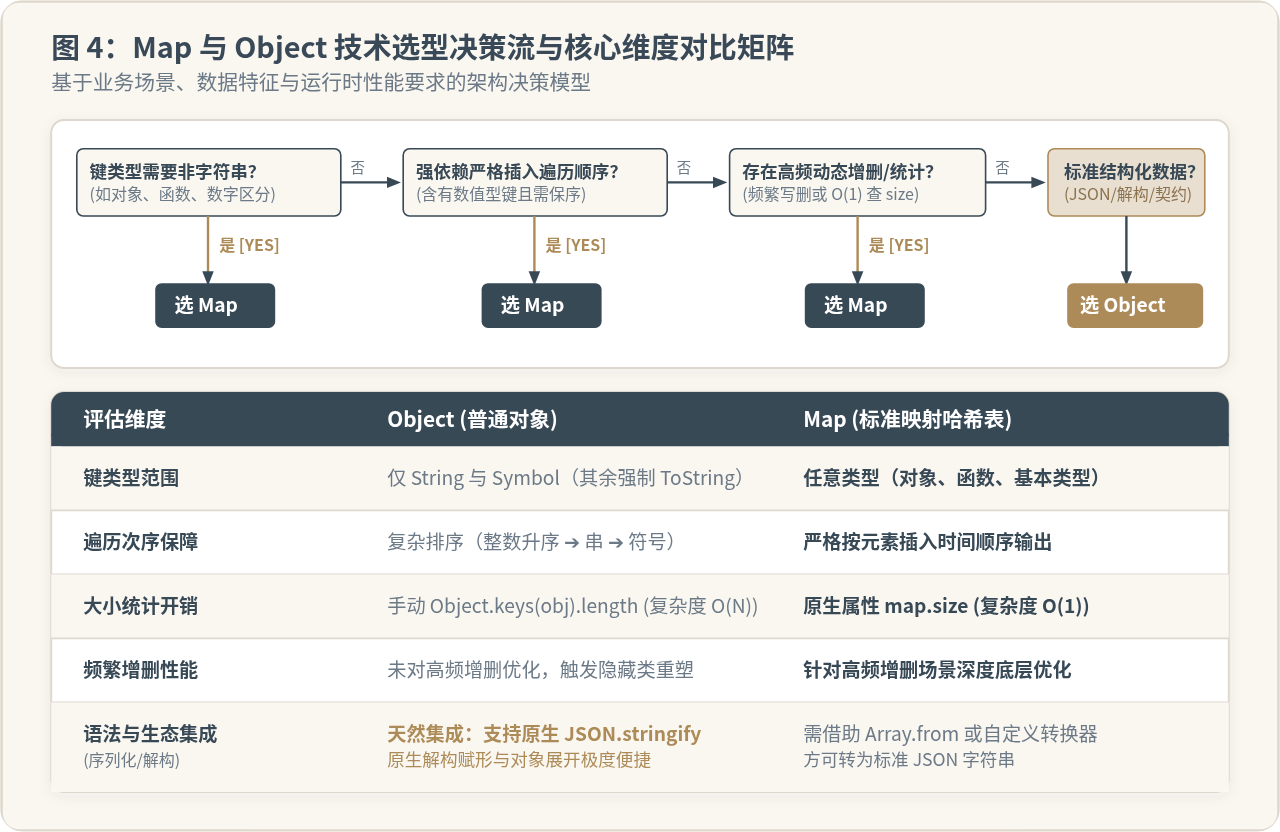
通过前面的解析可以看出,Map 与 Object 的定位差异并非“谁替代谁”,而是服务于不同的工程场景。理解以下几个关键维度的对比,有助于在系统设计中做出精准的技术抉择:
| 特性维度 | Object (普通对象) | Map (映射集合) |
|---|---|---|
| 键类型范围 | 仅限 String 与 Symbol(其他强制 ToString) | 任意类型(基本类型、对象引用、函数等) |
| 遍历次序 | 整数索引升序 ➔ 插入字符串 ➔ 插入 Symbol | 严格按照键值对插入的时间顺序 |
| 大小获取 | 需 Object.keys(obj).length 遍历计算 ($O(N)$) |
原生提供 map.size 属性访问 ($O(1)$) |
| 原型污染安全 | 默认继承 Object.prototype,有命名冲突风险 |
纯粹的键值映射,无任何默认继承属性 |
| 高频增删性能 | 非哈希表专用优化,高频增删易导致隐藏类变更 | 底层经过专用 Hash 散列优化,高频写入删除更高效 |
| 语法与生态支持 | 原生支持字面量定义、解构赋值与直接 JSON 序列化 | 需要通过 Array.from() 或自定义转换器序列化 |
四、实践建议与选型总结
在实际业务编码中,可以遵循以下明确的判断依据:
- 坚决选择 Map 的场景:
- 键名来自外部输入或可能包含纯整数字符串,且业务逻辑严重依赖遍历顺序(如按订单序号流水展示、分页队列)。
- 需要把复杂对象、组件实例或 DOM 节点作为键关联额外元数据(如缓存计算结果、事件订阅表)。
- 需要高频进行大量的增删改查操作,或者需要频繁读取字典中当前的记录总数。
- 优先选择 Object 的场景:
- 表示具有明确静态属性签名的业务实体(如用户信息模型
{ id, name, email }、配置字典)。 - 数据需要直接参与网络传输并使用
JSON.stringify()序列化为标准 JSON。 - 希望使用方便的解构语法(
const { a, b } = config)或属性展开运算符(...props)。
- 表示具有明确静态属性签名的业务实体(如用户信息模型
掌握了 Map 保持键类型原样与遵循插入顺序的特性,以及 Object 的隐式字符串转换与三阶段排序规则,开发者便能在数据结构选型时游刃有余,从源头上杜绝隐晦的属性覆盖与次序混乱 Bug。
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13
相关标签: