解决JavaScript下载文件时文件名乱码或无法自定义名称的问题
深入解析在JavaScript中通过a标签及接口流下载文件时文件名乱码、无法自定义重命名的底层原因,提供跨域Blob下载、RFC 5987响应头解析及UTF-8 BOM中文防乱码的完整解决方案。
在前端业务开发中,通过 JavaScript 实现文件导出或下载是一项基础且频繁的需求。然而很多开发者常会遇到两类典型异常:一是为 <a> 标签显式指定了 download="报表.xlsx" 属性,下载时浏览器却直接忽略该名称,仍然保存为服务端路径中的哈希字符或原始文件名;二是文件虽然正常保存,但中文名称却显示为 %E6%8A%A5%E8%A1%A8.xlsx 这样的 URL 编码串,或者出现类似 æ件、???? 的乱码字符。出现这些现象并非 JavaScript 本身存在缺陷,而是浏览器的跨域安全策略对下载属性的干预、HTTP 响应头规范解析差异,以及字符编码格式不一致共同导致的结果。解决该问题需要针对不同下载源分别建立标准的处理链路。
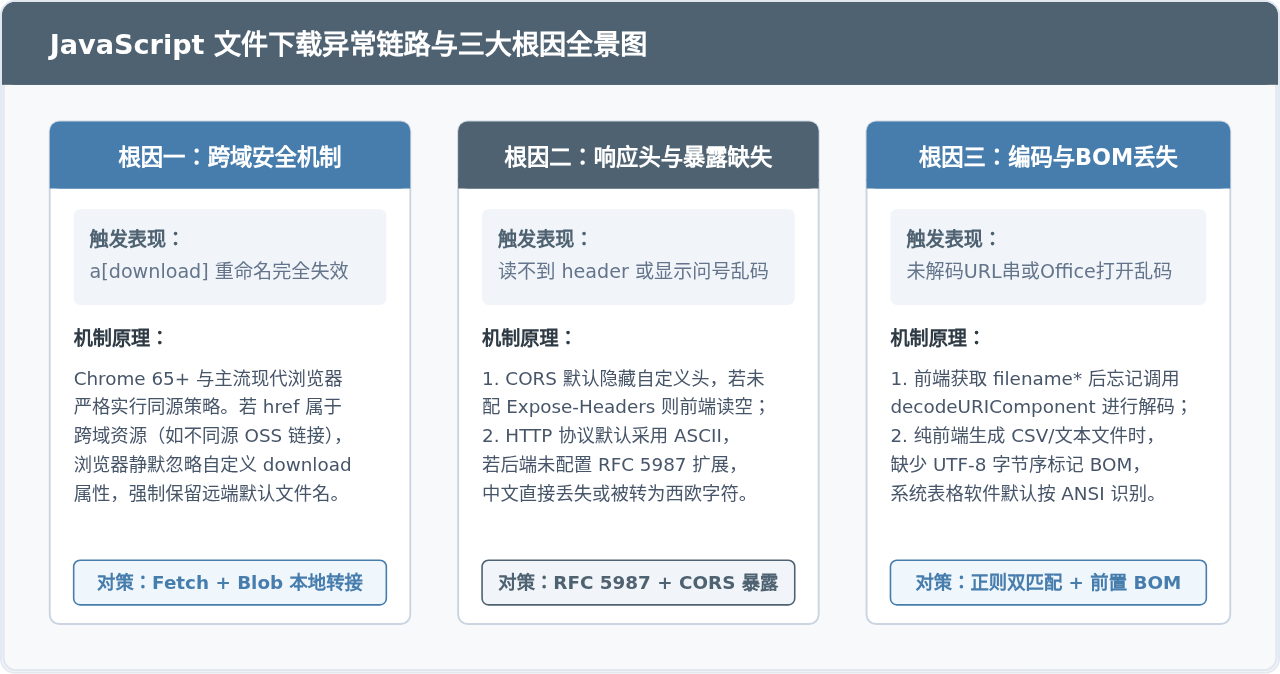
一、跨域静态文件下载:解决 a 标签 download 属性失效
在 HTML5 标准中,<a href="url" download="自定义名称.pdf"> 是实现文件下载最简捷的途径。然而很多开发者会发现:当 href 指向的是公司内网文件服务器、对象存储(如阿里云 OSS、腾讯云 COS、AWS S3)或第三方 CDN 等跨域地址时,设定的 download 属性会完全不起作用,浏览器下载弹出的文件名依然是远端链接末尾的文件标识符。
这是因为自 Chrome 65 起,主流现代浏览器(包括 Edge、Firefox、Safari)为了防范恶意钓鱼攻击(例如将危险跨域脚本伪装成安全文件名诱导用户点击下载),强制执行了同源策略限制。当目标 URL 与当前页面不同源时,浏览器会直接忽略 download 属性中的命名指令,直接沿用目标地址自身的原始名称。
解决方案:通过 Fetch 请求转换为同源 Blob 对象
破除同源限制的核心思路是:不让 <a> 标签直接导航至跨域外部链接,而是先在 JavaScript 中发起异步请求将文件数据读取为二进制 Blob,随后通过浏览器原生 API URL.createObjectURL() 生成一个与当前宿主页面同源的虚拟内存链接。此时再绑定 download 属性,浏览器即可安全地执行自定义命名:
/**
 * 下载跨域静态文件并强制重命名
 * @param {string} url 文件远端资源地址
 * @param {string} filename 期望保存的自定义文件名
 */
async function downloadRemoteFile(url, filename) {
  try {
    // 1. 发起请求获取二进制数据流
    const response = await fetch(url, {
      method: 'GET',
      mode: 'cors'
    });

    if (!response.ok) {
      throw new Error(`网络请求异常: ${response.status} ${response.statusText}`);
    }

    // 2. 将响应主体转换为 Blob
    const blob = await response.blob();

    // 3. 创建指向该 Blob 的同源临时对象 URL
    const objectUrl = window.URL.createObjectURL(blob);

    // 4. 动态构建不可见的 a 标签并触发点击
    const link = document.createElement('a');
    link.href = objectUrl;
    link.download = filename;
    link.style.display = 'none';
    document.body.appendChild(link);
    link.click();

    // 5. 移除节点并及时释放内存 URL
    document.body.removeChild(link);
    window.URL.revokeObjectURL(objectUrl);
  } catch (error) {
    console.error('文件下载失败:', error);
  }
}前置条件提醒:远端服务器或对象存储存储桶(Bucket)必须在后台配置 CORS 策略,允许当前站点的 Origin 发起 GET 请求。否则浏览器在 fetch 阶段就会被跨域拦截,控制台将提示 No 'Access-Control-Allow-Origin' header is present。
二、后端二进制接口:解决中文乱码与响应头读空
当调用后端导出接口(如通过 POST 或带鉴权 Token 的 GET 请求返回 Excel、PDF、ZIP 数据流)时,文件名通常是由后端根据业务参数动态决定的,并通过 HTTP 响应头 Content-Disposition 返回给客户端。在这个过程中,最常见两个问题:
- 前端在 Axios 或 Fetch 的响应拦截器中读取
response.headers['content-disposition'],结果为undefined。 - 拿到了响应头字符串,但中文文件名被 URL 编码为
%E6%B5%8B%E8%AF%95.xlsx,或者后端以旧编码输出导致中文字符变成乱码。
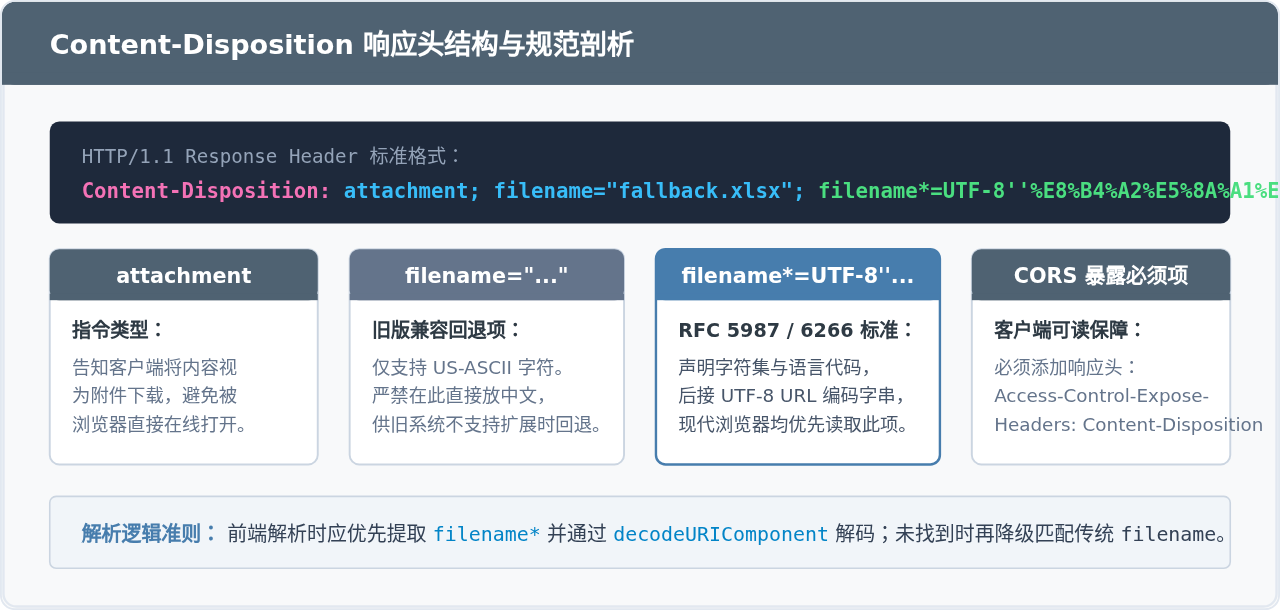
1. 解决 headers 读不到:服务端配置 CORS 暴露项
在 W3C 的 CORS 规范中,浏览器通过 XMLHttpRequest 或 Fetch 发起跨域请求时,默认只允许脚本读取 6 个基础安全响应头(Cache-Control、Content-Language、Content-Type、Expires、Last-Modified、Pragma)。若服务端未显式放行,Content-Disposition 即使真实存在于 HTTP 报文中,也会被浏览器屏蔽。
服务端需在响应拦截或网关(Nginx、Spring Boot、Express 等)中补充响应头:
// Nginx 示例
add_header 'Access-Control-Expose-Headers' 'Content-Disposition';

// Node.js (Express) 示例
res.setHeader('Access-Control-Expose-Headers', 'Content-Disposition');
2. 解决中文乱码:服务端采用 RFC 5987 编码规范
早期很多服务端直接向 filename 注入原生中文或 GBK 字符,由于 HTTP 头部默认基于 ASCII 规范传输,容易在网关或浏览器转换中变为不可逆的乱码。根据 RFC 5987 和 RFC 6266 标准,当文件名包含非 ASCII 字符(如中文)时,应采用 filename*=charset'lang'encoded-value 的格式:
// 服务端返回的标准响应头形式
Content-Disposition: attachment; filename="fallback.xlsx"; filename*=UTF-8''%E8%B4%A2%E5%8A%A1%E6%8A%A5%E8%A1%A8.xlsx
三、通用前端文件流下载与文件名解析实现
结合前述规范,前端在接收到服务端的响应后,必须执行一套严谨的解析逻辑:从响应头中优先提取 filename*,通过 decodeURIComponent 还原中文字符;如果不存在,则回退提取普通 filename;若均未提供,则采用默认备用名。整个处理过程严格按照以下流程执行:
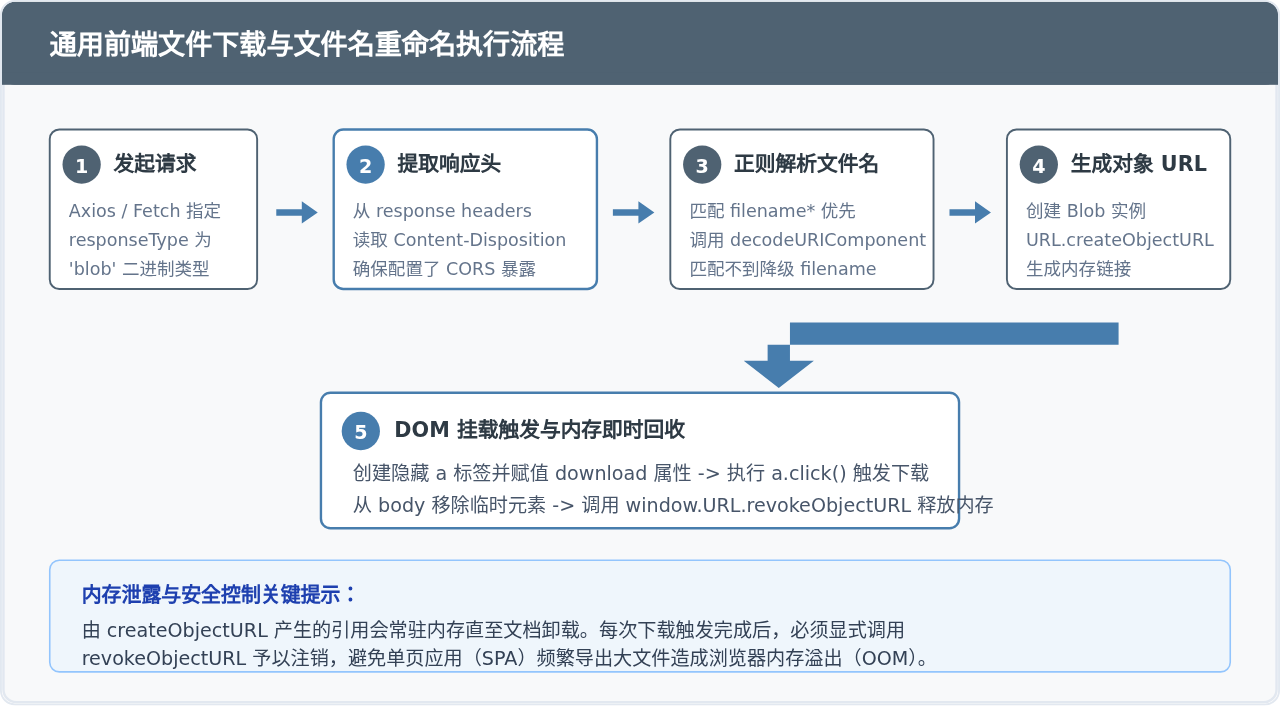
文件名解析与下载核心实现
/**
 * 从 Content-Disposition 响应头中安全提取文件名
 * @param {string} disposition 响应头字符串
 * @param {string} defaultName 默认回退文件名
 * @returns {string} 解析后的文件名
 */
function parseFilenameFromHeader(disposition, defaultName = 'download_file') {
  if (!disposition) return defaultName;

  // 1. 优先匹配 RFC 5987 / RFC 6266 标准的 filename*=UTF-8''xxx 格式
  const utf8FilenameRegex = /filename\*=UTF-8''([^;]+)/i;
  const utf8Matches = utf8FilenameRegex.exec(disposition);
  if (utf8Matches && utf8Matches[1]) {
    try {
      return decodeURIComponent(utf8Matches[1].trim());
    } catch (e) {
      console.warn('UTF-8 文件名解码失败,尝试降级匹配:', e);
    }
  }

  // 2. 降级匹配传统 filename="xxx" 或 filename=xxx
  const standardFilenameRegex = /filename=["']?([^"';]+)["']?/i;
  const standardMatches = standardFilenameRegex.exec(disposition);
  if (standardMatches && standardMatches[1]) {
    const rawName = standardMatches[1].trim();
    try {
      // 兼容部分服务端直接把 URL 编码后的字符串塞入传统 filename 的情况
      return decodeURIComponent(rawName);
    } catch {
      return rawName;
    }
  }

  return defaultName;
}

/**
 * 通用二进制流下载触发器
 * @param {Blob} blob 文件二进制对象
 * @param {string} filename 最终保存的文件名
 */
function triggerBlobDownload(blob, filename) {
  // 兼容 IE / 旧版 Edge 专属 API
  if (window.navigator && typeof window.navigator.msSaveOrOpenBlob === 'function') {
    window.navigator.msSaveOrOpenBlob(blob, filename);
    return;
  }

  const objectUrl = window.URL.createObjectURL(blob);
  const anchor = document.createElement('a');
  anchor.href = objectUrl;
  anchor.download = filename;
  anchor.style.display = 'none';

  document.body.appendChild(anchor);
  anchor.click();

  // 延迟清理 DOM 与内存链接,确保部分触发较慢的浏览器顺利接收
  setTimeout(() => {
    document.body.removeChild(anchor);
    window.URL.revokeObjectURL(objectUrl);
  }, 100);
}

/**
 * 业务层调用示例(以 Axios 为例)
 */
async function downloadReportApi() {
  try {
    const response = await axios.get('/api/export/financial-report', {
      responseType: 'blob' // 核心:明确声明响应为 Blob
    });

    // 读取响应头并解析
    const disposition = response.headers['content-disposition'];
    const fileName = parseFilenameFromHeader(disposition, '默认财务报表.xlsx');

    // 触发下载
    triggerBlobDownload(response.data, fileName);
  } catch (err) {
    console.error('报表导出失败:', err);
  }
}
四、纯前端生成导出(CSV / 文本):补齐 UTF-8 BOM 防乱码
除网络下载外,前端还经常直接使用 JavaScript 内存数据生成并导出 CSV 或 TXT 文件。很多开发者发现:导出的文件在记事本或 VS Code 中打开中文一切正常,但只要双击用 Windows 版 Microsoft Excel 打开,所有中文全部变成乱码。
这是因为 Excel 在 Windows 环境下,默认会按照系统本地区域的 ANSI 编码(如中文系统下的 GBK / GB2312)去解释文本文件。如果纯前端生成的 UTF-8 文件没有携带字节顺序标记(BOM,Byte Order Mark),Excel 就无法获知该文件属于 UTF-8 编码,进而产生乱码。
解决此问题的标准做法,是在构建 Blob 时向数组最前面压入 UTF-8 的 BOM 标识符 \uFEFF:
/**
 * 纯前端导出 CSV 文件并解决 Excel 中文乱码
 * @param {string} csvContent 拼装好的 CSV 文本内容
 * @param {string} filename 导出的文件名
 */
function exportCsvWithBom(csvContent, filename = '数据清单.csv') {
  // \uFEFF 是 UTF-8 的字节顺序标记 (BOM)
  // 加入 BOM 后,Excel 能够主动将其识别为 UTF-8 编码并正确渲染中文
  const blob = new Blob(['\uFEFF' + csvContent], {
    type: 'text/csv;charset=utf-8;'
  });

  triggerBlobDownload(blob, filename);
}

// 使用示例
const csvData = "姓名,部门,绩效\n张三,研发部,A\n李四,市场部,S";
exportCsvWithBom(csvData, "2026年年度绩效名单.csv");
五、全场景排查与决策速查
为了在实际排查问题时快速定位根因,下表和决策矩阵汇总了文件下载过程中常见异常对应的排查切入点与对应解决手段:
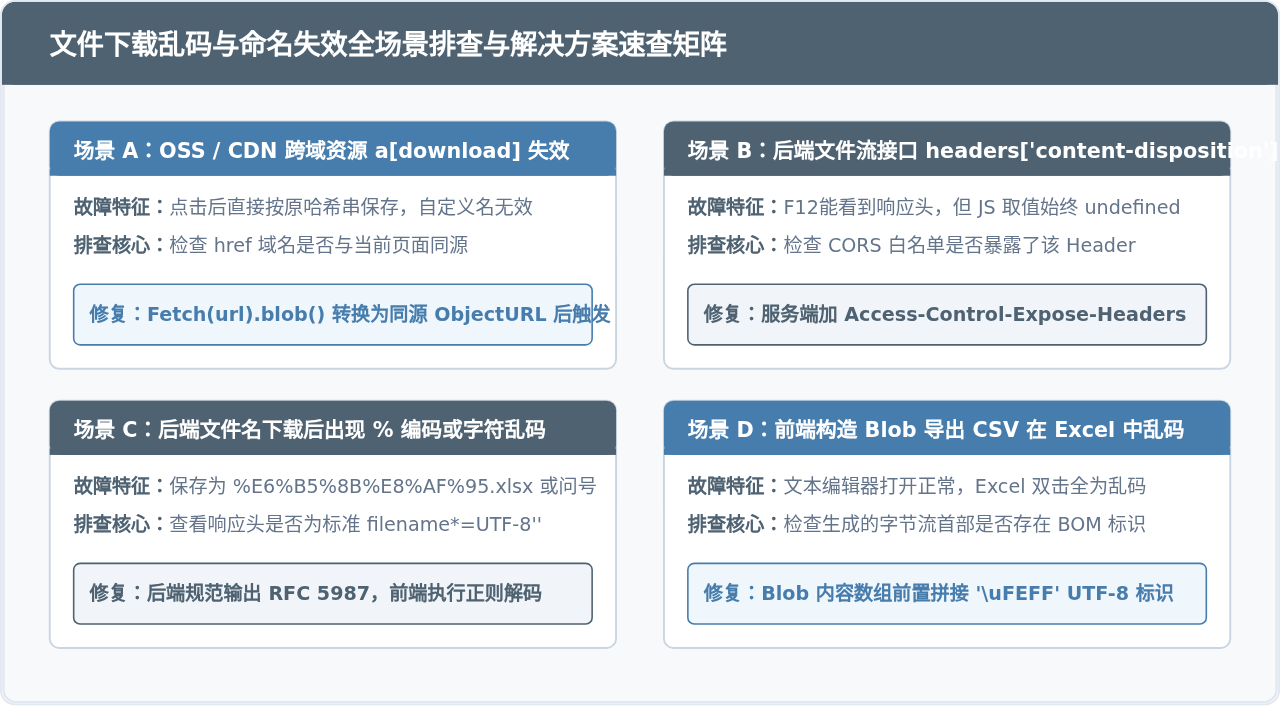
| 问题场景 | 典型表象 | 核心根因 | 标准解决对策 |
|---|---|---|---|
| 跨域静态文件下载 | <a download="xx"> 指定名称不生效 |
现代浏览器安全规范限制,禁止跨域链接自定义重命名 | fetch() 读取为 Blob,使用 URL.createObjectURL() 包装为同源链接后再触发 |
| 接口流文件名无法读取 | 前端打印 response.headers 为空 |
CORS 跨域安全机制默认不暴露自定义响应头 | 服务端在响应头中加入 Access-Control-Expose-Headers: Content-Disposition |
| 接口流文件名乱码 | 出现 %E4%B8... 或 æ件 |
服务端未按 RFC 5987 标准编码,或前端未做 decodeURIComponent |
服务端输出 filename*=UTF-8''...,前端正则提取后解码 |
| 前端导出 CSV 乱码 | Excel 打开中文显示乱码 | Excel 默认以 ANSI 编码解析无 BOM 的 UTF-8 文本 | 在 new Blob(['\uFEFF' + content]) 前置追加 UTF-8 BOM 字符 |
总结:解决 JavaScript 文件名乱码与重命名失效的问题,核心在于理清“同源策略”、“响应头编码协议”与“字符集标识”三者的边界。针对跨域 URL 走 Blob 内存中转,针对流式响应规范配置 RFC 5987 并暴露响应头,针对纯文本导出补齐 BOM 标记,即可彻底消除各类下载命名与中文乱码异常。
JS在setTimeout或Ajax回调中打开新标签页失败怎么处理
2026-11-05 15:50:12
JS直播协议选型:HLS、FLV与WebRTC的延迟与兼容性对比
2026-11-05 12:16:14
JS实现回到顶部:scrollTop赋值与浏览器兼容性处理
2026-11-04 23:43:35
JS使用classList动态添加、移除和切换CSS类名
2026-11-04 23:40:58
在 D3.js 中实现平滑过渡动画的技巧
2026-11-03 23:46:09