JS遍历DOM树:parentNode、children与nextSibling导航属性用法
全面解析JavaScript中遍历DOM树的核心导航属性,详细讲解parentNode、children与nextSibling的用法、运行机制、空白文本节点陷阱以及实战遍历算法。
在前端交互与组件开发中,定位与遍历DOM节点是高频的基础需求。相较于消耗选择器解析开销的 querySelector 系列方法,直接通过节点内置的导航指针(Node Navigation Properties)在DOM树中向上溯源、向下检索或横向平移,能够带来确定性的层级关系与极高的执行效率。本文将系统拆解 parentNode、children 与 nextSibling 这三个核心导航属性的具体机制、典型陷阱以及实际遍历实现。
一、DOM树的层级结构与核心导航属性
浏览器在解析HTML文档时,会将每一个标签、文本片段甚至注释都解析为内存中的节点(Node),并按嵌套关系组装成一棵倒挂的树状结构——DOM树。在这棵树上,每个节点都有三个主要的行进方向:向上找寻父级、向下访问子级、向旁侧寻访同级。
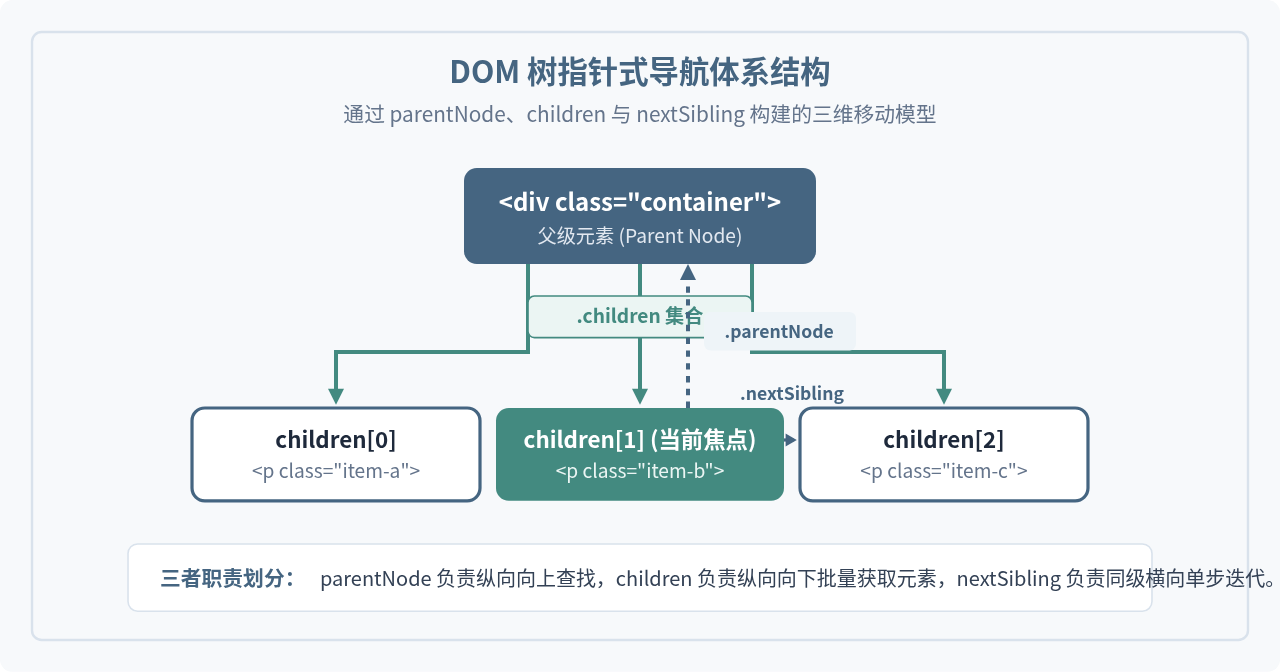
1. parentNode:向上溯源父节点
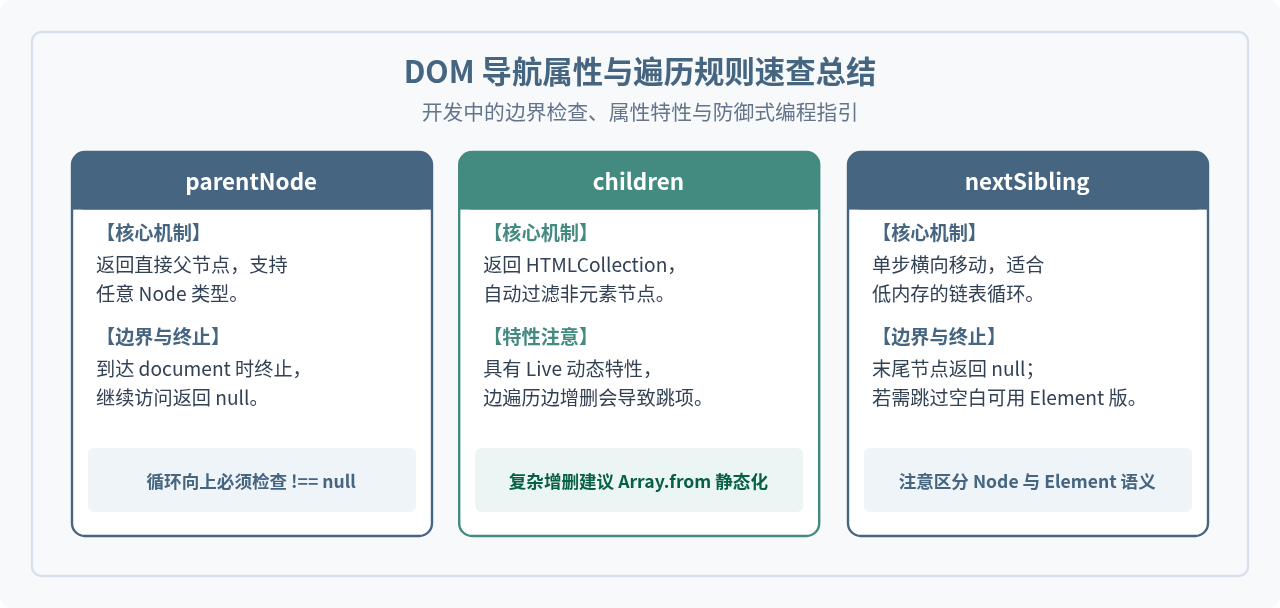
parentNode 属性返回当前节点的直接父节点。在标准的HTML树中,几乎所有被挂载的节点都有其父节点,其最顶层路径通常为:div → body → html → document。当抵达 document 节点后,其 parentNode 将返回 null。
const current = document.querySelector('.item-b');
const parent = current.parentNode; // 获取其父容器 div.container
console.log(parent.nodeName);     // 输出: DIV
2. children:向下获取子元素实时集合
children 是一个只读属性,返回当前节点所包含的所有元素子节点构成的 HTMLCollection 集合。特别需要注意两点:
- 只包含元素(Element):它会自动忽略文本换行、空格及注释节点。
- 动态集合(Live Collection):当后续向父节点添加或删除DOM元素时,该集合的内容和长度会自动更新,无需重新读取属性。
3. nextSibling:向后获取下一个同胞节点
nextSibling 返回当前节点在同一父节点下的紧邻后一个节点。如果当前节点已经是父节点的最后一个子节点,则返回 null。这个属性是实现线性链表式遍历的核心工具。
二、Node导航与Element导航的关键差异及空白节点陷阱
初学者在使用 nextSibling 时,最容易遭遇的困惑是“获取到了空内容”。这是因为在DOM规范中,节点被严格划分为“通配Node”与“纯标签Element”。
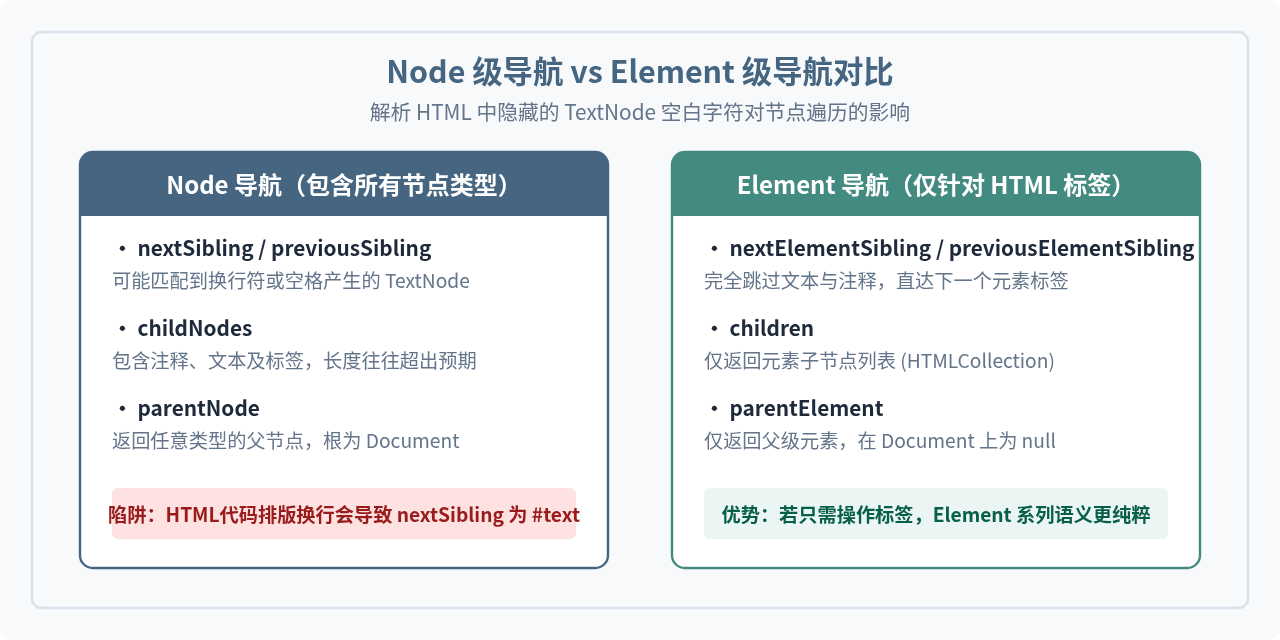
考虑以下HTML代码片段:
<ul id="menu">
  <li>首页</li>
  <li>产品</li>
</ul>
在 <ul> 与第一个 <li> 之间,以及两个 <li> 之间,存在代码排版的换行符和空格缩进。这些不可见字符会被浏览器解析为 nodeType === 3 的 Text 节点。因此:
- 第一个
<li>的nextSibling不是第二个<li>,而是一个内容为"\n "的文本节点。 - 若需要直接获取下一个标签元素,应使用
nextElementSibling,或者在遍历时对nodeType进行类型校验。
三、基于导航属性遍历DOM树的标准操作步骤
掌握了属性细节后,我们可以通过三种经典模式完成DOM树的不同遍历需求。
模式一:通过 children 遍历直接子元素
当只需要遍历某个容器内的直接子标签(例如列表项、菜单项)时,children 结合 for...of 或下标是最直观、最安全的方式:
function traverseChildren(parentElement) {
  // children 是 HTMLCollection,可直接使用下标或 for...of 遍历
  const items = parentElement.children;
  for (let i = 0; i < items.length; i++) {
    const el = items[i];
    console.log(`子元素序号 ${i}: <${el.tagName.toLowerCase()}>`);
  }
}
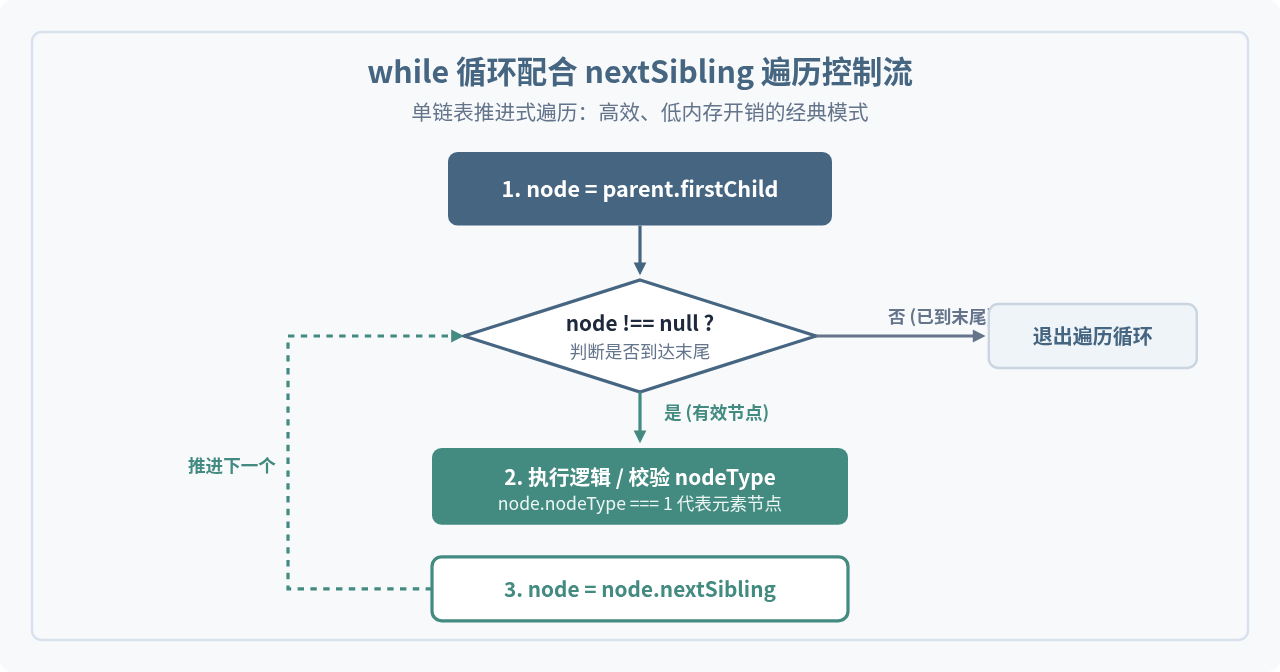
模式二:使用 while + nextSibling 进行链表遍历
如果需要遍历包含文本节点在内的所有底层子节点,或者编写底层轻量级解析引擎,链表式推进更加高效:
function traverseSiblings(parentElement) {
  let current = parentElement.firstChild;

  while (current !== null) {
    if (current.nodeType === Node.ELEMENT_NODE) {
      console.log('遇到元素标签:', current.tagName);
    } else if (current.nodeType === Node.TEXT_NODE) {
      const text = current.textContent.trim();
      if (text) {
        console.log('遇到有效文本:', text);
      }
    }
    // 指针横向推移
    current = current.nextSibling;
  }
}
模式三:深度优先遍历(DFS)全树递归
若要从根节点出发访问其下的每一个后代节点,可以将 children 与递归结合,或者使用 parentNode 向上回溯路径:
function walkTree(node, depth = 0) {
  if (!node) return;

  // 打印当前层级与标签名
  const indent = ' '.repeat(depth * 2);
  console.log(`${indent}<${node.tagName.toLowerCase()}>`);

  // 递归处理子元素
  const children = node.children;
  for (let i = 0; i < children.length; i++) {
    walkTree(children[i], depth + 1);
  }
}

// 向上反向回溯至根节点,生成面包屑路径
function getBreadcrumbs(node) {
  const path = [];
  let curr = node;
  while (curr && curr.nodeType === Node.ELEMENT_NODE) {
    path.unshift(curr.tagName.toLowerCase());
    curr = curr.parentNode;
  }
  return path.join(' > ');
}
四、DOM遍历的注意事项与常见边界问题
1. 动态集合与边遍历边修改的“漏项”问题
element.children 是一个实时响应DOM树变动的动态集合。如果在循环体内部调用了 removeChild 或改变了层级,集合的 length 和各子项索引会立即重排:
// 错误示例:因为索引变动,会导致只删除了奇数项
for (let i = 0; i < parent.children.length; i++) {
  parent.removeChild(parent.children[i]);
}

// 正确做法:转换为真数组或倒序删除
const staticChildren = Array.from(parent.children);
staticChildren.forEach(child => child.remove());
2. 防御性空指针判断
无论是使用 parentNode 向上回溯还是使用 nextSibling 向后推进,循环必须有确定的终止条件:
- 在根元素
html之外,document.parentNode为null; - 在最后一个子节点后,
nextSibling为null; - 当元素尚未被
appendChild挂载到主文档树时,其parentNode也为null。
总结
在实际工程开发中,理解 parentNode、children 和 nextSibling 是掌握DOM底层操作的必修课。总结其用法:向上追踪父级或祖先链时使用 parentNode;在确切知道只处理子标签、需要快速迭代时首选 children;而在需要低内存消耗、流式或包含底层文本处理的场景下,while + nextSibling 是最简洁高效的范式。
JS监听滚动事件:回到顶部按钮的显示与隐藏逻辑
2026-11-05 16:19:37
JavaScript怎么读写LocalStorage与SessionStorage
2026-11-05 15:40:11
anime.js 与 GSAP 对比:轻量级项目该怎么选择动画库
2026-11-05 11:24:55
flv.js 与 hls.js 在直播场景下的选型对比
2026-11-05 08:18:52
JavaScript能做什么?前端开发中的作用与应用场景解析
2026-11-04 23:17:54