

JS获取DOM元素:getElementById与querySelector的区别及使用场景
深入对比JavaScript中getElementById与querySelector的核心差异,涵盖语法规则、接收参数、返回值特性、性能表现及适用场景,帮助开发者准确选择最适合的DOM查找方案。
getElementById 专用于通过唯一的 ID 字符串获取单个元素,底层由浏览器 ID 索引直达,性能极高但限制较多;querySelector 则接收任意标准 CSS 选择器,支持类名、属性、后代组合及局部子树查询,表达力丰富但解析成本略高。在已知元素且具备明确 ID 时,优先使用 getElementById;在涉及复杂选择、父子限定或多条件筛选时,首选 querySelector。
一、两种方法的基本定义与调用语法
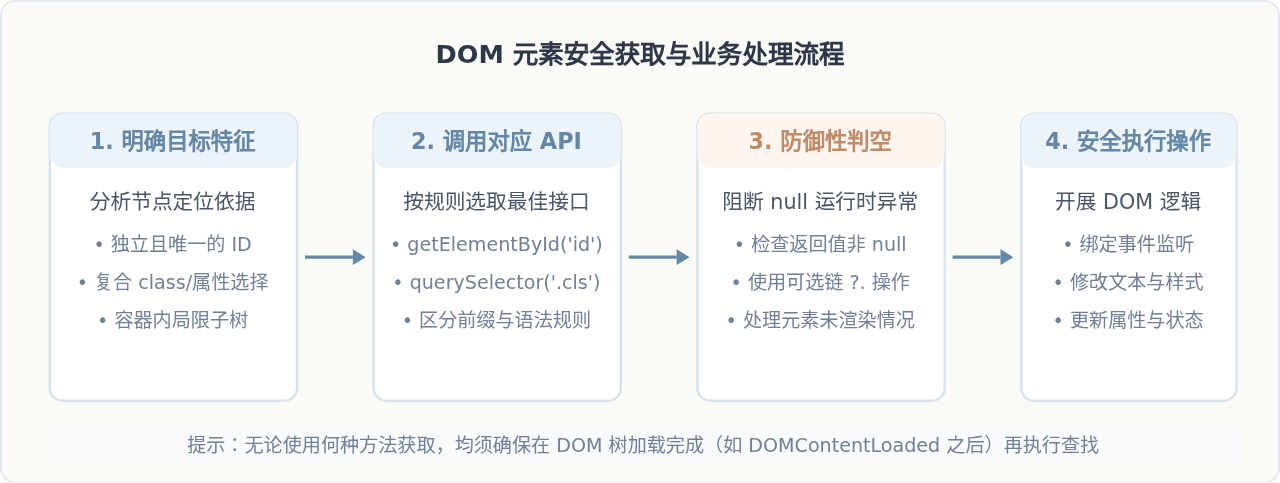
在前端交互开发中,操作界面的第一步几乎都是“找到目标节点”。现代浏览器为我们提供了多种节点查找接口,其中最经典的便是 getElementById 与 querySelector。
1. document.getElementById
getElementById 是 DOM 规范中历史悠久的传统 API。该方法属于 Document.prototype,仅能通过全局 document 对象发起调用。它接收一个纯文本格式的元素 ID(不需要加 # 前缀),并在当前文档树中寻找拥有该 id 属性的第一个节点。若找到则返回对应的 Element 对象,若未找到则返回 null。
// 示例:获取 id 为 "submit-btn" 的按钮
const submitBtn = document.getElementById('submit-btn');

if (submitBtn) {
  submitBtn.addEventListener('click', () => {
    console.log('按钮被点击');
  });
} else {
  console.warn('未找到指定ID的元素');
}
2. querySelector (及其批量形式 querySelectorAll)
querySelector 随着 Selectors API 规范引入,旨在将 CSS 选择器的强大匹配能力引入 JavaScript。与 getElementById 不同,querySelector 既可以由 document 调用,也可以由任意具体的 Element 节点调用。它接收一个或多个符合 CSS 语法规范的选择器字符串,返回文档或该节点子树中匹配指定选择器的第一个元素;若无匹配则返回 null。
// 示例1:通过类名与层级选择器获取第一个匹配元素
const primaryNav = document.querySelector('.header .nav-item.active');

// 示例2:在指定父容器内部缩小查找范围
const card = document.querySelector('#user-card');
if (card) {
  const userAvatar = card.querySelector('img.avatar');
  console.log('头像地址:', userAvatar?.src);
}
二、核心区别深入剖析
表面上看,两者都能返回一个 DOM 元素,但在入参要求、宿主对象、查找性能以及配套的批量集合机制上,存在本质的区别。
1. 接收参数与语法规则的差异
这是两者最直观的语法差异:
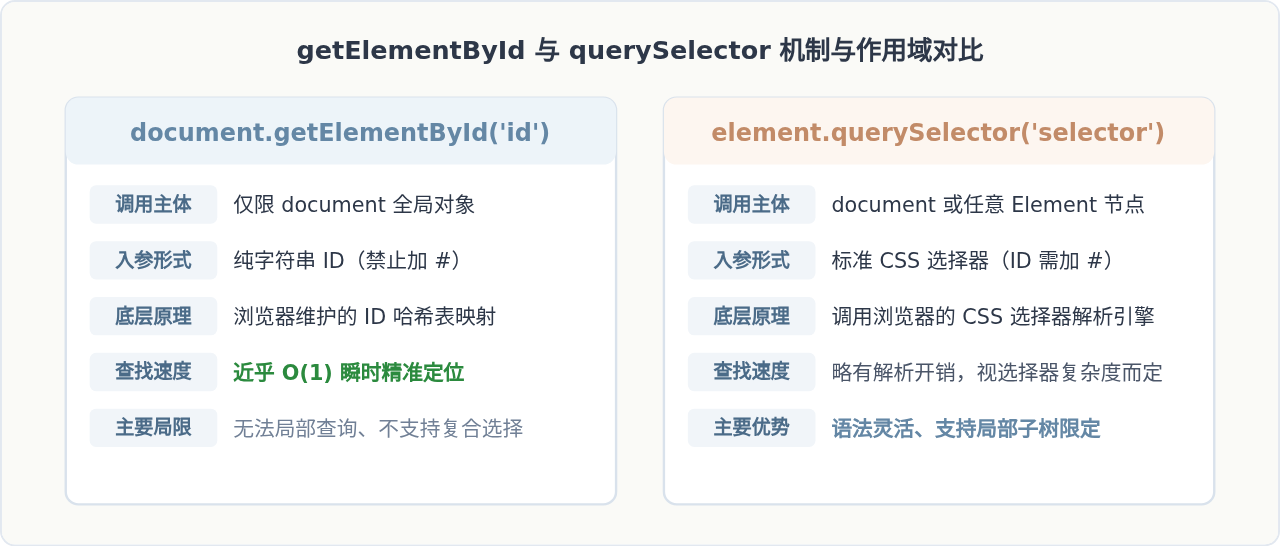
getElementById仅接受纯 ID 字符串:不能包含 CSS 的#符号。如果你写成了document.getElementById('#title'),引擎会尝试寻找id="#title"的元素,通常会直接返回null。querySelector接收合法的 CSS 选择器字符串:如果是通过 ID 查找,必须严格遵循 CSS 规范加上#前缀(如document.querySelector('#title'))。此外,它支持类选择器(.btn)、属性选择器([data-role="tab"])、复合关系选择器(ul.menu > li:first-child)等全套 CSS 选择器语法。
2. 调用主体与作用域范围的差异
查找范围决定了代码的解耦程度与局部查询能力:
getElementById仅存在于Document:你无法在一个普通的div元素上调用该方法(例如myDiv.getElementById('sub-item')会直接抛出TypeError: ... is not a function)。ID 在 HTML 规范中本应全局唯一,因此该方法设计为仅能从整个文档根节点开始全局检索。querySelector同时存在于Document和Element:这意味着你可以先定位一个外层容器,然后在该容器范围内调用container.querySelector('.item'),将查询范围严格限制在组件或子树内部,极大降低了命名冲突的风险。
3. 底层解析机制与执行性能
浏览器在解析和构建 DOM 树时,通常会维护一张全局的 id -> Element 映射表(类似于哈希表)。因此:
- 调用
getElementById时,浏览器只需对传入的字符串进行哈希索引查询,时间复杂度近似于O(1),无需执行任何复杂的树遍历或规则判定。 - 调用
querySelector('#id')时,虽然现代浏览器的渲染引擎对单纯的 ID 选择器做了特化短路优化,但它在真正执行查询前,依然需要通过 CSS 语法解析器对传入的字符串进行词法分词与语法验证。
在日常常规业务中,单次调用的微秒级差异对用户几乎是完全无感知的;但在需要频繁执行高频查询(如虚拟列表滚动渲染、密集画布/图表更新或大型循环内部),getElementById 带来的累积性能优势依然非常清晰。
4. 衍生对比:批量获取时的“动态集合”与“静态快照”
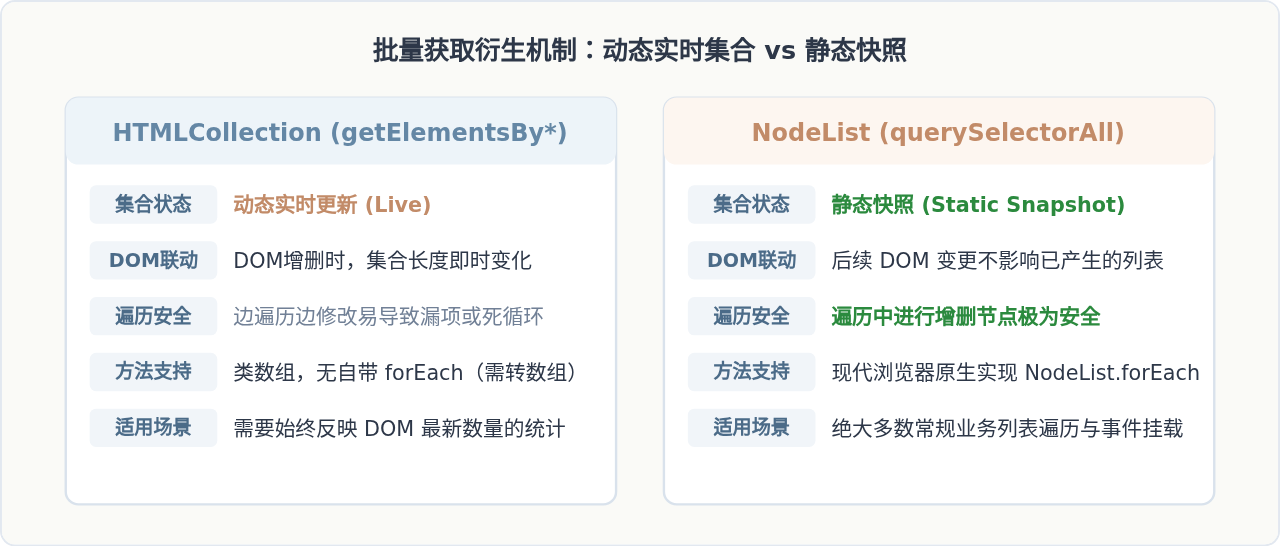
理解 getElementById 与 querySelector 的差异,必然延伸到它们的批量获取对应方法:以 getElementsByClassName / getElementsByTagName 为代表的经典方法,与现代的 querySelectorAll。
getElementsBy*系列方法返回的是一个 HTMLCollection(动态集合 / Live Collection)。当页面后续发生 DOM 增删时,该集合的内容会自动发生变动;在循环该集合的过程中若动态插入匹配节点,极易引发死循环。querySelectorAll返回的是一个 NodeList(静态快照 / Static NodeList)。它记录的是执行调用那一瞬间匹配到的元素集合。即使后续 DOM 树被删除或新增节点,已经返回的 NodeList 也不会有任何改变,且原生支持.forEach()迭代,在现代前端开发中逻辑更为稳健。
三、核心差异速查与使用场景选型
为了帮助你在实际业务中快速建立条件反射,以下整理了两者特性的关键维度对照表:
| 对比维度 | getElementById | querySelector |
|---|---|---|
| 支持调用方 | 仅 document |
document 及任意 Element 节点 |
| 入参要求 | 纯 ID 字符串(如 'app',不可带 #) |
合法 CSS 选择器(如 '#app'、'.list > li') |
| 查询匹配范围 | 整篇 HTML 文档 | 整篇文档或调用节点的子树分支 |
| 返回值类型 | 单个 Element 或 null |
首个匹配的 Element 或 null |
| 底层解析机制 | ID 哈希直达,查询复杂度约 O(1) |
CSS 选择器解析引擎分词匹配 |
| 对应批量获取方法 | getElementsByClassName / TagName (动态集合) |
querySelectorAll (静态 NodeList 快照) |
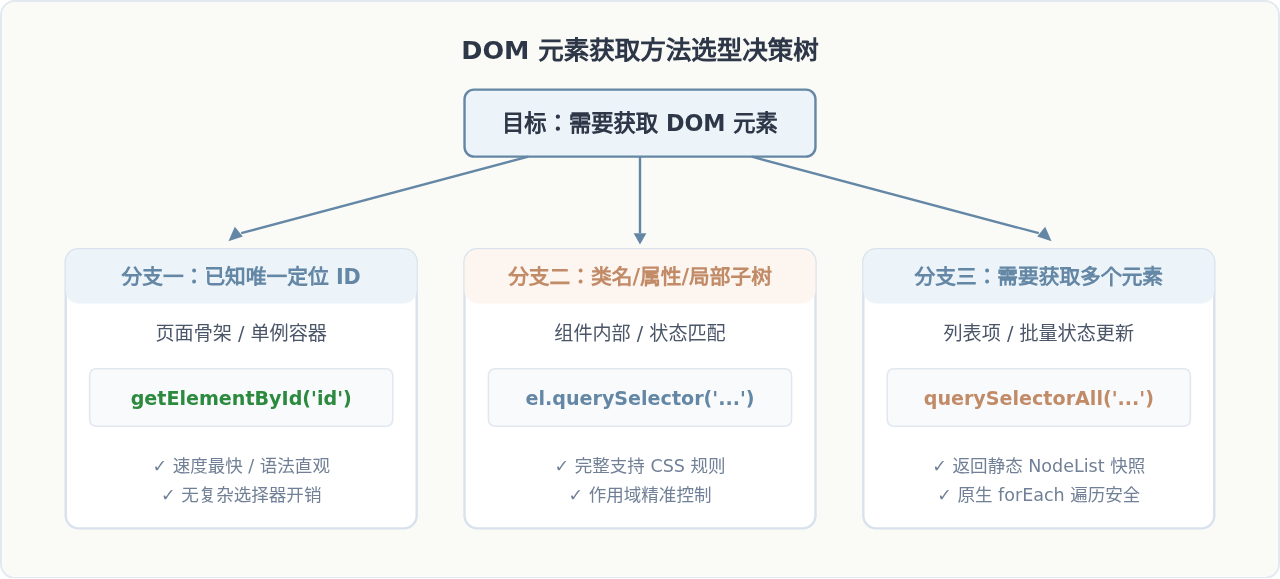
1. 优先选择 getElementById 的典型场景
- 全局唯一且语义明确的核心骨架节点:如单页应用(SPA)的根挂载点
document.getElementById('app')、全局模态框容器document.getElementById('modal-root')等。 - 对高频执行效率有苛刻要求的性能瓶颈环节:在密集动画、图表重绘或高频循环中,直接使用 ID 获取具有最好的确定性与最高的速度。
- 代码追求极致清晰与防止错写:只按 ID 查找时,
getElementById('box')比querySelector('#box')少了拼接选择器字符串的潜在错误,语义一目了然。
2. 优先选择 querySelector 的典型场景
- 组件化与模块化开发中的局部子树查找:在封装自定义组件或独立列表项时,需要限定在当前卡片内部查找元素,使用
cardElement.querySelector('.title')可以完美避免污染全局。 - 依赖类名、属性或复合状态的查找:如根据自定义数据属性匹配
document.querySelector('[data-user-id="1002"]'),或查找当前选中的单选框document.querySelector('input[name="gender"]:checked')。 - 需要精准匹配复杂的层级关系:如直接子代选择器
.container > .item:first-child,这是传统方法无法单次调用的。
四、常见开发误区与避坑建议
# 前缀初学者最常犯的错误之一是在
getElementById 中带上了 #,例如 document.getElementById('#user-name'),这会导致方法寻找 id="#user-name" 的元素而返回 null;反之,在 querySelector 中按 ID 查找时漏写了 #(如 querySelector('user-name')),则会被浏览器当作寻找 <user-name> 自定义标签。
将
<script> 标签直接放置在 HTML <head> 区域且未添加 defer 属性时,执行脚本时底部的 HTML 尚未解析,getElementById 与 querySelector 均会返回 null,紧随其后的属性访问便会触发臭名昭著的 TypeError: Cannot read properties of null。确保将脚本放置在 </body> 前,或通过监听 DOMContentLoaded 事件、添加 defer 确保 DOM 解析就绪。
虽然 HTML 语法要求
id 属性在全文档中必须唯一,但当页面因模板错误导致多个元素共用同一个 ID 时:getElementById 与 querySelector('#id') 通常只返回文档流中遇到的第一个匹配元素,其余重名元素将无法被直接访问。保证 ID 的唯一性是基础开发规范。
五、总结
getElementById 与 querySelector 并不是非此即彼的对立关系,而是各自面向不同需求维度的补充:
- 追求极端性能、定位顶层单例骨架时,选择简单纯粹的
getElementById; - 追求表达自由度、组件局部解耦以及复杂规则筛选时,拥抱能力全面的
querySelector。
在实际编码中,建立“全局单例用 getElementById,组件内部与复合规则用 querySelector”的直觉,能够兼顾运行性能与代码整洁度。
js-cookie 安装与基础用法:set、get、remove 详解
2026-11-05 16:35:06
适合JavaScript初学者的实战项目:制作简易待办事项列表
2026-11-05 16:17:07
JS打开新标签页时怎么通过URL传递参数
2026-11-05 12:21:08
sigma.js 自定义节点样式:设置颜色、大小及标签显示的技巧
2026-11-05 09:55:00
JS 生成的统计图怎么导出为 PNG 图片或 PDF 文件?
2026-11-05 09:37:58







