

ECMAScript英文规范阅读入门:理解JavaScript底层设计
面向前端开发者的ECMAScript英文规范阅读入门指南,系统解析规范的术语体系、算法表示法与查阅路径,帮助读者从根源理解JavaScript底层运行机制。
日常开发中遇到隐式转换边界、原型查找细节或执行上下文谜题时,二手技术博客的解读往往众说纷纭甚至存在偏差。阅读官方英文规范(ECMA-262)是终结语法争论、探究JavaScript语言底层设计的最可靠途径。本文旨在降低英文规范的技术阅读壁垒,直接剖析规范的架构体系、记号法约定、内部数据类型与算法伪代码组织形式,并通过典型场景演示如何顺藤摸瓜检索并读懂一条具体语言特性的权威定义。
一、规范的全景组织与分层体系
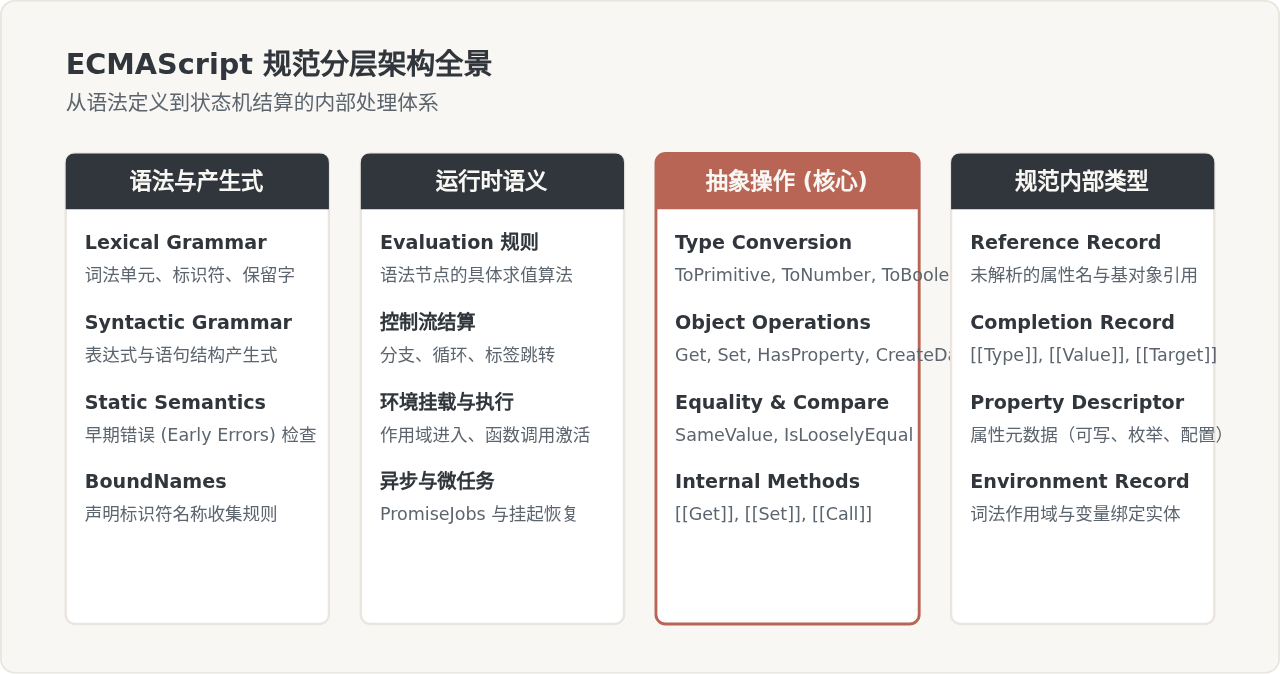
ECMA-262标准并非一份简单的API函数字典,而是一个严格的形式化状态机描述文档。整份规范将JavaScript抽象为一个由内存状态、作用域环境、类型体系以及算法指令构成的计算模型。阅读前首先需要明确规范内部的四个主要层级。
最表层是句法与文法(Syntax & Grammar),定义代码如何被词法分析与语法分析器接受;其次是运行时语义(Runtime Semantics),规定语法结构求值时触发的具体执行逻辑;中间层是海量的抽象操作(Abstract Operations),相当于规范作者编写的无歧义子程序;最底层则是规范内部类型(Specification Types)与执行上下文模型,用于维持引擎运算时的临时状态。
二、检索与定位规范章节的四步流程
初学者面对上千页的规范常常感到无从下手。最高效的查阅方式永远是“由具体代码表现驱动”,沿着语法推导线逐步深挖。以下四步法构成了查验任何JavaScript语言疑问的标准路径:
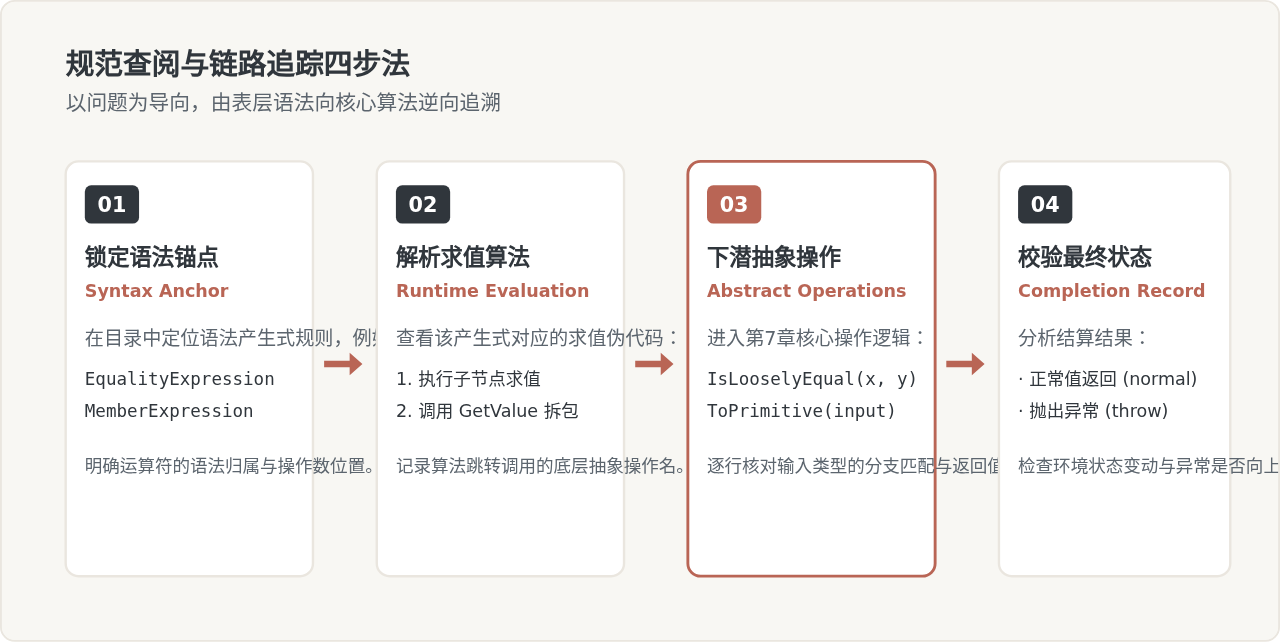
- 确定官方入口:访问最新快照草案
tc39.es/ecma262。草案集成了已进入Stage 4的最新提案,拥有完善的站内高亮与双向锚点跳转。 - 锁定语法产生式:遇到不理解的语法时(如
a?.b或for await (...)),先在左侧目录定位其Grammar定义。 - 拆解运行时算法:重点关注每个产生式下方的
Runtime Semantics: Evaluation。算法以有序步骤编号列出,遇到大写开头的操作(如ToNumeric、Call)直接点击跳转。 - 核对副作用与返回类型:观察每一步算法是否修改了内存记录(如设置内部插槽值),以及最终返回的是真实值还是控制流记录。
三、读懂规范的特殊记号与专有机制
规范中充斥着普通代码中不会见到的特殊数学符号与格式约定,理解这些符号是消除阅读阻力的关键。
1. 规范内部类型(Specification Types)
ECMAScript中的类型分为两类:一类是开发者熟知的ECMAScript语言类型(Undefined, Null, Boolean, String, Symbol, Number, BigInt, Object);另一类则是仅存在于规范算法内部、在JavaScript运行环境中无法直接打印的规范类型:
- Reference Record(引用记录):解析诸如
foo.bar或标识符x时生成的中间产物,包含[[Base]](基对象或词法环境)、[[ReferencedName]](属性名或变量名)与[[Strict]]标志。它解释了为什么delete foo.bar能够删除属性,以及(obj.method)()与(0, obj.method)()中this绑定的根本差异。 - Completion Record(完成记录):所有语句与算法步骤的通用包装器,格式为
(type, value, target)。type可以是normal、break、continue、return或throw。只有normal属于正常流程,其他均属于突然终止(Abrupt Completion)。 - Property Descriptor(属性描述符):用于精确描述对象属性特征的记录,包含
[[Value]]、[[Writable]]、[[Get]]、[[Set]]、[[Enumerable]]、[[Configurable]]。
2. 双中括号记号([[...]])
双中括号表示引擎实体的不可直接遍历属性,主要分为两类:
- 内部插槽(Internal Slots):相当于引擎内部的数据字段。例如
[[Prototype]]存储原型引用,[[Extensible]]标识对象是否可扩展,[[PromiseState]]记录Promise的状态。 - 内部方法(Internal Methods):规范定义的多态函数接口。例如普通对象与Proxy对象都实现
[[Get]]、[[Set]]、[[Call]],但Proxy重写了这些内部方法的算法,从而实现拦截。
3. 前缀速记符:?(ReturnIfAbrupt)与 !
现代规范大量使用 ? 和 ! 简化异常处理伪代码:
? OperationName(...):等价于“执行该操作;如果返回结果是突然终止(如抛出异常),则立即向外层调用栈返回该突然终止;否则解包该Completion Record,获取其正常值并继续”。! OperationName(...):断言该操作绝不可能返回突然终止(例如已知传入参数类型合法),要求引擎直接解包获取其值,无需生成错误处理分支。
四、原理深入:属性读取(obj.prop)的底层抽象操作流转
以最简单的对象属性访问 obj.prop 为例,很多开发者直觉上认为就是“去哈希表找key”。但规范从语法解析到最终取出数据,经历了严密的抽象操作流转:
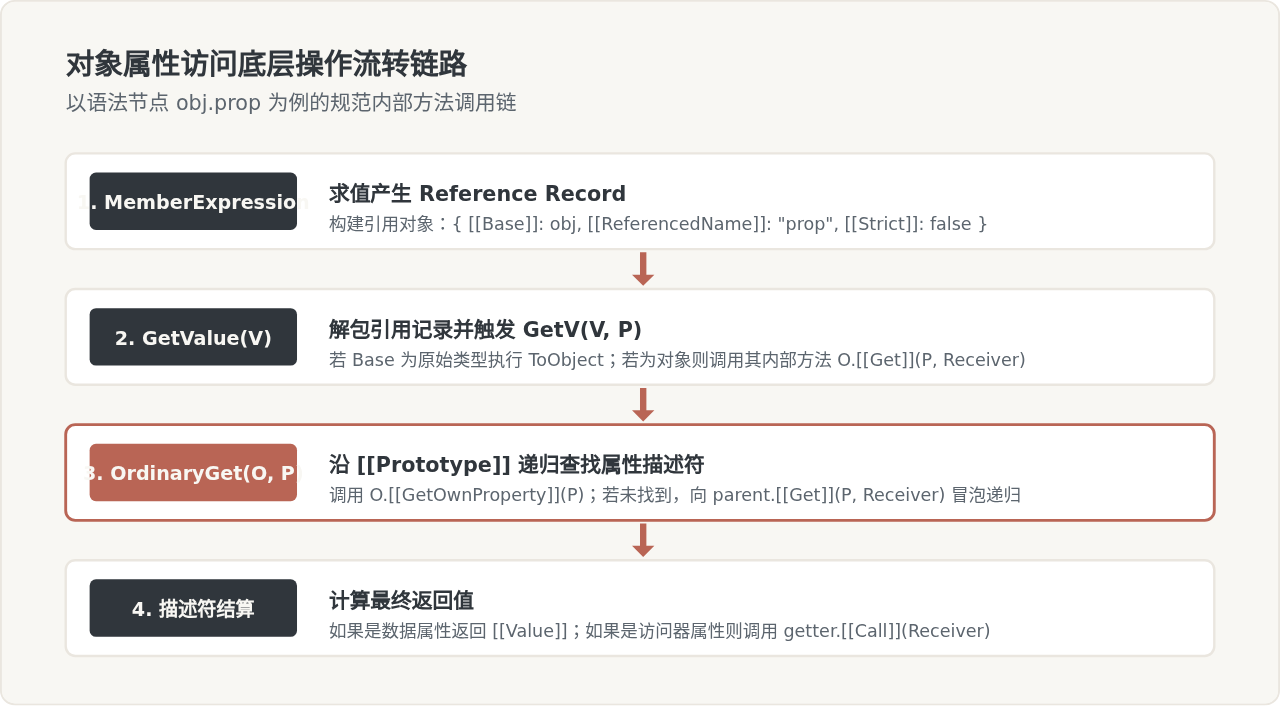
这个流转链条清晰解释了许多高级语义:为什么给 getter 函数内部传递的 this 是 Receiver(即发起调用的最初对象,而不是原型链上定义 getter 的那个对象)。因为在第2步中,Receiver 被原封不动地传给了 OrdinaryGet,并在最后一步绑定给了 getter 的 [[Call]]。
五、实战演练:用规范算法推导经典疑难
我们通过两个经常被面试讨论的“反直觉”语法现象,完整演示如何用规范算法进行客观推导。
案例一:推导 [] == ![] 为何结果是 true
面对 [] == ![],不要凭感觉猜测,我们严格对照规范的算法步骤:
- 解析运算符优先级:一元逻辑非运算符
!的优先级高于宽松相等比较运算符==。因此首先计算表达式右侧的![]。 - 计算
![]:查阅UnaryExpression : ! UnaryExpression的求值算法:- 对
[]调用抽象操作ToBoolean([])。 - 查阅
ToBoolean表格:任何属于Object类型的输入,结果一律为true。空数组是对象,故结果为true。 - 逻辑非取反,右侧表达式求值结果确定为布尔值
false。原表达式演变为[] == false。
- 对
- 计算
[] == false:查阅抽象操作IsLooselyEqual(x, y)(宽松相等比较):- 步骤:“If Type(y) is Boolean, return the result of the comparison ! IsLooselyEqual(x, ! ToNumber(y))”。
- 将
false传入ToNumber(false),得到数字0。表达式演变为[] == 0。
- 计算
[] == 0:继续对照IsLooselyEqual规则:- 步骤:“If Type(x) is Object and Type(y) is Number, return ! IsLooselyEqual(! ToPrimitive(x), y)”。
- 对
[]调用ToPrimitive([])。 ToPrimitive默认偏向为default(对象默认为number策略,但普通对象转为调用OrdinaryToPrimitive(hint: "number"))。- 该操作优先尝试
valueOf(),数组返回自身非原始值;进而调用toString(),空数组的toString()返回空字符串""。 - 表达式演变为
"" == 0。
- 计算
"" == 0:再次触发IsLooselyEqual:- 步骤:“If Type(x) is String and Type(y) is Number, return ! IsLooselyEqual(! ToNumber(x), y)”。
ToNumber("")转换空字符串,依据字符解析规范得到数字0。- 最终比较
0 == 0,数值严格相等,返回true。
案例二:用规范理解 let/const 的暂存死区(TDZ)
很多资料简单解释“let 没有变量提升”,但在规范中,作用域与变量创建被明确拆分为两个阶段:
// 规范算法:BlockDeclarationInstantiation
1. For each element d of declarations, do:
   a. For each String dn of the BoundNames of d, do:
      i. If IsConstantDeclaration of d is true, then:
         1. Perform ? env.CreateImmutableBinding(dn, true).
      ii. Else:
         1. Perform ? env.CreateMutableBinding(dn, false).
在进入块级作用域时,引擎会遍历块内所有声明,并在环境记录中调用 CreateMutableBinding 预先创建绑定名称。但请注意:此时该绑定尚未被初始化(uninitialized)。
当执行流到达赋值语句 let x = 10; 时,才触发 InitializeBinding(dn, value)。如果在初始化之前试图通过 GetBindingValue 读取该绑定,规范明确规定:
"If the binding for N in envRec is an uninitialized binding, throw a ReferenceError exception."
这正是“暂存死区”的真实物理面貌:绑定在作用域顶部已被创建,但处于未初始化标记状态;只有执行到达声明处后才解禁访问。
六、高效阅读心智模型与避坑建议
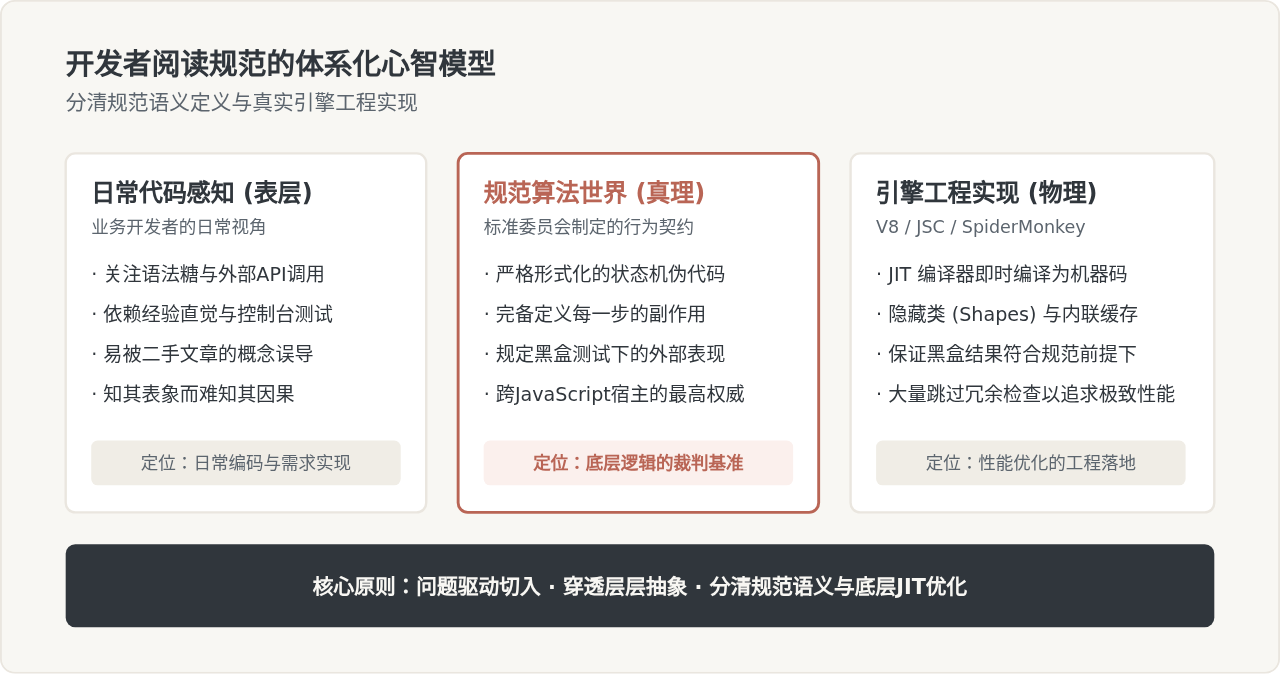
掌握阅读规范的能力后,还需建立正确的工程心智模型,避免走向极端:
阅读规范的三大禁忌与应对策略
- 禁忌一:试图从第一页从头通读到末页。ECMA-262是参考手册而非线性叙述教科书。直接通读会迅速淹没在繁重的类型声明与边界校验细节中。正确做法是将其作为“代码疑难的终极解答工具”,由具体问题引导跳读。
- 禁忌二:把规范算法等同于C++源码实现。规范描述的是“外部可观察行为(Observable Behaviors)”的等价模型。现代引擎(如V8)通过隐藏类(Hidden Classes)、内联缓存(Inline Caching)和TurboFan优化编译器执行属性访问,在绝大多数热点路径中根本不需要像规范伪代码那样逐级递归遍历原型链。只要最终运算结果与规范完全一致,引擎在内部可以采用任何优化的数据结构。
- 禁忌三:忽略控制流中突然终止的传递。阅读抽象算法时,务必关注每一步开头的
?符号。很多初学者只看主干计算,忽略了在第一步计算操作数时若抛出异常,整个算法会立刻提前终止并冒泡异常,后续步骤根本不会执行。
总结
ECMAScript英文规范不仅是消除歧义的权威裁判,更是一座展示现代编程语言如何严密定义类型系统与运行环境的宝库。掌握规范的查阅路径与算法记号法后,原本晦涩的英文条目将转化为清晰明了的伪代码逻辑。当开发者遇到任何框架或语言层面的“奇异现象”时,不再需要依赖道听途说的解释,只需打开规范追根溯源,即可直接看清JavaScript在语言设计上的真实面貌。
JS语法错误会阻止加载吗?区分SyntaxError与资源加载失败
2026-11-05 16:08:46
JavaScript常见SyntaxError语法错误排查与修复方法
2026-11-05 13:58:44
JS中slice、substring和substr截取字符串的区别
2026-11-05 13:43:47
JS 转 TS 手动迁移最佳实践:从配置 tsconfig 到消除 any 类型
2026-11-05 11:53:32
为什么JS数组push后得到的是数字而不是数组?
2026-11-05 09:59:18







