

JS基本数据类型与引用类型的区别:栈内存与堆内存解析
深入解析JavaScript基本数据类型与引用类型的本质区别,详细剖析调用栈与堆内存的存储机制、变量复制流转、全等判断与内存回收策略。
JavaScript 中基本数据类型与引用类型的核心区别,本质上取决于底层运行时的数据存储位置与内存访问机制。基本类型拥有固定大小,由调用栈(Stack)直接存取具体数值;引用类型的数据结构具有动态可变性,其实体存储于堆内存(Heap)中,而栈内存仅保留指向该实体的引用地址。清晰理解栈与堆的分工,是解决变量赋值同步变化、深浅拷贝、函数传参与内存优化等疑难问题的基础。
一、JavaScript 两大分类与数据类型全貌
在 ECMAScript 规范中,语言内置的所有数据都可以被划分为两类:原始类型(Primitive Type,亦称基本数据类型)和对象类型(Reference Type,亦称引用数据类型)。
- 基本数据类型(7种):
Number、String、Boolean、Undefined、Null、Symbol、BigInt。它们的值在底层被视为不可变原始值(Immutable),占据固定大小的内存空间。 - 引用数据类型:
Object(包括衍生出的Array、Function、Date、RegExp、Map、Set等)。引用类型是属性和方法的集合,属性可随时增删改动,体积可动态伸缩。
二、栈内存(Stack)与堆内存(Heap)的运行机制
JavaScript 代码在 V8 等引擎中执行时,需要依靠不同的内存区域协同工作。栈内存与堆内存并不是随意的概念划分,而是操作系统与 JavaScript 虚拟机为平衡访问性能与容量灵活性而设立的两种物理组织形式:
- 栈内存(Stack):主要由代码执行上下文栈构成。空间连续、读取速度极快,遵循先进后出(LIFO)的规则。栈内存要求存储在其内部的数据必须占用确定大小的连续字节。当一个函数调用结束、执行上下文弹出销毁时,栈内分配的局部变量随之自动出栈释放。
- 堆内存(Heap):用于分配无序的、大小不固定的复杂数据。堆空间庞大,依靠散列和动态指针分配内存,但分配和寻址的开销相对栈内存更高。堆中的对象不能自动弹出,必须依靠垃圾回收器(Garbage Collector)周期性判定其存活状态后予以回收。
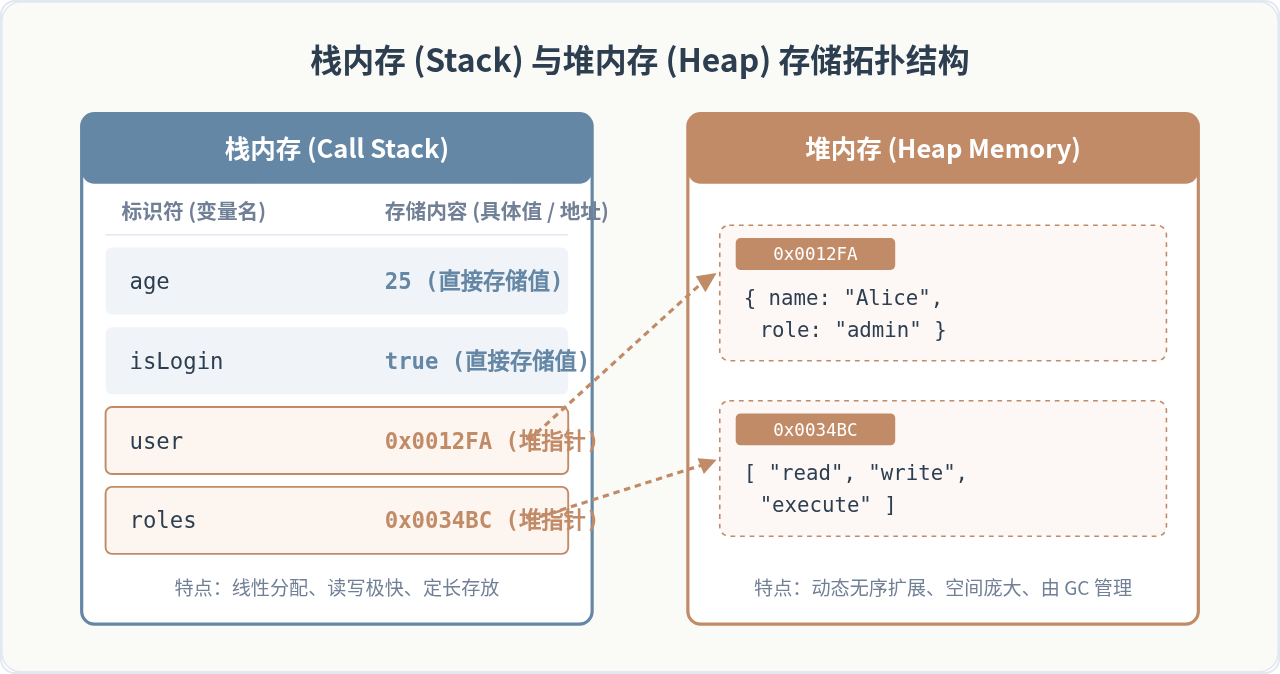
从图 1 可以直观看到,当代码中声明 let user = { name: "Alice", role: "admin" } 时:
- JavaScript 引擎在堆内存中动态申请一块能容纳该对象的物理空间,并生成唯一的内存起始地址(如
0x0012FA)。 - 在当前的栈执行上下文中压入变量名
user,但其对应槽位存储的并不是对象本身,而是该十六进制内存地址。 - 代码后续访问
user.name时,执行引擎必须先读取栈内的地址指针,顺着指针去堆内存寻址,再提取属性值。这种访问方式被称为按引用访问。
三、变量赋值与传参的内存推导过程
变量在赋值、传值与修改时的行为差异,完全由其在栈中存入的内容决定。
1. 基本类型的按值复制(Pass by Value)
当把一个基本类型变量赋值给另一个变量时,系统会在栈内存中开辟一块全新的物理槽位,并将原变量槽位中的具体数值完整克隆一份写入新槽位。两个变量在栈中完全独立,后续对其中任何一个变量的重新赋值或修改,绝不会波及另一个。
let a = 10;
let b = a;  // 栈中新建槽位 b,复制值 10
b = 20;     // 只改写槽位 b 的值

console.log(a); // 10 (完全不受影响)
console.log(b); // 20
2. 引用类型的按引用复制(Pass by Reference / Sharing)
当把一个引用类型变量赋值给另一个新变量时,栈内存同样会为新变量开辟一个槽位,但复制的并不是堆中的具体对象,而是堆内存地址指针。此时,两个变量的栈槽位存储着一模一样的内存地址,共同指向堆中的同一块物理对象空间。
let obj1 = { count: 1 };
let obj2 = obj1; // 仅复制了地址指针

obj2.count = 2; // 沿指针修改了堆中同一个对象

console.log(obj1.count); // 2 (被同步改变!)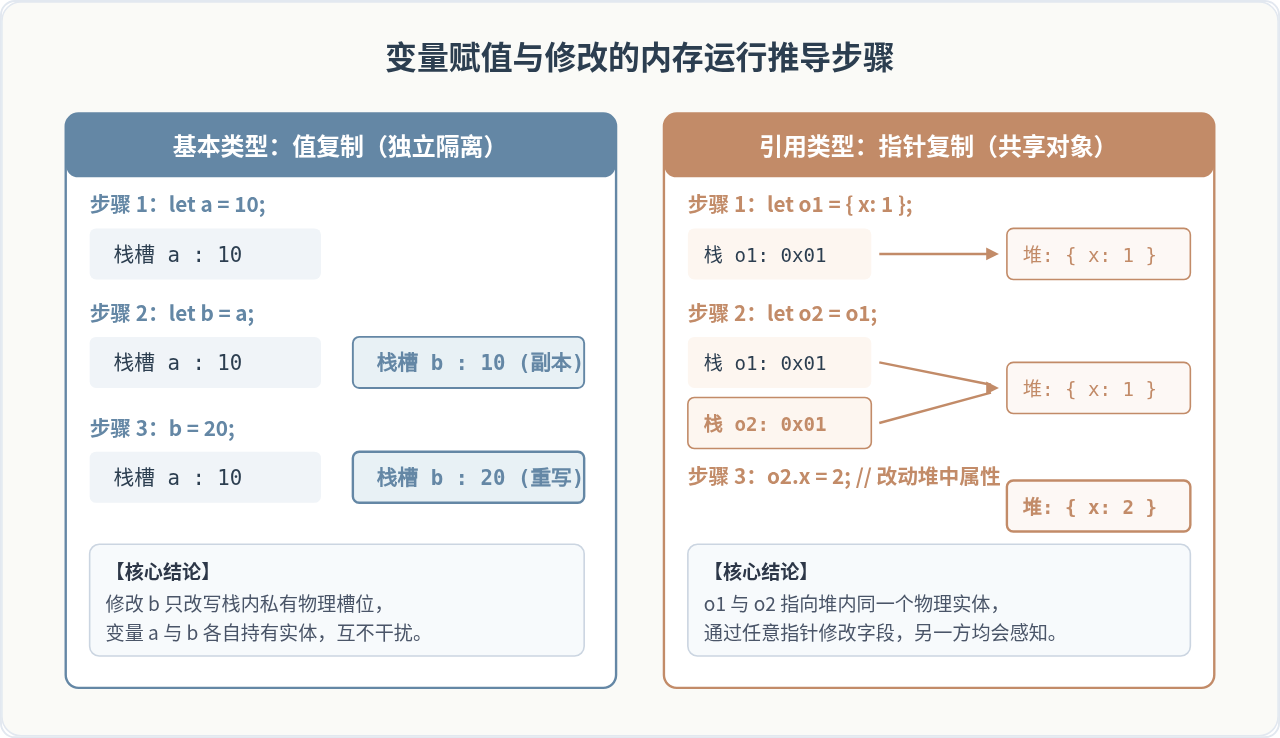
若执行
o2.x = 2,是顺着指针去堆中修改属性;但如果执行 o2 = { x: 99 },则是给 o2 在栈内的槽位写入一个全新对象的堆地址,此时 o2 切断了与原对象的关联,o1 仍指向原堆对象,其 x 不会变成 99。
四、核心特性维度深入对比
为了在系统设计和代码调试中迅速定位问题,我们可以从可变性、相等性判定、内存回收机制等几个核心维度深入剖析两者的底层差异。
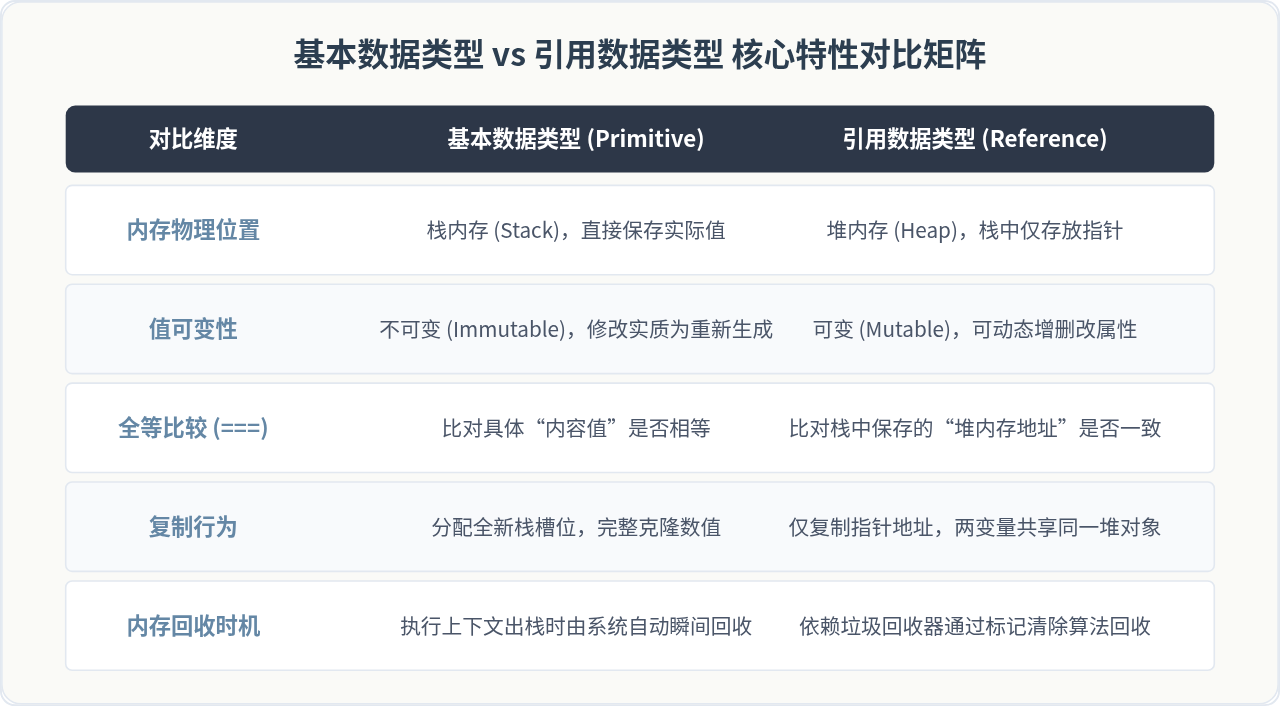
1. 全等比较(===)为何在对象比较时“反常理”?
初学者常常困惑于以下现象:
console.log('hello' === 'hello'); // true (值相同)
console.log(100 === 100);         // true (值相同)

console.log({} === {});           // false!为什么?
console.log([] === []);           // false!为什么?
原因在于:字面量 {} 每次出现,JavaScript 都会在堆内存中申请一块全新的独立空间。第一个 {} 假设物理地址为 0x00A1,第二个 {} 物理地址为 0x00B2。全等运算符 === 在面对引用类型时,比较的是栈中存放的指针地址,由于 0x00A1 !== 0x00B2,结果必然为 false。只有当两变量持有同一个内存地址时,比较才会成立。
2. 函数参数传递:本质均为“值传递”
技术面试中常问:“JavaScript 是按值传递还是按引用传递?”严格来说,JavaScript 中所有函数的参数传递都是按值传递(Pass by Value)。
- 传递基本类型时,形参得到的是实参数值的副本。
- 传递引用类型时,形参得到的是实参指针地址的副本(被称为按共享传递 Call by Sharing)。
function update(obj) {
  obj.name = "Bob";     // 顺着传入的指针地址修改堆对象属性(外部可见)
  obj = { name: "Tom" }; // 形参局部变量指向了新对象,原实参指针不受影响
}

let user = { name: "Alice" };
update(user);
console.log(user.name); // 输出 "Bob",而不是 "Tom"
五、开发中常见陷阱与内存管理指南
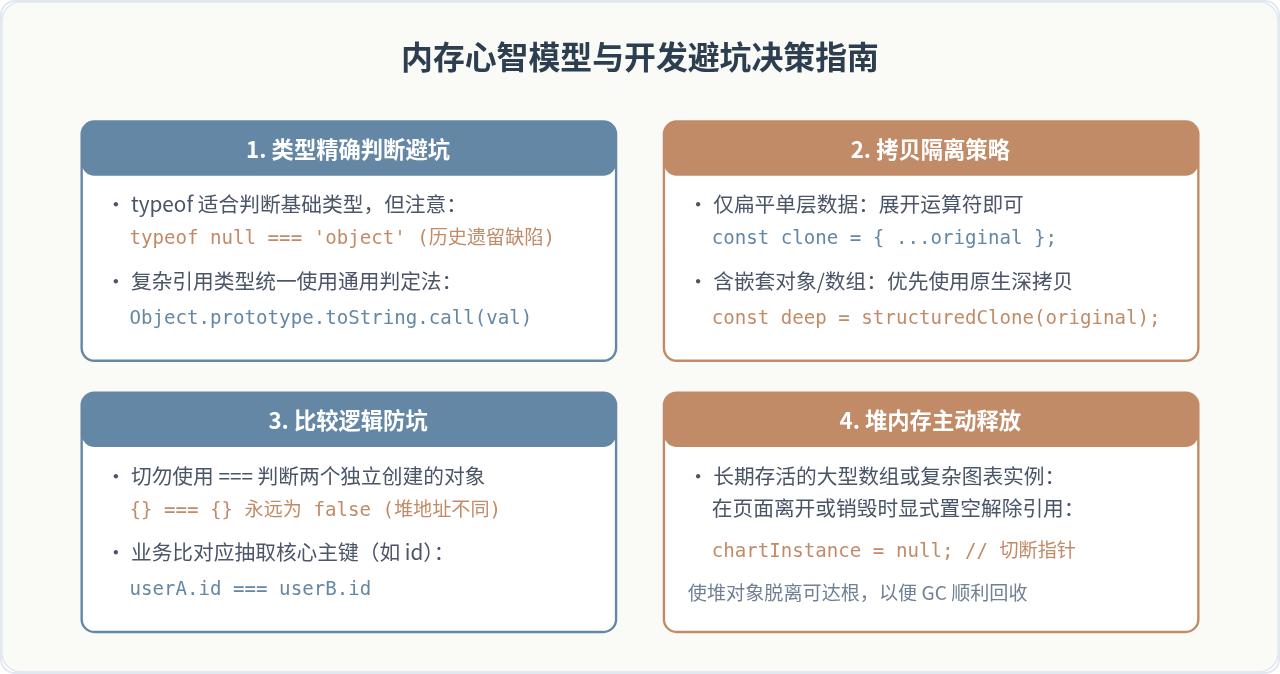
1. 浅拷贝(Shallow Copy)与深拷贝(Deep Copy)
由于引用类型在赋值时只复制指针,若要真正克隆出一个互不干扰的新对象,必须进行拷贝:
- 浅拷贝:例如
Object.assign({}, source)或展开运算符{ ...source }。它只复制对象第一层的键值对。若属性值本身还是一个对象,它仍然只复制指针,嵌套层依然会产生数据污染。 - 深拷贝:在堆内存中递归创建全新的对象结构,各层级均拥有独立物理空间。现代浏览器已原生支持
structuredClone(obj),亦可根据业务场景选用递归遍历方案。
2. 避免无意识的堆内存泄漏
JavaScript 具备自动垃圾回收机制,但若代码逻辑使得堆中的对象始终能被根对象(Global/Window/当前作用域链)可达,垃圾回收器就无法判定其为废弃对象,最终导致堆内存持续膨胀:
- 未清理的全局变量与缓存:挂载在全局变量上的对象生命周期与页面一致,除非显式设置
obj = null切断引用,否则堆内存永远不会释放。 - 未移除的事件监听器与定时器:若组件已经销毁,但
addEventListener或setInterval的回调闭包仍捕获着父级作用域的大对象,该对象在堆中就无法被回收。 - 闭包引用滥用:内层函数若长久保留对外部大体量对象的引用,将延长该对象在堆中的留存期。
六、全文总结
JavaScript 区分基本数据类型与引用类型的终极意义,在于计算机底层资源的最优调度。栈内存追求速度与轻量,通过固定尺寸满足局部变量的瞬时创建与即时销毁;堆内存追求容量与扩展,支撑动态复杂业务模型的发展。编写代码时,只要建立起“栈上存值、堆上存体、指针连结”的心智模型,面对变量赋值传参、深浅拷贝和内存泄露排查时便能游刃有余。
怎么在 Three.js 中加载 GLTF/GLB 模型并修复材质丢失
2026-11-02 09:23:59
three.js 加载常用 3D 模型格式的方法与代码示例
2026-10-31 13:09:57
深入理解JavaScript中setTimeout的执行机制与常见陷阱
2026-10-30 16:34:22







