

JS基本数据类型与引用类型的区别:栈堆存储与拷贝机制
深入解析JavaScript基本数据类型与引用数据类型的核心差异,详解栈内存与堆内存的存储模型、变量赋值机制、参数传递本质,以及浅拷贝与深拷贝的实现方案与避坑指南。
在 JavaScript 开发中,变量赋值和传递常常表现出截然不同的行为:修改一个数字变量并不会波及其他变量,而修改一个对象属性却可能导致多处数据同时改变。产生这种现象的根源在于 JavaScript 对“基本数据类型”和“引用数据类型”采用了完全不同的底层存储模型。本文将从运行时的栈内存与堆内存分配切入,详细剖析两者的本质差异、参数传递机制,并给出安全拷贝复杂数据的具体工程方案。
一、两类数据类型的定义与核心特征
ECMAScript 规范将所有运行期数据划分为两大阵营:基本数据类型(Primitive Types)与引用数据类型(Reference Types)。明确两者的边界是理解后续存储机制的前提。
1. 基本数据类型(值类型)
截至当前标准,JavaScript 共有 7 种基本数据类型:
Number:双精度 64 位二进制浮点数,以及NaN、Infinity。String:不可变字符序列。Boolean:布尔值(true与false)。Undefined:未定义,表示变量已声明但尚未被赋予具体值。Null:空值,表示一个空的对象指针占位。Symbol:ES6 引入的独一无二标识符。BigInt:支持任意精度的整数类型。
基本类型的核心特征是不可变性(Immutable)与按值访问。所谓不可变,是指内存中该原始数据一旦分配就无法被原地修改;我们平时对字符串进行的拼接、截取,本质上都是在内存中创建了崭新的原始值并返回。
2. 引用数据类型(复杂类型)
引用数据类型统称为 Object,涵盖广义上的各种实体与集合结构:
- 普通对象(
Object) - 数组(
Array) - 函数(
Function) - 内置对象与容器:
Date、RegExp、Map、Set等。
引用类型的核心特征是可扩展性(Mutable)与按引用访问。对象在创建后,其属性可以被动态添加、修改或删除,其内部包含的值大小和属性数量往往是动态可变的。
二、内存存储模型:栈内存(Stack)与堆内存(Heap)
JavaScript 引擎(如 V8)在执行代码时,会划分出不同职责的内存空间,其中与变量存储直接相关的是栈内存(Stack)与堆内存(Heap)。
栈内存由操作系统直接调度,结构为先进后出(LIFO)的连续内存区。栈空间存取速度极快、容量较小,专门存放执行上下文中的局部变量标识符、基本数据类型的值,以及对象在堆中的引用地址(指针)。
堆内存是一块结构更为灵活但存取相对开销较大的动态存储区。由于对象的大小无法在编译期预先确定,且生命周期受垃圾回收器(Garbage Collector)管理,引擎会将对象的具体内容放置在堆内存中,并将堆内存的十六进制起始地址写入栈内存的变量格内。
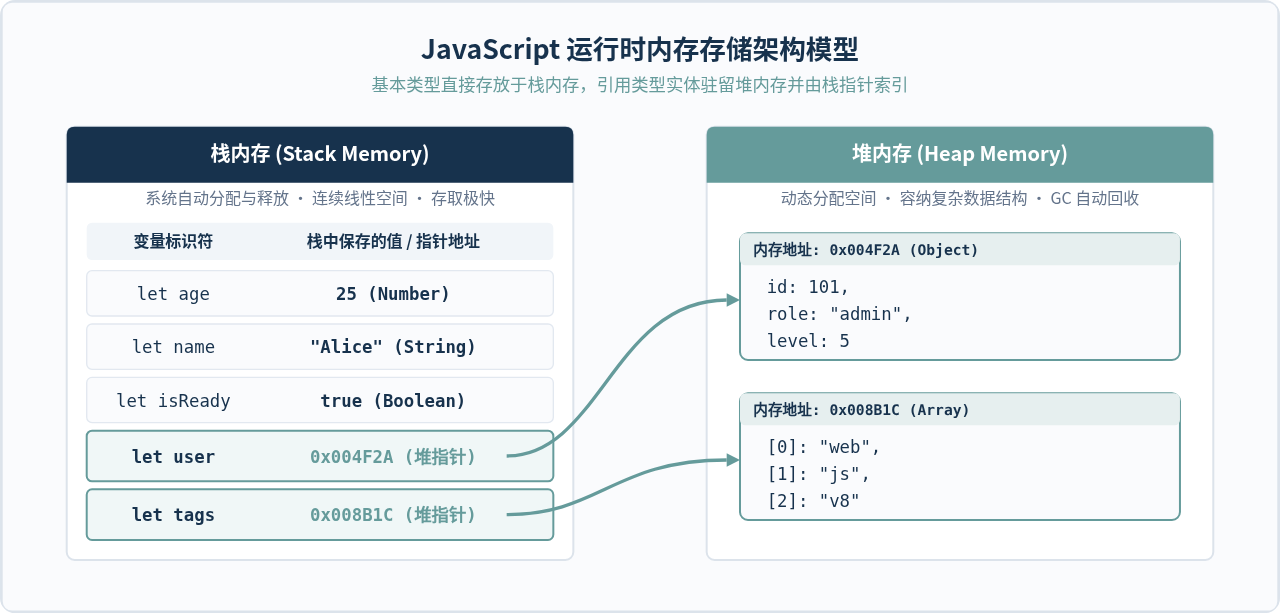
三、变量赋值与传参行为的本质差异
理解了栈与堆的分布规则,变量赋值(Assignment)与函数传参(Parameter Passing)的真实执行逻辑便一目了然。
1. 变量赋值行为对比
在 JavaScript 中,执行 let b = a 时,引擎在底层只做一件事:将变量 a 在栈内存中的内容完整复制一份,写入为变量 b 分配的栈空间中。
- 若
a是基本类型:栈中复制的是纯粹的具体值。赋值完成后,a与b各自拥有独立的值副本,后续对b的任何算术运算或重新赋值,都不会影响a。 - 若
a是引用类型:栈中保存的是堆内存地址。因此,复制给b的也是这串内存地址(指针)。此时a与b共同指向堆内存中完全相同的对象实体。当执行b.name = "Bob"时,由于修改的是指针所指向的堆实体,a.name也会同步发生改变。
2. 引用赋值 vs 重新赋值的区别
初学者容易产生一个混淆:既然 b = a 共享对象,为什么给 b 赋予一个新对象后,a 却不会变成新对象?
原因在于:修改属性(如 b.prop = 1)操作的是堆内存;而直接重新赋值(如 b = { prop: 1 })改变的是 b 自己的栈内存指针。给 b 重新赋值会切断 b 对原堆地址的指向,使其改为指向全新的堆地址,而 a 栈中的指针从未改变。
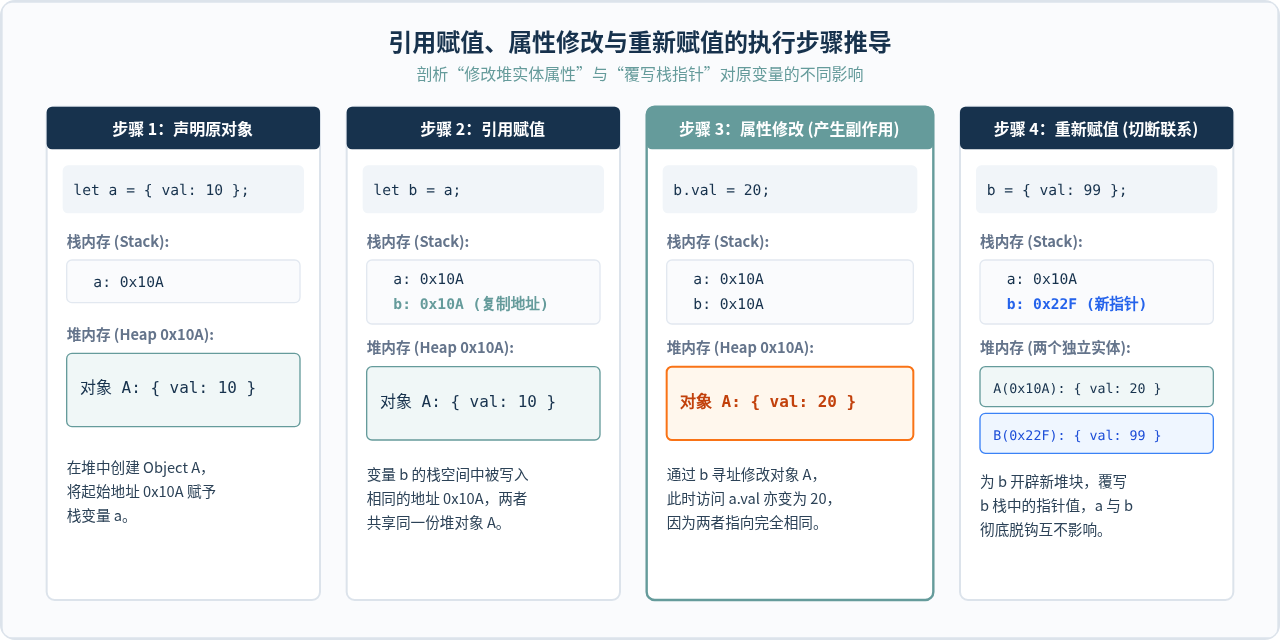
3. 函数参数传递:全都是“按值传递”
在面试和日常技术交流中,常有人误称“基本类型按值传递,引用类型按引用传递”。在规范层面,JavaScript 的所有传参都是严格的按值传递(Pass by Value)。
当把一个对象传入函数时,形参得到的是该对象指针地址的一个拷贝值(在学术上亦称为按共享传递,Call by Sharing)。验证这一规则的经典代码如下:
function modifyObject(obj) {
  // 操作 1:通过指针修改属性,外部可感知
  obj.name = "Modified";

  // 操作 2:给形参赋予全新对象,外部不受影响
  obj = { name: "Completely New" };
}

const target = { name: "Original" };
modifyObject(target);

console.log(target.name); // 输出: "Modified",而不是 "Completely New"
如果 JavaScript 真正支持语言级的按引用传递(如 C++ 中的 & 引用),那么在函数内部对 obj 的重新赋值必定会导致外部 target 也变为新对象。实际打印输出 "Modified" 证明了形参只持有栈中指针副本,重新赋值仅仅切断了形参自身的绑定。
四、拷贝机制剖析:从浅拷贝到深拷贝
由于引用类型的赋值只是简单复制内存地址,为了在修改新数据时不污染源数据,必须建立实体拷贝机制。根据复制的深度层次,拷贝分为浅拷贝与深拷贝。
1. 浅拷贝(Shallow Copy)
浅拷贝会创建一个新对象,并将原始对象第一层的所有属性键值对逐一拷贝到新对象中:
- 若属性值是基本类型,拷贝的就是基本类型的原始值;
- 若属性值是引用类型(如嵌套的子对象或数组),拷贝的依然是该子对象的指针地址。
常见实现浅拷贝的语法手段:
const source = { id: 1, info: { city: "Beijing" } };

// 方案 A:展开运算符(Spread)
const copyA = { ...source };

// 方案 B:Object.assign
const copyB = Object.assign({}, source);

// 方案 C:针对数组的 slice() 或 concat()
const arrCopy = [1, [2, 3]].slice();隐患提示:浅拷贝仅适用于单层扁平对象。一旦源对象包含嵌套属性,执行 copyA.info.city = "Shanghai" 依然会同步修改 source.info.city,在复杂应用(如 Vue/React 状态更新)中容易引起难以定位的隐蔽 Bug。
2. 深拷贝(Deep Copy)
深拷贝会递归遍历源对象的所有层级,无论嵌套了多少层对象或数组,都会在堆内存中为每一层独立开辟新的存储空间。深拷贝后的产物与源对象在内存物理层面完全隔绝。
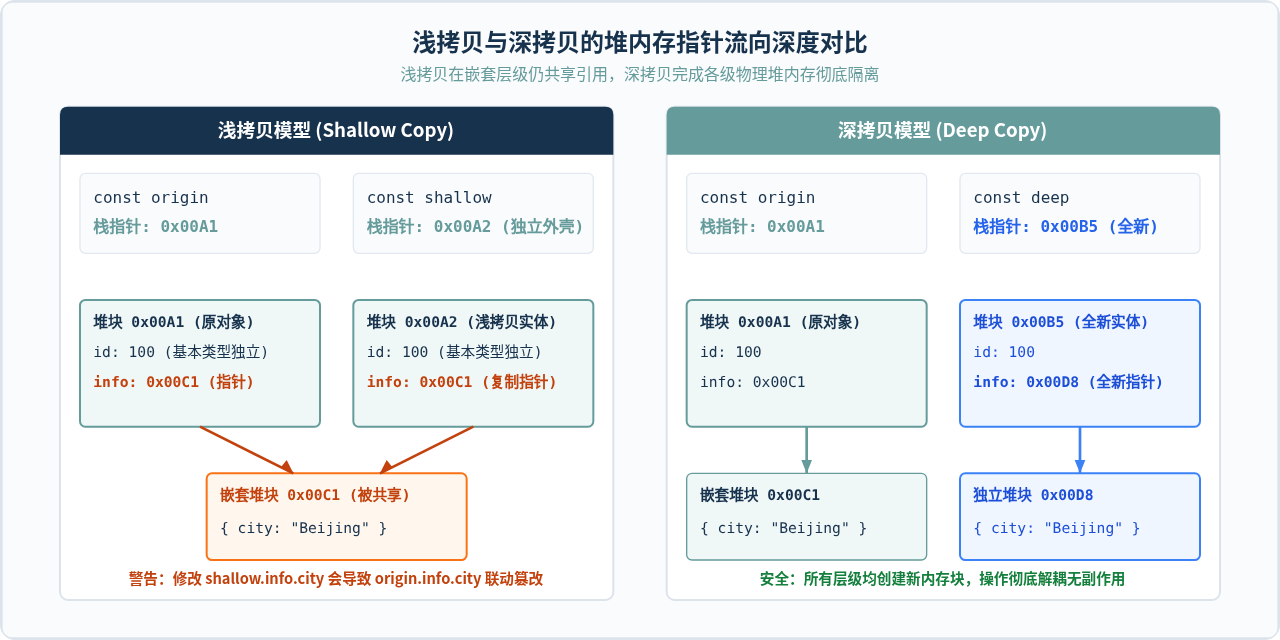
五、深拷贝的工程落地方案与选择
在前端与 Node.js 实际项目中,实现深拷贝主要有以下三种手段,它们各自具有明确的适用边界:
方案 1:现代原生标准 structuredClone()(推荐优先选用)
HTML 规范及 ECMAScript 运行时已经全平台内置了全局函数 structuredClone()(支持 Node.js 17+ 及各主流现代浏览器)。它采用结构化克隆算法,属于开箱即用的原生深拷贝能力:
const original = {
  date: new Date(),
  set: new Set([1, 2, 3]),
  map: new Map([["key", "value"]]),
  nested: { count: 42 }
};

// 执行标准深拷贝
const cloned = structuredClone(original);优势:原生 C++ 实现,性能卓越;天生支持 Date、RegExp、Map、Set、ArrayBuffer 等复杂内建对象;能自动检测并正确处理循环引用(Circular Reference)。
限制条件:不支持克隆函数(Function)、DOM 节点以及带有原型链上自定义 getter/setter 的特殊实例(遇到会直接抛出 DataCloneError 异常)。
方案 2:JSON.parse(JSON.stringify(obj))(受限场景下的快捷方式)
通过序列化与反序列化生成全新对象,是代码量最少的技巧:
const cleanObj = JSON.parse(JSON.stringify(oldObj));局限性:
- 会直接忽略
undefined、Symbol和函数属性。 - 会将
Date转换成 ISO 字符串,将RegExp和Error转换为空对象{}。 - 会将
NaN和Infinity转为null。 - 无法处理循环引用,遇到即崩溃报错(
TypeError: Converting circular structure to JSON)。
方案 3:基于 WeakMap 的通用手写递归深拷贝
当需要拷贝包含函数、原型链或在低版本执行环境中运行时,需要手写支持循环引用的递归实现。使用 WeakMap 缓存已被遍历过的对象实体,能够有效避免死循环栈溢出:
function deepClone(target, hash = new WeakMap()) {
  // 1. 如果是基本类型或 null/undefined,直接返回值
  if (target === null || typeof target !== "object") {
    return target;
  }

  // 2. 特殊引用类型处理
  if (target instanceof Date) return new Date(target);
  if (target instanceof RegExp) return new RegExp(target);

  // 3. 循环引用检测:如果已克隆过当前对象,直接从缓存返回
  if (hash.has(target)) {
    return hash.get(target);
  }

  // 4. 初始化同构容器(保持 Array 或 Object 的原型构造)
  const cloneTarget = Array.isArray(target) ? [] : Object.create(Object.getPrototypeOf(target));
  hash.set(target, cloneTarget);

  // 5. 递归复制属性(包含 Symbol 键)
  const keys = Reflect.ownKeys(target);
  for (const key of keys) {
    cloneTarget[key] = deepClone(target[key], hash);
  }

  return cloneTarget;
}
六、全维度特性总结与决策矩阵
为了在实际编码、代码审查及架构设计中做出准确决策,下表与图示全面归纳了基本类型与引用类型的核心特征矩阵:
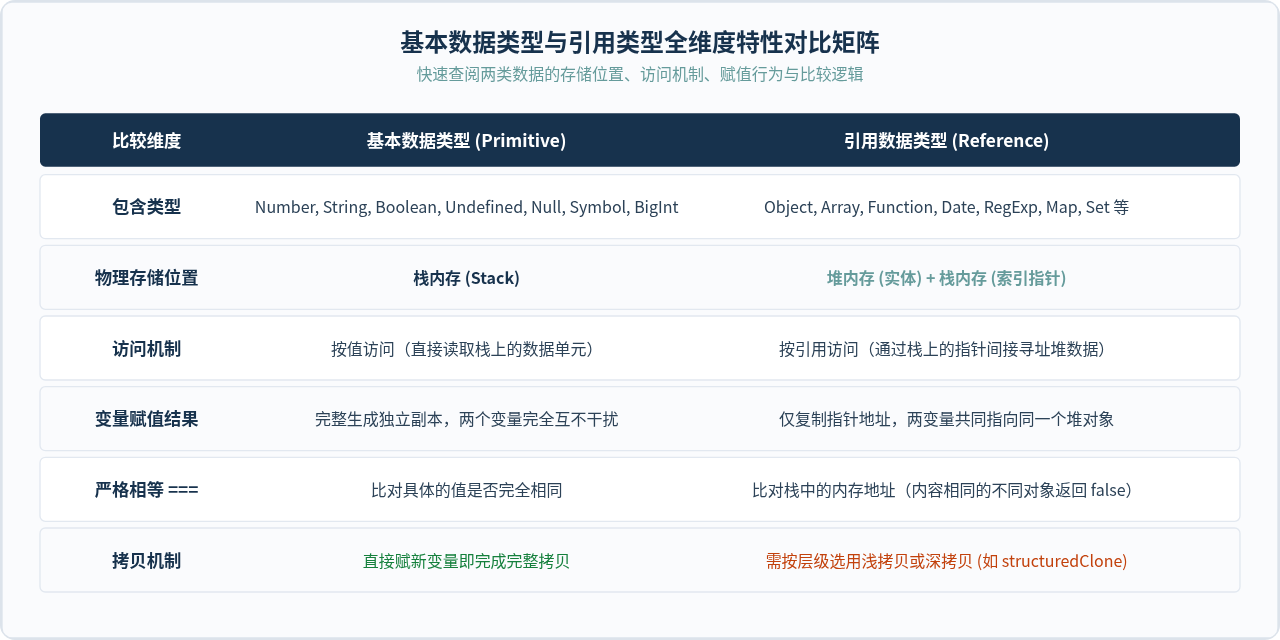
七、开发常见误区与注意事项
在日常业务开发中,以下两点细节极易引起理解偏差:
1. const 声明对象的属性可变性
使用 const 声明变量时,许多开发者会误以为该对象的所有属性都“只读”。事实上,const 约束的仅仅是栈内存中变量绑定的指针地址不可更改。也就是说,你不能对该变量执行 obj = {} 重新赋值,但通过 obj.name = "New" 修改堆内存实体的属性是完全合法的。如果需要真正冻结对象内容,应当显式调用 Object.freeze(obj)(注意该方法亦为浅冻结)。
2. typeof null === "object" 的历史遗留
在检测变量类型时,执行 typeof null 会返回 "object"。这是 JavaScript 最初版本实现中的一个历史 Bug:由于早期系统使用 32 位单元存储变量,用低位 1-3 位作为类型标签,而对象的类型标签正好为 000;null 的空指针表示为全 0,导致其直接被错误判定为对象。严谨判断类型时,应优先使用 Object.prototype.toString.call(val) 或 Array.isArray()。
掌握了栈与堆的分配逻辑、指针的复制传递以及深浅拷贝的适用边界,开发者就能在处理状态管理、事件传递及数据管道时做到心中有数,从根源上规避引用污染带来的系统隐患。
JavaScript怎么准确判断数据类型:typeof、instanceof与Object.prototype.toString
2026-11-05 17:09:21
JS中将数组和对象混合组装为JSON字符串
2026-11-05 16:41:42
JS运算符优先级与结合性的区别是什么?
2026-11-05 13:22:02
JS Map怎么只遍历Key或Value
2026-11-05 13:00:36
D3.js 与 ECharts 选型对比:灵活性 vs 开发效率
2026-11-05 09:45:01







