JavaScript高阶函数练习题:map/reduce应用与柯里化实现
深入解析JavaScript高阶函数核心机制,通过map与reduce高频练习题剖析其内部细节,手写实现通用柯里化并结合实战构建数据处理管道。
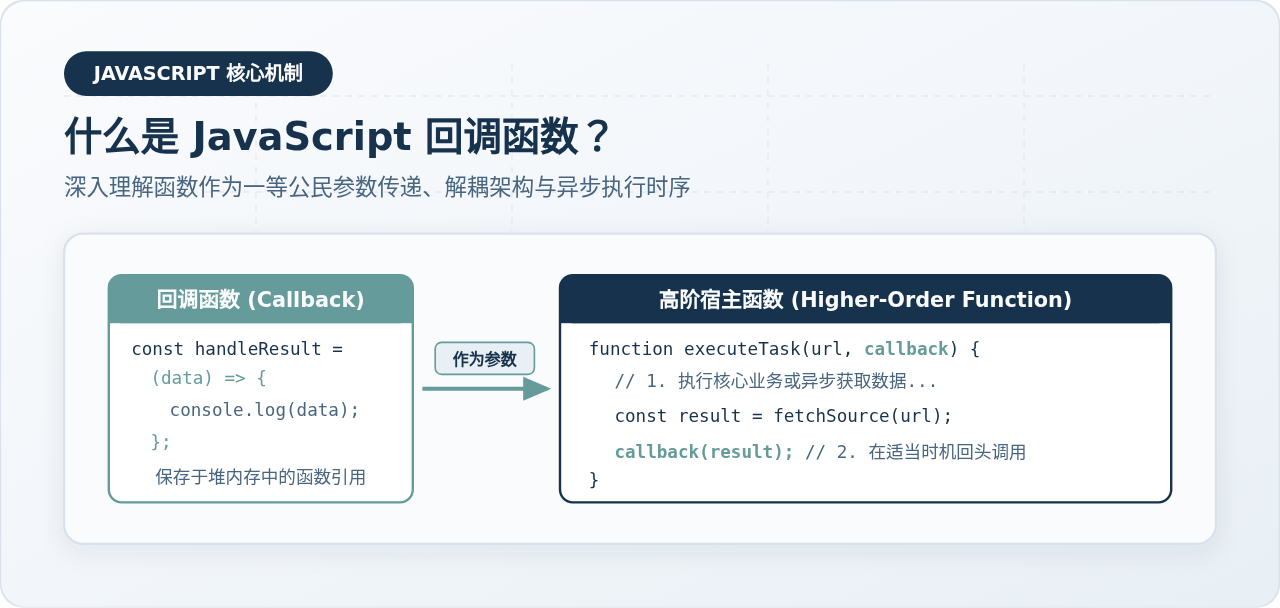
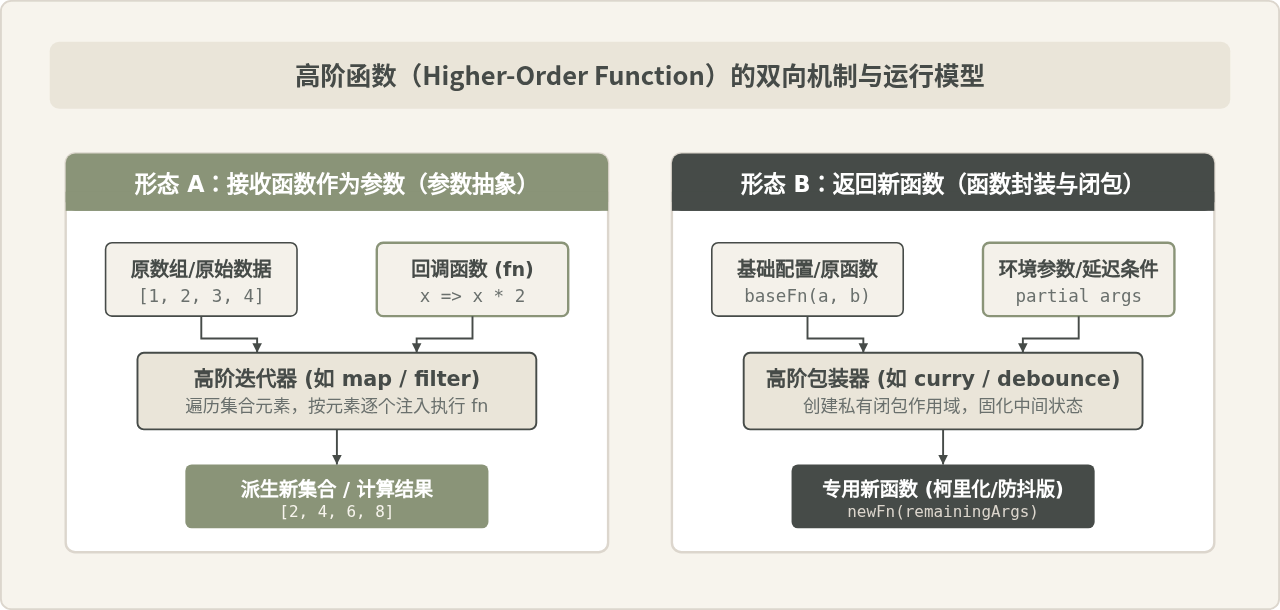
高阶函数(Higher-Order Function)是满足“接收函数作为参数”或“将函数作为返回值输出”的函数。在日常业务开发与面试考核中,单纯记忆概念往往难以应对复杂数据变形与架构抽象需求。本文通过精选的典型练习题,系统剖析 Array.prototype.map、Array.prototype.reduce 的底层边界行为与高级聚合技巧,并完整推导通用柯里化(Currying)函数的实现过程,帮助你在实际编码中写出简洁、健壮且易于组合的 JavaScript 代码。
一、高阶函数基础与核心运行机制
在 JavaScript 中,函数是一等公民(First-Class Citizen),这意味着函数可以像普通数值、字符串或对象一样被赋值给变量、存储在数据结构中,或者在函数之间传递。高阶函数利用这一特性实现了控制逻辑与具体执行细节的解耦。
常见的高阶操作主要体现为两类典型形态:一类是行为抽象,例如 Array.prototype.filter、map、sort,它们接收一段决策逻辑并在集合上迭代执行;另一类是函数工厂与包装器,例如防抖(Debounce)、节流(Throttle)以及柯里化函数,它们接收目标函数并产出具备附加控制状态的新函数。
二、练习题一:map 的边界处理与手写实现
Array.prototype.map 负责对数组中的每个元素调用指定回调,并返回包含每次调用结果的新数组。初学者常以为 map 只是简单的 for 循环,但真实规范中包含三个重要边界:稀疏数组跳过(Sparse Arrays)、回调传参完整性(item, index, array)以及 thisArg 上下文绑定。
经典陷阱辨析:为什么 ['1', '2', '3'].map(parseInt) 返回 [1, NaN, NaN]?
很多开发者在初遇该题时会感到困惑。其根本原因在于参数签名的错位:
map传递给回调的签名是:callback(currentValue, index, array)。parseInt接收的参数签名是:parseInt(string, radix),其中第二个参数代表进制基数。
当两者直接结合时,实际执行过程如下:
// 第一次迭代:index 为 0
parseInt('1', 0); // radix 为 0 时,默认按 10 进制解析,返回 1

// 第二次迭代:index 为 1
parseInt('2', 1); // 进制基数 radix 必须在 2 到 36 之间,1 属于非法进制,返回 NaN

// 第三次迭代:index 为 2
parseInt('3', 2); // 2 进制中只允许 0 和 1,字符 '3' 无法识别,返回 NaN正确做法是使用显式单参箭头函数进行包裹:['1', '2', '3'].map(num => parseInt(num, 10)),确保第二个参数始终明确指定为 10。
手写实现规范级 myMap
要真正理解 map,最有效的方法是手写实现。该实现必须兼顾原型链安全、上下文 thisArg 以及稀疏数组(通过 in 操作符跳过空位索引):
Array.prototype.myMap = function(callback, thisArg) {
  // 1. 严格检查调用主体是否合法
  if (this == null) {
    throw new TypeError('Array.prototype.myMap called on null or undefined');
  }
  // 2. 检查 callback 是否为可执行函数
  if (typeof callback !== 'function') {
    throw new TypeError(callback + ' is not a function');
  }

  // 3. 转为对象并获取长度(遵循规范 ToObject 与 ToLength)
  const O = Object(this);
  const len = O.length >>> 0; // 无符号右移确保非负整数
  const result = new Array(len);

  // 4. 循环迭代,使用 in 操作符跳过稀疏数组的未定义空位
  for (let i = 0; i < len; i++) {
    if (i in O) {
      result[i] = callback.call(thisArg, O[i], i, O);
    }
  }

  return result;
};

// 验证用例
const sparseArr = [1, , 3];
const mapped = sparseArr.myMap(x => x * 2);
console.log(mapped); // 输出: [2, 空属性, 6],长度仍为 3
三、练习题二:reduce 的多元聚合应用与管道构建
Array.prototype.reduce 是 JavaScript 中最具表达力的数组方法。任何通过 map 和 filter 完成的变换,都可以用 reduce 单次遍历实现。其核心模型是“累加器(Accumulator)传递模式”。
若不提供
initialValue,reduce 会把数组第 0 个元素作为初始累加器,并从索引 1 开始迭代;如果对一个空数组调用不带初始值的 reduce,JavaScript 引擎会立即抛出 TypeError: Reduce of empty array with no initial value。因此,在业务中处理动态数据时,务必养成显式指定 initialValue 的良好习惯。
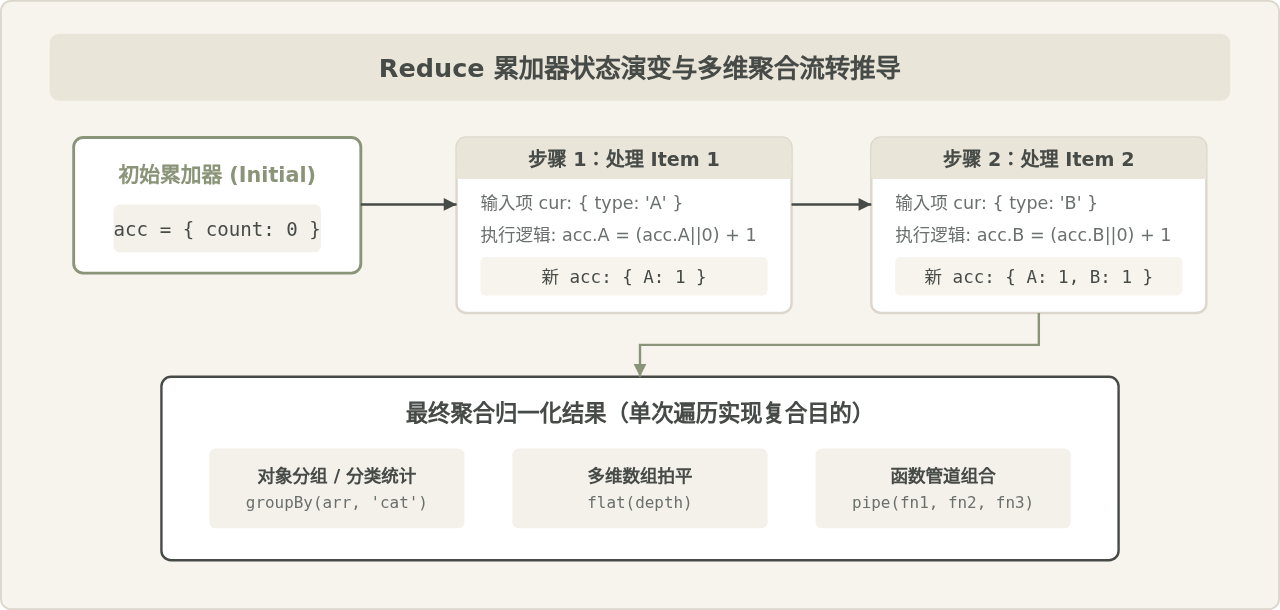
练习题 2.1:利用 reduce 实现多属性对象分组(groupBy)
在数据看板或分类统计中,经常需要将平面数组按指定字段转为字典分组:
function groupBy(array, keyOrFn) {
  return array.reduce((acc, item) => {
    // 允许通过字段名或自定义回调获取分组键
    const key = typeof keyOrFn === 'function' ? keyOrFn(item) : item[keyOrFn];
    if (!acc[key]) {
      acc[key] = [];
    }
    acc[key].push(item);
    return acc;
  }, {});
}

// 示例
const students = [
  { name: '张三', score: 85, grade: 'A' },
  { name: '李四', score: 62, grade: 'C' },
  { name: '王五', score: 91, grade: 'A' }
];
console.log(groupBy(students, 'grade'));
// 输出: { A: [张三, 王五], C: [李四] }
练习题 2.2:利用 reduce 实现函数管道(pipe 与 compose)
函数组合是函数式编程的核心支柱。pipe 代表从左到右执行数据流,而 compose 代表从右往左嵌套执行:
// 从左往右顺序流转
const pipe = (...fns) => (initialValue) =>
  fns.reduce((acc, fn) => fn(acc), initialValue);

// 从右往左经典数学复合 f(g(x))
const compose = (...fns) => (initialValue) =>
  fns.reduceRight((acc, fn) => fn(acc), initialValue);

// 测试管道
const add10 = x => x + 10;
const multiply2 = x => x * 2;
const toString = x => `结果为: ${x}`;

const calculate = pipe(add10, multiply2, toString);
console.log(calculate(5)); // 输出: "结果为: 30" (5 + 10 = 15 -> 15 * 2 = 30 -> 格式化)
四、练习题三:通用柯里化(Currying)的实现与参数收集机制
柯里化是把一个接收多个参数的函数,转化为“接收一个单一参数(或部分参数)并返回一个新函数,直到所有参数收齐后执行”的技术。柯里化的核心价值在于参数复用、提前校验与延迟执行。
实现通用柯里化的关键逻辑
- 获取原函数形参个数:通过
fn.length获取原函数声明的必要参数个数。需要注意:默认参数、剩余参数(...rest)不会计入length。 - 比较实参个数与形参需求:每次调用时将新参数与之前收集的闭包参数合并。如果已收集参数数量大于等于
fn.length,则立即调用原函数并返回最终结果;如果数量不足,则返回一个新函数继续收集后续参数。
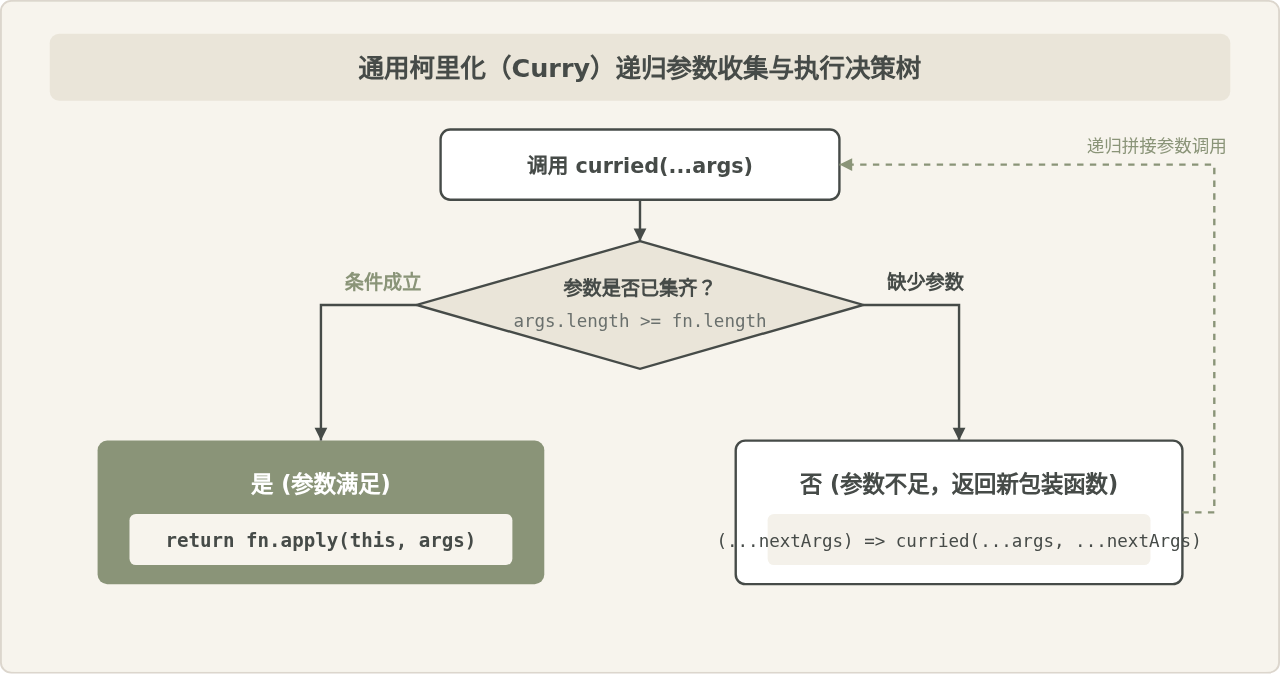
手写通用 curry 实现
function curry(fn) {
  if (typeof fn !== 'function') {
    throw new TypeError('curry 必须接收一个函数');
  }

  return function curried(...args) {
    // 若当前收齐的参数个数已满足原函数要求
    if (args.length >= fn.length) {
      return fn.apply(this, args);
    }

    // 否则返回一个新函数,继续接收并拼接后续参数
    return function(...nextArgs) {
      return curried.apply(this, args.concat(nextArgs));
    };
  };
}

// 示例:多参数累加
function sum(a, b, c) {
  return a + b + c;
}

const curriedSum = curry(sum);
console.log(curriedSum(1)(2)(3));    // 输出: 6
console.log(curriedSum(1, 2)(3));    // 输出: 6
console.log(curriedSum(1)(2, 3));    // 输出: 6
五、练习题四:组合实战——用柯里化配合 map/reduce 构建数据清洗管道
为了体会柯里化在工程中的威力,我们来看一个真实业务场景:处理从服务端接收的原始用户订单数据,剔除无效订单、计算含税折扣价并归纳用户总消费。
业务需求场景
原始订单列表中包含多个字段,我们需要:
- 过滤掉状态不为
'PAID'的订单; - 将外币金额统一根据传入汇率换算并乘以折扣率;
- 按用户 ID 分组归纳其实际总支付金额。
// 1. 定义纯工具高阶/柯里化函数
const prop = curry((key, obj) => obj[key]);
const filter = curry((predicate, array) => array.filter(predicate));
const map = curry((transform, array) => array.map(transform));

// 2. 构造特定领域的运算单元
const isPaid = order => prop('status', order) === 'PAID';
const calculateFinalPrice = curry((exchangeRate, discount, order) => ({
  userId: order.userId,
  amount: Number((order.amount * exchangeRate * discount).toFixed(2))
}));

// 3. 原始输入数据
const rawOrders = [
  { id: 101, userId: 'U1', amount: 100, status: 'PAID' },
  { id: 102, userId: 'U2', amount: 250, status: 'CANCELLED' },
  { id: 103, userId: 'U1', amount: 80,  status: 'PAID' },
  { id: 104, userId: 'U3', amount: 300, status: 'PAID' }
];

// 4. 构建数据管道
// 固定当前美元汇率 7.2,折扣 0.95
const applyPricing = calculateFinalPrice(7.2, 0.95);

const aggregateUserSpending = (orders) => {
  return orders.reduce((summary, order) => {
    const { userId, amount } = order;
    summary[userId] = (summary[userId] || 0) + amount;
    return summary;
  }, {});
};

// 使用之前实现的 pipe 组合高阶函数
const processOrders = pipe(
  filter(isPaid),
  map(applyPricing),
  aggregateUserSpending
);

console.log(processOrders(rawOrders));
// 输出: { U1: 1231.2, U3: 2052 }
通过柯里化,我们预先固化了汇率与折扣规则,使得转换函数 applyPricing 能够无缝作为标准参数送入 map 中,避免了在迭代循环中频繁写出冗长的临时逻辑,保证了代码的可读性与可维护性。
六、常见认知辨析与概念边界
辨析一:高阶函数是否一定会导致严重的性能下降?
有人认为命令式的 for 循环在任何时候都优于 map/filter/reduce,因此应该尽量避免使用高阶函数。这种观点看似合理,是因为多层 map().filter() 会产生临时的中间数组并增加函数调用开销(Call Stack)。
但在现代 V8 等 JavaScript 引擎中,内置迭代方法已经经历了深度的 JIT 内联(Inlining)和内存逃逸分析优化。在处理十万条以下的一般业务数据集时,高阶函数与原生循环的耗时差异通常在微秒级别,对用户体验毫无感知影响;而高阶函数带来的无副作用、易于单测和逻辑清晰的工程价值,远远大于微小的纳秒级差异。只有在千万级密集数值计算、游戏渲染循环等极端场景下,才需要优先重写为扁平的 while/for 循环。
辨析二:柯里化(Currying)与偏函数应用(Partial Application)是一回事吗?
很多开发者混淆这两个概念。它们的本质差异在于调用的元数与返回形态:
- 柯里化(Currying):是将一个 $N$ 元函数逐层转化为 $N$ 个单一参数函数的过程。严格意义上的柯里化每次调用仅接收一个参数,直到满足原函数的 Arity(形参数量)。
- 偏函数应用(Partial Application):是固定原函数的其中 $M$ 个参数($M < N$),产出一个接收剩余 $N - M$ 个参数的新函数。它不强制要求每次只传一个参数。
七、知识体系与练习复盘总结
学习高阶函数的核心,不仅在于掌握几个原生 API 的语法糖,更在于培养声明式(Declarative)的数据流设计思维。下表梳理了本文四大练习题的核心技能树:
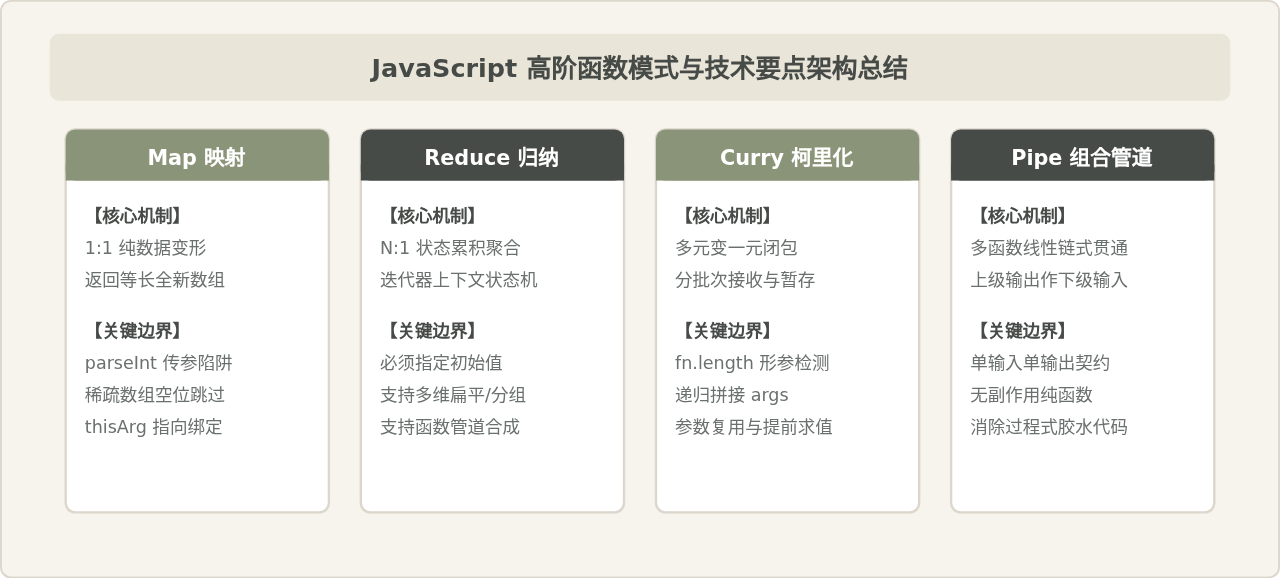
通过掌握 map 的元素映射与稀疏位细节、reduce 的累加器聚合状态流转,以及 curry 的参数延迟收集机制,我们能够将复杂的大型数据处理任务拆解为精炼、单一职责的微小函数,并通过管道自由装配。在实际项目开发中,合理选用这套高阶函数工具集,是提升代码抽象度与工程质量的重要法宝。
D3.js 比例尺与坐标轴的配置详解
2026-11-05 16:54:46
JavaScript怎么遍历对象的Symbol键和不可枚举属性
2026-11-05 13:13:39
封装一个健壮的JS字符串判空工具函数
2026-11-05 12:16:14
JavaScript合并数组的三种常用方法:concat、扩展运算符与push
2026-11-05 11:22:29
JavaScript立即执行函数(IIFE)是什么及基本语法
2026-11-05 10:51:19