JavaScript事件驱动模型与多线程阻塞模型的区别
深入对比JavaScript事件驱动非阻塞模型与传统多线程阻塞模型的架构差异、执行机制、资源开销与适用场景。
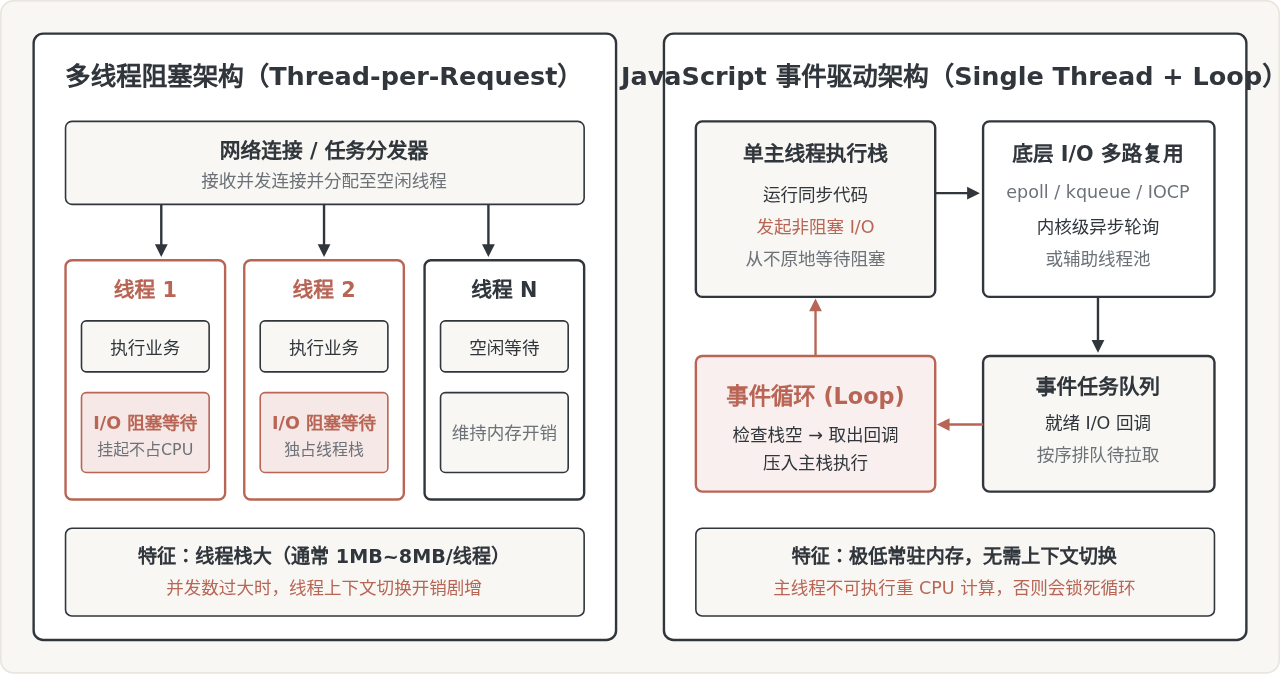
JavaScript 事件驱动模型与多线程阻塞模型的核心差异,在于处理并发任务时对操作系统线程资源的组织方式:前者依赖单主线程和事件循环(Event Loop),通过非阻塞 I/O 和回调机制在单个执行上下文中轮询流转任务;后者则采用“一连接/一任务一线程”的分配模式,线程在遇到 I/O 操作时主动休眠等待,直到内核返回数据后再唤醒。这种本质区别直接决定了两者的内存开销、高并发吞吐能力以及编程复杂度的分歧。
一、两种并发模型的底层运行机制
要理解两者的差异,首先需要看任务在运行时系统内部是如何被调度执行的。
1. 多线程阻塞模型的运行机制
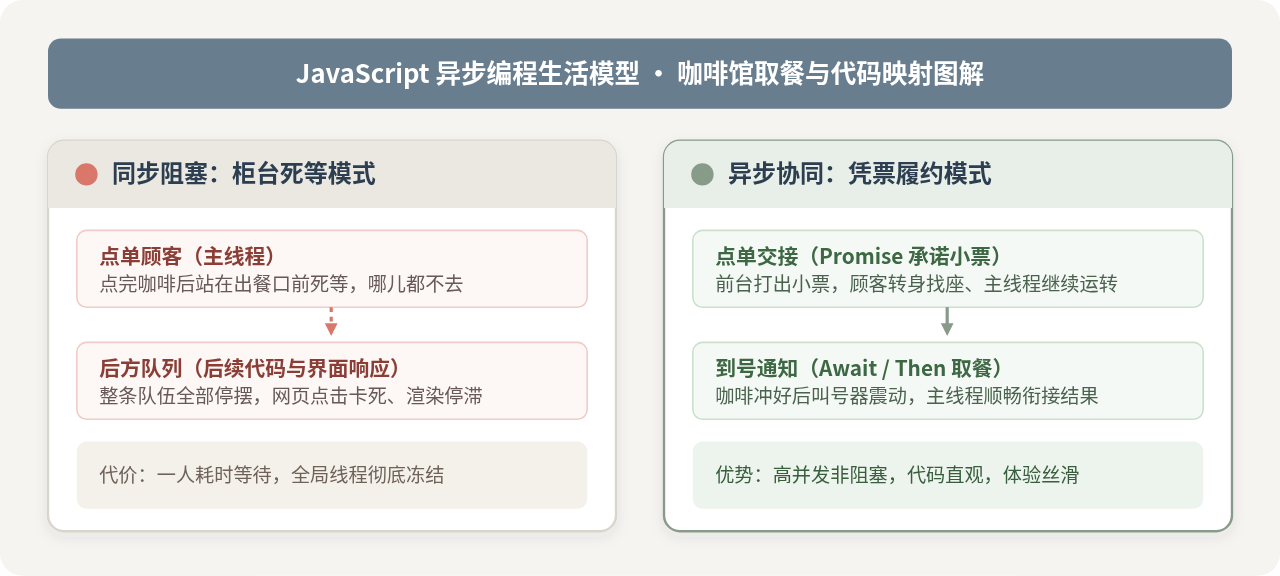
在经典的多线程阻塞模型(如传统 Java Servlet 容器、早期 Apache HTTP Server)中,服务器维护一个线程池。当一个客户端连接或耗时 I/O 请求到达时,主调度器会从池中提取一个独立的工作线程处理该请求。若该线程发起数据库查询或磁盘读取操作,操作系统会将该线程挂起(进入阻塞等待状态),CPU 切换到其他就绪线程执行。直到数据就绪,操作系统通过中断唤醒该线程,继续向下执行。
2. JavaScript 事件驱动模型的运行机制
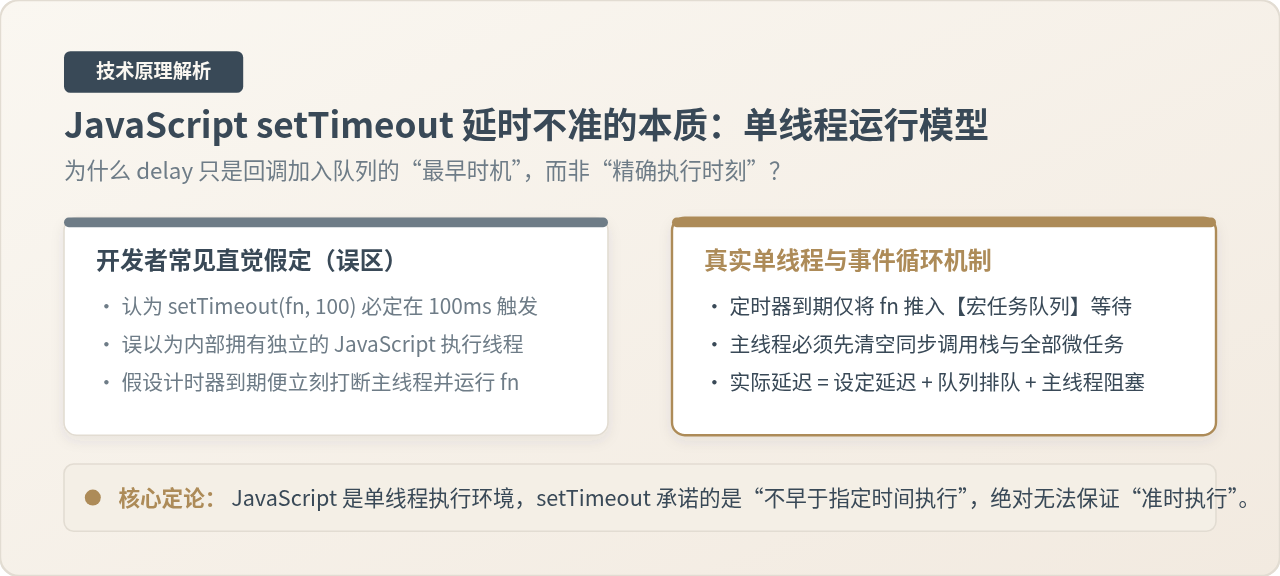
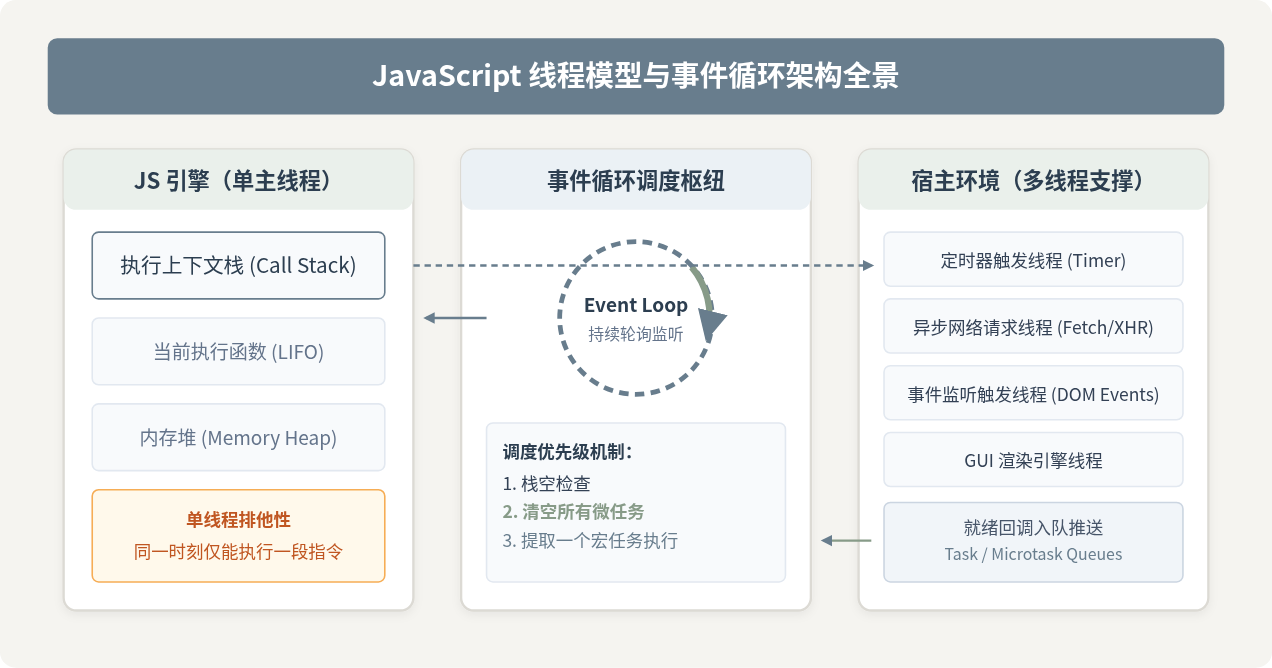
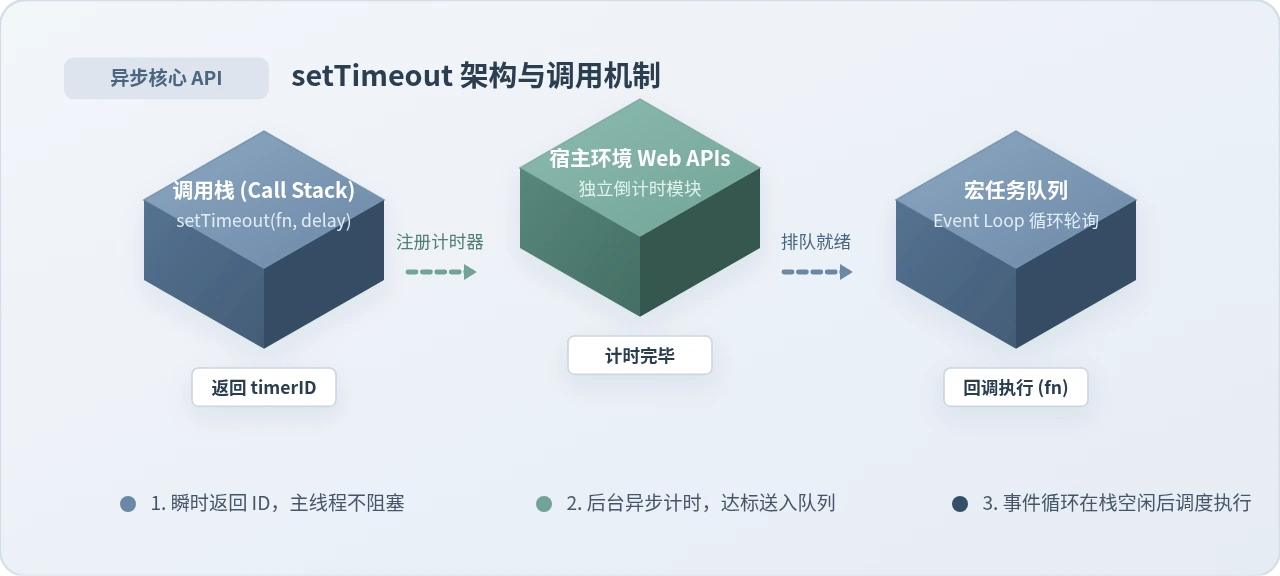
JavaScript 运行时(浏览器引擎或 Node.js)的主执行栈始终只有一个主线程在执行同步代码。当遇到网络请求、文件读取或定时器等异步操作时,主线程并不等待结果返回,而是将具体底层 I/O 工作交付给宿主环境(如 Node.js 底层的 libuv 线程池或操作系统的 epoll/kqueue 事件通知),主线程立即返回继续执行后续同步代码。一旦底层 I/O 完成,相应事件附带回调函数被推入任务队列,等待主调用栈清空后由事件循环拉取执行。
二、推导与理解:请求到达时的执行步骤差异
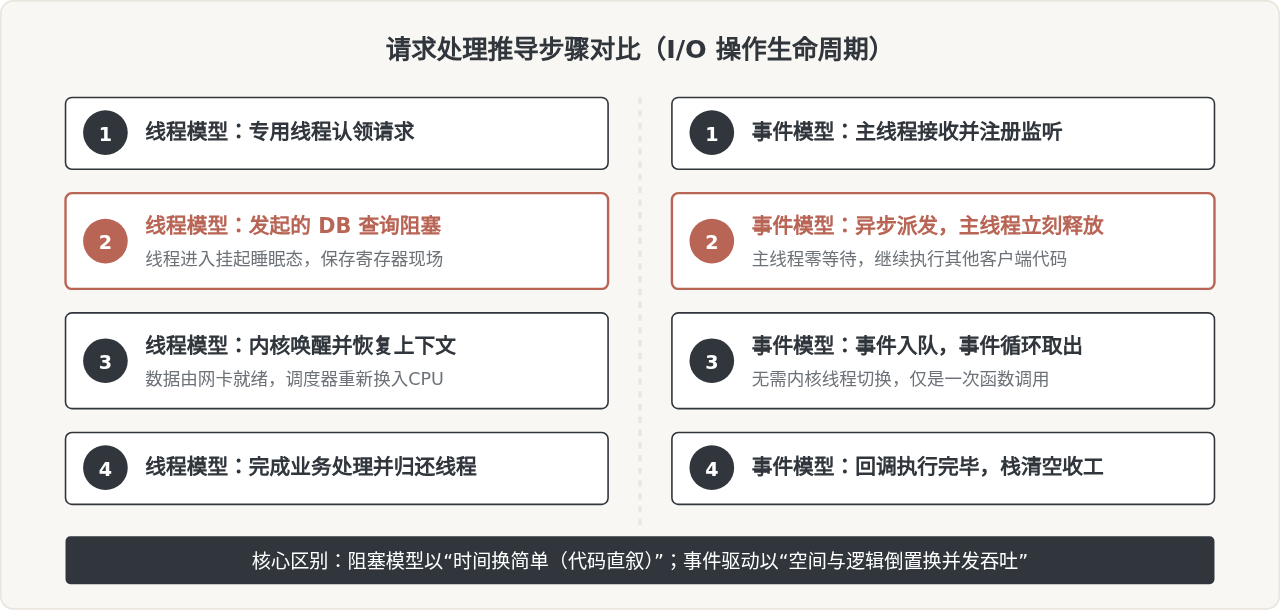
为了直观对比两种模型在实际服务中的工作方式,我们观察一个包含“读取网络数据、查询数据库、计算响应体并返回”的标准 Web 请求在两种环境下的推进步骤。
三、核心差异维度深度分析
1. 内存消耗与并发上限
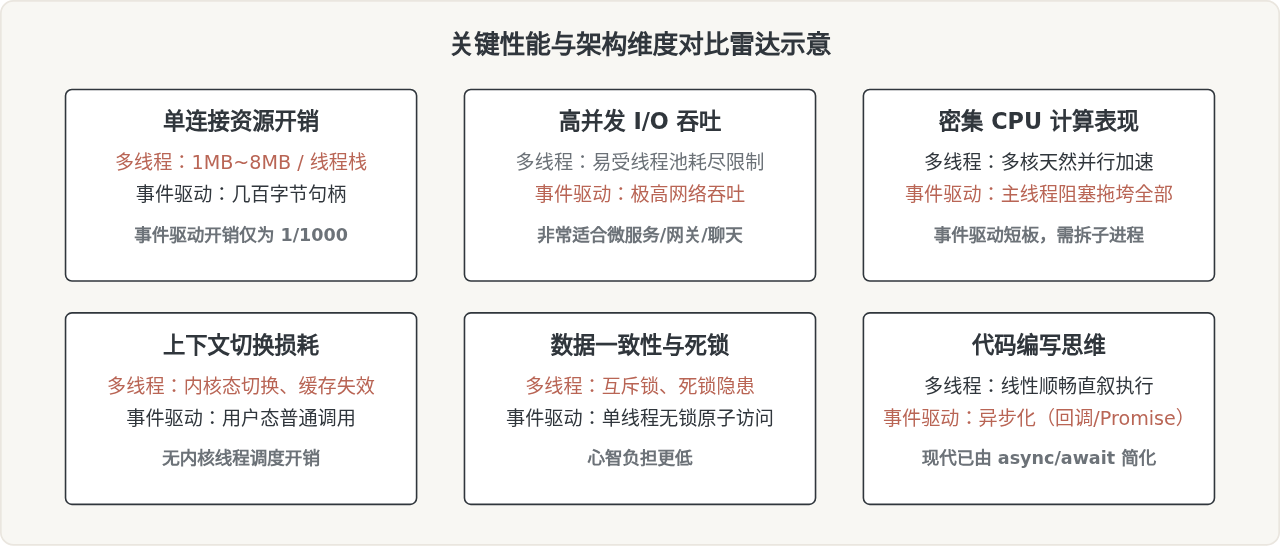
在多线程阻塞模型中,每一个并发连接必须对应一个操作系统线程。现代主流操作系统为每个线程分配的虚拟栈内存通常在 1MB 至 8MB 之间。当并发连接数达到数万时,仅线程栈内存开销就高达数十 GB,远超一般单机的承载上限,这就是经典的 C10K 问题。
而在 JavaScript 事件驱动模型中,一个长连接(如 WebSocket 或待决 HTTP 请求)在非活跃状态下,只表现为一个几十字节至几百字节的套接字描述符和闭包引用。单台机器使用事件驱动模型可以较为轻松地维持数万甚至数十万并发连接,内存开销呈数量级下降。
2. 上下文切换与 CPU 利用率
多线程环境下,当活跃线程数远超 CPU 核心数时,操作系统必须频繁在多个线程之间执行上下文切换。每次切换需要保存和恢复 CPU 寄存器、程序计数器,并导致 CPU 缓存(L1/L2/L3 Cache)以及 TLB(快表)失效。在超高并发的高压下,系统 CPU 时间大部分被内核态调度浪费,真正执行业务代码的有效 CPU 时间大幅下降。
JavaScript 的单线程执行栈在处理普通非阻塞任务时,不需要操作系统内核介入线程调度。回调函数在用户态空间中只是简单的函数调用,完全规避了跨线程上下文切换的昂贵代价,CPU 指令命中率高。
3. 共享状态与数据竞争
多线程并发访问共享内存时,极易产生竞态条件(Race Condition)。开发人员必须使用互斥锁(Mutex)、读写锁、信号量或原子操作来保护临界区。这不仅增加了编码心智负担,稍有不慎还会引发死锁、活锁或锁竞争导致的性能劣化。
JavaScript 单线程特性使得所有在主执行栈中运行的同步代码都天然具备互斥性。在一段同步代码执行期间,绝对不会有另一段代码并发修改当前堆中的同一个对象,因此无需使用互斥锁,彻底杜绝了多线程编程中的死锁和竞态条件。
四、代码示例与直观对照
下面通过具体伪代码示例,展示两种模型在代码实现结构上的根本差异。
1. 多线程阻塞模型代码(以类 Java 伪代码为例)
// 工作线程执行函数:每一个连接独占一个线程
public void handleClient(Socket socket) {
    try {
        // 1. 读取请求(若客户端迟迟未发,本线程在此阻塞挂起)
        byte[] requestData = socket.read();

        // 2. 查询数据库(向 DB 发出查询,线程再次阻塞挂起等待网络返回)
        UserData user = database.queryUser("SELECT * FROM users WHERE id = ?", requestData.id);

        // 3. 计算并输出响应
        byte[] response = renderHtml(user);
        socket.write(response);
    } catch (IOException e) {
        log.error(e);
    } finally {
        socket.close(); // 归还线程池
    }
}在上述代码中,socket.read() 和 database.queryUser() 均为同步阻塞调用。代码直观易读,行行连续,但若并发量骤增至 10,000,线程池资源耗尽后后续所有连接只能在操作系统队列中排队超时。
2. JavaScript 事件驱动非阻塞代码(Node.js 示例)
const http = require('http');
const db = require('./db');

const server = http.createServer(async (req, res) => {
    try {
        // 主线程发起数据库查询,并不会在此挂起等待底层网络传输
        // 主线程释放控制权,可继续处理其他到来的 HTTP 请求
        const user = await db.queryUser('SELECT * FROM users WHERE id = ?', req.userId);

        // 数据库返回数据后,回调作为微任务在事件循环中被拉取恢复
        const responseData = renderHtml(user);
        res.writeHead(200, { 'Content-Type': 'text/html; charset=utf-8' });
        res.end(responseData);
    } catch (err) {
        res.writeHead(500);
        res.end('Internal Error');
    }
});

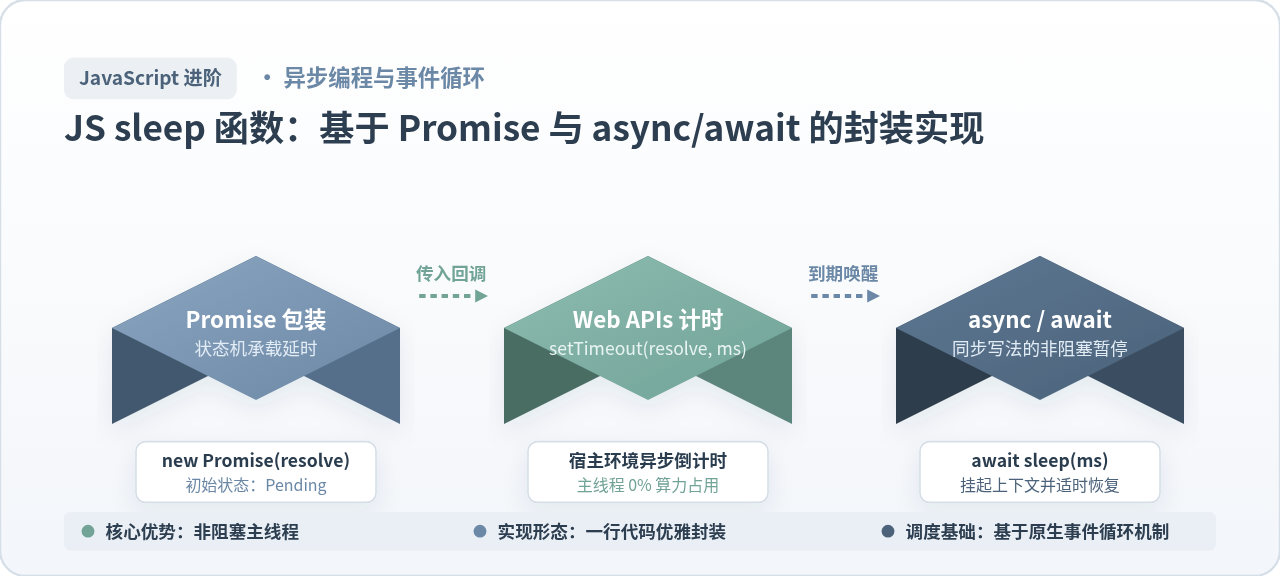
server.listen(3000);async/await 语法在表面上看起来像同步代码,但它的底层依然是将后续逻辑包装为 Promise 微任务推入微任务队列。主线程绝未被挂起,它依然在不间断地轮询处理其他事件。
五、综合对比与选型决策
为了帮助在实际技术架构中做出合理选型,下表对两种并发模型进行了综合对照:
| 对比维度 | JavaScript 事件驱动模型 | 传统多线程阻塞模型 |
|---|---|---|
| 并发实现载体 | 单主线程 + 事件循环 + 底层 I/O 多路复用 | 多操作系统线程(线程池模式) |
| 单任务内存占用 | 极低(每个任务仅几十到几百字节事件闭包) | 较高(每个线程通常需 1MB~8MB 栈内存) |
| C10K/C100K 支撑 | 极佳,原生适应海量轻量长连接 | 较差,易遭遇内存耗尽或调度风暴 |
| CPU 密集型任务 | 薄弱,计算任务会霸占主线程,阻塞所有后续请求 | 优秀,天然利用多核 CPU 分摊密集并行计算 |
| 数据锁与共享变量 | 无锁化,单线程同步片段原子执行 | 需使用互斥锁、读写锁、条件变量防范死锁 |
| 代码调试与异常追踪 | 异步调用栈容易丢失上下文(需要 async stack 支持) | 调用栈严格线性连续,排查与单步断点极其直观 |
六、总结与结语
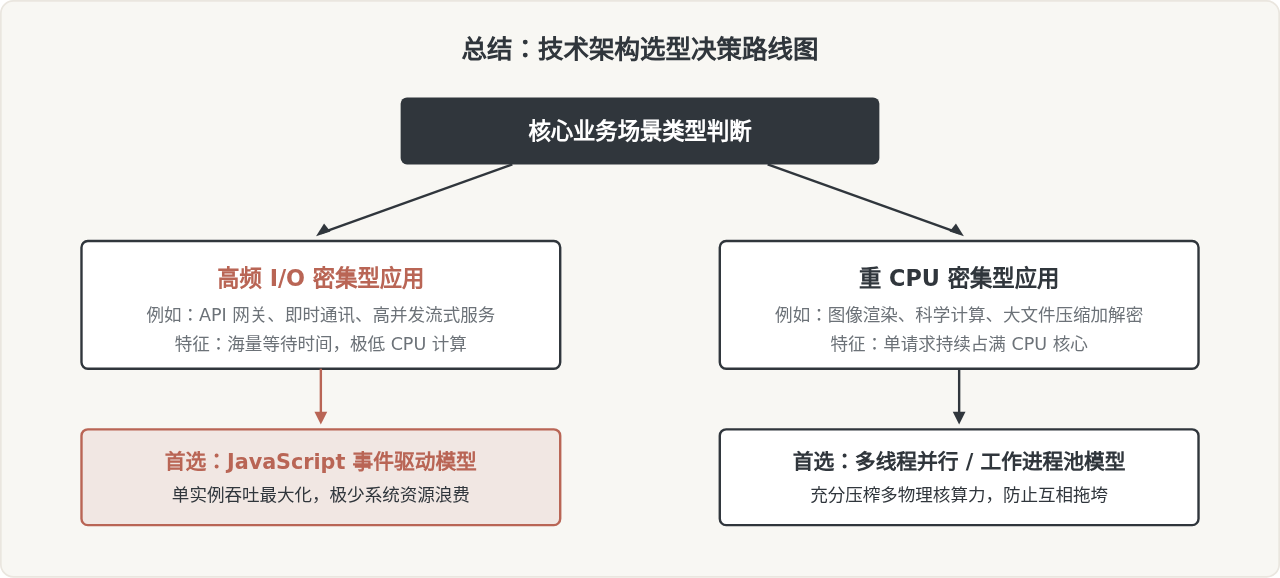
JavaScript 的事件驱动模型并非“银弹”,它用巧妙的非阻塞事件调度解决了传统多线程阻塞模型在面对海量 I/O 并发连接时资源过度浪费的问题,但代价是绝对不能在主线程中执行耗时计算,否则整个循环机制都会被锁死。而在需要强一致性内存共享或重度依赖 CPU 多核运算的领域,多线程及其进阶并发模型(如虚拟线程/协程)依然具备不可替代的优势。理解两者的本质差异,才能在系统设计与技术选型中做到因地制宜。
ES6模块化中js文件怎么用import和export交互
2026-11-05 17:00:48
JS读取本地文件时报错或无响应的常见原因
2026-11-05 16:32:31
let、const与var的区别:JavaScript变量声明最佳实践
2026-11-05 14:16:38
JS中直接定义静态二维数组的字面量写法
2026-11-05 14:16:08
JS 怎么查找字符串中所有匹配项的位置
2026-11-05 14:15:53
相关标签: