

Java和JavaScript在类型系统与编译机制上的核心区别
深入对比Java与JavaScript在类型系统与编译运行机制上的核心区别,剖析静态强类型与动态弱类型的行为差异,并解析JVM与现代JS引擎(如V8)的编译执行流水线。
一、核心维度总览:两套演化方向截然不同的技术基石
在很多初学者看来,“静态 vs 动态”和“编译 vs 解释”往往容易被混淆或过度概括。事实上,“类型系统”解决的是变量与值的类型约束在何时校验、如何转换的问题;而“编译机制”解决的是代码如何被转译为机器指令并投入执行的问题。
Java的设计初衷是构建跨平台、可预测、易于长期维护的大规模企业级应用,因此把类型约束前置在编译期,依靠严格的静态语法树分析拦截错误;JavaScript最初则是为了在浏览器中处理轻量级交互,追求“即改即刷、宽容容错”,因而把类型检查推迟到运行时,并在必要时进行激进的隐式类型转换。
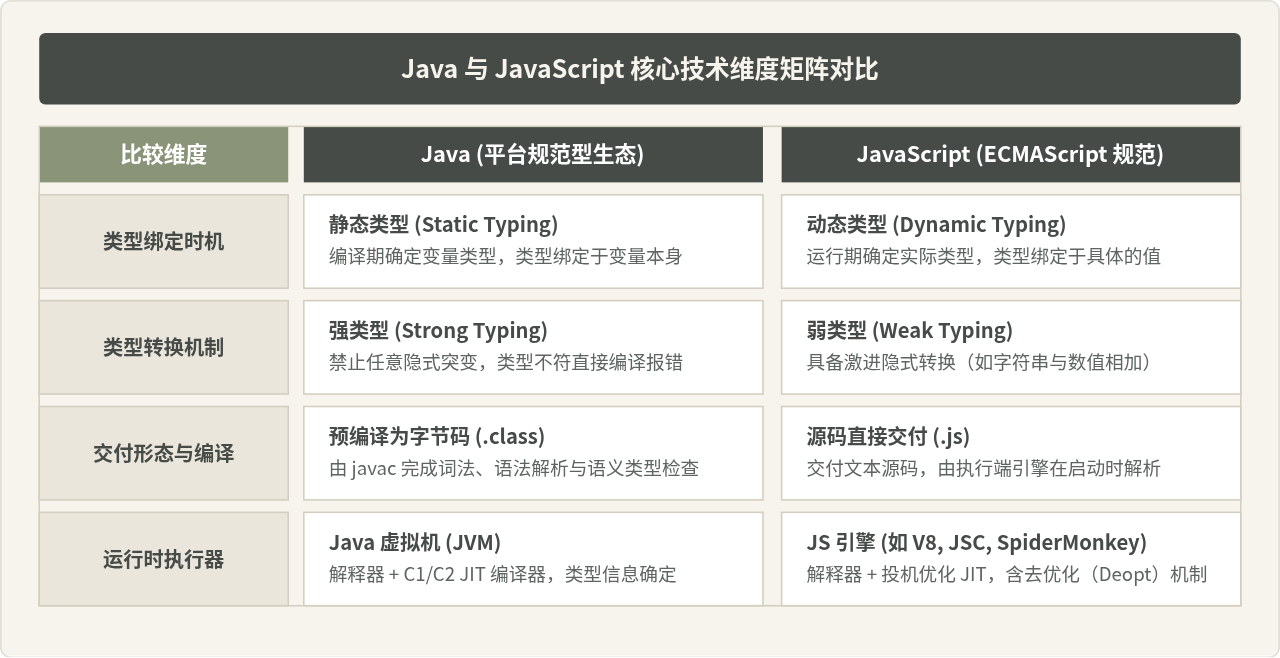
二、类型系统的核心区别:静态强类型 vs 动态弱类型
评估一门语言的类型系统,通常需要从两个正交的维度来审视:
1. 类型检查的时机(When):静态类型(Static Typing)在编译期检查,动态类型(Dynamic Typing)在运行期检查。
2. 类型转换的容忍度(How):强类型(Strong Typing)不允许偏离类型定义的隐式隐蔽转换,弱类型(Weak Typing)会在运行时静默地按规则强行转换操作数。
1. 静态绑定与动态推导的本质差异
在Java中,变量本身具有明确的类型槽位。当你在代码中声明 int counter = 10; 时,JVM与编译器就已经确认了内存中分配给该变量的具体规格(例如4字节带符号整数)。如果你试图把字符串赋值给它,编译器在生成任何字节码之前就会直接拒绝通过。
// Java 代码示例:静态类型强约束
public class TypeDemo {
    public static void main(String[] args) {
        int count = 42;
        // 编译错误:java: 不兼容的类型: java.lang.String无法转换为int
        // count = "hello";

        // 即使是 Java 10 引入的局部变量类型推断 var:
        var score = 100; // 编译期推断为 int
        // score = "A+"; // 同样编译报错!推断发生在编译期,它不是动态类型
    }
}反观JavaScript,变量只是一个对具体数值的无类型引用容器(Slot)。类型并不属于变量本身,而是属于当前被引用的具体值。因此变量可以在生命周期中随意指向不同类型的数据:
// JavaScript 代码示例:动态类型
let val = 42;        // 此时 val 引用一个 Number 类型值
console.log(typeof val); // 输出 "number"

val = "hello world"; // 合法,val 现在引用一个 String 类型值
console.log(typeof val); // 输出 "string"

val = { id: 101 };   // 合法,val 变成了引用对象
console.log(typeof val); // 输出 "object"
2. 强类型 vs 弱类型:隐式强制转换(Coercion)
“Java是强类型,JavaScript是弱类型”最直观的体现是在二元操作符上的行为表现。当两个不同类型的操作数相遇时,弱类型的JavaScript拥有非常复杂的隐式转换规则(ToPrimitive, ToNumber, ToString),而Java除了有限的字符串拼接重载和受限的数值拓宽(如 int 自动转 double)外,绝不容许类型混用。
// JavaScript 弱类型转换示例
console.log(1 + "2");      // 输出 "12"(数字 1 隐式转换为字符串 "1")
console.log("6" - 2);      // 输出 4(减号强制将字符串 "6" 转换为数值 6)
console.log("5" * "3");    // 输出 15(乘法强制将两边转换为数值)
console.log([] + {});      // 输出 "[object Object]"
console.log(true + 1);     // 输出 2(true 被转换为 1)
在Java中,加号 + 针对 String 进行了语法糖重载,但减号、乘法、除法以及不同引用对象之间绝对禁止此类运算:
// Java 强类型行为
System.out.println(1 + "2"); // 输出 "12",仅因为 String 定义了字符串连接规范
// System.out.println("6" - 2); // 严重编译错误:二元运算符 '-' 的操作数类型错误
// boolean flag = true;
// int result = flag + 1; // 严重编译错误:二元运算符 '+' 的操作数类型错误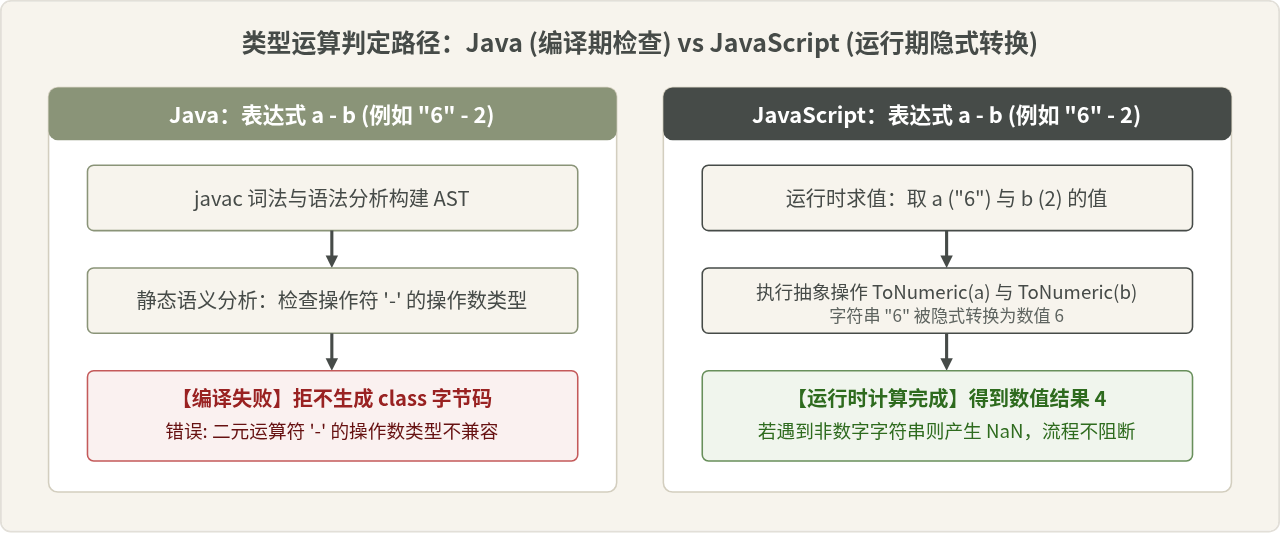
三、编译机制与执行模型:两阶段混合执行 vs 现代动态流水线
在传统认知中,常有“Java是编译型语言,JavaScript是解释型语言”的断言。这个说法在20年前大体成立,但在现代虚拟化与运行时优化技术高度成熟的今天,两者都早已采用“解释执行 + 即时编译(JIT)”的混合架构。它们的核心分歧,在于编译流水线起跑线的位置以及类型假设在JIT优化中的作用。
1. Java 的执行流水线:AOT 前置编译与确定性 JIT
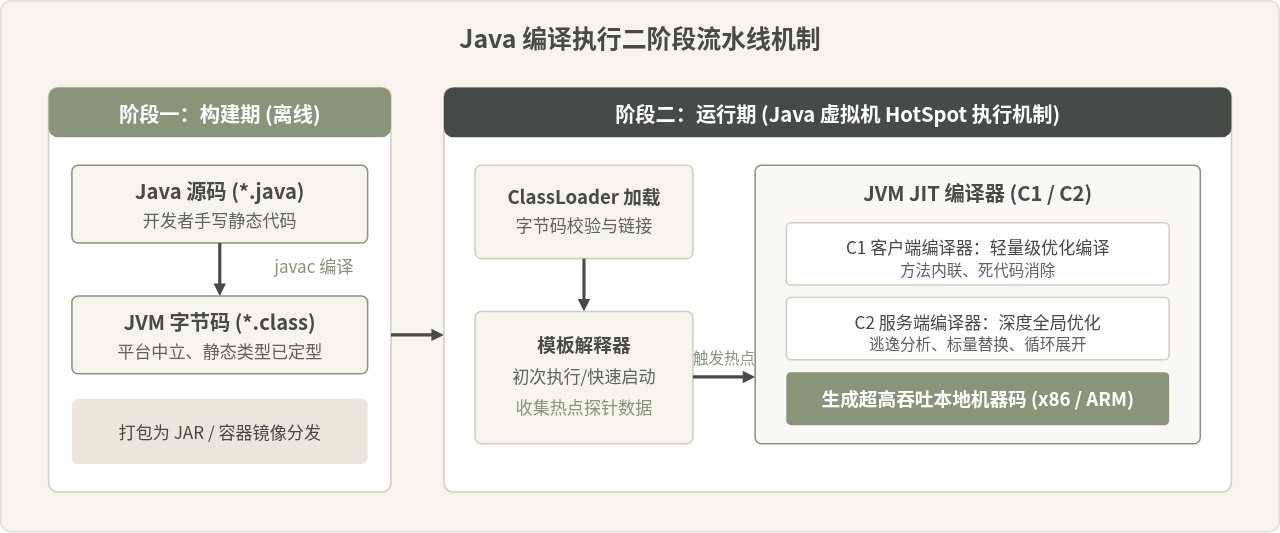
Java 的标准构建流程是两段式的:
第一阶段(构建期,离线进行):由 javac 编译器将 .java 源代码编译为符合 JVM 规范的 .class 字节码文件。字节码是一种与底层硬件无关、面向栈式抽象机的中间表示(IR)。在这一步,所有的静态语法检查、常量折叠、泛型擦除都已经定型。
第二阶段(运行期,线上进行):JVM 启动后,类加载器(ClassLoader)载入字节码,经过字节码验证(Bytecode Verifier)后,解释器开始逐行解释执行。随着程序运行,JVM 的性能计数器会监控方法的调用频次与循环回边。当某段代码被识别为“热点(Hotspot)”时,JIT 编译器(如 HotSpot 的 C1 Client 编译器和 C2 Server 编译器)介入,将字节码编译为底层 CPU 能够直接执行的纯本地机器码(Native Assembly)。
关键优势:因为 Java 字节码中包含了完全确定、受验证保护的静态类型签名,C2 编译器在生成机器码时,能够放心地使用确定性内存偏移(Offset)来访问对象字段,生成非常紧凑、高密度的本地汇编指令,无需担心类型突然发生改变。
2. JavaScript 的执行流水线:全运行时交付与投机式 JIT
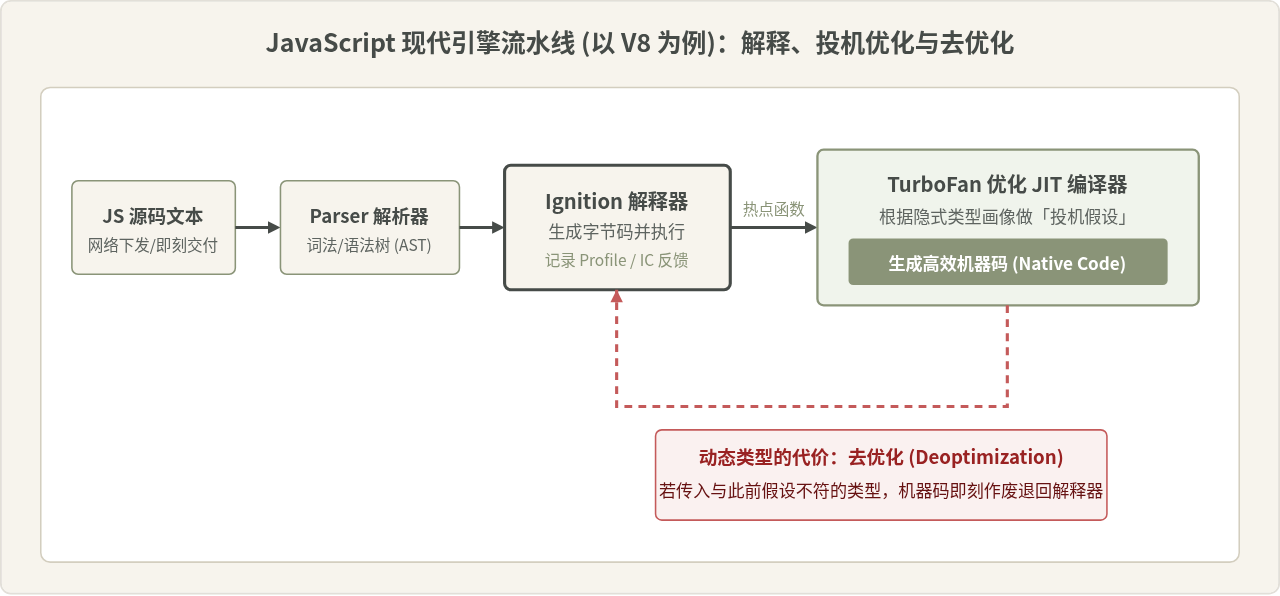
JavaScript 通常不经历类似 javac 那样的离线独立编译。网络上传输分发的是完全可读的纯文本源代码。以当今最具代表性的 Google Chrome / Node.js 的 V8 引擎为例,代码的编译与优化完全发生在客户端宿主内部,形成了一套充满“投机(Speculation)”与“回退(Deoptimization)”的精妙闭环:
第1步:源码解析与 AST 构建:Parser(解析器)对源码进行词法分析(Lexer)与语法分析,输出抽象语法树(AST),并建立变量作用域链。
第2步:生成字节码并解释执行:Ignition(解释器)将 AST 快速转化为内部字节码,并立即启动执行。由于无需等待耗时的机器码编译,JavaScript 的首屏启动时间极短。
第3步:内联缓存(Inline Caches, IC)与类型画像反馈:在解释执行过程中,Ignition 会持续收集类型反馈信息(Type Feedback)。如果某个函数的参数总是传入同一形状(Shape / Hidden Class)的对象,反馈向量(Feedback Vector)就会将此函数标记为“单态(Monomorphic)”。
第4步:投机性 JIT 编译(TurboFan):优化编译器 TurboFan 提取热点函数及其类型画像,假定以后的调用也永远符合当前类型,直接编译出极致优化的本地机器码,消除了原本每次都要查找属性偏移的动态开销。
第5步:类型失配与去优化回退(Deoptimization):因为 JavaScript 是动态弱类型语言,开发者随时可能向该优化函数传递一个全然不同的类型(例如原本传入的是整型,突然传入了一个字符串或新属性结构的对象)。此时,编译生成的机器码保护守卫(Check Maps)失败,引擎必须立即中止机器码执行,进行去优化(Bailout / Deopt),将堆栈状态原封不动地还原回解释器字节码继续执行。
四、关键细节与误区辨析:代码实测中的性能与行为陷阱
1. 为什么“动态类型”在 JIT 时代依然会影响运行效率?
有人认为:“既然现代 JavaScript 引擎都有 JIT 编译器,能生成和 C/Java 类似的本地机器码,那么两者的执行效率应该没有差别。”这种看法在理论上看似成立,但在实际工程中往往不攻自破。
根本原因正是在于类型的确定性与多态开销。在 Java 中,一个类的内存布局在编译期和类加载期就完全固化了。访问一个对象的字段 user.age,底层只需一条 mov eax, [rcx + 16] 的内存偏移指令,寻址耗时极其确定。
而在 JavaScript 中,对象本是一个可以随时增删键值的动态哈希字典。为了接近 Java 的访问速度,引擎发明了隐藏类(Hidden Class,V8中称为 Map)机制:如果两个对象以完全相同的顺序初始化相同的字段,它们会共享同一个 Hidden Class。
// 编写友好单态代码:字段结构严格保持一致
function Point(x, y) {
    this.x = x;
    this.y = y;
}
const p1 = new Point(1, 2); // 具有稳定的隐藏类 MapA
const p2 = new Point(3, 4); // 共享 MapA,JIT 可以生成极速的单态内联缓存

// 破坏 JIT 优化的不良写法:动态添加属性或改变顺序
p2.z = 5; // 导致 p2 的隐藏类突变为 MapB,破坏单态性!
如果一个函数被频繁传入不同结构的对象(多态或超多态),TurboFan 编译生成的机器码将无法做单态假设,甚至引发去优化回退,重新回到慢速的解释执行模式。
2. 静态检查的边界:编译通过并不等于运行时绝对类型安全
初学者也容易产生另一个极端认识:“Java 既然是静态强类型,那么编译通过后运行时就绝不会出现任何类型错误。”这也是不严谨的。
Java 的类型系统虽然严密,但在以下场景中依然需要在运行时进行动态类型校验,若使用不当会抛出运行时异常:
- 显式强制向下转型(Downcasting):当父类引用强制转换为子类类型时,编译器允许书写,但如果在运行时对象真实类型不匹配,JVM 会在运行时抛出 ClassCastException。
- 泛型类型擦除(Type Erasure):Java 的泛型只存在于源码编译期。在字节码中,List<String> 和 List<Integer> 的原生类型都是 List。如果绕过类型安全检查(如通过反射或原始类型 raw type),可能会将错误类型的对象放入集合中,直到取出取值转换时才在运行时崩溃。
- 数组协变(Array Covariance):Java 中 String[] 可以隐式赋值给 Object[],但在运行时若向其中存放一个整数,JVM 会动态抛出 ArrayStoreException。
| 特性指标 | Java (静态强类型) | JavaScript (动态弱类型) |
|---|---|---|
| 类型检查时刻 | 编译期 (javac) 严格检查,类型与变量绑定 | 运行期通过值动态判断,变量无固定类型 |
| 隐式转换强度 | 极度克制,仅限基本数值提升与受限 String 拼接 | 非常宽松,存在 ToPrimitive、ToNumber 等复杂转换 |
| 交付分发物 | 编译后的二进制 .class 字节码或归档包 |
UTF-8 纯文本源代码字符串(.js) |
| 启动延迟 | 需要加载 JVM、加载类并进行验证,冷启动偏重 | 源码即时分发,解释器瞬间就绪,首屏冷启动极快 |
| 峰值吞吐算力 | 极高。类型信息固定,C2 JIT 可实施深度激进优化 | 高。但受动态特性约束,存在去优化及垃圾回收波动 |
| 工程维护复杂度 | 代码重构有强大的 IDE 语义分析与编译屏障保障 | 自由度极高,但在复杂项目通常需配合 TypeScript 补充约束 |
五、总结:如何理解两者的设计取舍
通过上述对比可以看出,Java 和 JavaScript 在类型系统与编译机制上的差异,本质上是“可预测性与工程约束”与“开发敏捷度与启动响应速度”之间的权衡抉择。
Java 宁可在构建阶段消耗更多编译时间、强制开发者编写严谨显式的类型声明,也要换取大型分布式系统在数月、数年后演进时的类型安全边界与超高的长周期稳态吞吐吞吐量。
JavaScript 则诞生于互联网交互的前沿,它通过省略前置编译阶段,实现了网络直发、开箱即行与极速首屏反馈,并在弱类型与动态对象的灵活性中释放了高度的表达力。尽管现代 JavaScript 引擎通过复杂的投机 JIT 编译器无限逼近原生编译语言的性能,但其内在的动态机制依然深刻影响着内存利用率与优化确定性。理解这些底层机制,能够帮助开发者在编写两种语言时,真正做到知其然并知其所以然。
JS空字符串、null和undefined转数字的结果是什么
2026-11-05 14:49:16
CodePen、JSFiddle与StackBlitz:主流JS在线编辑器对比
2026-11-05 13:38:29
JS怎么将时间戳转换为“刚刚”、“几分钟前”等相对时间
2026-11-05 12:55:14
JavaScript将儒略日逆向还原为公历日期时间的实现方法
2026-11-04 23:51:05
能在我的世界手机版直接修改JS代码吗
2026-11-04 19:02:53







