

现代浏览器原生JS API能否替代第三方函数库?兼容性分析与选型建议
深入分析现代浏览器原生JavaScript API替代Lodash、Axios、jQuery等第三方函数库的可行性、兼容性边界与技术选型建议。
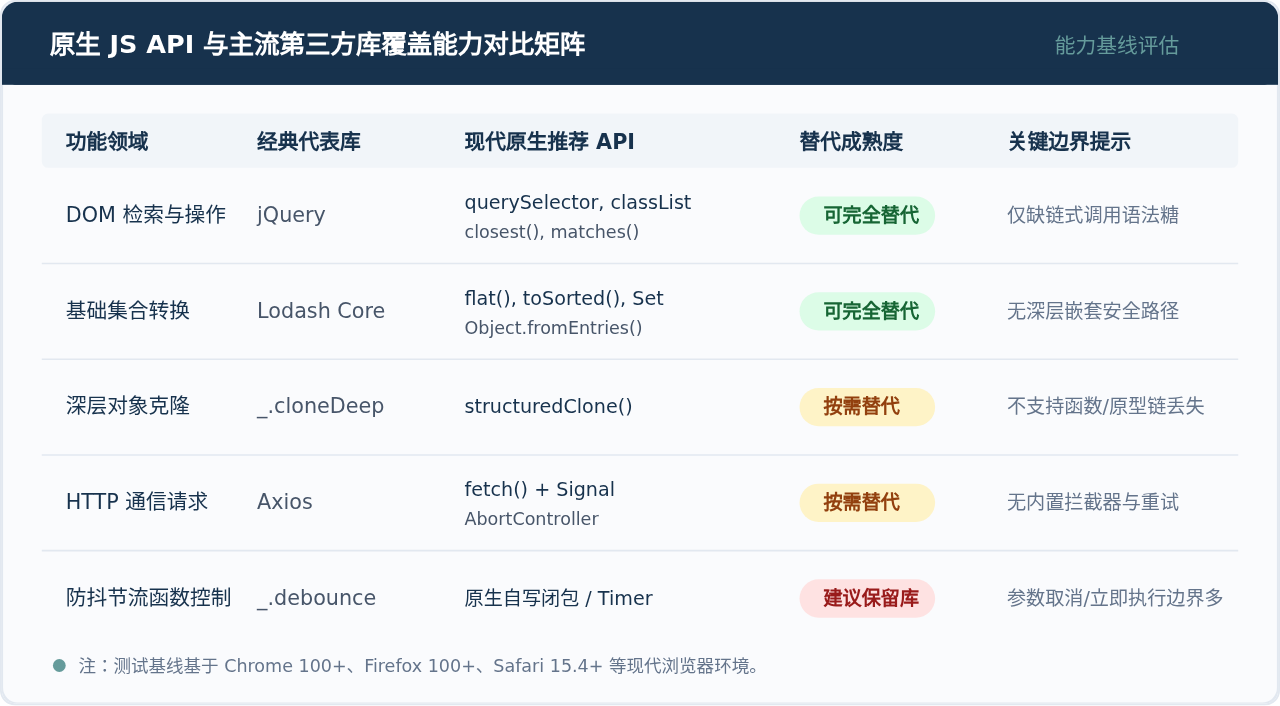
在当前主流现代浏览器环境中,原生 JavaScript API 已经具备了替代绝大多数基础第三方库(例如 jQuery、Lodash 基础集合方法、部分 Axios 请求场景)的能力。然而,这种替代并不是非黑即白的彻底抛弃,而是在深拷贝类型支持、高频防抖节流函数、网络请求拦截恢复以及特定运行宿主环境下存在明确的边界差异。本文将直接梳理常见替代方案、剖析无法完全替代的关键限制,并给出可落地的技术选型与渐进迁移建议。
一、原生API典型替代场景与实现对比
随着 ECMAScript 规范的持续演进和现代浏览器对 Web API 的全面支持,许多曾经必须借助第三方库才能解决的繁琐操作,现在仅需一行原生代码即可标准执行。
1. DOM 操作与选择器:全面告别 jQuery
在过去,jQuery 凭借平滑的 DOM 操作与跨浏览器兼容性几乎成为前端标配。但在当今主流浏览器中,原生 DOM API 已非常成熟:
- 元素查找:使用
document.querySelector与document.querySelectorAll完全可以替代$()的绝大多数 CSS 选择器用法。 - 样式类与属性:
element.classList.add / remove / toggle提供了直观且高效的类名控制能力,替换了addClass / removeClass。 - 节点遍历与匹配:
element.closest(selector)能够直接查找距离最近的祖先匹配项,与element.matches(selector)配合即可完全胜任事件委托。
2. 集合与数据处理:替代绝大部分 Lodash 基础操作
早期开发者依赖 Underscore 或 Lodash,主要是因为旧版 JavaScript 缺失数组与对象的常用处理方法。如今标准规范已补齐这些短板:
- 嵌套拍平与映射:
Array.prototype.flat()与flatMap()替代了_.flatten和_.flatMap。 - 无副作用排序与翻转:ES2023 引入的
toSorted()、toReversed()和toSpliced()能够直接返回新数组,避免了手动拷贝再排序的样板代码。 - 键值对转换:
Object.entries()与Object.fromEntries()形成了完整的对象与二维键值数组互相转换闭环,轻松替代_.toPairs与_.fromPairs。 - 数组去重与交并集:使用
Array.from(new Set(arr))或最新的Set.prototype.intersection等集合运算,不再需要额外引入大型函数库。
3. 网络请求:原生 Fetch API 替代基础 Axios
对于大部分 RESTful 数据查询和提交,原生 fetch() 配合 AbortController 与 URLSearchParams 已经可以取代 Axios:
// 原生 Fetch 请求与超时取消示例
const controller = new AbortController();
const timeoutId = setTimeout(() => controller.abort(), 5000); // 5秒超时

async function fetchUserData(userId) {
  try {
    const params = new URLSearchParams({ id: userId, format: "detailed" });
    const response = await fetch(`/api/user?${params.toString()}`, {
      method: "GET",
      headers: { "Accept": "application/json" },
      signal: controller.signal
    });

    if (!response.ok) {
      throw new Error(`HTTP 异常状态码: ${response.status}`);
    }
    const data = await response.json();
    return data;
  } finally {
    clearTimeout(timeoutId);
  }
}
二、原生方案不可忽视的四大边界与坑点
盲目移除第三方库常常会在真实业务中引发隐藏故障。理解以下四个维度的差异与限制,是做出合理选型决策的前提。
1. 深拷贝的盲区:structuredClone vs lodash.cloneDeep
现代浏览器提供了原生的 structuredClone(),它基于结构化克隆算法,支持循环引用、Map、Set、Date、RegExp、ArrayBuffer 等复杂数据类型。然而,它并不是 lodash.cloneDeep 的完全替代:
- 函数与方法报错:如果对象属性包含函数(方法)或 DOM 节点,
structuredClone()会直接抛出DataCloneError异常,而 Lodash 则会忽略函数或复制引用。 - 原型链丢失:克隆后的对象原型总是普通
Object,无法保留自定义类(class)实例的原型和继承关系。 - Symbol 属性丢失:以
Symbol为属性键的字段会被直接忽略。
2. 网络请求与异常机制:Fetch 的隐性陷阱
很多初学者从 Axios 迁移至 fetch 时容易忽略状态码与拦截逻辑:
- 4xx / 5xx 状态不触发 Reject:只要服务器有网络返回,即便状态码是 404 或 500,
fetch()返回的 Promise 依然是resolve状态。必须手动检查response.ok。 - 无开箱即用的拦截器:统一注入 Token、自动刷新过期认证、接口签名等功能,原生 API 需要自行基于高阶函数封装。
- 上传进度与重试:监控文件上传百分比在 Fetch 中无法直接读取(需配合 Streams API 且较为繁琐),缺少类似 Axios 的
onUploadProgress钩子。
3. 函数频率控制:自写 Debounce / Throttle 的维护成本
原生 JavaScript 语言并没有内置 debounce(防抖)或 throttle(节流)。虽然简单版本只有十几行闭包代码,但企业级业务常需要:
- 首次立即触发(leading 选项)与尾部触发(trailing 选项);
- 支持手动取消待执行任务(
cancel方法)与立即刷新执行(flush方法); - 在 React/Vue 组件卸载时的定时器销毁与闭包内存泄露防范。
自行维护此类底层通用工具往往会导致各个业务线实现不统一,因此这类场景更推荐使用轻量级微库。
4. 宿主环境基线与兼容性差异
尽管桌面端现代浏览器更新迅速,但在特定混合移动端(如企业微信内置旧版 WebView、老旧 Android 工业终端机、海外低端手机)中,类似 toSorted()、Array.prototype.at() 等特性可能并不存在。如果未配置完整的 Polyfill 体系,直接使用原生新语法可能导致线上白屏。
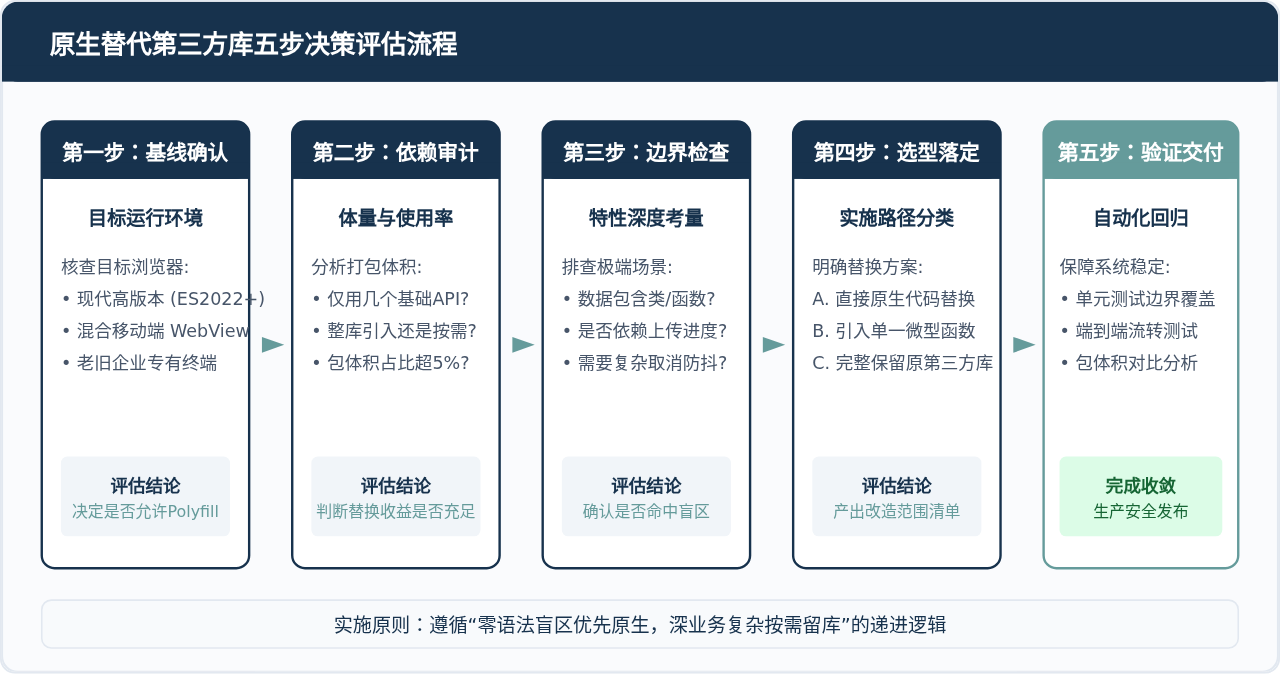
三、渐进式迁移与落地步骤
如果现有项目中引入了较多体积庞大的第三方库,一次性全面重构往往风险较高。推荐采用分层渐进式的迁移策略。
步骤一:使用依赖分析工具完成全量审计
在项目中执行打包分析(例如 webpack-bundle-analyzer 或 Rollup/Vite 的 rollup-plugin-visualizer),明确以下指标:
- Lodash / Axios / Moment 等工具库所占整体产物构建体积的绝对大小;
- 是否存在重复引入(例如主工程和子依赖各自引入了不同版本的 Lodash);
- 通过全局搜索确认实际调用的方法集合,建立“使用频率与依赖深度清单”。
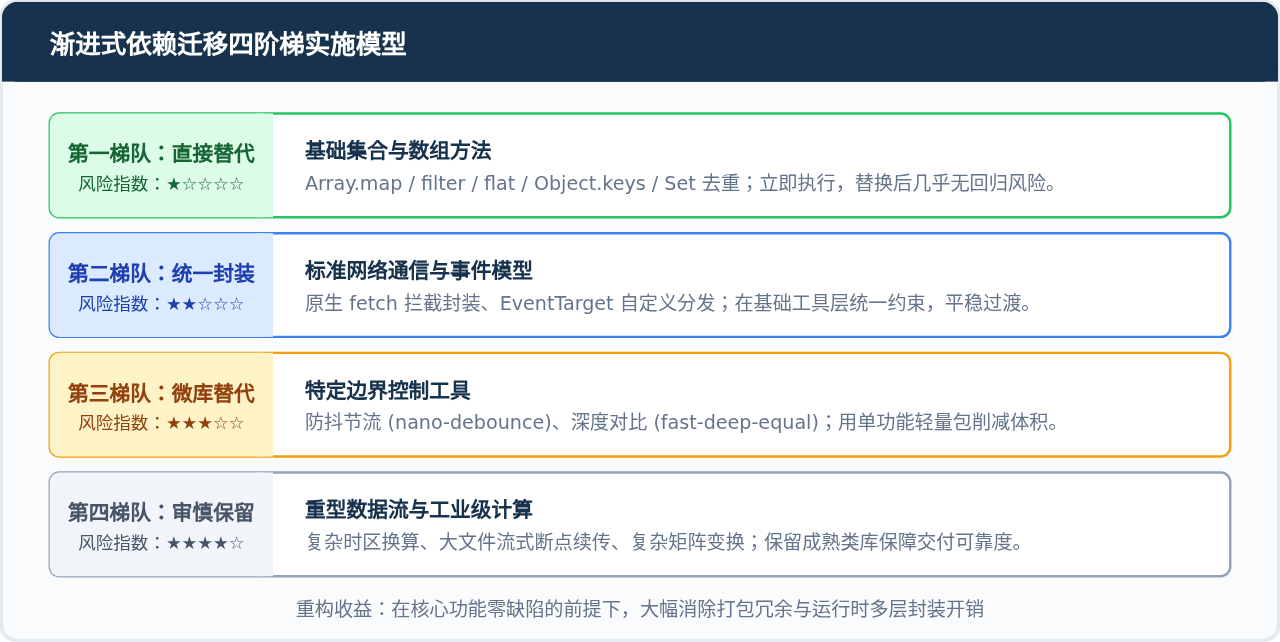
步骤二:划分迁移梯队,遵循先易后难原则
将依赖分为四个阶段推进:
- 第一梯队(安全直接替换):将
_.map、_.filter、_.find、_.includes、_.keys等基础集合遍历直接重写为原生数组/对象方法。此阶段几乎没有任何逻辑风险。 - 第二梯队(标准封装替换):基于
fetch编写统一的基础请求封装模块,把通用的 Header 注入与业务错误码解析收拢在少数几处工具函数中。 - 第三梯队(微库定向替代):若项目中仅使用了深拷贝或防抖节流,可使用体积仅几百字节的单一功能包(如
nano-debounce、fast-deep-equal)替代整个庞大的工具库。 - 第四梯队(复杂业务保持原样):如果业务涉及复杂图表计算、大数据深度比对或定制化请求链路,继续保留经过充分验证的第三方库,不为“纯原生”而冒险重写。
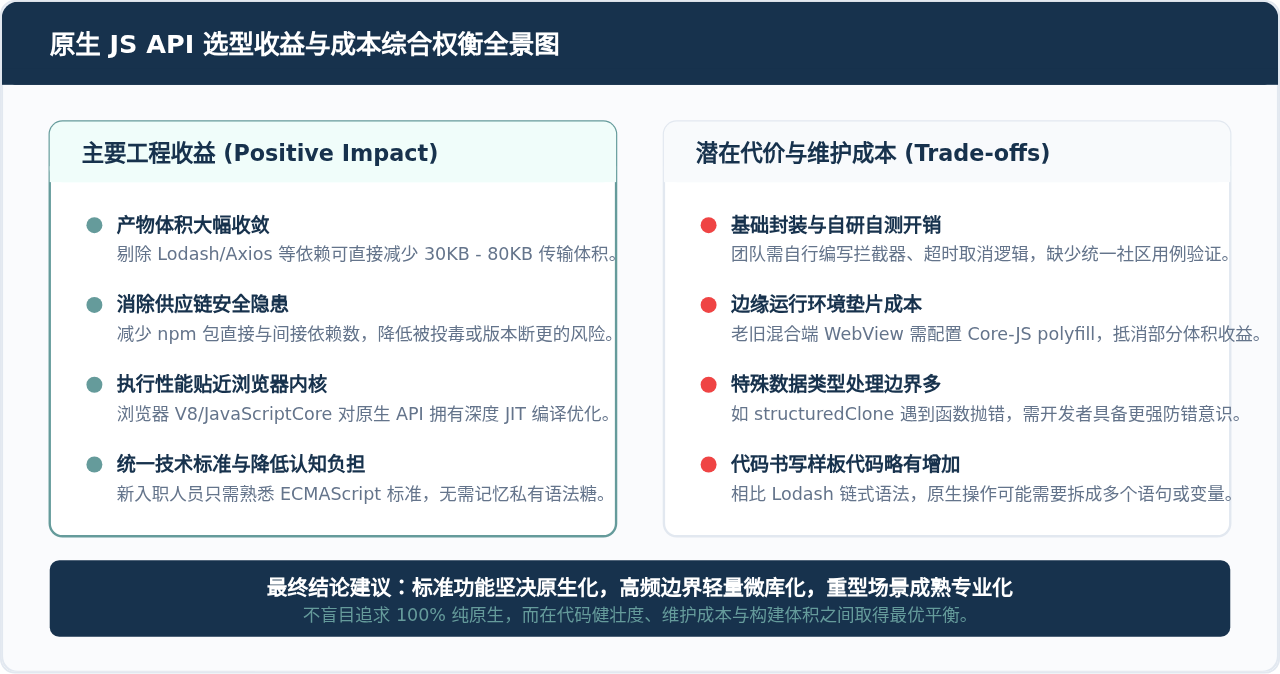
四、具体项目选型建议与落地策略
结合团队规模、业务形态与维护周期,建议采用差异化的选型策略:
| 业务场景分类 | 运行环境特征 | 推荐技术选型方案 | 核心选型理由与注意事项 |
|---|---|---|---|
| 轻量前端活动页 / 移动端营销 | 现代主流移动浏览器为主,对首次加载包体积极度敏感 | 坚决使用纯原生 JS API(禁用 Lodash、Axios) | 网络请求直接用原生 Fetch,利用纯原生代码大幅削减体积,缩短首屏白屏时间。 |
| 中后台管理系统 / 企业内部 SaaS | 目标浏览器统一(如统一为 Chrome 105+ 或 Edge) | 全面原生化 + 轻量专用微库 | DOM 与数据集合全部采用原生;对于深拷贝若无类实例直接用 structuredClone,请求层统一轻封装。 |
| 大型复杂平台 / 长期演进核心产品 | 数据结构深度嵌套、多端嵌入(含旧宿主 WebView) | 基础层原生化 + 核心边界保留成熟库 | 使用 Lodash 的单方法按需引入(或改用 Radash/ES-Toolkit),保留成熟的 Axios 处理多层重试与拦截器。 |
| 公共基础 SDK / 第三方 NPM 组件库 | 宿主无法预知,代码体积和依赖侵入性要求极高 | 零第三方运行时依赖(Zero Dependencies) | SDK 不应绑架宿主工程的依赖版本,所有集合转换与请求均基于原生 API 或内联纯函数编写。 |
五、常见疑问与实战答疑
Q1:既然已有 structuredClone,是否永远不需要引入深拷贝库?
并非如此。如果你的数据源是纯 JSON 数据(来自后端接口返回的简单数据实体),structuredClone 表现非常优异,且支持循环引用;但如果你的数据结构中挂载了类方法、Vue/React 的响应式代理对象(Proxy)或 DOM 句柄,structuredClone 会直接中断抛错。在富客户端应用开发中,面对复杂对象图时,轻量级深拷贝库依然具有更宽松的容错性。
Q2:现有成熟老项目中,是否值得专门花时间把 Lodash 全部清洗掉?
通常不建议无条件全面重写。对于稳定运行的遗留项目,全部替换带来的业务产出不明显,反而可能因为边界细节引发线上回归。合理的实践是:在工程中配置 ESLint 规则(例如 eslint-plugin-you-dont-need-lodash-underscore),禁止在新增代码中调用无必要的第三方辅助函数,对老代码采取“改到该模块时再顺手重构”的渐进更新策略。
Q3:如何防止开发者误用尚未普及的实验性原生新 API?
依靠代码评审往往会遗漏细节。最有效的方式是在工程中明确配置 browserslist 声明目标环境,并配合 ESLint 的 eslint-plugin-compat。它会在编译期静态扫描你的代码,如果发现调用的原生 API 在目标浏览器清单中支持率不足,会在提交时给出明确警告并阻断构建。
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02
p5.js 中 setup() 和 draw() 函数的执行机制详解
2026-11-05 12:32:38







