

JavaScript基本数据类型存栈还是堆?按值传递机制解析
深入解析JavaScript基本数据类型在内存中的实际存储位置(栈与堆的区别),结合V8引擎底层优化、闭包影响,彻底理清基本类型与引用类型的按值传递机制。
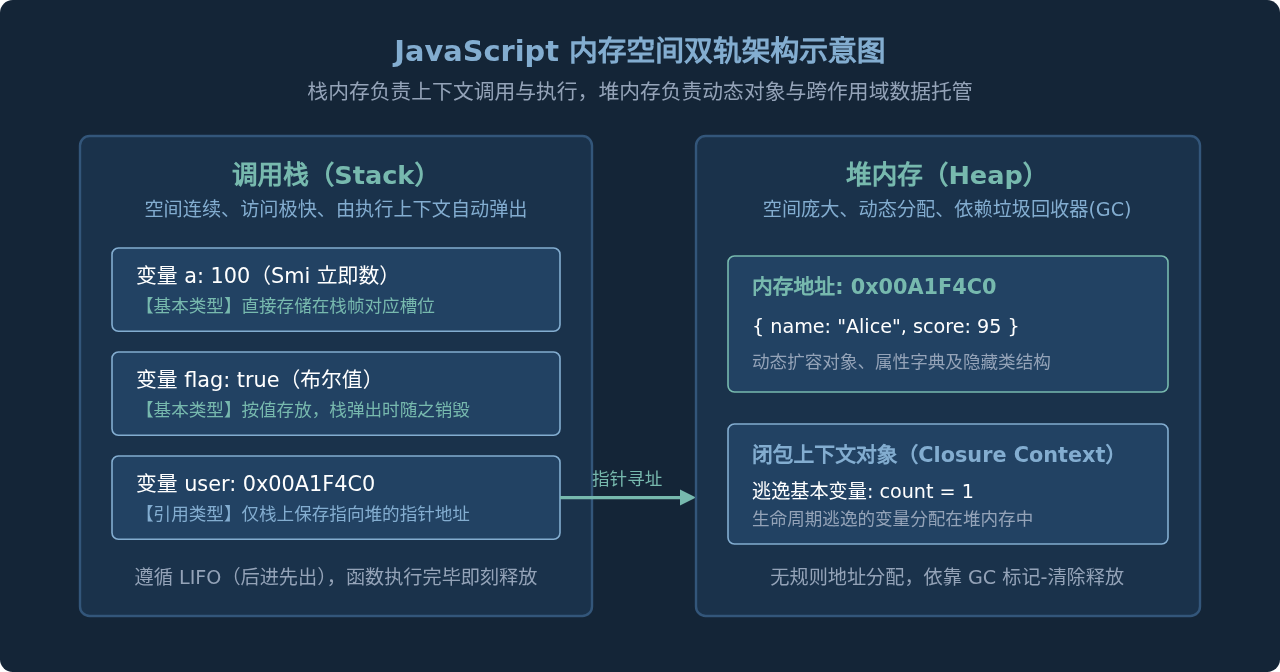
在日常JavaScript开发中,我们常听到“基本类型存栈中、引用类型存堆中”的传统说法。然而在实际运行环境(如Chrome V8引擎)中,这个结论并不完全准确。简而言之:在语言规范层面上,变量直接持有基本类型的实际值,持有引用类型的内存地址引用;而在现代引擎底层,局部小整数与布尔值等会直接内联存放在执行栈中,但被闭包引用的基本类型、长字符串(由于不可变与字符串池机制)以及逃逸变量均会被存放在堆内存中。理解这种差异,不仅能解决面试常考的内存分配问题,更能彻底厘清JavaScript中一贯的“按值传递”运作本质。
一、内存模型基石:规范语义与物理实现
设想一个典型场景:我们定义了一个简单的数字变量 let age = 18;,在某个函数内部它执行完毕即释放,但在另一个返回的闭包函数中,它却能持久存在。很多开发者因此困惑:为什么同一个基本数据类型,有时随着调用栈弹出销毁,有时却依然存活?
要搞清“存栈还是堆”,首先要区分ECMAScript规范抽象与JavaScript引擎底层物理实现:
- 语言规范层:ECMAScript规范只定义了环境记录项(Environment Record)和数据类型(Undefined、Null、Boolean、Number、BigInt、String、Symbol)。规范根本没有出现“调用栈”或“堆内存”这两个硬件视角的词汇。
- 引擎实现层(以V8为例):为了追求极致执行性能,引擎通常将当前执行上下文的固定尺寸变量分配在物理执行栈(Stack)上;而变长数据或生命周期超出当前执行栈的数据,则统一分配在堆(Heap)中由垃圾回收器(GC)管理。
二、基本数据类型究竟存哪?打破“绝对存栈”的迷思
教科书通常将 number、boolean、null、undefined、symbol、bigint 列为栈存储,而将 Object、Array、Function 列为堆存储。但在现代化引擎中,基本数据类型是否进栈取决于其生命周期与引擎的数据表示策略。
1. V8的小整数指针标记(Pointer Tagging / Smi)
在V8中,数值并不都作为独立的浮点数对象保存。对于常用的31位或32位有符号小整数(Small Integer,简称 Smi),V8采用指针标记技术直接将整数值嵌入在指针槽位内部(最低位为0),完全不额外分配堆内存,伴随栈帧分配与注销。
2. 闭包场景下的逃逸分析与堆分配
当一个函数返回了内部函数,并且内部函数引用了外层函数的局部基本类型变量时,该变量就发生了“逃逸”。此时如果依然放在调用栈上,当外层函数执行完毕出栈后,内存被回收,内部函数调用时就会产生野指针或无法读取的情况。
function createCounter() {
  let count = 0; // 基本类型 number
  return function() {
    count++;
    return count;
  };
}
const counter = createCounter();
console.log(counter()); // 输出: 1
console.log(counter()); // 输出: 2在上述代码中,count 虽然是基本类型 number,但 V8 编译器在词法分析和逃逸分析时发现该变量会被跨作用域捕获,因此会直接在堆上创建一个闭包上下文对象(Context Object),将 count 提升并存放在堆中。外层函数出栈后,count 依然由堆上的 Context 保留,直到不再有引用时由 GC 清理。
3. 字符串(String)的特殊性
在规范定义中,string 是绝对的基本数据类型。但在引擎底层,字符串是变长且不可变(immutable)的。短字符串可能通过哈希去重存入字符串常量池(String Table),长字符串(如包含几万字符的文章)则由堆内存的 SeqOneByteString 或 ConsString 等对象结构来表示。变量持有的是该字符串在堆内的引用或句柄。
技术总结:未逃逸的局部变量(如常规数值、布尔值)分配在执行栈;被闭包引用、作为对象属性、或超长字符串等,无论其类型多么基础,均存放在堆内存中。
三、核心机制:JavaScript 只有“按值传递”
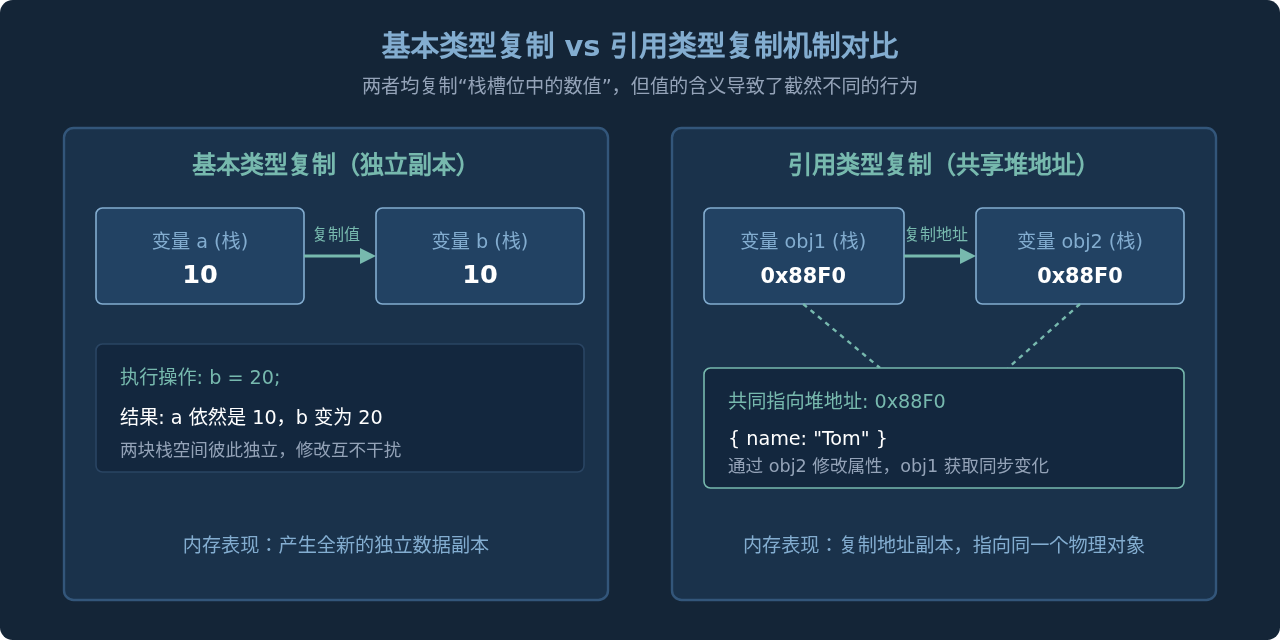
许多初学者会产生一个常见误解:“JavaScript中基本类型按值传递,引用类型按引用传递”。这是对计算机体系结构术语的混淆。在规范层面,JavaScript 只有一种传递方式——严格按值传递(Pass by Value)。
之所以让人产生“按引用传递”的错觉,是因为对象在栈中保存的“值”本身就是一个内存地址。复制或传递对象时,复制的是这个地址值,而不是把对象的内存空间按引用绑定。
四、函数调用传参:逐步推导演练
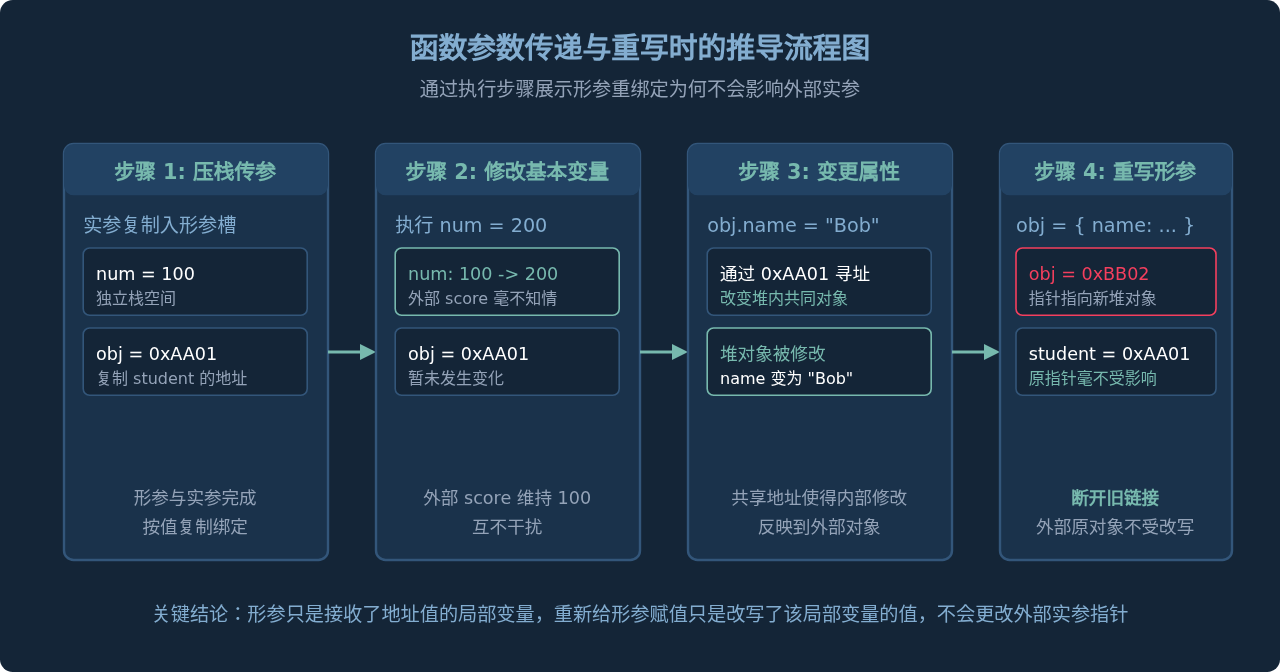
为了证实“只有按值传递”,我们通过一段最具代表性的参数重绑定代码进行分步推导:
function modify(num, obj) {
  num = 200;                    // 步骤1:重新赋值基本类型形参
  obj.name = "Bob";             // 步骤2:修改对象内部属性
  obj = { name: "Charlie" };    // 步骤3:重写形参引用
}

let score = 100;
let student = { name: "Alice" };

modify(score, student);

console.log(score);        // 输出: 100
console.log(student.name); // 输出: "Bob"(而非 "Charlie")
如果 JavaScript 存在真正的“按引用传递”,那么 obj = { name: "Charlie" } 将会把外部 student 的绑定目标直接改写为新对象。但实际输出却始终为 "Bob"。下面详细分解函数执行时的每一步动作:
五、开发中防范“共享引用”的实用技巧
理解了按值传递机制后,我们在开发中就能准确规避许多因为“意外共享引用”导致的数据污染与Bug:
- 编写纯函数(Pure Functions):在业务函数内部不要直接通过形参修改传入对象的属性(Mutation)。如果需要变更,应返回浅拷贝或深拷贝后的新对象。
- 浅拷贝防御:对于单层对象,使用对象解构
const safeObj = { ...originObj }或Object.assign({}, originObj)能够断开顶层属性的引用联系。 - 深拷贝策略:若对象包含嵌套结构,浅拷贝的内层属性依然是引用拷贝。推荐使用现代浏览器原生支持的
structuredClone(data),或使用稳定的深拷贝工具,阻断多层对象的意外串扰。
六、知识总结与概念判定对照
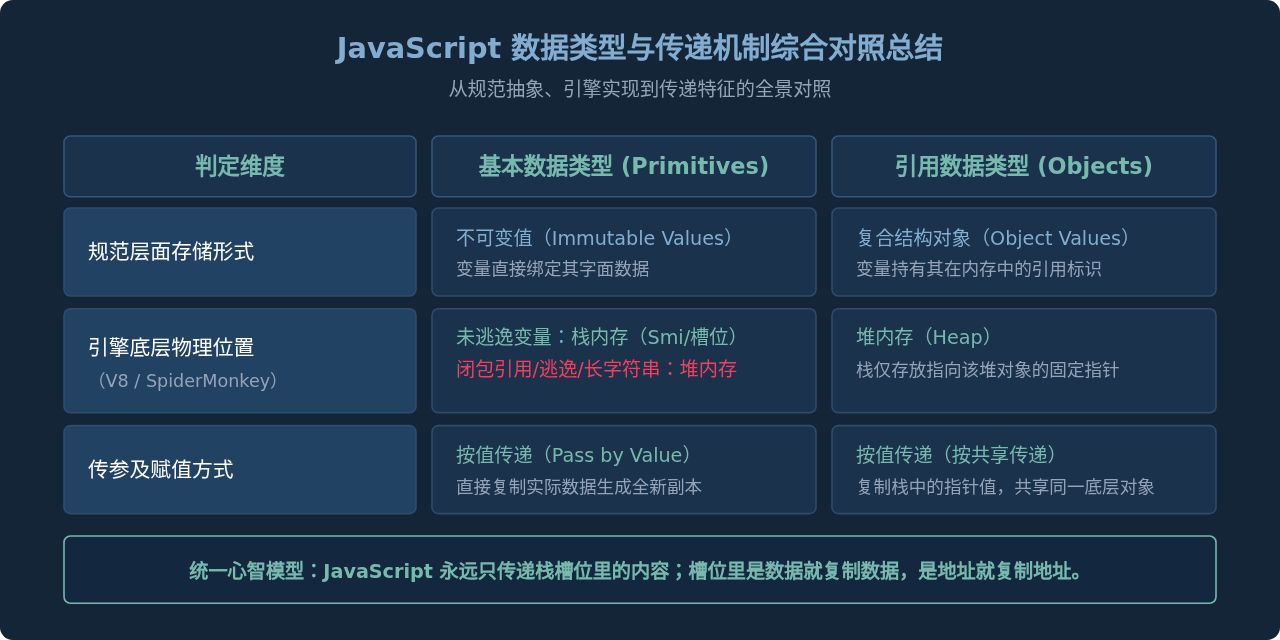
最后,我们将基本类型与引用类型在存储位置、传递语义及底层机制上的差异整理为对照模型,便于随时回顾与验证:
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13







