JavaScript读取URL参数中文乱码怎么解决
深入分析JavaScript读取URL中中文参数出现乱码的核心原因,提供基于URLSearchParams与decodeURIComponent的标准解决方案、排查步骤及兼容细节。
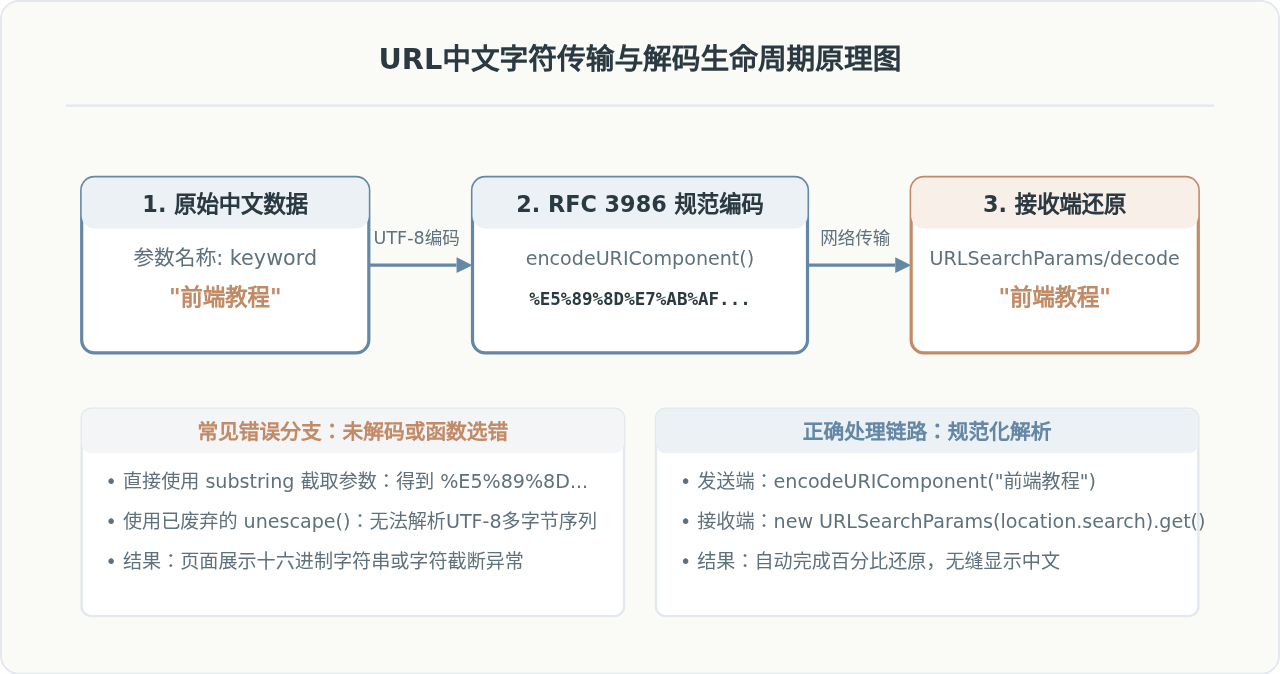
%E4%B8%AD%E6%96%87 或问号乱码,本质是字符经过了百分比编码(Percent-Encoding)但未在接收端正确调用 UTF-8 解码,或者是前后端字符集编码(如 GBK 与 UTF-8)不一致。现代前端解决此问题的首选方案是原生 URLSearchParams API(自动完成标准解码),在需手动解析的场景下使用 decodeURIComponent() 并结合 try...catch 进行防护。
一、URL中文乱码的两种典型表现与根因
在Web开发中,通过浏览器地址栏或接口拼接传递包含中文的URL时,JavaScript脚本读取到的内容往往不是原本的中文字符,常见表现主要分为两类:
- 表现形式 A(百分比编码串):读取出来的参数形如
%E5%89%8D%E7%AB%AF%E5%BC%80%E5%8F%91。这并不是传统意义上的数据损坏,而是URL传输规范要求的十六进制编码结果。RFC 3986规定URL中只能包含ASCII字符集的未保留字符,所有中文字符必须使用UTF-8编码后再转为%XX格式。出现该现象是因为前端代码提取了原始键值串,但遗漏了解码步骤。 - 表现形式 B(不规则乱码或问号):读取到的字符串呈现为
éâ、或菱形问号。产生这种乱码的主要原因是编码规则不匹配。例如发送端使用旧系统的GBK或GB2312编码计算十六进制字节,而接收端默认以UTF-8规格进行反序列化;或者是Web容器(如历史版本的Tomcat默认按ISO-8859-1转码)在中途篡改了解码字节。
二、标准解决方案与实操代码
解决中文参数乱码的核心思路是:获取原始键值 -> 使用正确的字符编码器进行百分比反转义。以下分别介绍现代浏览器标准方案与传统兼容方案。
方法 1:使用原生的 URLSearchParams API(首选推荐)
在所有现代浏览器中,URLSearchParams 是解析查询字符串的标准接口。当调用其 get() 方法获取参数值时,浏览器内部会自动按照 UTF-8 规则进行百分比解码,无需开发者手动调用解码函数。
// 假设当前地址为: https://example.com/search?keyword=%E5%89%8D%E7%AB%AF%E5%BC%80%E5%8F%91&category=%E7%BC%96%E7%A8%8B

// 1. 获取 URL 中的查询串 (包含问号)
const queryString = window.location.search;

// 2. 实例化 URLSearchParams 对象
const urlParams = new URLSearchParams(queryString);

// 3. 直接读取中文参数 (自动解码)
const keyword = urlParams.get('keyword');
const category = urlParams.get('category');

console.log(keyword);  // 输出: "前端开发"
console.log(category); // 输出: "编程"
方法 2:正则表达式/截取配合 decodeURIComponent(兼容及组件封装)
如果需要在低版本浏览器中运行,或者需要通过自定义正则函数提取参数,必须在提取出键值字符串之后,显式包裹一层 decodeURIComponent():
/**
 * 安全获取 URL 指定参数并解码中文字符
 * @param {string} name 参数键名
 * @param {string} [url] 可选的自定义URL,默认使用当前页面地址
 * @returns {string|null} 解码后的参数值
 */
function getUrlParam(name, url = window.location.href) {
  // 匹配参数键值正则
  const reg = new RegExp('(^|&|\\?)' + name + '=([^&]*)(&|$)', 'i');
  const match = url.match(reg);

  if (!match) {
    return null;
  }

  // 关键步骤:使用 decodeURIComponent 还原UTF-8中文
  try {
    return decodeURIComponent(match[2]);
  } catch (err) {
    // 处理非法百分比序列异常 (如 URIError: malformed URI sequence)
    console.warn('URL参数解码失败:', err);
    return match[2];
  }
}

// 示例调用
const keywordVal = getUrlParam('keyword');
console.log(keywordVal);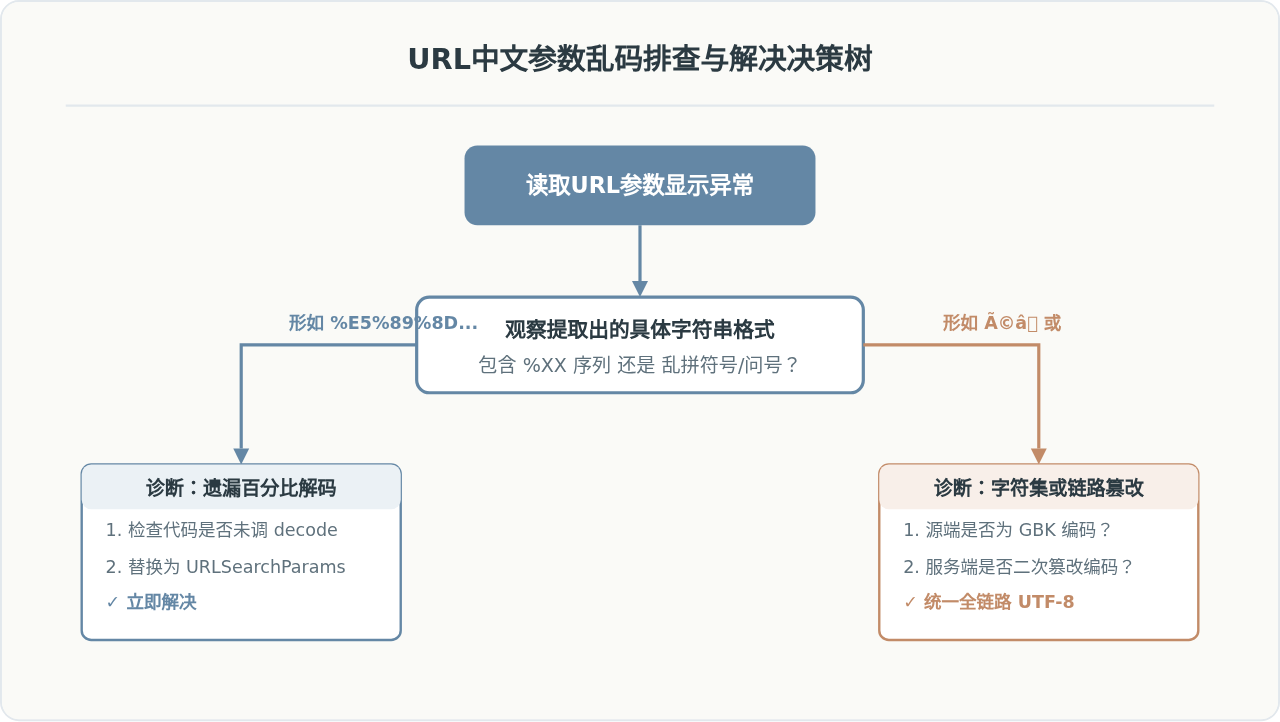
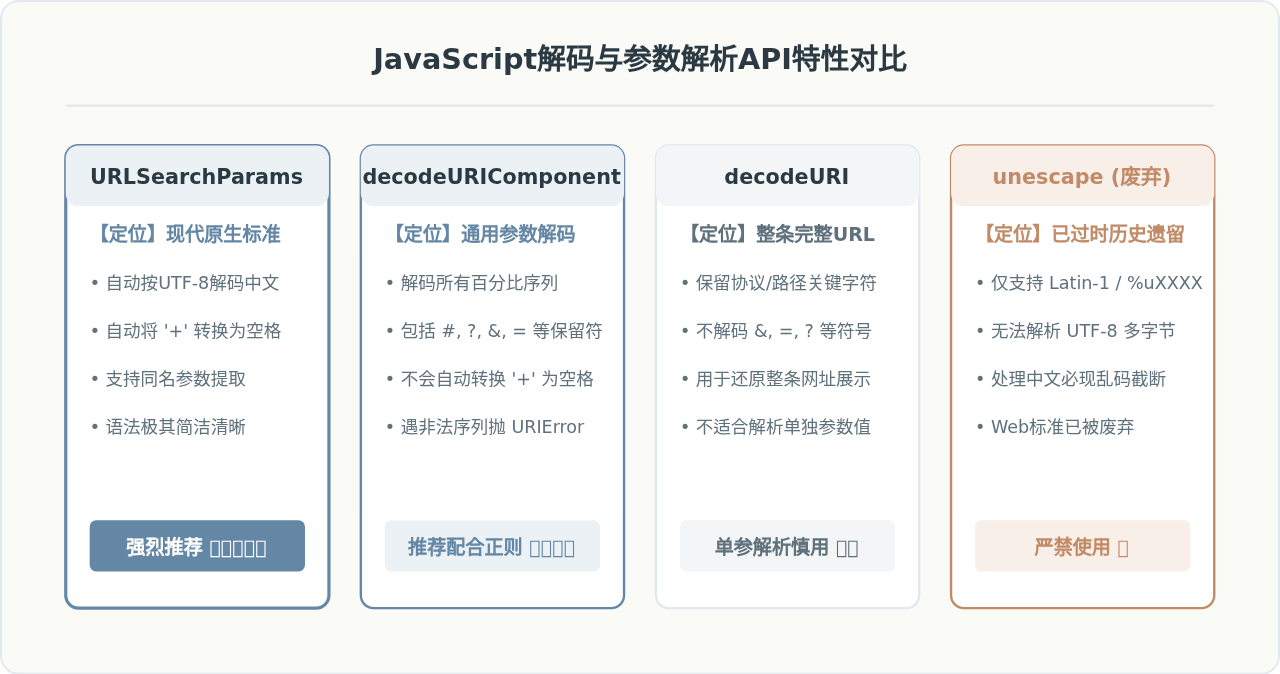
三、常见解码API对比与选型细节
JavaScript原生提供了若干解码或解析API,由于历史演进原因,它们的行为特性各异,选错API往往会导致隐蔽的解析异常:
四、实际应用中的三个常见易错陷阱
1. 加号(+)与空格的解析差异
按照早期的 application/x-www-form-urlencoded 规范,表单在提交时会将空格转换为加号(+),而现代标准编码中空格通常转义为 %20。
如果直接使用 decodeURIComponent() 解码包含 + 的字符串,加号会被原样保留而不是变为空格;而使用 URLSearchParams 则会按照规范自动把 + 转为空格。如果项目采用手动正则提取,建议在调用 decodeURIComponent 之前统一替换:
// 手动正则处理包含加号的参数
const rawVal = "JavaScript+%E6%95%99%E7%A8%8B";
const formatted = decodeURIComponent(rawVal.replace(/\+/g, '%20'));
console.log(formatted); // 输出: "JavaScript 教程"
2. 双重编码(Double Encoding)场景
在某些旧版后端框架(例如默认以 ISO-8859-1 读取 Query 的后端服务)中,客户端在发送请求前往往会主动执行两次 encodeURIComponent:
// 发送端:双重编码
const param = encodeURIComponent(encodeURIComponent("前端教程"));
// 此时参数值为: %25E5%2589%258D%25E7%25AB%25AF... (把 % 自身编码为了 %25)
如果在接收端仅进行了一次解析,拿到的依然是形如 %E5%89%8D... 的字符串。此时如果确认发送端存在双重转码,接收端需要进行第二次 decodeURIComponent 还原。
3. 非 UTF-8 编码页面的参数传递
如果源页面或后端重定向系统使用的是 GBK 编码,其产生的十六进制串格式是两个字节表示一个汉字(例如“中文”的GBK编码为 %D6%D0%CE%C4)。原生的 decodeURIComponent 强制按照 UTF-8(三字节表示常用汉字)规范解码,执行时会直接抛出 URIError: malformed URI sequence 异常。
解决这类问题的根本方案是将网站所有页面的 <meta charset="UTF-8"> 及响应头统一设置为 UTF-8;若因历史遗留无法修改后端编码,必须引入支持 GBK 解码的库(如 text-encoding 或借助 GBK.js)进行非标准字符集转换。
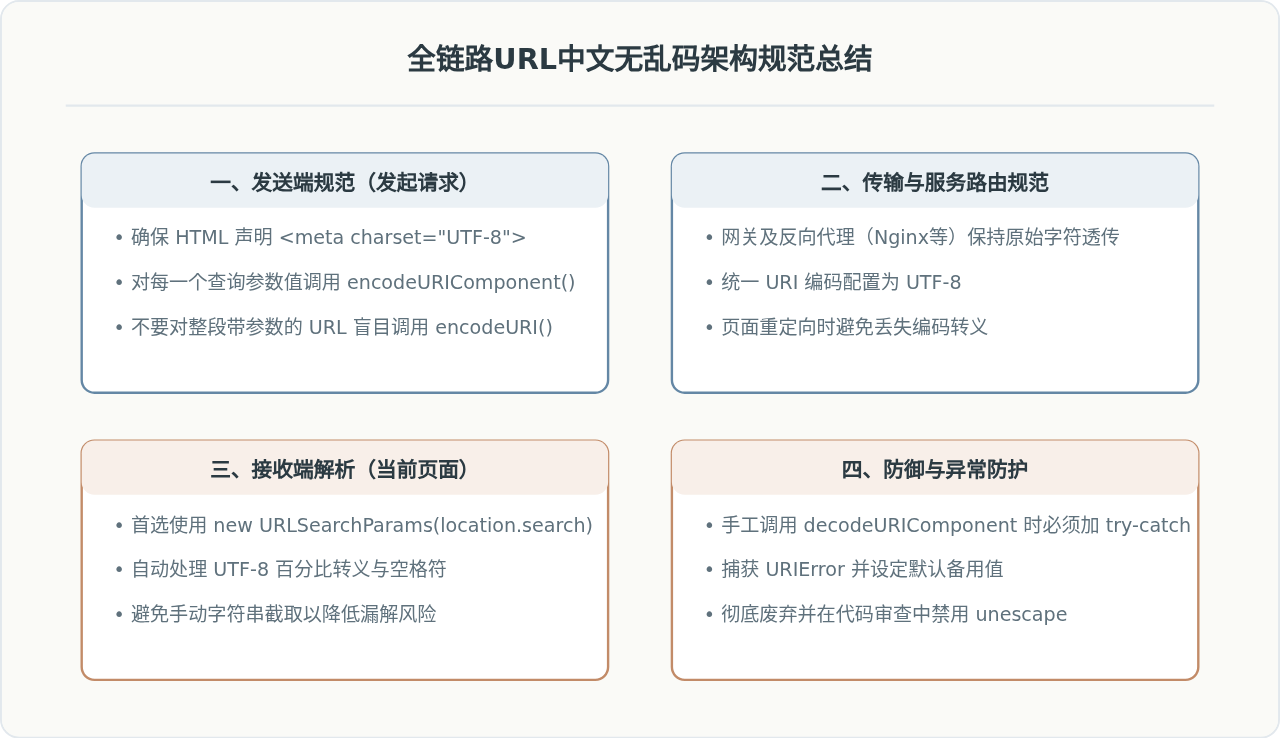
五、总结
JavaScript读取URL参数中文乱码的本质并不复杂。在日常开发中,只要牢记以下实践准则即可彻底杜绝乱码隐患:
- 参数拼接时,针对每个具体值使用
encodeURIComponent()进行序列化; - 参数提取时,优先使用浏览器的原生
new URLSearchParams(window.location.search).get('key'); - 在必须使用正则的遗留系统环境中,使用
decodeURIComponent()并包裹try...catch; - 严禁在现代项目中使用早已废弃的
unescape()函数; - 确保前端页面、服务端及API链路统一采用标准的 UTF-8 字符集。
vtk.js 渲染窗口黑屏或无内容显示的常见原因及排查
2026-11-05 17:30:30
js-cookie 安装与基础用法:set、get、remove 详解
2026-11-05 16:35:06
适合JavaScript初学者的实战项目:制作简易待办事项列表
2026-11-05 16:17:07
JS打开新标签页时怎么通过URL传递参数
2026-11-05 12:21:08
sigma.js 自定义节点样式:设置颜色、大小及标签显示的技巧
2026-11-05 09:55:00