

Ramda 与 Lodash/fp 对比:哪个库更适合 JavaScript 函数式开发
深入对比 Ramda 与 Lodash/fp 在设计哲学、柯里化、数据流水线组合、不可变性与深层数据操作(Lens)上的核心差异,提供生产级代码示例与选型决策指南。
假设你正在重构一个承载核心业务的复杂前端模块:后端返回了深层嵌套的实体对象,你需要依次完成状态过滤、汇率换算、属性提取与聚合求和。使用传统的 JavaScript 原生数组链式调用,代码很快就会充斥着中间临时变量、难以拆分复用的内联回调,以及深度属性访问时恼人的可选链。为了提升代码的可读性、可测试性与模块化程度,你决定引入函数式编程(Functional Programming, 简称 FP)工具库,而摆在面前最主流的两个选项便是 Ramda 与 Lodash/fp。
先给出明确的选型结论:如果你的目标是构建纯粹、规范驱动的函数式代码库,深度依赖自动柯里化(Auto-currying)、代数结构和 Lens(透镜)来优雅操作不可变状态,Ramda 是毫无疑问的首选;但如果你的项目已经深度集成 Lodash、团队成员对高阶函数式概念尚在熟悉阶段,希望以最低的心智负担实现数据管道化(Point-free 与流水线组合),Lodash/fp 则更为稳妥、务实且易于落地。
一、核心范式与 API 设计哲学差异
要理解两个库的本质差别,首先需要看它们诞生的背景与初衷:
- Lodash 原生:完全以命令式与实用主义为中心。它的函数通常采用「数据优先(Data-First)」的参数顺序(如
_.map(collection, iteratee)),并且重度依赖多态参数、可选配置以及动态参数长度(Variadic arguments)。这种设计方便了直接调用,但彻底阻断了函数的自由组合与柯里化。 - Lodash/fp:是 Lodash 官方提供的一个函数式外覆层(Functional Programming Guide wrapper)。它并非推倒重写,而是对 Lodash 内部现有函数进行了批量转换:将参数重构为「数据置后(Data-Last)」、固定参数元数(Fixed arity),并默认开启柯里化支持。
- Ramda:从第一行代码起就是为了纯粹函数式编程而量身定制的。Ramda 坚守「函数在前,数据在后(Function first, data last)」与「始终自动柯里化」的原则,不妥协于 JavaScript 的命令式遗留习惯,所有 API 均围绕组合子(Combinators)与纯函数管道构建。
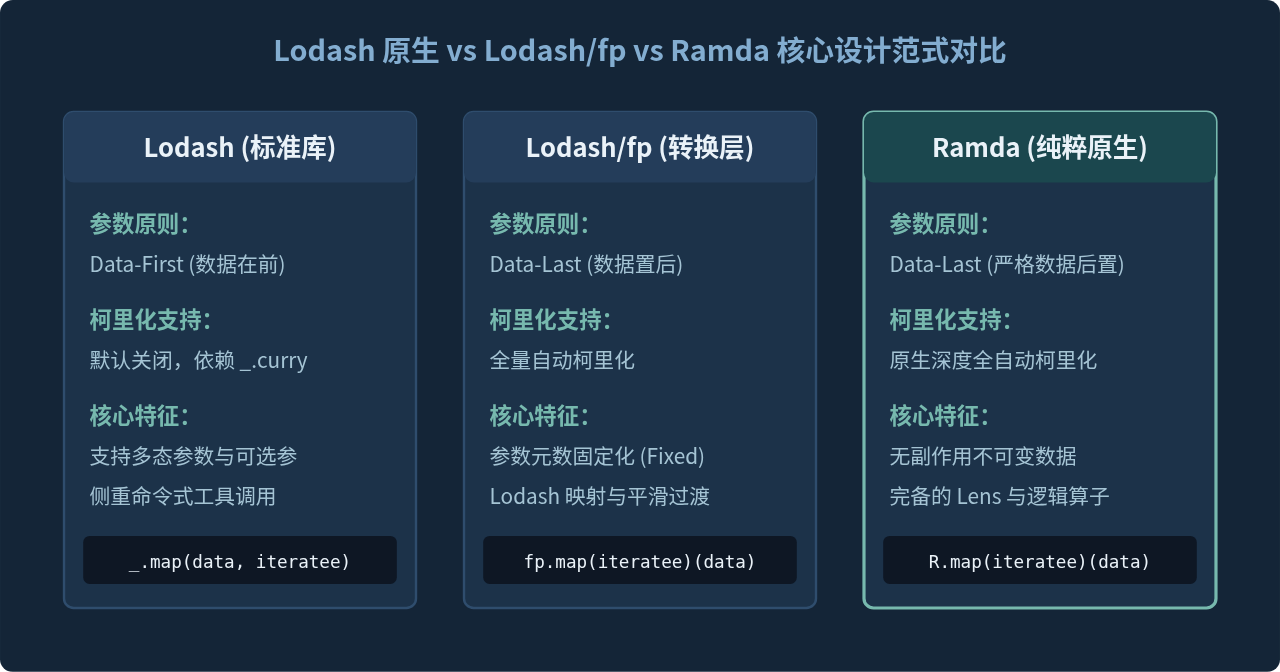
这种差异带来的最大实践影响就是自动柯里化质量。在 Ramda 中,每个函数的形参长度(fn.length)都经过严格规划,柯里化行为完全符合数学直觉;而在 Lodash/fp 中,由于底层复用了原生 Lodash 的多参数函数,Lodash/fp 通过固定参数封装(如对大多数遍历函数截断为仅传递单个当前项,不传递 index 或 array)来强制达成柯里化。尽管这消除了诸如 ['1', '2', '3'].map(parseInt) 产生 NaN 的经典陷阱,但偶而在定制柯里化元数时,Lodash/fp 会产生不如 Ramda 直观的边界情况。
二、数据流水线实战:管道组合机制对比
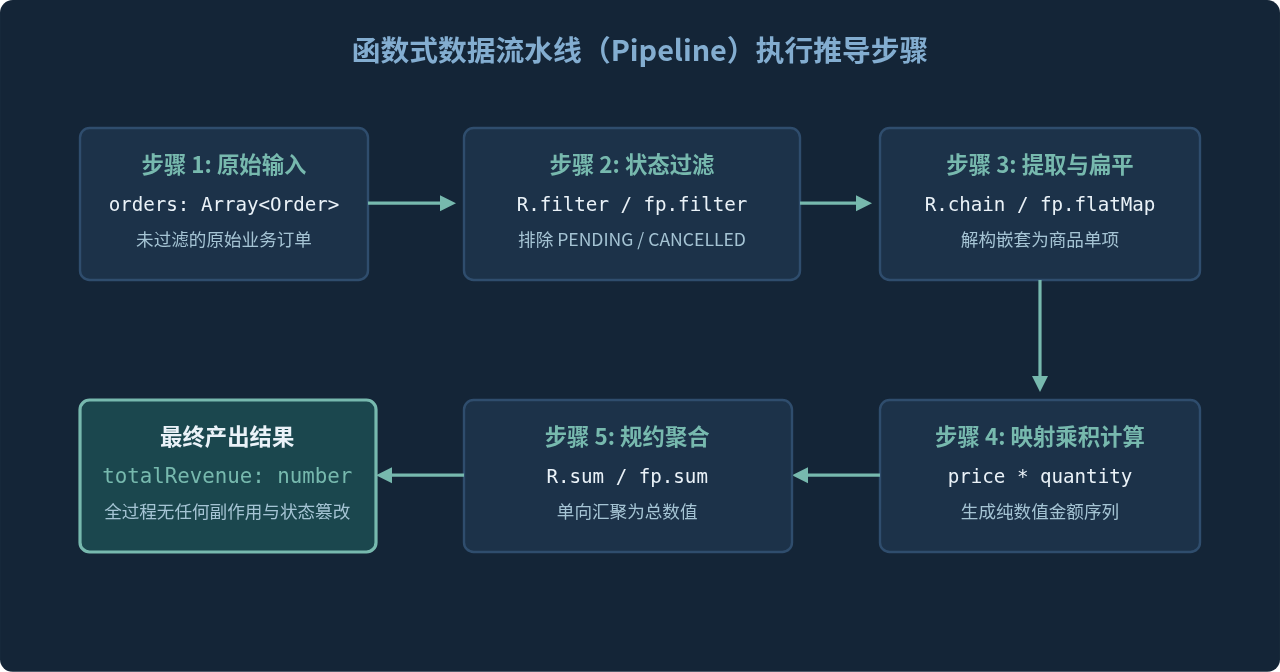
函数式编程的核心威力在于「组合(Composition)」。通过将微小的单一职责函数像积木一样组装,我们无需声明任何中间变量即可实现完整的复杂业务链路。在 Ramda 中对应的核心算子是 R.pipe(从左到右执行)与 R.compose(从右到左执行);在 Lodash/fp 中对应的则是 fp.flow 与 fp.flowRight。
我们来看一个典型的实际电商计算场景:输入一批订单列表,需要(1)过滤出状态为 PAID 的订单;(2)提取每个订单中所有商品的实付金额;(3)累加计算总营业额。
1. Lodash/fp 实现
import fp from 'lodash/fp';

const calculateRevenueFP = fp.flow([
  // 1. 过滤已支付订单 (自动柯里化 & 数据置后)
  fp.filter(order => order.status === 'PAID'),
  // 2. 提取并扁平化商品列表
  fp.flatMap(order => order.items),
  // 3. 提取商品实付单价
  fp.map(item => item.price * item.quantity),
  // 4. 求和
  fp.sum
]);

// 执行管道运算
const revenue = calculateRevenueFP(orders);
2. Ramda 实现
import * as R from 'ramda';

const calculateRevenueRamda = R.pipe(
  // 1. 使用 propEq 表达纯粹的声明式判断
  R.filter(R.propEq('PAID', 'status')),
  // 2. 链式扁平化映射
  R.chain(R.prop('items')),
  // 3. 使用 R.converge 或局部纯函数计算单项金额
  R.map(item => R.multiply(item.price, item.quantity)),
  // 4. 聚合求和
  R.sum
);

// 执行管道运算
const revenue = calculateRevenueRamda(orders);
对比两段代码可以发现:Lodash/fp 在风格上更贴近普通 JavaScript 工程师的习惯,允许在回调中书写常规箭头函数;而 Ramda 则提供了大量如 R.propEq、R.chain、R.multiply 等基础谓词与算子,鼓励开发者彻底摆脱形参声明,书写极致的 Point-free 风格代码。
三、状态变更与深层操作:Lens vs 路径变换
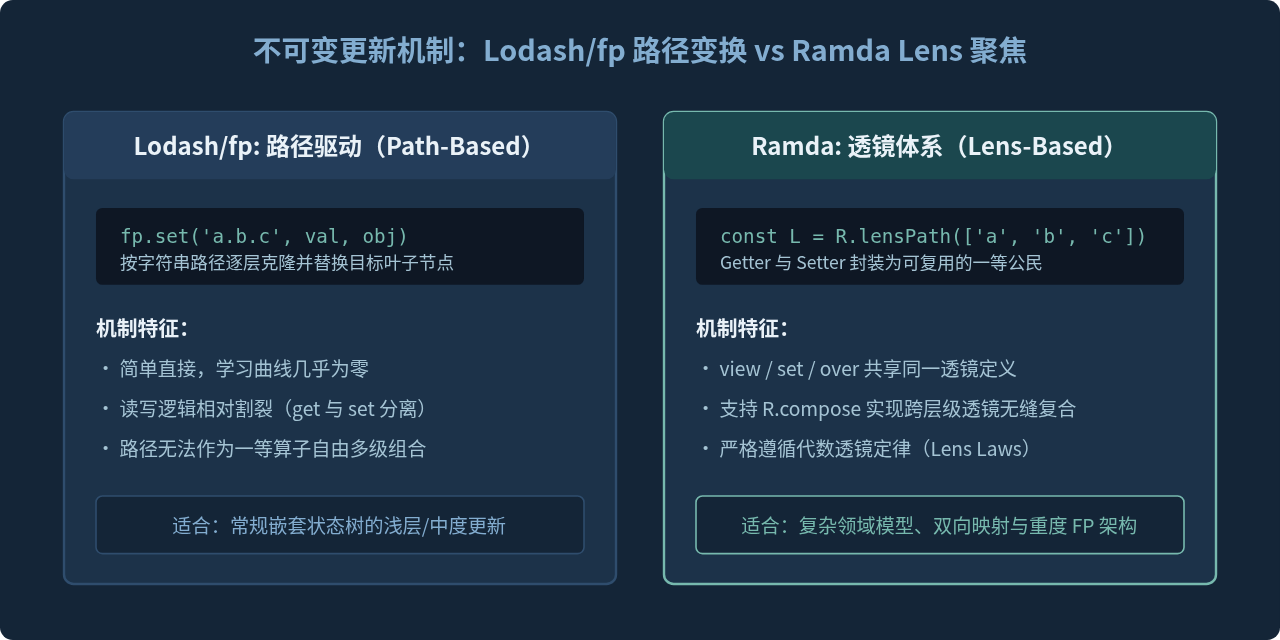
在不可变数据结构中,更新嵌套对象的某一深层属性是极为常见的痛点。如果直接使用 ES6 的解构展开符(Spread Operator),遇到三层以上的嵌套时代码就会沦为「展开地狱」。在处理这一问题上,Ramda 和 Lodash/fp 采用了截然不同的思维模型。
1. Lodash/fp:基于属性路径的快照操作
Lodash/fp 沿用了直观的字符串或数组路径更新思想,提供 fp.get、fp.set 和 fp.update:
import fp from 'lodash/fp';

const state = {
  user: {
    profile: { name: 'Alice', score: 90 },
    settings: { theme: 'dark' }
  }
};

// 纯函数方式更新:返回新对象,内部做浅拷贝
const updatedState = fp.set('user.profile.name', 'Bob')(state);
const incrementedScore = fp.update('user.profile.score', n => n + 10)(state);
这种机制非常易于理解,语法与现代状态管理库(如 Redux、Zustand)完全相通。
2. Ramda:数学意义上的 Lens(透镜)体系
Ramda 引入了来自函数式编程语言(如 Haskell)的 Lens 概念。Lens 是一个将 Getter 和 Setter 打包在一起的一等公民抽象。你可以把它看作一个可以随时「聚焦」到数据结构某个局部的小透镜:
R.view(lens, target):透过透镜查看数据(Getter)。R.set(lens, value, target):透过透镜设定数据,并返回全新根对象(Setter)。R.over(lens, fn, target):透过透镜将聚焦的值送入函数进行变换(Modifier)。
import * as R from 'ramda';

// 1. 定义聚焦到 user.profile.name 的透镜
const nameLens = R.lensPath(['user', 'profile', 'name']);
const scoreLens = R.lensPath(['user', 'profile', 'score']);

// 2. 无论读取还是写入,都复用同一个透镜对象
const currentName = R.view(nameLens, state); // 'Alice'
const nextState = R.set(nameLens, 'Bob', state); // 返回修改后的新 state
const bonusState = R.over(scoreLens, R.add(10), state); // score 变为 100R.compose 组合为一个新的 Lens。例如 R.compose(userLens, profileLens, nameLens) 可以随意拆解、组装与跨模块传递,这是单纯的路径字符串所无法媲美的。
四、工程考量:打包体积、TypeScript 支持与学习曲线
在现代化前端工程中,除了 API 的美学设计,工程化落地的可行性往往起着决定性作用。以下三点尤为关键:
1. 打包体积与 Tree-shaking
很多开发者误以为只要引入 lodash/fp,打包体积就会非常小。然而在实际工程中:
- 如果直接书写
import fp from 'lodash/fp',现代打包工具(如 Webpack、Vite、Rollup)将无法进行摇树优化(Tree-shaking),会导致打包产物体积剧增约 70KB+(压缩前)。要实现精细按需加载,你必须按子路径导入,例如import map from 'lodash/fp/map',或者配合babel-plugin-lodash。 - Ramda 原生发布了符合 ES Module 规范的版本(
ramda/es)。当书写import { pipe, map, filter } from 'ramda'时,主流打包工具可以较为精准地只打包实际被引用的独立模块,对工程构建配置更为友好。
2. TypeScript 类型推断挑战
函数式编程中的高阶函数柯里化是 TypeScript 类型系统的最大考验。无论在 Ramda 还是 Lodash/fp 中,管道函数(pipe 或 flow)在串联超过 7 到 9 个函数时,类型系统都会出现断层(落入 any 或产生难以解读的极其冗长的泛型报错)。
- Ramda:社区维护的
@types/ramda极其庞大且严密,但这也导致在复杂柯里化嵌套时,IDE 的自动补全与类型检查性能可能发生可感知的延迟。 - Lodash/fp:使用
@types/lodash/fp时,由于底层很多类型映射自动从标准 lodash 衍生,某些高阶柯里化函数在处理重载时类型推断容易退化。
工程实践建议:在 TypeScript 项目中,无论选择哪个库,都不建议构建过度复杂、深达数十步的长管道。将大型管道拆解为带显式类型签名的具名子流水线,是保持类型安全的最佳手段。
3. 团队协作与认知负荷
引入函数式库最忌讳「自嗨式编码」。Lodash/fp 的优势在于其函数命名和语义与 Lodash 高度保持一致(如 filter、groupBy、sortBy),团队成员无需专门学习函数式范式也能快速看懂代码意图;而 Ramda 充斥着来自范畴论与 Haskell 的命名(如 chain 代替 flatMap、converge、juxt、ap),如果团队缺乏扎实的函数式背景,极易引发代码审查(Code Review)阻力与维护断层。
五、选型对比矩阵与决策指南
综合以上各维度的考量,我们可以将两个库的关键特性整理为以下对比表:
| 评估维度 | Lodash/fp | Ramda |
|---|---|---|
| 设计初衷 | 对命令式 Lodash 进行函数式兼容封装 | 从零构建的纯粹函数式编程基石 |
| 参数顺序 | Data-Last(数据置后) | Data-Last(数据置后) |
| 自动柯里化 | 固定元数包装,基本支持 | 深度原生支持,严格遵循形参元数 |
| 深层更新机制 | 字符串/数组路径(fp.set, fp.update) | 数学 Lens(透镜)系统(view, set, over) |
| 打包友好度 | 需按子路径导入或借助 Babel 插件 | 原生支持 ESM,摇树优化友好 |
| 生态兼容性 | 与既有 Lodash 项目 100% 顺畅互操作 | 独立生态,遵循 Fantasy Land 代数规范 |
| 学习曲线 | 平缓,前端工程师普遍无缝接受 | 陡峭,需掌握柯里化、Lens、组合子思维 |
六、总结与落地建议
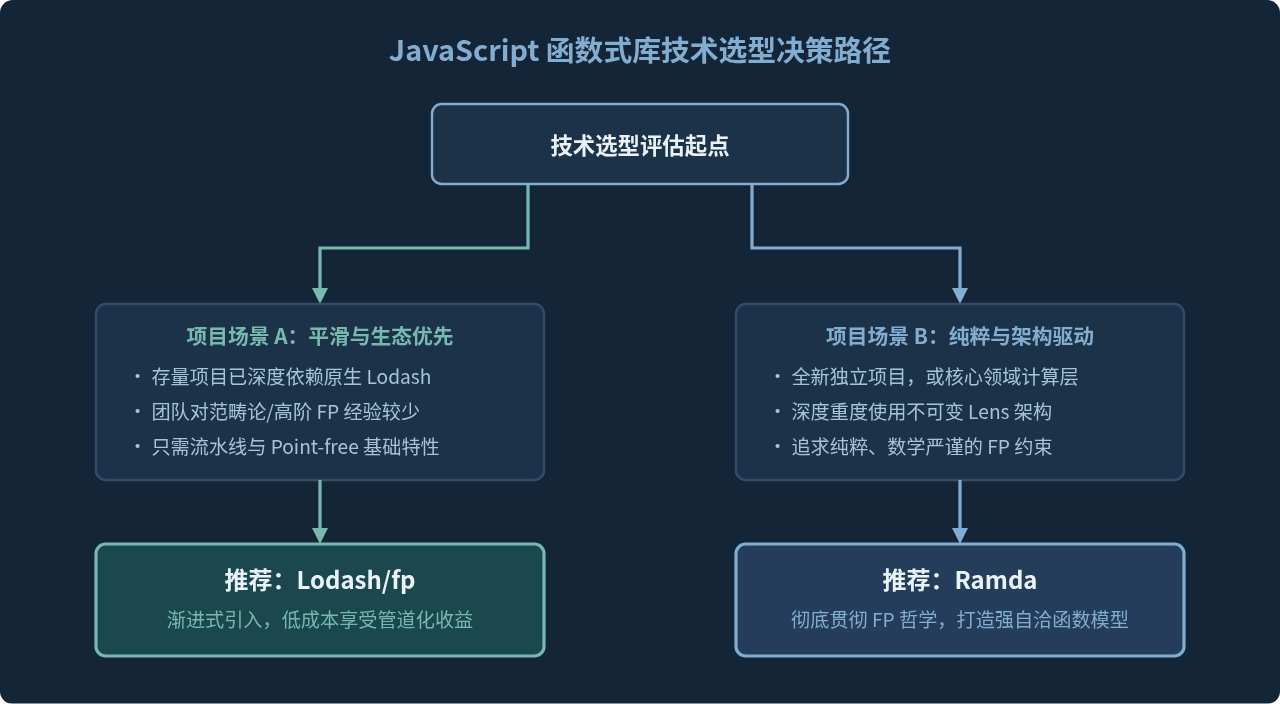
回到最初的问题:「Ramda 与 Lodash/fp,哪个库更适合 JavaScript 函数式开发?」答案从来不是二元对立的,而是取决于你的项目处于函数式演进的哪一个阶段:
- 探索与渐进引入期:如果团队刚刚从命令式代码向函数式流水线转型,或者项目代码库中随处可见
lodash工具函数,直接使用lodash/fp是风险最小、产出最高的选择。你只需学习fp.flow与数据置后的传参方式,即可立即消除大批中间状态变量。 - 范式重塑与成熟期:如果你正在主导构建一个对数据流纯度要求极高的数据处理管道、复杂的富文本/图表状态转换模块,或者全团队已建立起函数式共识,那么 Ramda 能够提供远比 Lodash/fp 纯净、自洽且优雅的编程体验。它的 Lens 系统和对代数结构的尊重,将彻底改变你组织和看待业务逻辑的方式。
JS处理含Emoji或中文的字符串转数组乱码问题
2026-11-05 16:12:28
JS怎么使用展开运算符合并对象
2026-11-05 14:42:18
ES6+环境下判断JS对象为空的简洁写法
2026-11-05 12:12:23
怎么通过replacer函数自定义JS中JSON的格式化输出
2026-11-05 11:19:44
JS正则表达式基础:字面量与RegExp构造函数的区别及常用元字符
2026-11-05 11:16:58







