

网页是怎么构成的?HTML搭骨架、JS加交互、Java做后端
深入解析网页构成的核心技术与全链路协作:阐述HTML如何搭建页面语义骨架、JavaScript如何实现动态事件与异步通信、Java后端如何处理业务逻辑与持久化存储。
一、HTML 如何搭建网页的结构骨架
当在浏览器地址栏输入网址并敲击回车后,浏览器接收到的第一个核心文件就是 HTML(超文本标记语言)文档。HTML 的本质是一份由标签嵌套组成的纯文本结构说明书,它的首要职责是告诉浏览器当前页面包含哪些具体信息,以及这些信息之间的从属和层级关系。
浏览器引擎在读取 HTML 时,会根据标签的开闭关系将其逐行解析,在内存中构建出一棵倒挂的树状数据结构——文档对象模型(Document Object Model,简称 DOM)。如果把网页比作一套住宅,HTML 就是建筑的承重墙、门窗开口和房间隔断。没有 HTML 定义的语义骨架,所有的文本、按钮和输入框都将失去安放位置。
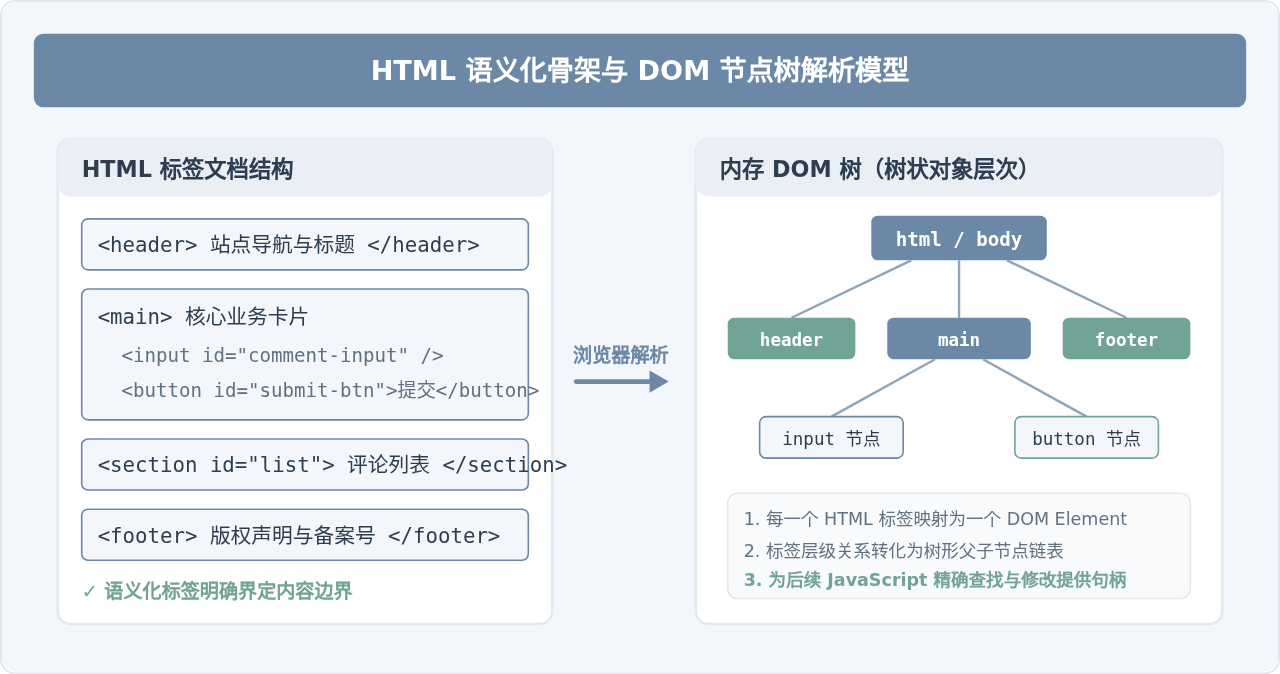
为了直观理解骨架的搭建过程,下面展示一段典型的 HTML 代码片段。它包含一个具有明确业务含义的发表留言功能区域:
<!-- 留言发表卡片骨架 -->
<main class="comment-card">
  <h2 class="card-title">发表您的观点</h2>

  <!-- 输入交互容器 -->
  <div class="form-group">
    <textarea id="content-input" placeholder="请输入留言内容..." rows="4"></textarea>
  </div>

  <!-- 操作按钮与状态容器 -->
  <div class="action-bar">
    <span id="status-tip" class="tip-text"></span>
    <button id="post-btn" class="primary-btn">立即提交</button>
  </div>

  <!-- 动态展示容器:后续由 JS 填充具体评论节点 -->
  <section id="comment-list" class="list-container">
    <!-- 初始为空或展示骨架屏 -->
  </section>
</main>
在这段 HTML 中,<textarea> 声明了一个多行文本输入控件,<button> 声明了一个可点击的按钮,而 <section id="comment-list"> 则预先划定了一块容器区域。仅凭这份代码,页面就可以在屏幕上呈现出输入框和按钮的基本轮廓。但此时无论怎样点击按钮,网页都不会产生任何反应,因为 HTML 本身只负责“陈列物体”,并不具备处理行为与动态逻辑的能力。
二、JavaScript 如何为网页注入动态交互
有了 HTML 搭建的骨架之后,网页需要具备与用户对话的能力。当用户在输入框输入文字、按下键盘或者点击提交按钮时,页面需要产生反馈,这正是 JavaScript(简称 JS)的核心使命。
JavaScript 是一门运行在客户端浏览器内部的脚本语言。它的核心工作机制可以概括为三步:
- 定位目标节点:利用浏览器提供的 API(如
document.getElementById或document.querySelector),在 DOM 树中找到需要交互的 HTML 元素。 - 绑定事件监听:通过
addEventListener注册用户操作监听器(如click、keydown、input),等待特定时机的触发。 - 执行业务动作并变更 DOM:事件被触发后,JS 运行预先编写的函数,执行格式验证、向远端发送数据请求,并直接在内存中修改、添加或删除 DOM 节点,使页面在无需刷新的情况下发生即时改变。
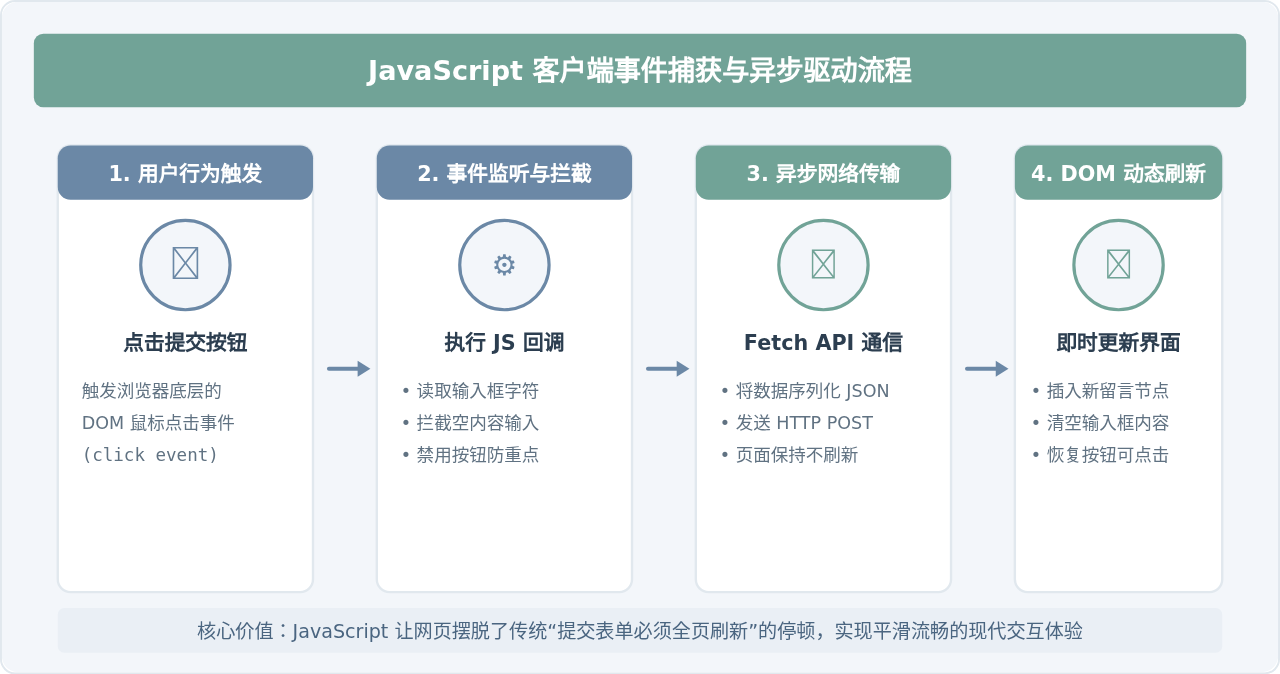
为了完成上面图示的完整操作,前端通常会编写如下标准的 JavaScript 逻辑:
// 1. 获取需要操作的 DOM 元素
const postBtn = document.getElementById('post-btn');
const contentInput = document.getElementById('content-input');
const statusTip = document.getElementById('status-tip');
const commentList = document.getElementById('comment-list');

// 2. 绑定点击事件监听器
postBtn.addEventListener('click', async () => {
  const text = contentInput.value.trim();

  // 基础前端验证:阻止无效请求
  if (!text) {
    statusTip.textContent = '留言内容不能为空';
    statusTip.style.color = '#E74C3C';
    return;
  }

  // 变更 UI 状态:防止用户频繁重复点击
  postBtn.disabled = true;
  postBtn.textContent = '正在提交...';
  statusTip.textContent = '';

  try {
    // 3. 异步向后端发起 HTTP 请求(Fetch API)
    const response = await fetch('/api/comments', {
      method: 'POST',
      headers: {
        'Content-Type': 'application/json'
      },
      body: JSON.stringify({ content: text })
    });

    const result = await response.json();

    if (response.ok && result.code === 200) {
      // 4. 动态创建新的 DOM 节点并挂载到列表
      const item = document.createElement('div');
      item.className = 'comment-item';
      item.textContent = result.data.content;
      commentList.prepend(item);

      // 清空输入框并给出成功提示
      contentInput.value = '';
      statusTip.textContent = '发表成功!';
      statusTip.style.color = '#27AE60';
    } else {
      statusTip.textContent = result.message || '提交失败,请重试';
    }
  } catch (error) {
    statusTip.textContent = '网络异常,无法连接服务器';
  } finally {
    // 恢复按钮可用状态
    postBtn.disabled = false;
    postBtn.textContent = '立即提交';
  }
});
从这段代码中可以看到,JavaScript 在浏览器内部扮演了“前端调度中枢”的角色。但是,浏览器环境是完全公开且运行在用户设备上的。如果数据只停留在 JavaScript 变量里,一旦关闭或刷新网页,所有输入都会灰飞烟灭;同时,前端代码完全无法直接、安全地连接远程数据库。这就必须依赖第三个核心组件——后端服务。
三、Java 后端如何承担业务计算与数据存储
当 JavaScript 把打包好的数据通过网络发出去之后,真正决定数据能否被保存、用户是否具有权限、以及资金或库存如何变动的,是部署在远端服务器上的后端程序。在企业级开发和大型互联网系统中,Java 是最主流的后端开发语言之一。
为什么不能直接用前端连数据库?
初学者常会产生一个疑问:既然前端 JavaScript 如此灵活,为什么不直接在网页里写 SQL 语句连接 MySQL 数据库?
- 极度危险的安全隐患:运行在浏览器里的 JS 源代码对所有人都是可见的。如果在前端配置数据库的 IP、账号和密码,攻击者轻点浏览器“开发者工具”就能获取全部数据库凭证,导致数据被窃取或删库。
- 业务规则不可信:前端所有的拦截逻辑(如“充值金额必须大于0”、“用户必须先登录”)都可以被攻击者通过抓包工具或控制台轻易绕过。核心规则必须在不受客户端控制的独立服务器上重新严格校验。
- 高并发与资源管理:数据库所能承受的并发连接数是有限的(通常为数百到数千个连接)。如果有上万名用户同时打开网页,让每个浏览器直连数据库会瞬间导致数据库连接池崩溃。
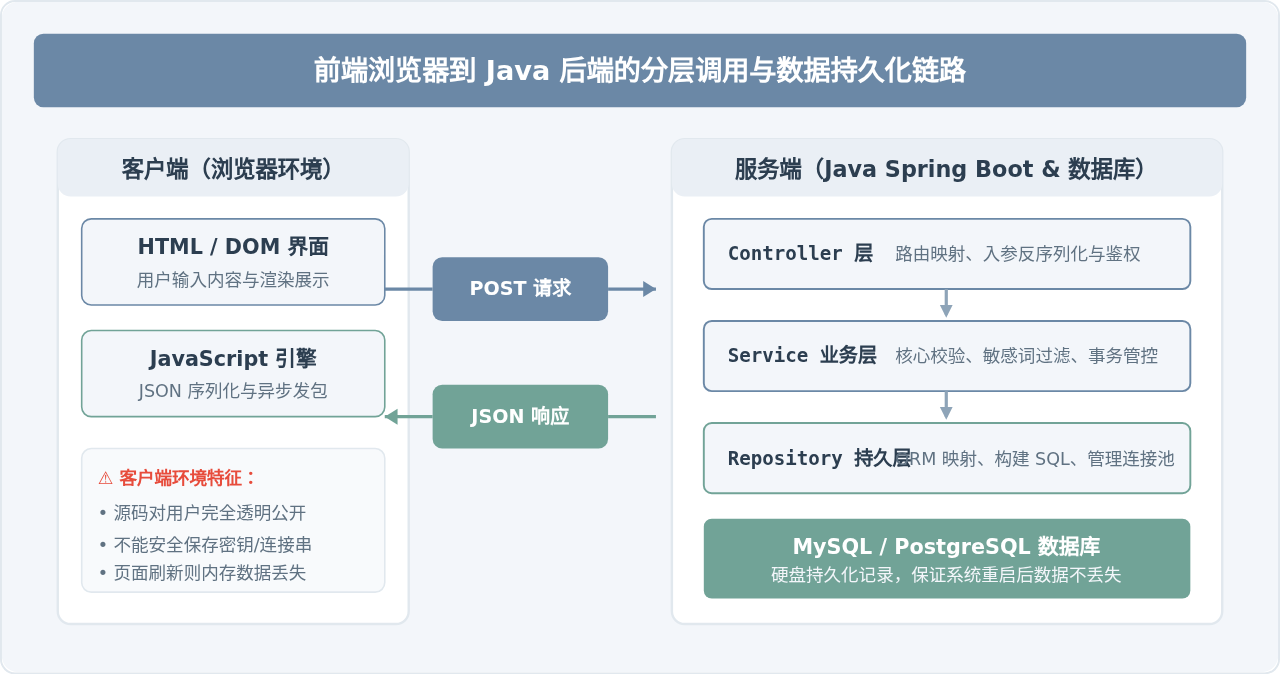
Java 后端的经典分层架构
在主流的 Spring Boot 框架中,Java 通常采用清晰的三层架构来处理来自前端的请求:
- 控制器层(Controller):对外暴露 HTTP 接口。负责接收浏览器发来的网络请求,将 JSON 文本自动转换为 Java 实体对象,并进行基本的入参校验。
- 业务逻辑层(Service):系统的核心大脑。例如检查当前用户是否处于被禁言状态、过滤评论中的非法敏感词、或者计算业务积分。
- 持久化层(Repository / DAO):负责与底层数据库打交道。执行具体的
INSERT INTO语句,将校验通过的数据永久写入磁盘。
下面是一个处理前端评论提交的典型 Java Controller 与 Service 代码示例:
// 1. 控制器:接收前端的 POST /api/comments 请求
@RestController
@RequestMapping("/api/comments")
public class CommentController {

    @Autowired
    private CommentService commentService;

    @PostMapping
    public ResponseEntity<ApiResponse> createComment(@RequestBody CommentRequest request) {
        // 服务端强制防线:哪怕前端被绕过,后端依然阻断空输入
        if (request.getContent() == null || request.getContent().trim().isEmpty()) {
            return ResponseEntity.badRequest()
                .body(new ApiResponse(400, "评论内容不能为空", null));
        }

        // 调用业务层保存数据
        CommentEntity saved = commentService.saveComment(request.getContent());

        // 返回标准 JSON 格式的成功响应
        return ResponseEntity.ok(new ApiResponse(200, "success", saved));
    }
}

// 2. 业务逻辑层与数据库操作
@Service
public class CommentService {

    @Autowired
    private CommentRepository commentRepository;

    public CommentEntity saveComment(String content) {
        // 执行商业逻辑:敏感词替换、绑定发布者与当前服务器时间
        String safeContent = content.replaceAll("(?i)badword", "***");

        CommentEntity entity = new CommentEntity();
        entity.setContent(safeContent);
        entity.setCreatedAt(LocalDateTime.now());

        // 持久化到 MySQL 数据库
        return commentRepository.save(entity);
    }
}前端 JS 的校验是为了提升用户体验(在用户输错时瞬间提示,避免白白耗费一次网络请求);而后端 Java 的校验是为了系统安全底线(防止恶意脚本绕过浏览器直接向接口发送脏数据)。两者各司其职,缺一不可。
四、端到端协同实战:一次点击的全链路穿透
理解了 HTML、JavaScript 与 Java 的各自角色后,我们把整个过程连贯起来,追踪一次完整的用户操作在系统中的流动路径:
- 第一阶段:页面初始呈现
用户在浏览器输入网址,浏览器向服务器请求 HTML。浏览器接收到 HTML 后解析出骨架(输入框、提交按钮、空评论列表),并将界面渲染在屏幕上。 - 第二阶段:本地交互与事件拦截
用户在输入框键入“这篇文章讲得很透彻!”,然后点击“立即提交”按钮。此时浏览器触发click事件,预先加载好的 JavaScript 脚本捕获该事件。JS 首先把按钮置灰变为“正在提交...”,防止用户手抖连续点两次。 - 第三阶段:跨网络异步通信
JavaScript 将文本组装为 JSON 格式{"content": "这篇文章讲得很透彻!"},通过浏览器的fetch函数发起 HTTP POST 请求,穿过互联网发送到后端的/api/comments端口。在此期间,页面其他部分完全正常可用,无需像传统旧网页那样整页白屏刷新。 - 第四阶段:服务端业务处理与持久化
远端的 Java 服务器接收到该 HTTP 报文:- Spring Boot 的 Controller 拦截请求,解析 JSON 为 Java 对象;
- Service 进行业务校验,确认内容合规后生成唯一 ID 与当前时间戳;
- Repository 通过数据库连接池将记录执行 SQL 写入 MySQL 数据库表中;
- 处理完毕后,Java 组装包含新记录 ID 和状态码的 JSON,返回 HTTP 200 响应。
- 第五阶段:前端收到响应并局部重绘
浏览器的 JavaScript 收到后端发回的 JSON 响应,确认状态码为 200 后,动态创建一个新的<div class="comment-item">标签,将新评论追加到评论列表顶部,并清空输入框文本。用户立刻看到了自己刚发出的评论。
五、全链路协作与职责分工全景对照
为了在开发中始终清晰各技术的边界与权责,避免“逻辑该写在前端还是后端”的困惑,下图对 HTML、JavaScript 与 Java 后端在各个维度的分工进行了全景总结:
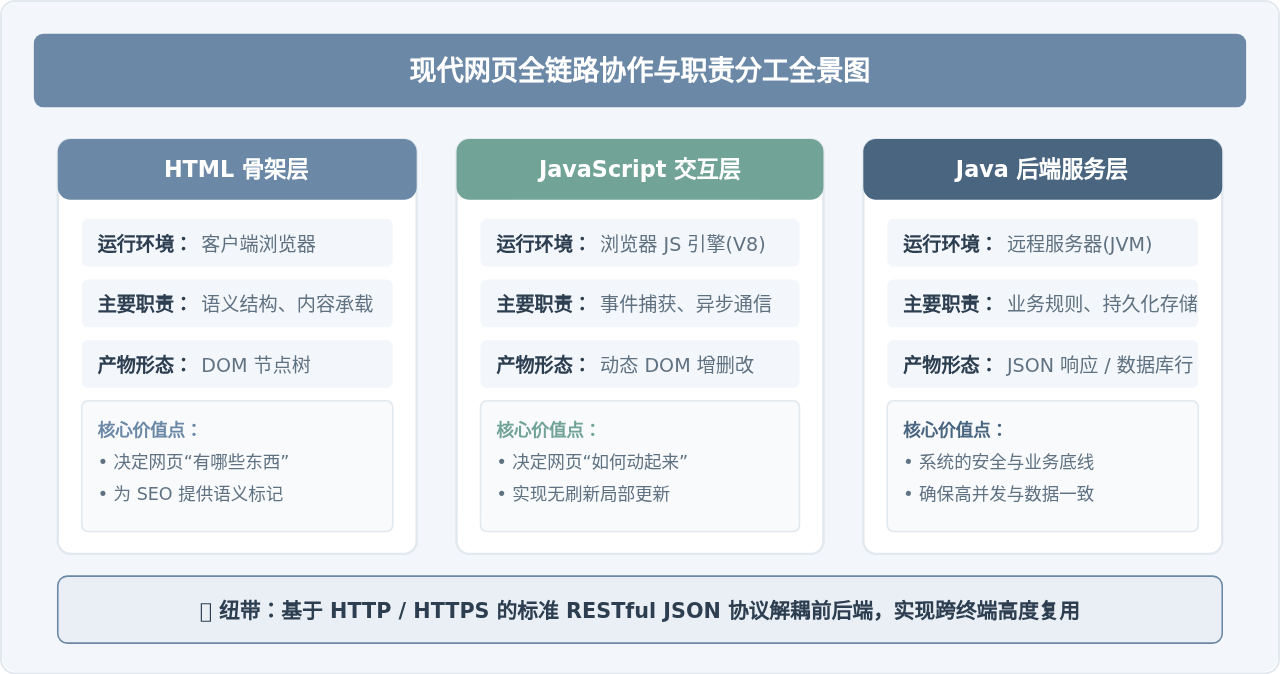
核心维度对照表
| 对比维度 | HTML(骨架) | JavaScript(交互) | Java(后端) |
|---|---|---|---|
| 代码执行位置 | 用户本地浏览器 | 用户本地浏览器(V8 引擎) | 远端独立云服务器(JVM) |
| 数据生命周期 | 页面刷新即恢复初始结构 | 存储于页面内存,关闭标签即丢失 | 写入磁盘与数据库,永久保存 |
| 安全防护级别 | 无安全隔离(源码完全公开) | 防线脆弱(仅供基础交互验证) | 核心安全防线(鉴权、加密、事务) |
| 典型开发职责 | 声明文本、输入框、容器结构 | 监听点击、发起 Ajax、局部刷新 UI | 业务规则计算、写库、保证数据一致 |
六、总结
现代网页的开发并不是单纯某项技术的独角戏,而是一场精密分工的团队接力:
- HTML 搭骨架:负责用语义化标签搭建出层次严谨的 DOM 结构,解决“内容在哪里、以什么层级展示”的问题。
- JS 加交互:负责在用户与 DOM 之间架起桥梁,监听事件、控制界面反馈并驱动异步通信,解决“用户操作后界面如何快速响应”的问题。
- Java 做后端:负责在远端提供可靠的业务运算、权限管控与数据持久化,解决“业务如何计算、数据如何安全长期存续”的问题。
搞清楚这三者的分工边界,在遇到问题时就能快速定位排查:如果是页面缺了按钮或排版错乱,先看 HTML;如果是点击按钮没反应或没发请求,检查 JavaScript;如果是点击后提示“服务器错误”或刷新后数据没保存,则应重点排查 Java 后端与数据库。三者各司其职、紧密协同,共同构成了支撑现代互联网海量应用的坚固基石。
D3.js 处理大规模数据点的性能优化策略
2026-11-05 15:37:25
JS实现网页摄像头实时扫码:结合getUserMedia与jsQR教程
2026-11-05 15:27:28
D3.js v5 迁移到 v7 的 API 变更与注意事项
2026-11-05 11:57:17
使用 animate.js 实现多元素协同的序列动画
2026-11-04 22:27:53
JS拖拽排序时怎么添加平滑动画效果?FLIP技术实战
2026-11-04 10:12:22







