

Web全栈选JavaScript,数据处理选Python:怎么根据项目类型匹配语言
面对项目选型,本文详解为什么Web全栈优先选择JavaScript/TypeScript,数据清洗与处理优先选用Python,并提供具体的架构对比、选型评估流程与混合协作落地方案。
一、语言特质与底层生态的现实边界
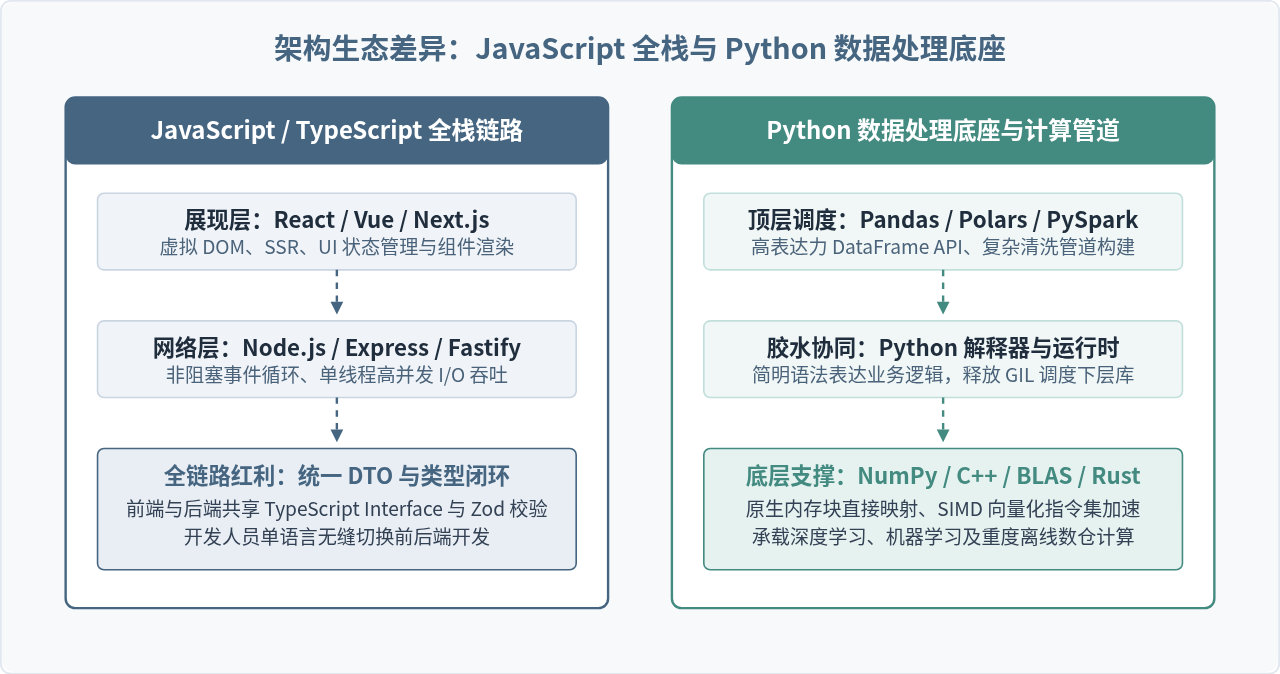
JavaScript与Python在设计之初针对的是完全不同的计算场景。现代浏览器原生仅支持JavaScript,这奠定了Node.js诞生后JavaScript在Web全栈领域不可替代的地位。基于单线程事件循环(Event Loop)与非阻塞I/O模型,JavaScript在处理数以万计的并发HTTP短连接、WebSocket推送时展现出高吞吐特质。配合TypeScript的静态类型系统,前端界面组件与后端API之间可以实现零开销的接口定义共享。
Python的设计则深度契合通用脚本编写与科学计算。虽然Python存在全局解释器锁(GIL),限制了原生多线程CPU密集运算,但数据科学社区选择了一条独特的工程路径:将密集矩阵运算、线性代数分解和底层内存操作交给C/C++及Fortran编写的高性能底座(如NumPy、BLAS),Python则充当轻便易懂的语法调度胶水。
二、Web全栈场景为什么选JavaScript/TypeScript
在纯Web业务系统中,最大的工程损耗往往不是微秒级的CPU吞吐,而是前后端数据契约不一致带来的联调成本与认知负担。使用全栈JavaScript方案具有以下关键优势:
- 模型一致性(Isomorphic Code):前后端共用一套验证库(如Zod、Yup)与数据传输对象(DTO)。字段定义变更只需修改一处,IDE即可在前后端代码中同时触发语法告警。
- 渲染流水线深度集成:现代前端框架依赖服务器端渲染(SSR)和流式传输(Streaming HTML),如Next.js、Nuxt.js。这些框架要求在Node.js环境下执行组件生命周期函数,前后端同栈是实现无缝混合渲染的基础。
- 高密度I/O并发成本低:针对电商结算、即时通讯、订单轮询等以网络等待为主的场景,Node.js的单进程事件驱动架构内存占用平缓,不需要预先配置庞大的线程池。
实操示例:全栈类型复用与契约校验
以下示例展示在前后端同构体系中,如何定义一份公共模型并在前后端同时生效,彻底消除跨语言序列化转换带来的类型丢失风险:
// 共享目录 shared/schemas/order.ts
import { z } from "zod";

export const OrderSchema = z.object({
  orderId: z.string().uuid(),
  userId: z.number().int().positive(),
  amount: z.number().min(0.01),
  items: z.array(z.string().min(1)),
});

export type Order = z.infer<typeof OrderSchema>;

// 后端路由处理 server/routes/order.ts
import express from "express";
import { OrderSchema } from "../../shared/schemas/order";

const router = express.Router();
router.post("/api/orders", (req, res) => {
  const parseResult = OrderSchema.safeParse(req.body);
  if (!parseResult.success) {
    return res.status(400).json({ errors: parseResult.error.flatten() });
  }
  const validOrder = parseResult.data; // 类型严格推断为 Order
  res.status(201).json({ status: "success", orderId: validOrder.orderId });
});
三、数据处理场景为什么选Python
如果试图用JavaScript完成复杂的批量统计或数据清洗任务,开发者很快会遇到缺少原生矩阵表达、内存不可控膨胀以及缺失权威数学库的问题。Python在数据处理领域的统治力体现在三个层面:
- 矩阵与张量的高效存储:NumPy数组分配连续内存段,避免了JavaScript对象由于指针间接寻址带来的缓存缺失(Cache Miss)与内存碎片化。
- 丰富的专业管道工具链:从缺失值填补(Pandas)、统计建模(Statsmodels)、自动化特征工程(Scikit-Learn)到大数据交互(PySpark),成熟生态减少了自研轮子的风险。
- 数据探索的即时反馈:依托Jupyter Notebook与交互式解释器,分析人员可以在几秒钟内查看中间步骤的分布图表与分位数,这种工作流是传统编译或单次执行脚本难以比拟的。
实操示例:批量数据清洗与统计聚合
面对格式不统一的交易日志,使用Python进行缺失值修复、异常检测及按维度向量化聚合只需几行高阶API:
import pandas as pd
import numpy as np

# 读取并解析多源业务交易日志
raw_data = {
    "transaction_id": ["T101", "T102", "T103", "T104", "T105"],
    "amount": [128.5, np.nan, 340.0, -15.0, 520.0],
    "category": ["electronics", "books", "electronics", "fashion", "books"]
}
df = pd.DataFrame(raw_data)

# 1. 过滤无效负数金额
df = df[df["amount"] >= 0]

# 2. 均值补齐缺失值
df["amount"] = df["amount"].fillna(df["amount"].median())

# 3. 向量化分组聚合
summary = df.groupby("category")["amount"].agg(
    total_sales="sum",
    avg_ticket="mean",
    count="count"
).reset_index()

print("清洗与聚合结果示例:")
print(summary)
# 终端示例输出
清洗与聚合结果示例:
category total_sales avg_ticket count
0 books 340.0 340.0 1
1 electronics 468.5 234.25 2四、项目类型匹配决策流程
面对具体业务需求时,选型不应取决于团队成员的个人偏好,而应按照系统输入输出的本质属性进行递进式推导。以下步骤构成了一套标准选型评估路径:
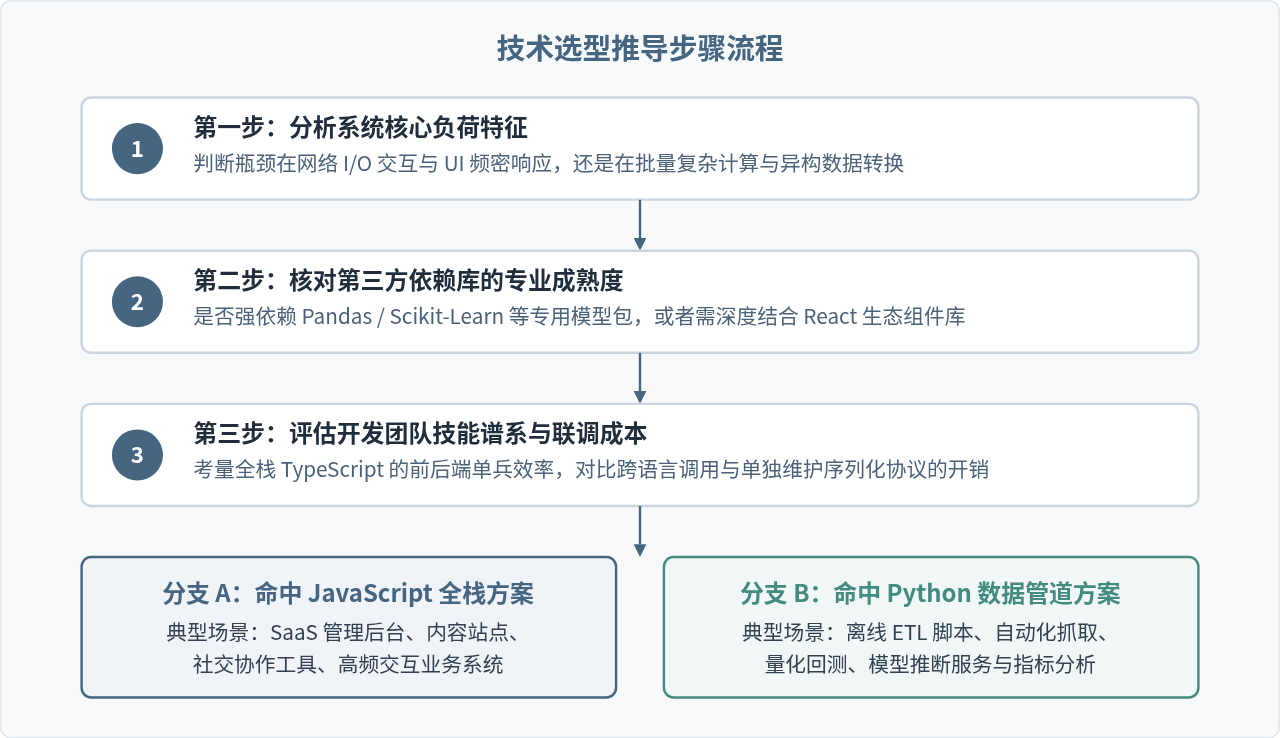
在具体工程落地时,读者可以通过以下对照表快速定位自己所处的项目类型:
| 评估维度 | 推荐 JavaScript / TypeScript | 推荐 Python |
|---|---|---|
| 典型项目形态 | SaaS管理后台、电商交易系统、实时协作看板、SSR前台门户 | 网络爬虫系统、离线ETL清洗、机器学习训练预测、自动化报告脚本 |
| 计算负荷类型 | 网络I/O密集型、JSON序列化与流转、DOM渲染 | CPU/内存向量计算密集型、复杂结构文件解析、矩阵运算 |
| 关键依赖工具 | React/Vue、Next.js、Node.js、Prisma、Express/NestJS | NumPy、Pandas、Polars、Scikit-Learn、PyTorch |
| 团队人员协同 | 全栈工程师单兵作战,前后端代码无缝阅读与协作 | 数据分析师、算法工程师与后端数据工程深度协同 |
五、常见混合架构:两者的协同协作
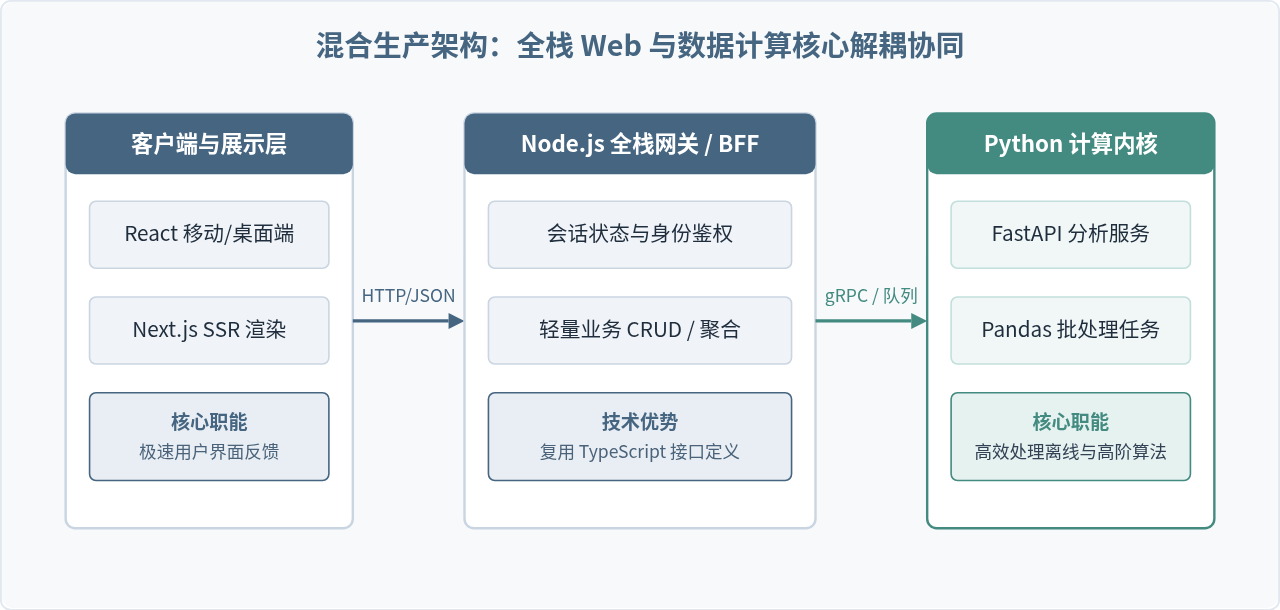
现实开发中,技术选型并非零和博弈。绝大多数中大型成熟产品选择“双核协作”:前端与对客BFF(Backend for Frontend)网关使用TypeScript保障用户体验与交付速度;后端的核心计算、文本挖掘或模型预测交由Python异步完成。
两者之间通过标准化的HTTP RESTful接口、gRPC或消息队列解耦,既发挥了JavaScript处理并发交互的长处,又利用了Python强大的数据计算基底。
六、选型避坑与边界提醒
在落地匹配过程中,需要重点防范以下两个常见误区:
- 误区一:认为JavaScript无法胜任任何后端任务。许多开发者误认为Node.js“只能做前端玩具”。事实上,对于I/O密集型的CRUD接口、高并发聚合代理与微服务BFF,基于TypeScript的Node.js生产力与执行效率极高。只有遇到强CPU计算时,单线程事件循环才需要借助Worker线程或下放至外部独立服务。
- 误区二:在Python中用逐行for循环处理大规模数据。Python数据处理的高效必须建立在“向量化(Vectorization)”基础之上。如果绕过NumPy/Pandas底层的C函数,直接用Python原生列表和for循环遍历百万行数据,运行效率将发生断崖式下跌。
七、核心总结
根据项目类型匹配语言的实质,是让代码逻辑最直接地贴近其运行环境的最优资源。Web全栈的核心资源是浏览器与终端用户交互管道,JavaScript/TypeScript在此具备天然的生态壁垒;数据处理的核心资源是内存矩阵与数学计算库,Python在该领域积累了数十年的工程资产。
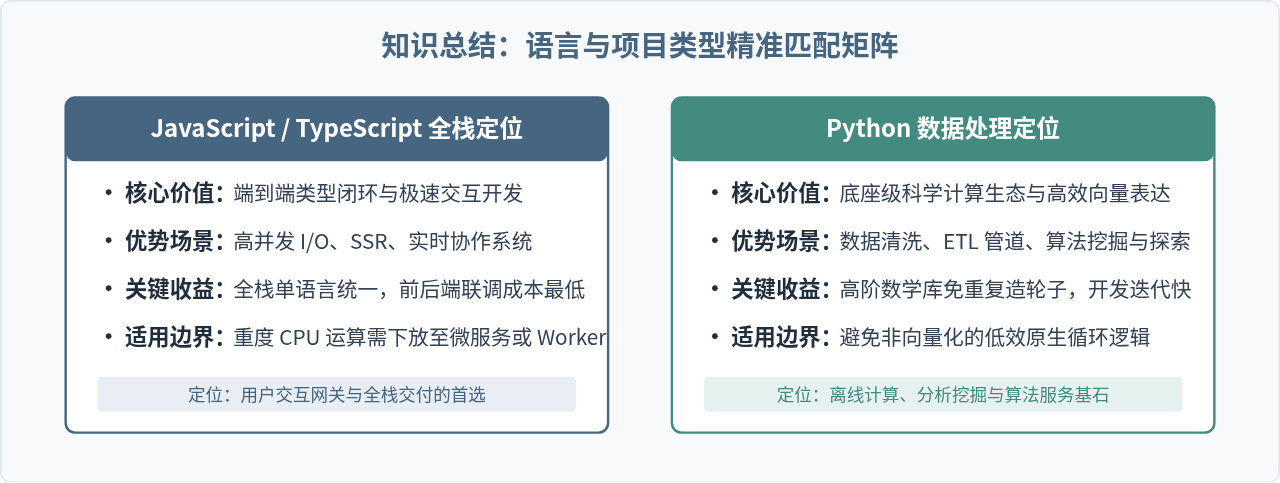
建立清晰的选型标准后,开发团队应当依据核心瓶颈做出决策,并在必要时运用现代轻量接口协议将两者连接起来,从而以最小的维护代价实现系统的最大产出。
Cube.js连接PostgreSQL或MySQL数据库的配置方法
2026-11-03 11:35:58
Node.js 实现 SQL 模糊查询的完整流程与转义处理
2026-10-31 14:58:16
微信小程序多张照片上传与展示实现详解
2026-10-31 12:38:27
解决MySQL数据赋给JS变量报unterminated string literal错误
2026-10-25 06:55:20
JavaScript中SQL语句的应用实现
2026-10-24 21:23:01







