

JavaScript读取文件出现乱码怎么解决
全面分析JavaScript在浏览器与Node.js环境中读取文件出现中文乱码的根本原因,并提供基于FileReader、TextDecoder与iconv-lite的完整解决方案与代码示例。
JavaScript读取文本文件出现中文乱码,核心原因几乎只有一种:解码时指定的字符集与文件实际保存的编码格式不匹配。在日常开发中,中文Windows系统默认常使用GBK(ANSI/Windows-936)格式保存文本或CSV文件,而现代浏览器与Node.js的默认读取逻辑通常假定文件为UTF-8。只要解码字典与原始编码不一致,字符就会显示为问号、乱码字符或“锟斤拷”。解决该问题的标准路径是:先明确文件的源编码,再根据运行环境(浏览器或Node.js)使用支持指定字符集的API(如FileReader.readAsText(file, 'gbk')、TextDecoder或Node.js下的iconv-lite)进行准确解码。
一、为什么会出现乱码:编码与解码的本质
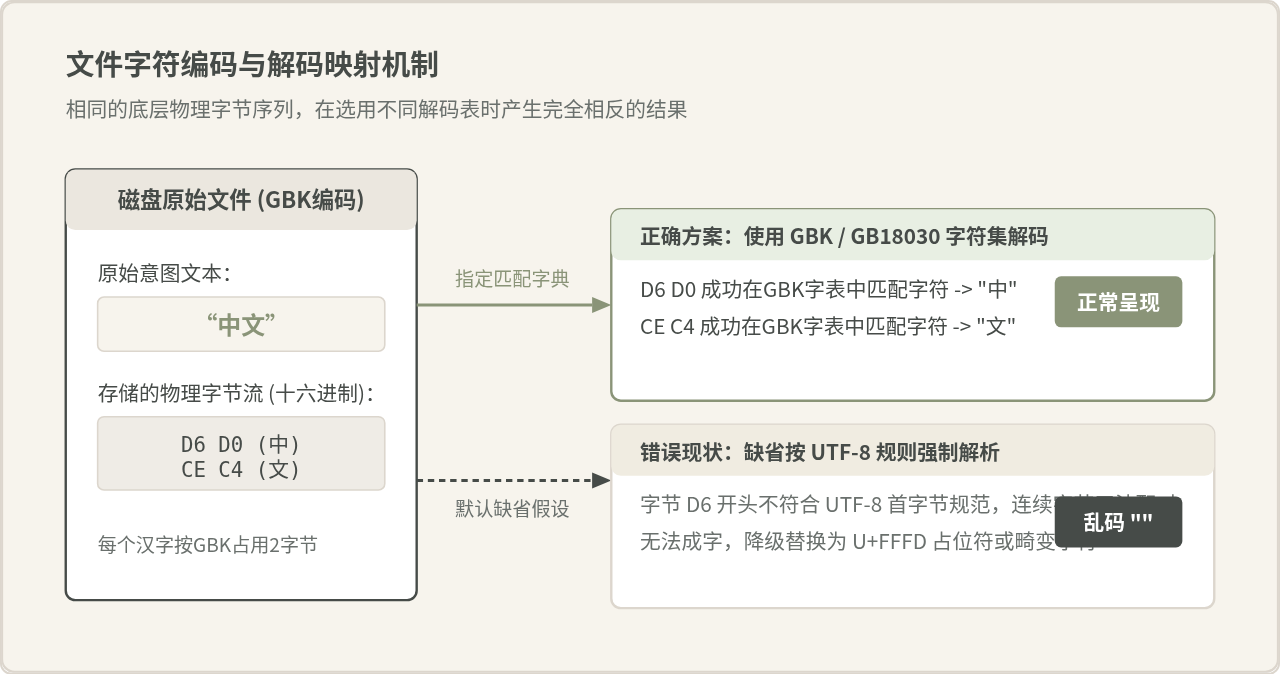
计算机在磁盘中存储任何文件时,本质上都只是一串连续的二进制字节序列。要将这串字节转换为人类可读的文字,就必须依靠“字符编码表”来进行一一映射。
例如,汉字“中文”在GBK编码下由4个字节构成(D6 D0 CE C4),每个汉字固定占用2个字节;而在UTF-8编码下,普通汉字通常占用3个字节。如果JavaScript程序默认按UTF-8规则去解析GBK的字节序列,遇到不符合UTF-8格式要求的字节时,便无法在编码表中定位到有效字符。此时系统会使用Unicode的“替换字符”U+FFFD(即黑底问号)代替,或者将其拼凑映射为奇怪的异体字与乱码符号。
二、常见认知误区与辨析
在排查乱码时,开发者常有一些看似合理但实际上存在偏差的理解,厘清这些概念有助于迅速锁定关键代码:
- 误区一:“网页已经配置了 <meta charset="UTF-8">,页面读取文件就不应该乱码。”
辨析:HTML中的meta标签仅用于告诉浏览器“当前网页文档本身的HTML代码是用UTF-8编写的”。当用户通过<input type="file">选择本地的一个GBK文本上传时,该文件的字节流编码完全由创建该文件的软件决定,与网页自身的meta设置毫无关系。 - 误区二:“只要把Node.js的编码参数改成gbk即可,例如 fs.readFile(path, 'gbk')。”
辨析:Node.js原生核心库仅支持utf8、utf16le、latin1、base64、hex和ascii等编码。直接传入'gbk'会被Node.js判定为无效编码或降级处理,依然无法正确还原文字。必须借助外部专业库如iconv-lite完成转换。 - 误区三:“所有乱码都是因为GBK造成的。”
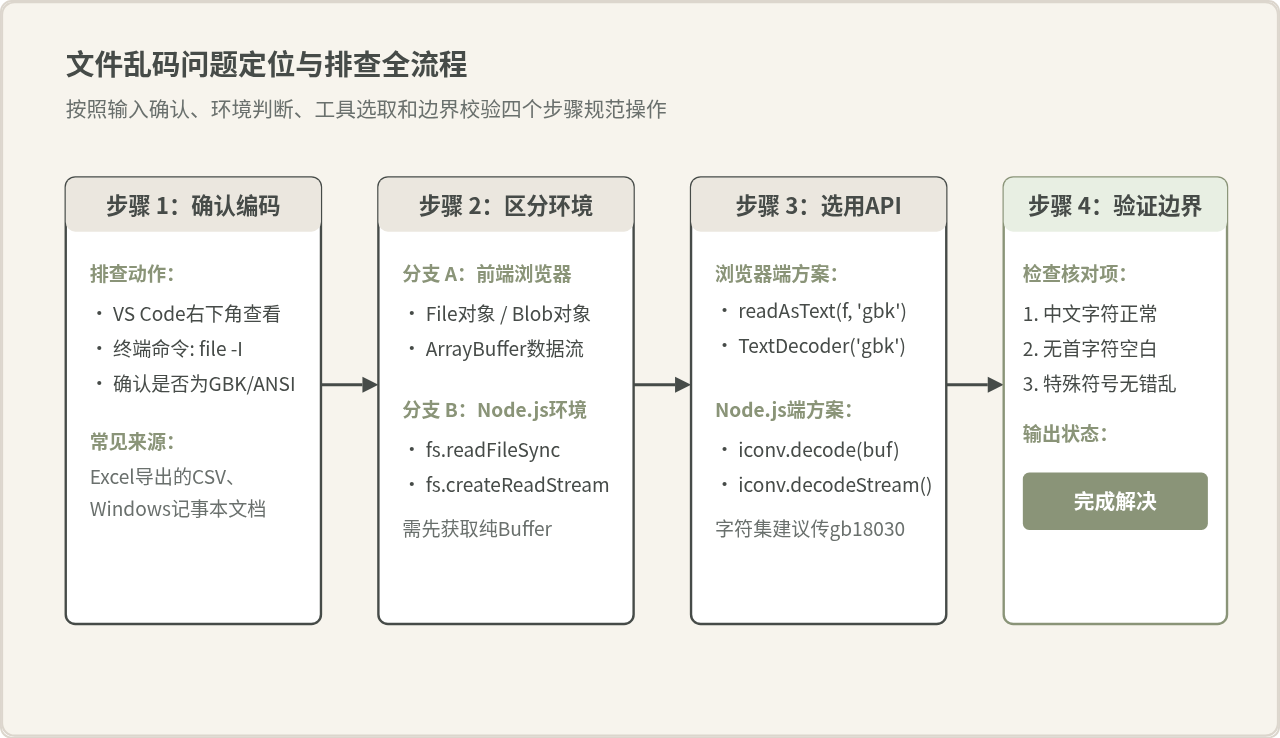
辨析:不一定。有些UTF-8文件在保存时被编辑器强行添加了BOM(Byte Order Mark,字节顺序标记,即文件头部的EF BB BF)。虽然正文能显示中文,但文件开头的第一个字符可能出现多余的空格、隐藏不可见字符或解析JSON失败,这也是一类典型的编码问题。
三、浏览器端读取文件乱码的解决方法
在前端浏览器环境中,最常见的文件来源是用户通过表单选择的本地文件,或者是通过网络请求获取的Blob数据。以下两种方式是最标准的解决方案:
方法 1:利用 FileReader.readAsText 传入编码参数
许多开发者习惯直接调用reader.readAsText(file),未传第二个参数时,浏览器默认以UTF-8读取。如果要读取中文Windows常见的GBK/ANSI文件,只需将第二个参数显式指定为'gbk'或兼容性更佳的'gb18030'。
// HTML: <input type="file" id="filePicker">
const picker = document.getElementById('filePicker');

picker.addEventListener('change', (event) => {
  const file = event.target.files[0];
  if (!file) return;

  const reader = new FileReader();

  // 监听读取完成事件
  reader.onload = (e) => {
    const textContent = e.target.result;
    console.log('读取成功,内容为:', textContent);
  };

  reader.onerror = () => {
    console.error('读取文件失败');
  };

  // 关键操作:明确指定第二个参数为 'gb18030' 或 'gbk'
  // GB18030向下完全兼容GBK和GB2312,且支持更多罕见字
  reader.readAsText(file, 'gb18030');
});
方法 2:使用现代 TextDecoder API 进行动态解码
如果文件数据是以ArrayBuffer形式获得(如调用file.arrayBuffer()或fetch二进制流),可以使用现代浏览器原生支持的TextDecoder接口。
async function readCustomFile(file) {
  // 1. 获取文件的原始二进制数据(ArrayBuffer)
  const buffer = await file.arrayBuffer();

  // 2. 构造指定编码的解码器
  // 如果是已知GBK文件,指定 gb18030
  const decoder = new TextDecoder('gb18030');

  // 3. 将二进制字节解码为标准字符串
  const resultText = decoder.decode(buffer);
  return resultText;
}实战建议:如果你无法预先得知用户上传的文件是UTF-8还是GBK,可以先通过TextDecoder('utf-8', { fatal: true })尝试解码。如果抛出异常,说明字节序列不符合合法UTF-8规范,此时在catch中降级采用TextDecoder('gb18030')重新解码。
四、Node.js 环境下读取文件乱码的解决方法
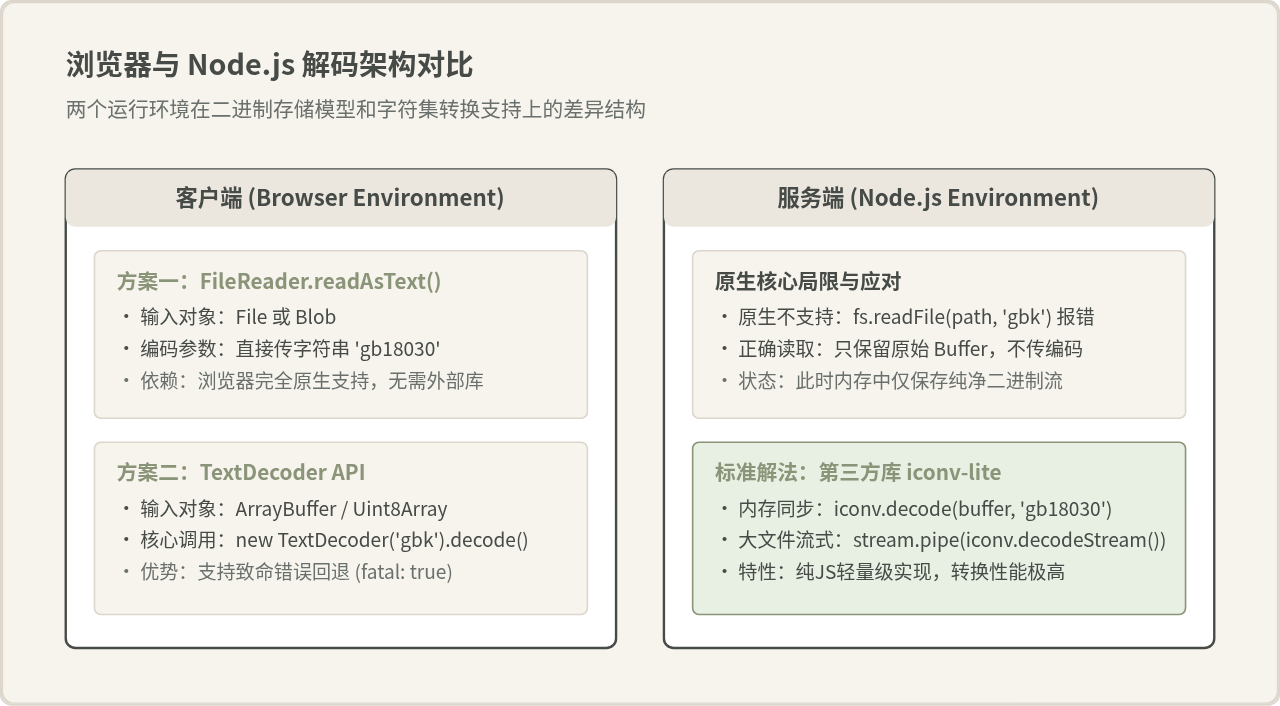
在Node.js中,由于原生文件模块fs不支持GBK,正确的处理逻辑是:先以无编码的纯Buffer形式读取文件,保留其原始二进制字节,再使用成熟的转换库进行解码。
安装与引入 iconv-lite
在项目中执行如下命令安装解码库:
npm install iconv-lite完整示例:读取GBK文件并输出正确中文
const fs = require('fs');
const iconv = require('iconv-lite');

function readGbkFileSync(filePath) {
  try {
    // 步骤 1:不要传入 'utf-8',保持原生 Buffer 二进制形式
    const rawBuffer = fs.readFileSync(filePath);

    // 步骤 2:使用 iconv-lite 对 Buffer 进行 gbk 解码
    const content = iconv.decode(rawBuffer, 'gb18030');

    console.log('文件解析成功:');
    console.log(content);
    return content;
  } catch (err) {
    console.error('读取发生异常:', err);
  }
}

// 示例调用
readGbkFileSync('./user_data_gbk.csv');
处理超大文件的流式解码
如果需要处理几十兆或几百兆的大型日志与数据表,将整文件一次性加载至内存可能引发内存溢出。此时可借助iconv-lite提供的流转换器:
const fs = require('fs');
const iconv = require('iconv-lite');

fs.createReadStream('./huge_log_gbk.txt')
  .pipe(iconv.decodeStream('gb18030'))
  .on('data', (chunk) => {
    // 这里的 chunk 已经是正确解码后的中文字符串
    process.stdout.write(chunk);
  })
  .on('end', () => {
    console.log('\n流式文件读取完毕');
  });
五、运行环境与核心API实现对比
为了让不同技术栈的开发者能够直观选取最合适的工具,下表梳理了浏览器端与Node.js端的主要处理方式与适用场景:
六、易忽视的边界场景与应对细节
1. 为什么优先推荐 'gb18030' 而不是 'gbk' 或 'gb2312'?
在中国国家标准字符集中,演变顺序为 GB2312 -> GBK -> GB18030。后发布的标准完全向下兼容前者。GB2312仅收录了6763个常用汉字;GBK扩展到了2万多个;而GB18030不仅收录了更多少数民族文字和生僻字,还收录了繁体字及大量特殊符号。在编码参数中传入'gb18030',能极大降低因文本包含生僻人名或特殊符号而再次出现个别字乱码的几率。
2. UTF-8 文件中的 BOM 标记清除
如果文件使用UTF-8编码,但首行在某些解析器中报错,通常是由于文件首部存在3个十六进制标记字节(0xEF, 0xBB, 0xBF)。在Node.js中,可以通过简单的Buffer截取将其剔除:
function stripBom(buffer) {
  // 判断前三个字节是否为 UTF-8 BOM 标记
  if (buffer[0] === 0xEF && buffer[1] === 0xBB && buffer[2] === 0xBF) {
    // 裁剪掉前三个字节
    return buffer.subarray(3);
  }
  return buffer;
}

const rawBuf = fs.readFileSync('export_data.csv');
const cleanBuf = stripBom(rawBuf);
const text = cleanBuf.toString('utf-8');
七、常见场景与解决策略速查总结
在实际业务开发中,可以对照以下总结表格与速查矩阵,根据具体遇到的文件形态快速应用相应处理策略:
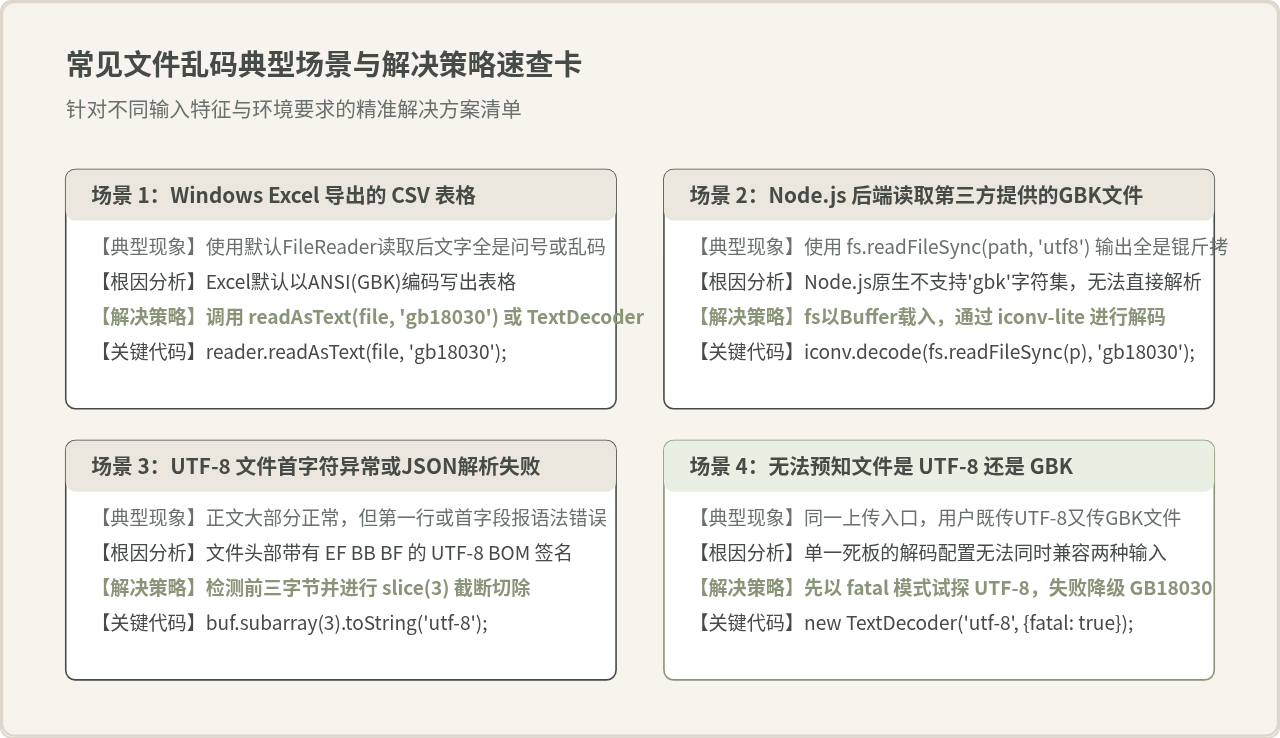
综上所述,解决JavaScript读取文件乱码的关键在于“不要把编码交给默认设置去猜测”。只要按照源文件编码选用对应的解码方式,并指定覆盖范围更广的gb18030,无论是浏览器中的本地文件读取,还是Node.js环境下的数据处理,都可以稳定、可靠地消除中文乱码问题。
全栈开发中JavaScript与Java怎么协作?前后端技术栈配合解析
2026-11-04 11:08:24
Node.js官网访问慢?国内镜像加速下载方案
2026-11-03 18:57:24
Node.js 连接 MySQL 数据库实现增删改查操作
2026-11-03 14:31:14
Windows系统安装Node.js:下载、配置与环境验证
2026-11-03 14:15:56
Linux (Ubuntu/CentOS) 环境下安装Node.js的常用方法
2026-11-03 10:18:39







