

JavaScript数组遍历方法对比与使用实例
深入对比JavaScript中常见数组遍历方法的核心特性、返回值差异、break中断支持、异步处理及具体使用实例与选型指南。
在 JavaScript 开发中,数组遍历是最频繁的基础操作之一。从经典的 for 循环,到 ES5 引入的 forEach、map、filter、reduce 等高阶方法,再到 ES6 普及的 for...of 迭代器语法,每种遍历方式在设计定位、执行效率、返回值构造以及循环控制(如 break 中断和异步 await 等待)上存在本质区别。选择遍历方法的核心不在于语法的“新”与“旧”,而在于操作意图的准确匹配与执行环境的约束。本文通过分类拆解、横向对比和针对性代码实例,系统梳理常用数组遍历方法的运行机制与选型依据。
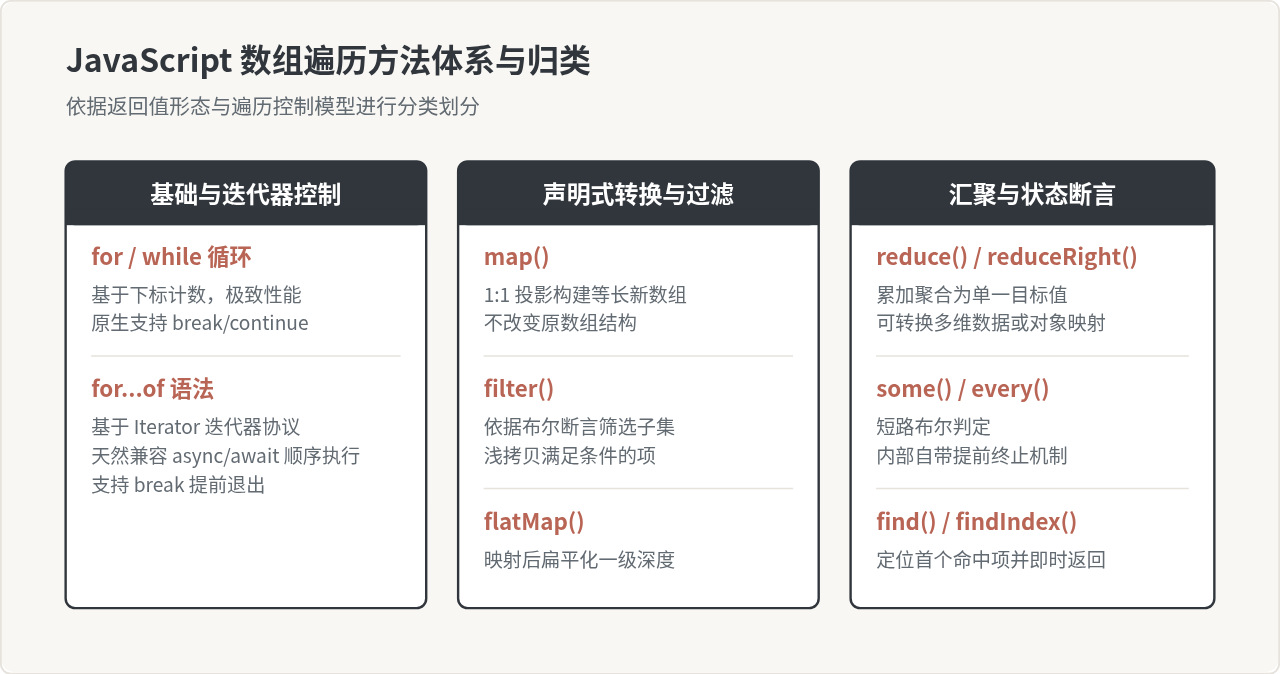
一、核心遍历方法特性与语法解析
在日常业务开发中,开发者接触最多的遍历手段集中在命令式循环(for、for...of)和函数式迭代器(forEach、map、filter、reduce)。这些方法在控制流与返回值设计上有显著分野。
1. 经典计数循环:for 循环
传统的 for (let i = 0; i < arr.length; i++) 属于指令式遍历。引擎直接通过索引访问内存地址,无需创建函数调用上下文或迭代器对象,因此在性能敏感的计算场景中具有最高的执行效率。
const numbers = [10, 20, 30, 40, 50];
let matchedIndex = -1;

for (let i = 0; i < numbers.length; i++) {
  if (numbers[i] === 30) {
    matchedIndex = i;
    break; // 立即跳出循环,避免无效计算
  }
}
// 示例输出: matchedIndex = 2关键特点:原生支持 break 和 continue 语句;支持倒序遍历或自定义步长;在稀疏数组中也会访问未定义的空洞槽位。
2. 迭代器协议巡检:for...of 循环
ES6 引入的 for...of 语句利用数组内置的 Symbol.iterator 协议工作。相较于传统 for 循环,其语法更简洁,直接提取元素值本身,同时保留了语句级流程控制能力。
const fruits = ['Apple', 'Banana', 'Cherry'];

for (const fruit of fruits) {
  if (fruit === 'Banana') {
    continue; // 跳过当前迭代
  }
  console.log(fruit);
}
// 示例输出:
// Apple
// Cherry关键特点:支持 break、continue 与 return;能够与 async/await 配合实现真正的串行异步处理;若需要获取索引,可搭配 fruits.entries() 解构使用。
3. 副作用消费:forEach()
forEach 是专为产生副作用(如记录日志、修改外部变量、发送网络请求等)而设计的遍历方法。该方法没有返回值(恒定返回 undefined),且无法被普通语法中断。
const logs = ['Info: init', 'Warn: disk full', 'Error: timeout'];
const collectedErrors = [];

logs.forEach((item, index) => {
  if (item.startsWith('Error:')) {
    collectedErrors.push({ index, message: item });
  }
});
// 示例输出: collectedErrors = [{ index: 2, message: 'Error: timeout' }]注意:在 forEach 的回调函数中使用 return 仅代表结束当前单次执行(等效于循环体内的 continue),绝不能中止整个数组的后续遍历。
4. 映射转换与条件过滤:map() 与 filter()
map 与 filter 均遵循不可变数据模式,不会修改原始数组,而是产生一个全新的数组结果:
map(callback):生成一个与原数组长度严格一致的新数组,每一项由回调函数的返回值填充。filter(callback):生成一个原数组的子集,仅保留回调返回真值(truthy)的元素。
const rawPrices = [25, 40, 10, 80, 5];

// 场景 1: map 投影加工,长度保持 5
const formatted = rawPrices.map(price => `¥${price.toFixed(2)}`);
// 示例输出: ["¥25.00", "¥40.00", "¥10.00", "¥80.00", "¥5.00"]

// 场景 2: filter 条件过滤,筛选高额项目
const highTier = rawPrices.filter(price => price >= 30);
// 示例输出: [40, 80]
5. 多维汇聚计算:reduce()
reduce 接收一个累加器(accumulator)函数和一个可选的初始值,通过自左向右依次处理数组元素,最终产出单一复合值(数字、对象或合并数组)。
const cart = [
  { id: 1, name: 'Book', price: 32, count: 2 },
  { id: 2, name: 'Pen', price: 5, count: 10 },
  { id: 3, name: 'Ruler', price: 8, count: 1 }
];

// 计算订单总金额,指定初始值为 0
const totalAmount = cart.reduce((accumulator, item) => {
  return accumulator + (item.price * item.count);
}, 0);
// 示例输出: 32*2 + 5*10 + 8*1 = 122
二、关键技术维度横向对比
为了让不同场景下的选型更加明确,我们需要从以下几个核心维度对常见遍历方法进行严格对比:
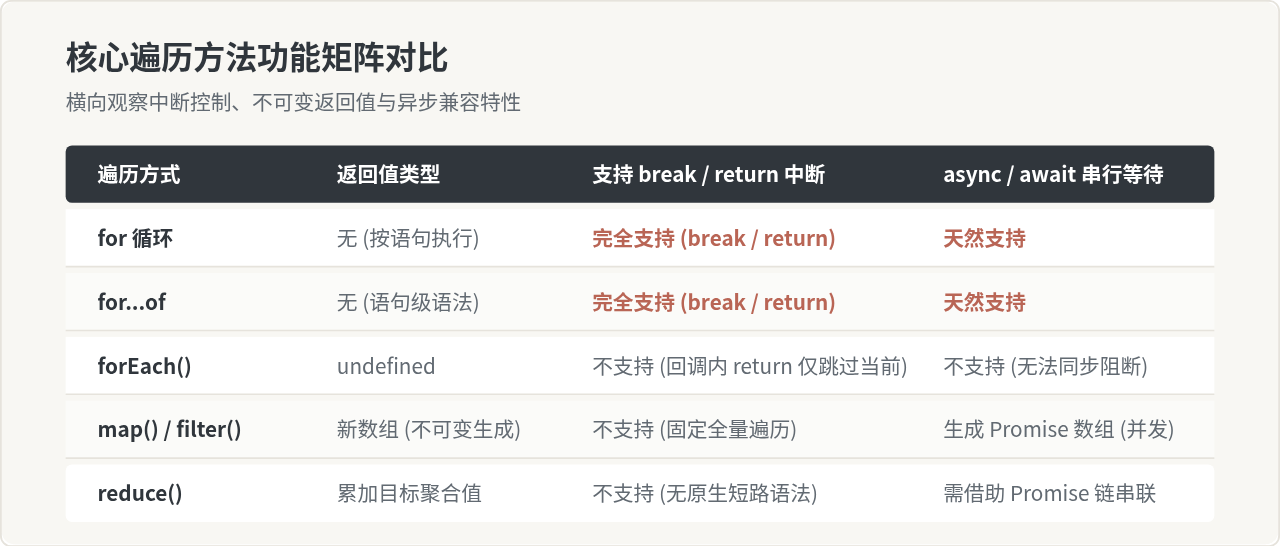
1. 中断控制与短路机制
当数组规模庞大且目标已达成时,能否提前退出循环对降低时间复杂度至关重要:
- 完全支持立即中断:
for、while、for...of原生支持使用break语法跳出,消耗极低。 - 内置条件短路:
some()在遇到首个返回true的项时立即终止后续迭代;every()在遇到首个返回false的项时立即终止。 - 无法直接中断:
forEach、map、filter。即使在函数体内写return,也只能结束当前这一次回调函数的执行,宿主遍历循环仍会继续访问后面的所有元素。
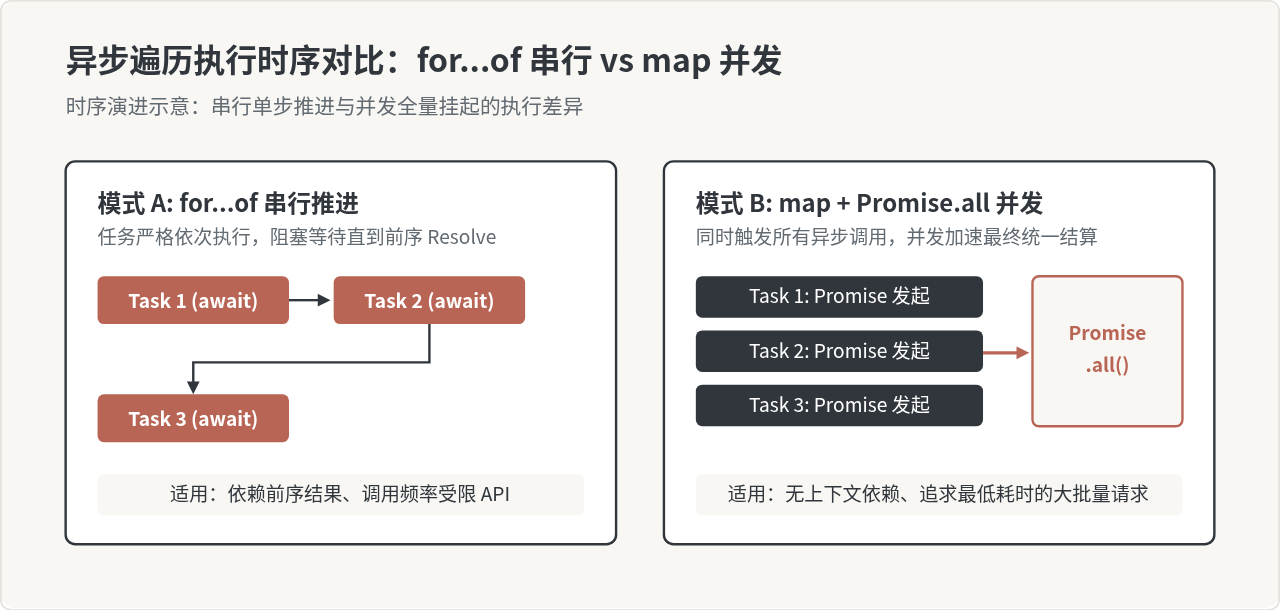
2. 异步处理:并发与串行执行的陷阱
在涉及网络请求或 I/O 操作时,对遍历方法的异步机制理解偏差极其容易导致逻辑缺陷:
// 错误示范:在 forEach 中使用 async/await 无法实现串行等待
async function processSequentiallyWrong(items) {
  items.forEach(async (item) => {
    // forEach 源码内部不会等待该 Promise resolve,而是同步调度下一个回调
    await fetch('/api/save', { method: 'POST', body: JSON.stringify(item) });
  });
  console.log('所有请求完成? 不,此时很可能还在并发网络请求中!');
}

// 正确解法 1: 严格串行执行(前一个请求完成后再发下一个)
async function processSequentiallyRight(items) {
  for (const item of items) {
    await fetch('/api/save', { method: 'POST', body: JSON.stringify(item) });
  }
  console.log('严格串行处理完成');
}

// 正确解法 2: 并发发起并通过 Promise.all 等待全部结算
async function processConcurrently(items) {
  const promises = items.map(item =>
    fetch('/api/save', { method: 'POST', body: JSON.stringify(item) })
  );
  await Promise.all(promises);
  console.log('全部并发请求已完成');
}
三、经典业务场景使用实例
1. 数据清洗与格式归一化
在处理后端返回的原始列表时,经常需要滤除空值,并将字段转换为前端视图所需的结构。链式调用 filter 与 map 能够清晰表达这一转换意图。
const rawUsers = [
  { id: 101, username: 'alice', active: true },
  { id: 102, username: 'bob', active: false },
  { id: 103, username: null, active: true },
  { id: 104, username: 'david', active: true }
];

// 步骤:剔除未激活或无用户名的项,并将用户名规范化为大写展示
const activeUserLabels = rawUsers
  .filter(user => user.active && typeof user.username === 'string')
  .map(user => ({
    userId: user.id,
    displayName: user.username.toUpperCase()
  }));

// 示例输出:
// [
//   { userId: 101, displayName: 'ALICE' },
//   { userId: 104, displayName: 'DAVID' }
// ]
2. 高性能按键分组与计数(reduce)
当需要把一维扁平列表按某一特征维度归纳为字典或分类对象时,reduce 是一步到位的理想工具,无需在外部声明可变的中间临时容器。
const transactions = [
  { type: 'income', amount: 1200 },
  { type: 'expense', amount: 350 },
  { type: 'income', amount: 800 },
  { type: 'expense', amount: 150 }
];

const summary = transactions.reduce((acc, curr) => {
  acc[curr.type] = (acc[curr.type] || 0) + curr.amount;
  return acc;
}, { income: 0, expense: 0 });

// 示例输出: summary = { income: 2000, expense: 500 }
3. 快速查找与状态短路验证
如果业务目标只是判断数组中是否存在满足某条件的元素,切勿使用 filter(fn).length > 0。这种写法会无意义地遍历整个数组并创建临时数组对象;应直接使用具有短路特性的 some 或 find。
const inventory = [
  { sku: 'A1', stock: 12 },
  { sku: 'B2', stock: 0 },
  { sku: 'C3', stock: 5 }
];

// 判定是否存在缺货商品 (遇到 B2 立即返回 true 并停止后续计算)
const hasOutOfStock = inventory.some(item => item.stock === 0);

// 获取首个缺货的条目对象 (返回该对象引用并立即终止)
const firstDeficitItem = inventory.find(item => item.stock === 0);

// 示例输出: hasOutOfStock = true, firstDeficitItem = { sku: 'B2', stock: 0 }
四、异步任务队列执行机制
在面对带有时间等待(如延时重试、防并发限流或依序入库)的遍历需求时,清晰理解不同遍历方式底层对于 Promise 任务的调度过程至关重要。
五、综合选型总结与决策指南
在工程实践中,代码的可读性、意图明确性和运行时稳健性往往比单一基准性能微优化更有价值。遵循以下决策流程,可帮助开发者在几秒钟内确定最合理的数组遍历方案:
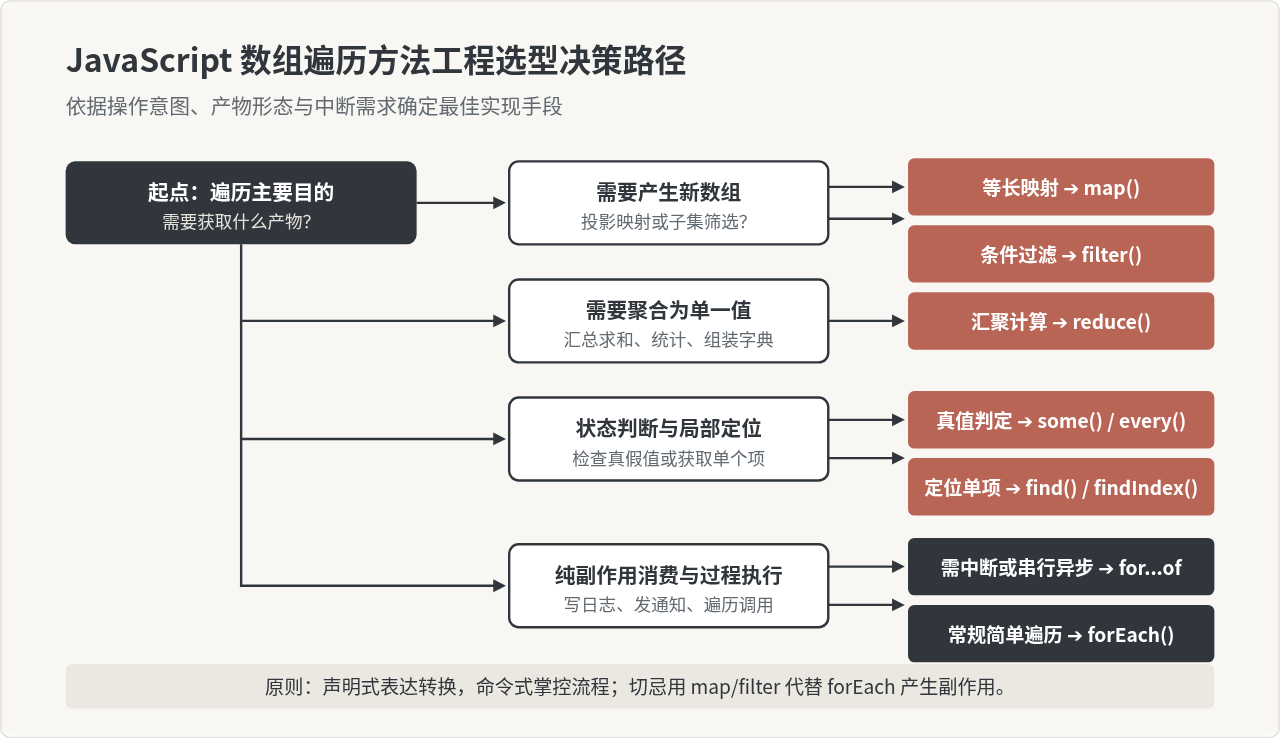
总结而言,现代 JavaScript 中的数组遍历已全面转向“语义优先”:
- 若需要将数据结构变形,优先使用
map; - 若需要提取满足特性的子集,使用
filter; - 若仅需要判定真假状态,使用带短路能力的
some或every; - 若涉及复杂流程中断(
break)或严格的async/await顺序执行,for...of是最稳健的选择; - 而在数据量级达到数百万的算法密集型场景下,传统的
for循环依然是兼顾可控性与执行性能的基石。
ES6模块化中js文件怎么用import和export交互
2026-11-05 17:00:48
JS读取本地文件时报错或无响应的常见原因
2026-11-05 16:32:31
let、const与var的区别:JavaScript变量声明最佳实践
2026-11-05 14:16:38
JS中直接定义静态二维数组的字面量写法
2026-11-05 14:16:08
JS 怎么查找字符串中所有匹配项的位置
2026-11-05 14:15:53







