

JavaScript 前端解析 Word 文档为 HTML 实战
本文介绍如何在 JavaScript 环境中将 Word 文档(docx)转换为浏览器可识别的 HTML。通过解析 docx 内部 XML 结构,利用 Mammoth 库提取语义信息并生成 HTML。文章详细讲解了前端解析方案,包括处理图片上传、base64 替换及自定义样式映射,并提供 Node.js 与浏览器环境下的具体代码实现。
前言
近期接到一个需求:领导要求实现类似某知名办公软件的 Word 文档导入功能,即解析上传的 Word 文档内容,并将其渲染到富文本编辑器中进行编辑。具体效果参考如下:
面对这个需求,我们该如何实现?难道要手动编写一个复杂的解析器吗?
本文将分享将 Word 文件转换为浏览器可识别 HTML 的实战经验。
什么是 Word 文档
Word 是微软公司开发的文字处理应用程序,属于 Office 套件的一部分。利用 Microsoft Office Word,用户可以创建和编辑信件、报告、网页或电子邮件中的文本与图形。相比写字板和记事本,Word 功能更强大,性能更全面,支持插入图片、多媒体及艺术效果等。
Word 支持的文件格式
以下列举 Word 常用的几种文件格式:
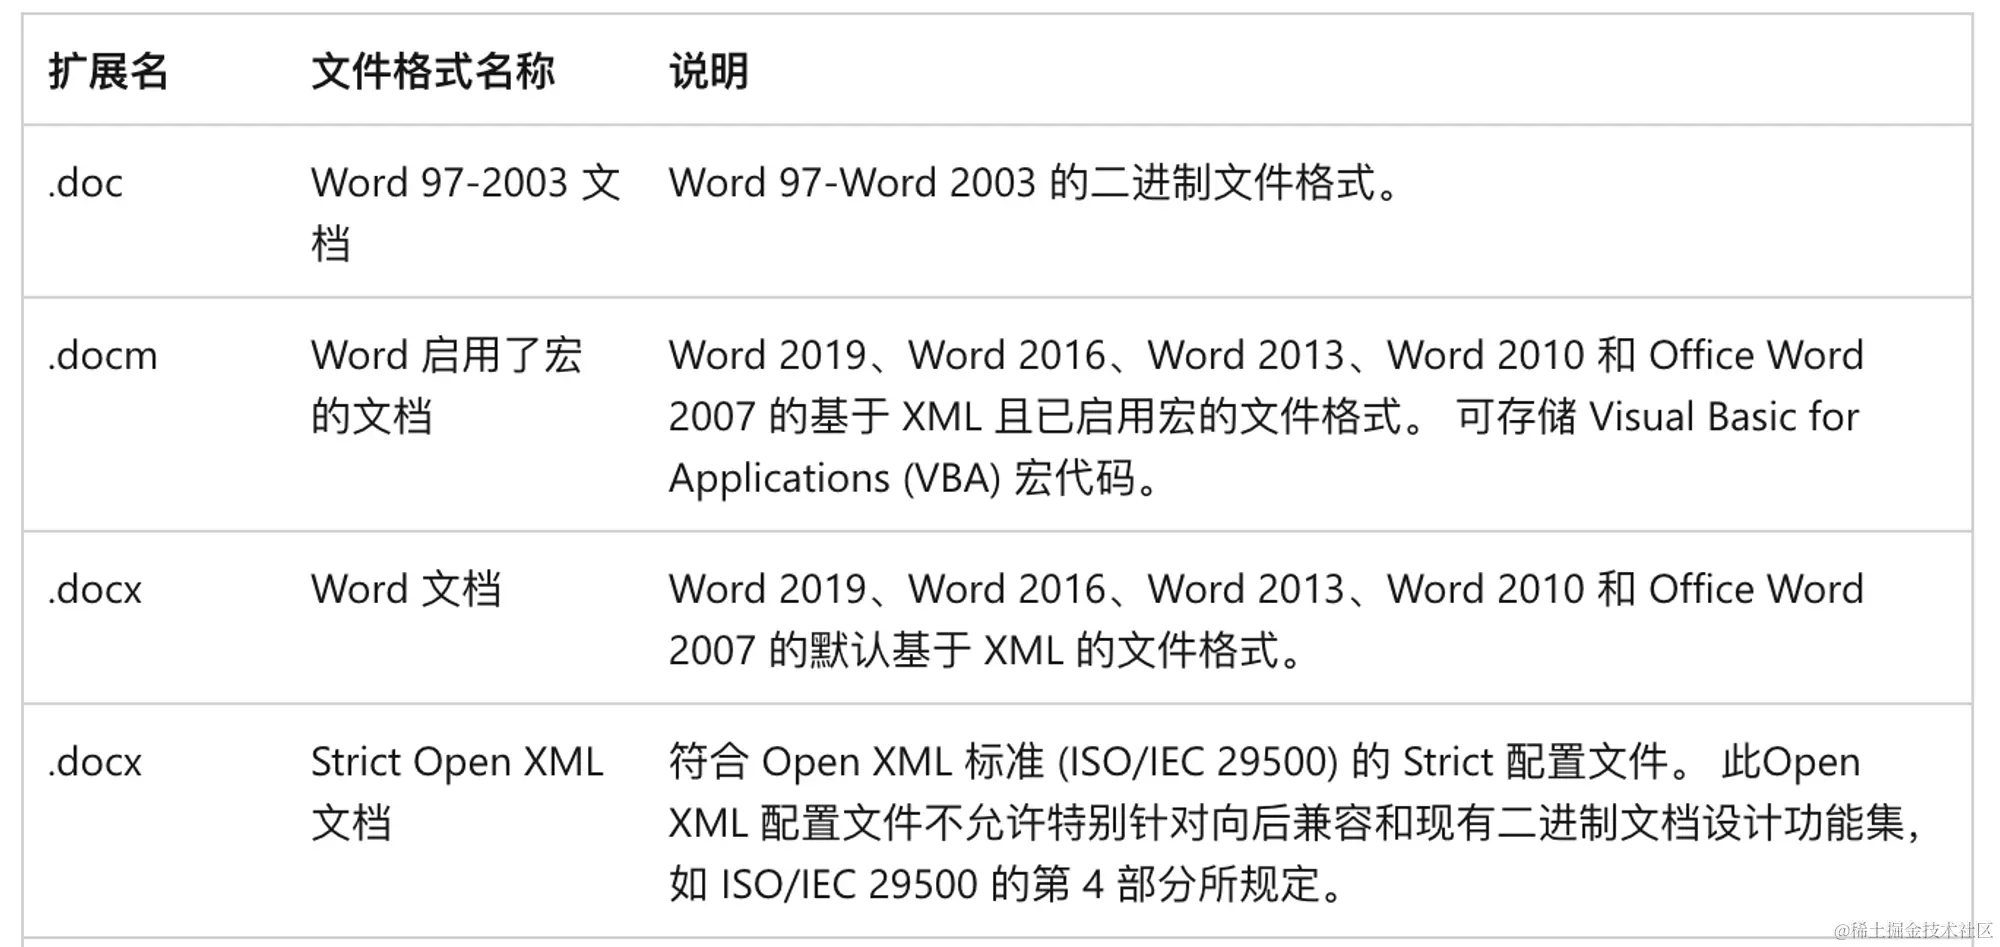
Word 支持的文档格式种类繁多,感兴趣的读者可以查阅 Word、Excel 和 PowerPoint 的文件格式参考文档。
docx 与 doc 的区别
Word 文档格式中,最常见的两种后缀名是 docx 和 doc。
既然有了 doc 格式,为何后来又出现了 docx?
网上流传着一个故事:从某一时期开始,微软办公文件的后缀名多了一个“x”。此前,Word、PowerPoint 和 Excel 的后缀名分别为 doc、ppt 和 xls。随后,docx、pptx 和 xlsx 格式突然涌现。
原来的 doc 格式采用二进制加密,只有微软自家的软件才能打开。
后来微软意识到,这种封闭策略并未让自己显得“神圣”,反而限制了自身的发展。
例如,金山 WPS 等办公软件发展迅速,积累了大量用户。许多用户开始转向使用 WPS,导致 Word 的用户群体面临被瓜分的风险。为此,微软基于 Office Open XML 标准,对文档家族进行了兼容处理。
由于新标准采用 XML 格式记录信息,因此在 .doc 后加了个“x”。在新标准下,即使是微软创建的文档,WPS 也能打开。这样,用户只需关注文档内容,无需在意使用哪个软件,从而实现了用户共享。
当然,我无法验证这个故事是否真实,这仅是听说而已。
简单总结两者的区别:
- docx 相比 doc 文件体积更小,对复杂对象的处理能力也更强。
- docx 旨在替代 doc:自 Microsoft Word 2007 版本开始,docx 已取代 doc,且 doc 格式不再进行开发。
- doc 是二进制文件,而 docx 是 XML 文件。docx 扩展名可修改为 zip 或 rar 等压缩包格式,使用压缩软件打开后可查看内部各类文件,从而实现批量替换图片等功能。
Word 文档转 HTML 实战
目前市面上实现该功能的方案主要有两种:
- 前端将 Word 文档上传给后端,由后端进行解析,然后通过接口将解析后的内容返回给前端。
- 前端直接解析,将解析后的内容渲染出来或传递给后端。
两种方案各有优劣,具体选择需视业务场景而定。
本文仅分享方案二的实现方式。若想了解后端解析方案,请参阅《Word 转换 HTML(Java 实用版)》。
如何解析
docx 看似是一个文件,实际上它是一个压缩包,其文件结构如下:
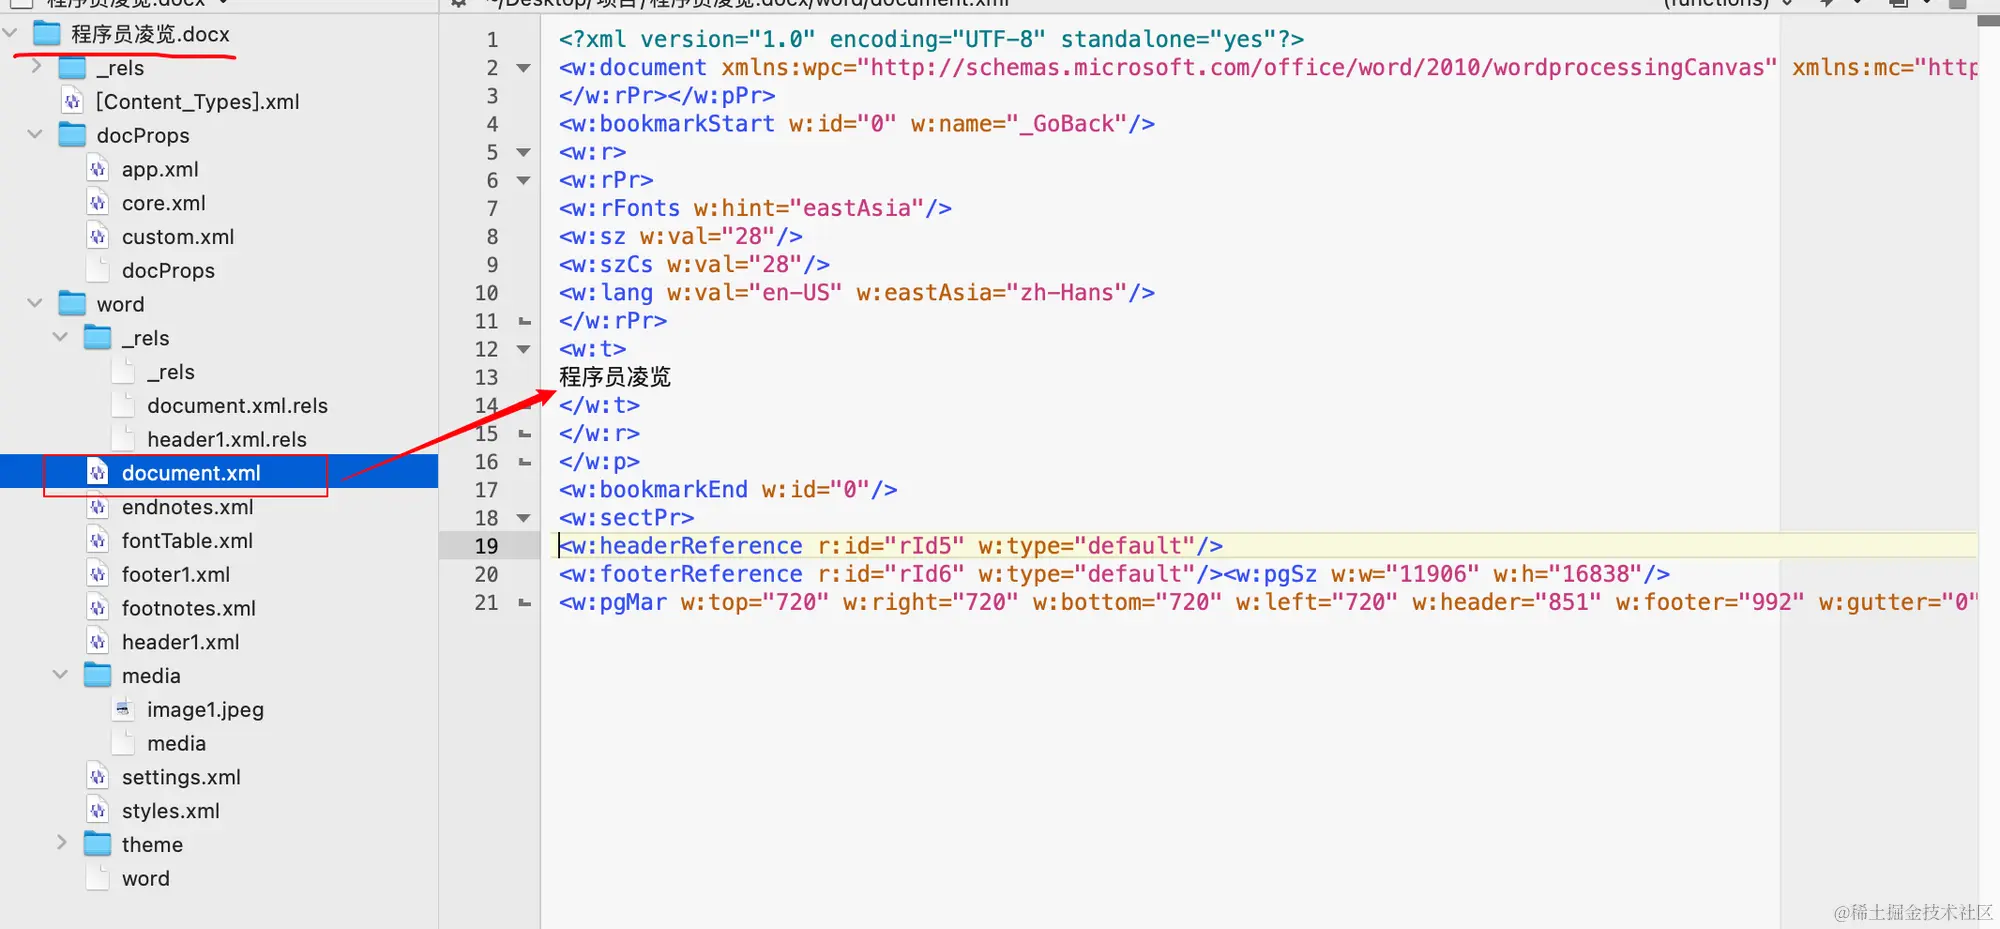
位于 word 目录下的 document.xml 文件是 docx 的主文件。文档中你能看到的所有内容,在这里都有直接或间接的记录。
document.xml 中的内容都被 XML 标签包裹,将 XML 标签转化为 HTML 标签即可实现 Word 到 HTML 的转换。
前提是对 XML 标签熟悉,否则无法盲目转换。
不用担心,即使不熟悉也没关系,我们可以站在前人的肩膀上完成这一步。
Mammoth 是什么
Mammoth 是一个专注于转换 .docx 文档的工具库,它能将 Microsoft Word、Google Docs 和 LibreOffice 创建的文档转换为 HTML。Mammoth 利用文档的 XML 语义信息,忽略其他细节,从而生成简洁明了的 HTML。例如,Mammoth 会将任何带有标题 1 样式的段落转换为 h1 元素,但不会复制标题的样式(如字体、文字大小、颜色等)。
Mammoth 支持以下功能:
- 标题
- 列表
- 标题
- 列表
- 可定制的 docx 样式到 HTML 的映射。例如,您可以通过提供适当的样式映射,将 WarningHeading 转换为 h1.warning。
- 表格:表格格式(如边框)会被忽略。
- 脚注和尾注
- 图片
- 粗体、斜体、下划线、删除线、上标和下标。
- 链接
- 换行
- 文本框:文本框的内容被视为一个单独的段落,出现在包含文本框的段落之后。
- 注释
Mammoth 提供了支持将 docx 转换成 Markdown、HTML、纯文本的方法。
Mammoth 实战
Mammoth 官方 demo:
const mammoth = require("mammoth");

mammoth.convertToHtml({path: "path/to/document.docx"})
    .then(function(result){
        const html = result.value; // 转换的HTML
        const messages = result.messages;
    })
    .catch(function(error) {
        console.error(error);
    });
这是在 Node.js 环境中的案例,浏览器环境无法通过 {path: "path/to/document.docx"} 来读取到 docx 文件。
如果要在浏览器环境中执行,需要将 docx 文件转化为 arrayBuffer 数组,再作为参数传递给 convertToHtml:
const  updateWord = {
	handleFileSelect(event) {
			const self = this
			this.readFileInputEventAsArrayBuffer(event, function (arrayBuffer) {
			    mammoth.convertToHtml({ arrayBuffer: arrayBuffer }, {
							//...
					})
			}
  },
	//文件转化成arrayBuffer数据类型
	readFileInputEventAsArrayBuffer(event, callback) {
      const file = event.target.files[0];
      const reader = new FileReader();
      reader.onload = function (loadEvent) {
          const arrayBuffer = loadEvent.target.result;
          callback(arrayBuffer);
      };
      reader.readAsArrayBuffer(file);
  }
}

//获取文件file后,传递给handleFileSelect函数
updateWord.handleFileSelect(file)
Word 文档中可能包含图片,Mammoth 默认会将图片转换为 base64 格式,导致生成的 HTML 内容体积巨大。通常情况下,我们希望将图片上传到自己的服务器,HTML 内容仅保留图片链接。
Mammoth 也提供了相应的方法:
const  updateWord = {
 //base64格式转blob
	base64ToBlob(base64, mimeType) {
        let bytes = window.atob(base64);
        let ab = new ArrayBuffer(bytes.length);
        let ia = new Uint8Array(ab);
        for (let i = 0; i < bytes.length; i++) {
            ia[i] = bytes.charCodeAt(i);
        }
        return new Blob([ia], { type: mimeType });
  },

	handleFileSelect(event,{success, fail}) {
			const self = this
			this.readFileInputEventAsArrayBuffer(event, function (arrayBuffer) {
			   mammoth.convertToHtml({ arrayBuffer: arrayBuffer }, {
                //处理图片
                convertImage: mammoth.images.imgElement(function (image) {
                    return image.read("base64").then(async (imageBuffer) => {
                        //base64转blob
                        const blob = self.base64ToBlob(imageBuffer, 'image/png')
                        blob.name = Date.now() + '.png'
                        const result = await new Promise((resolve, reject) => {
	                            //图片上传逻辑,可以自定义
															upImage({ file: blob }, {
                                resolve,
                                reject
                            })
                        })
                        const url = result.default
                        return {
                            src: url
                        }
                    });
                })
            }).then(success, fail);
			}
  },
//...
}
upImage 是上传图片到自己服务器的逻辑,该逻辑由用户自定义实现,只要最后将图片链接返回给 return {src: url},它便会将 base64 替换掉。
至此,完成 Word 文档转换 HTML,又能摸鱼了。
更高级的摸鱼
在日常学习和工作中,经常遇到某个项目开发上线某个功能后,另一个项目也提出相同的功能需求。历史总是惊人的相似。
为了以后遇到类似需求时能直接使用,我将 docx 文件转换 HTML 这段代码保存在 CodeGist 中,方便下次直接引用。
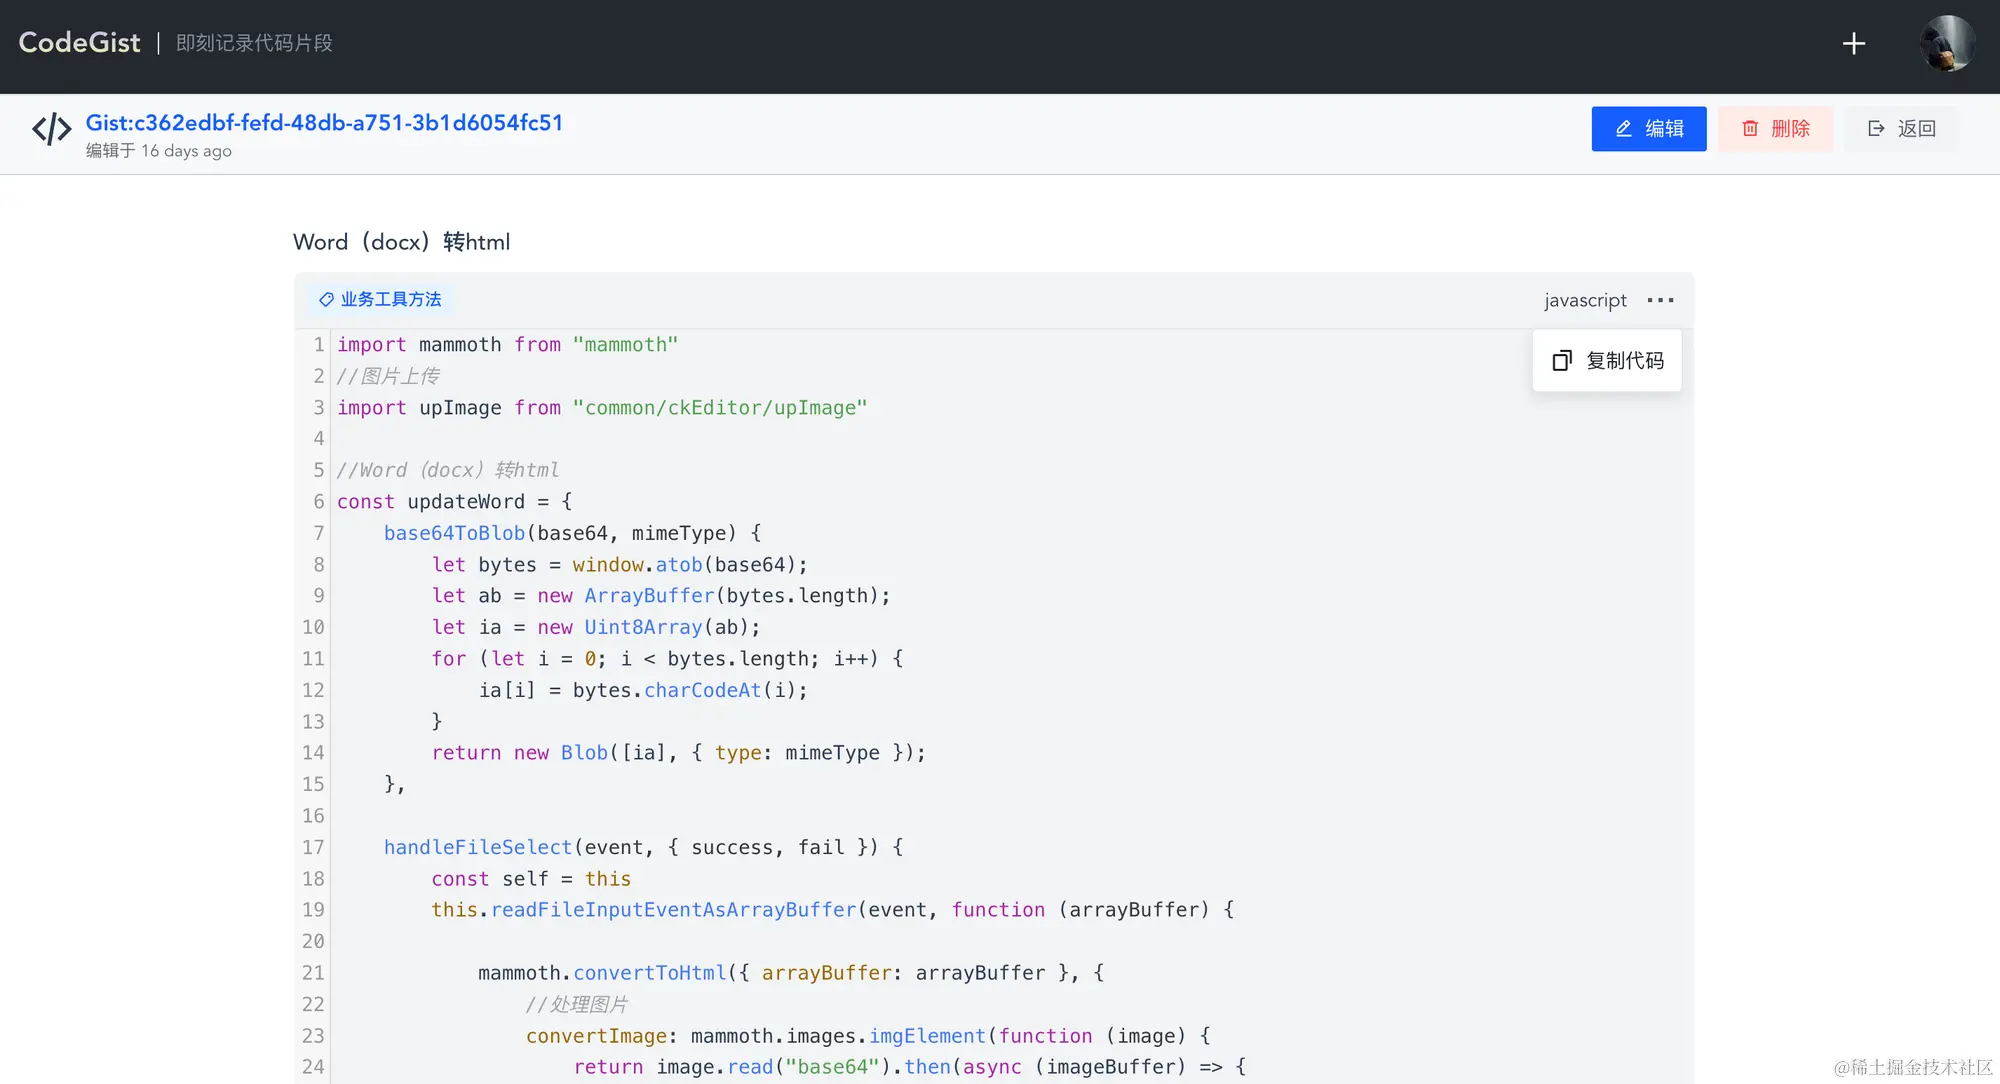
CodeGist 是一款代码管理工具,详细介绍请移步【工具推荐】代码管理工具 CodeGist。
以上就是 JavaScript 实现将 Word 文档解析成浏览器认识的 HTML 的详细内容,更多关于 JavaScript Word 解析成 HTML 的资料请关注本站其它相关文章!
JavaScript零基础入门:从环境搭建到运行第一段代码
2026-11-05 15:29:58
HTML链接中javascript:void(0)的作用及现代替代方案
2026-11-05 10:07:47
在线调试 JS 时怎么引入 jQuery 或 Vue 等第三方库
2026-11-05 08:53:56
原生JavaScript实现简易颜色选择器原理与代码
2026-11-03 23:22:19
JS原生表单序列化:FormData与URLSearchParams用法详解
2026-11-03 23:13:21