

Draft-js 表情插件性能优化:从 3 秒卡顿到 200ms 的缓存策略
本文深入分析了 Draft-js 表情符号插件在页面加载时导致的严重性能问题。通过 Chrome 性能分析器定位到频繁调用正则表达式构建函数是瓶颈所在。该插件每次调用都从零构建巨大的正则表达式,导致页面卡顿 2-3 秒。通过引入结果缓存机制,将阻塞时间大幅降低至 200ms 以内,并探讨了利用 Unicode 属性转义等更优替代方案的可能性。
引言
简要概述:面对长达 42kB 的庞大字符串,我们从零构建了 7138 次正则表达式。通过缓存这一计算过程,显著加速了 Draft-js 表情符号插件的初始化阶段。
本期《前端翻译计划》分享的内容涵盖“加速 JS 生态系统系列博客”,主要涉及以下主题:
- PostCSS、SVGO 等工具优化
- 模块解析机制
- ESLint 的使用规范
- npm 脚本配置
- Draft-js emoji 插件详解
- Polyfill 的过度使用问题
- 桶装文件崩溃现象
- Tailwind CSS 的应用
本期重点分享的是该系列的第 5 篇博客——Draft-js emoji 插件。
Draft-js 表情插件
我收到了 Josh Goldberg 发来的一封邮件,其中提到一个非常有趣的问题:某个网站在加载时会出现约 2-3 秒的卡顿。该网站使用 Draft-js 富文本编辑器进行内容输入,经过排查,问题根源指向了 Draft-js 表情符号插件。
通过 Chrome 性能分析器捕获的快速记录证实了最初的猜测:表情符号插件存在性能缺陷。我们可以看到,底部有一大堆频繁的函数调用,占据了绝大部分时间。遗憾的是,Chrome 分析器缺乏像 speedscope 那样的“左倾”可视化功能,这使得确定哪个函数值得深入研究变得有些困难。“左倾”视图能将相似的调用堆栈合并,对此场景更有帮助。
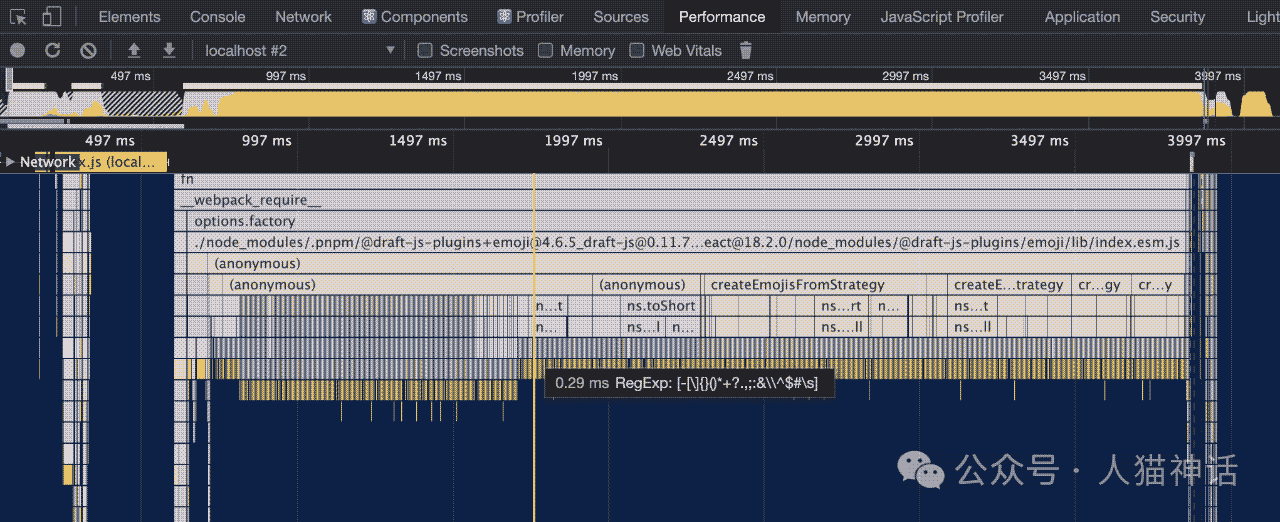
尽管每个单独的调用看起来都很正常,且最终都指向正则表达式引擎,但如此大量的调用足以引发警惕。Chrome 分析器的一个亮点是,它可以使用采样跟踪来注释源码行,从而提供每行执行所需的大致时间。虽然前端项目涉及大量转译,导致结果并非 100% 准确,但这足以让我们得出一些初步结论。
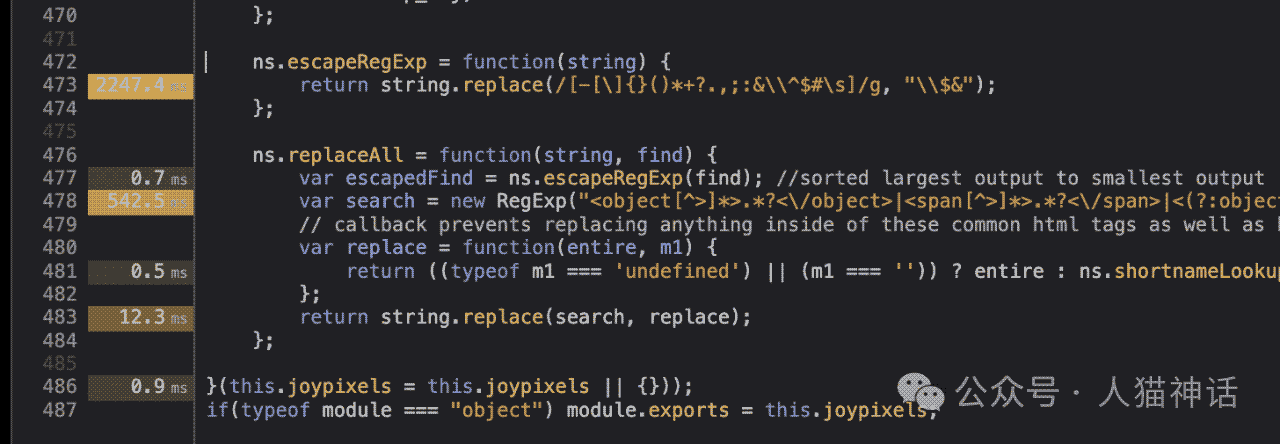
消耗大部分时间的两个方法都涉及正则表达式的处理。人们很容易认为正则表达式本身是罪魁祸首,但我怀疑这仅仅是深层问题的表象。我们首先检查的是该函数的调用频率。这可以通过添加一个简单的计数器,或者直接利用 console.count() 来实现。
  ns.escapeRegExp = function(string) {
+   console.count("escapeRegExp");
    return string.replace(/[-[\]{}()*+?.,;:&\\^$#\s]/g, "\\$&");
  };

  ns.replaceAll = function(string, find) {
+   console.count("replaceAll");
    var escapedFind = ns.escapeRegExp(find);
    var search = new RegExp("<object[^>]*>.*?<\/object>|<span[^>]*>.*?<\/span>|<(?:object|embed|svg|img|div|span|p|a)[^>]*>|("+escapedFind+")", "gi");
    // ...
  };
结果显示,每次页面加载时,replaceAll 方法会被调用 7318 次。接着,我们检查了 escapeRegExp 被调用时传入的参数类型。理论上,也许它会反复使用相同的参数进行调用。
一分钟后,这个假设得到了证实:该函数反复转义同一个字符串。我们知道此方法是从 replaceAll 调用的,因此让我们检查一下是否总是传递相同的参数。果然,第一个 string 参数接收到了两个不同的值,但第二个 find 参数始终相同。这正是后来传递给 escapeRegExp 的那个值。
核心问题浮现:“谁在调用 replaceAll,为什么它们总是传递相同的参数?”
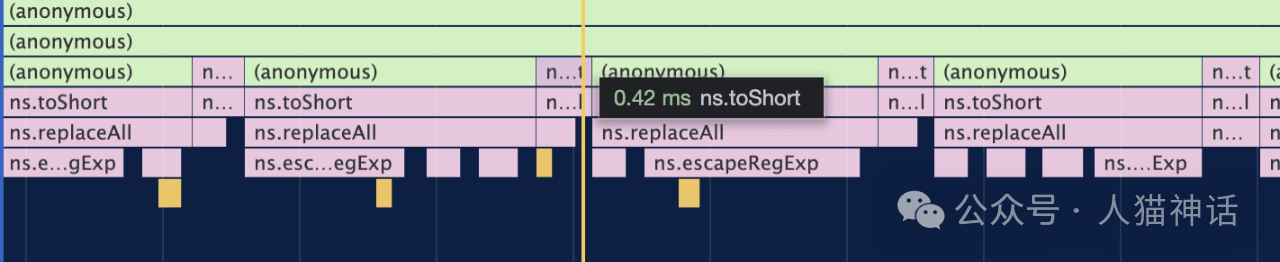
再次放大配置文件,我们观察到对 replaceAll 的所有调用都将 toShort 作为共同的祖先函数。
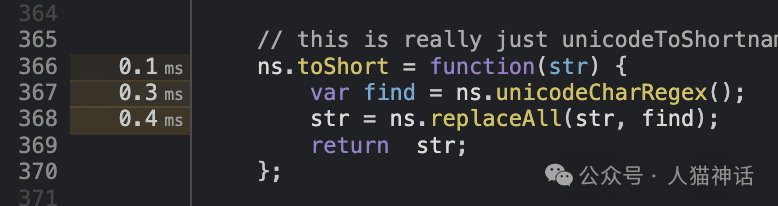
这里发生了一些非常有趣的事情:传递给 replaceAll 的第二个参数,完全不依赖于传递给 toShort 的参数。沿着 unicodeCharRegex 的线索,我们可以更清晰地了解此处代码的用途。与 Slack 等流行聊天应用类似,draft-js 插件允许用户输入文本 :smile:,随后该文本会自动转换为正确的表情符号“😀”。但反向转换也是必要的,这正是我们在代码中看到的逻辑。
寻找解决方案
在进一步了解此代码的用途后,我们注意到,正则表达式是通过迭代 unicode 字符及其元数据的大数据结构构建而成的。随后,将此正则表达式应用于传入的文本,以匹配表情符号并将其替换为短代码。每次调用 toShort 时,都会从零开始构建正则表达式。这成为了一个性能瓶颈,因为 unicode 标准包含无数的表情符号,且随着肤色和其他属性的变化,生成的正则表达式变得异常庞大。

Chrome 控制台显示,构建正则表达式所生成的字符串比单独的 42kB 还要大。
与大多数昂贵计算的情况类似,我们可以通过缓存先前的结果来避免大量重复工作,从而无需反复重新计算相同的内容。这是侵入性最小的修复方案,无需对插件架构进行大幅更改。我们提交了一个 PR,将阻塞时间从 2-3 秒大幅减少到小于 200ms。
完结撒花
如果我们退后一步思考,每当该模块首次加载时都构建该正则表达式显然是浪费资源。结果总是相同的,因此优化的关键在于存储转换后的结果,并在插件中复用。可以在每次发布新版本插件时预先构建它。
另一个潜在的想法是使用手工编写的函数来匹配表情符号。这可以极大地缩小潜在匹配项的搜索空间,但仍需验证此方案在此场景下是否比正则表达式更快。我认为值得尝试。
一个更好的想法是,我们可以利用最近的 unicode 增强功能,从而避免构建超过 40kB 的正则表达式。这包括特殊的 unicode 属性转义,例如 Emoji_Presentation,它允许你直接匹配所有表情符号(例如:/\p{Emoji_Presentation}/gu)。这样我们就可以完全摆脱所有正则表达式生成代码。
总的来说,这个特定问题很好地提醒我们,应定期分析我们的代码。它提醒我们,即使是看似无害的函数,也可能对性能产生巨大影响。
免责声明
本文属于语冰的直男翻译风格,略有删改,仅供粉丝参考。英文原版请传送 Speeding up the JavaScript ecosystem - draft-js emoji plugin
以上就是 JS 生态系统加速探索 Draft-js emoji 插件功能及使用探索的详细内容,更多关于 JS Draft-js emoji 插件的资料请关注本站其它相关文章!
JS数组查找性能对比:find、some与includes该选谁
2026-11-05 17:48:00
怎么优化 React 应用性能?避免不必要的重渲染
2026-11-05 12:43:40
怎么利用 Nuxt.js useHead 优化 SEO 与元数据管理
2026-11-05 10:37:58
JS混淆常见手段解析:字符串加密与控制流平坦化还原思路
2026-11-04 19:07:42
JavaScript能在浏览器中直接获取MAC地址吗
2026-11-03 20:34:17