

深入解析桶排序算法及Node.js上JavaScript的代码实现
本文深入解析桶排序算法原理,通过Node.js JavaScript代码实现展示其工作过程。文章对比了桶排序与快速排序在大规模数据(如高考分数统计)下的性能差异,分析了时间复杂度与空间复杂度的权衡,并提供了完整的代码示例与运行结果,帮助开发者理解线性排序算法的应用场景。
桶排序算法原理与步骤
桶排序(Bucket sort)是一种基于计数的排序算法。其核心原理是将数据分配到有限数量的桶中,随后对每个桶内的数据分别进行排序(可能使用其他排序算法,或通过递归继续应用桶排序)。当被排序的数据数值分布均匀时,桶排序的时间复杂度为Θ(n)。与快速排序不同,桶排序不属于比较排序,因此不受O(nlogn)时间复杂度下限的限制。桶排序的执行步骤如下:(1)设定固定数量的空桶;(2)将数据放入对应的桶中;(3)对每个非空桶内的数据进行排序;(4)将所有非空桶中的数据拼接,得到最终结果。桶排序主要适用于小范围整数数据,且数据独立均匀分布,能够处理大量数据,并符合线性期望时间。
为了直观展示桶排序算法,以下举例说明。假设有一组数据[7, 36, 65, 56, 33, 60, 110, 42, 42, 94, 59, 22, 83, 84, 63, 77, 67, 101],我们需要将其按从小到大的顺序进行排序。
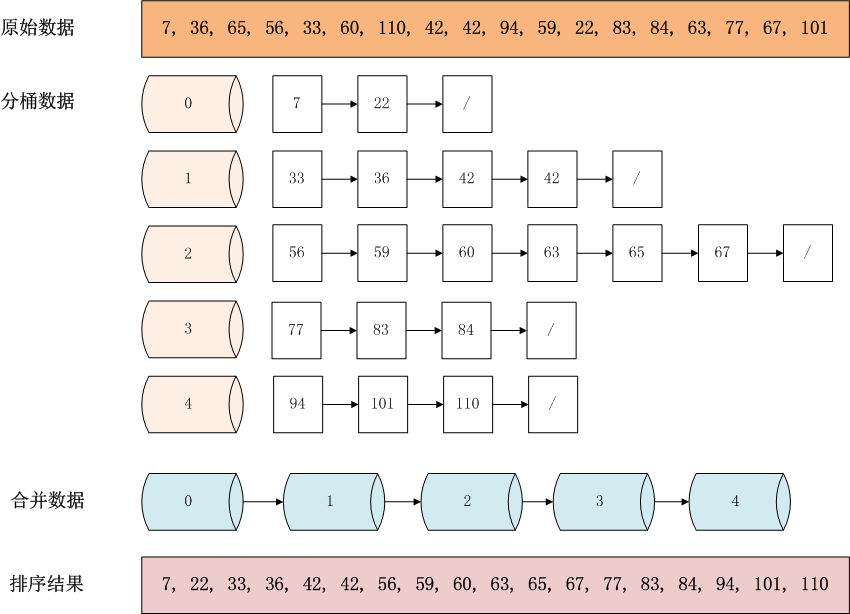
具体操作步骤如下:(1)设置5个空桶,找出最大值110和最小值7,计算每个桶的范围为20.8,公式为(110-7+1)/5。(2)遍历原始数据,使用链表结构将数据放入对应的桶中。例如,数字7的桶索引为0,计算公式为floor((7 – 7) / 20.8);数字36的桶索引为1,计算公式为floor((36 – 7) / 20.8)。(3)当向同一索引的桶插入第二个数据时,需判断桶中已有数字与新插入数字的大小,按照从左到右、从小到大的顺序插入。例如,索引为2的桶中已存在56、59、60、65四个数字,插入63时,应将其置于65的左侧。(4)合并非空桶,按从左到右的顺序合并索引0至4的桶。(5)最终得到排序后的桶排序结构。
Node.js JavaScript代码实现
对于桶排序这类成熟算法,自行实现并不困难。基于上述思路,我编写了一个简单的程序实现。其中最具挑战的部分在于使用JavaScript操作链表。以下是具体代码:
'use strict';

/////////////////////////////////////////////////
// 桶排序
/////////////////////////////////////////////////
var _this = this
  , L = require('linklist');//链表

/**
 * 普通数组桶排序,同步
 *
 * @param arr Array 整数数组
 * @param num 桶的个数
 *
 * @example:
 * sort([1,4,1,5,3,2,3,3,2,5,2,8,9,2,1],5)
 * sort([1,4,1,5,3,2,3,3,2,5,2,8,9,2,1],5,0,5)
 */
exports.sort = function (arr, count) {
  if (arr.length == 0) return [];
  count = count || (count > 1 ? count : 10);

  // 判断最大值、最小值
  var min = arr[0], max = arr[0];
  for (var i = 1; i < arr.length; i++) {
    min = min < arr[i] ? min : arr[i];
    max = max > arr[i] ? max : arr[i];
  }
  var delta = (max - min + 1) / count;
  // console.log(min+","+max+","+delta);

  //初始化桶
  var buckets = [];

  //存储数据到桶
  for (var i = 0; i < arr.length; i++) {
    var idx = Math.floor((arr[i] - min) / delta); // 桶索引

    if (buckets[idx]) {//非空桶
      var bucket = buckets[idx];
      var insert = false;//插入标石
      L.reTraversal(bucket, function (item, done) {
        if (arr[i] <= item.v) {//小于,左边插入
          L.append(item, _val(arr[i]));
          insert = true;
          done();//退出遍历
        }
      });
      if (!insert) { //大于,右边插入
        L.append(bucket, _val(arr[i]));
      }
    } else {//空桶
      var bucket = L.init();
      L.append(bucket, _val(arr[i]));
      buckets[idx] = bucket; //链表实现
    }
  }

  var result = [];
  for (var i = 0, j = 0; i < count; i++) {
    L.reTraversal(buckets[i], function (item) {
      // console.log(i+":"+item.v);
      result[j++] = item.v;
    });
  }
  return result;
}

//链表存储对象
function _val(v) {
  return {v: v}
}
运行该程序:
var algo = require('./index.js');
var data = [ 7, 36, 65, 56, 33, 60, 110, 42, 42, 94, 59, 22, 83, 84, 63, 77, 67,101 ];
console.log(data);
console.log(algo.bucketsort.sort(data,5));//5个桶
console.log(algo.bucketsort.sort(data,10));//10个桶
输出结果:
[ 7, 36, 65, 56, 33, 60, 110, 42, 42, 94, 59, 22, 83, 84, 63, 77, 67, 101 ]
[ 7, 22, 33, 36, 42, 42, 56, 59, 60, 63, 65, 67, 77, 83, 84, 94, 101, 110 ]
[ 7, 22, 33, 36, 42, 42, 56, 59, 60, 63, 65, 67, 77, 83, 84, 94, 101, 110 ]
需要特别说明的是:
(1)桶内排序可以在插入过程中实现,如程序所示;也可以先插入不排序,在合并过程中再进行排序,此时可以调用快速排序。(2)关于链表,Node底层API中已有链表实现,但我未直接使用,而是通过linklist包调用:https://github.com/nodejs/node-v0.x-archive/blob/master/lib/_linklist.js。
高考分数统计案例对比
4. 案例:桶排序统计高考分数 桶排序最出名的一个应用场景,就是统计高考的分数。一年的全国高考考生人数为900万人,分数使用标准分,最低200 ,最高900 ,没有小数,如果把这900万数字进行排序,应该如何做呢? 算法分析: (1)如果使用基于比较的排序,快速排序,平均时间复杂度为O(nlogn) = O(9000000*log9000000)=144114616=1.44亿次比较。 (2)如果使用基于计数的排序,桶排序,平均的时候复杂度,可以控制在线性复杂度,当创建700桶时从200分到900分各一个桶,O(N)=O(9000000),就相当于扫描一次900W条数据。 我们跑一个程序,对比一次快速排序和桶排序。
//产生100W条,[200,900]闭区间的数据
var data = algo.data.randomData(1000*1000,200,900);
var s1 = new Date().getTime();
algo.quicksort.sort(data);//快速排序
var s2 = new Date().getTime();
algo.bucketsort.sort(data,700);//装到700个桶
var s3 = new Date().getTime();

console.log("quicksort time: %sms",s2-s1);
console.log("bucket time: %sms",s3-s2);
输出结果:
quicksort time: 14768ms
bucket time: 1089ms
由此可见,对于高考计分案例,桶排序更为合适。将合适的算法应用于适合的场景,能为程序带来超越硬件性能的提升。
桶排序复杂度与空间代价分析
桶排序代价分析:桶排序利用函数的映射关系,减少了几乎所有的比较工作。实际上,桶排序中f(k)值的计算作用类似于快排中的划分操作,已将大量数据分割成基本有序的数据块(桶)。随后只需对桶内少量数据进行高级比较排序即可。对N个关键字进行桶排序的时间复杂度分为两部分:(1) 循环计算每个关键字的桶映射函数,时间复杂度为O(N)。(2) 利用高级比较排序算法对每个桶内所有数据进行排序,时间复杂度为∑ O(Ni*logNi),其中Ni为第i个桶的数据量。显然,第(2)部分是决定桶排序性能的关键。提高桶内数据数量的唯一办法是尽量减少桶内数据量(因为基于比较排序的最好平均时间复杂度只能达到O(N*logN))。因此,我们需要尽量做到以下两点:(1) 映射函数f(k)能将N个数据平均分配到M个桶中,使每个桶约有[N/M]个数据。(2) 尽量增大桶的数量。极限情况下,每个桶仅包含一个数据,从而完全避免桶内数据的“比较”排序操作。当然,这很难实现,在数据量巨大时,f(k)函数会导致桶集合数量巨大,造成空间浪费。这是时间代价与空间代价的权衡问题。对于N个待排数据,M个桶,平均每个桶[N/M]个数据的桶排序平均时间复杂度为:
O(N)+O(M*(N/M)*log(N/M))=O(N+N*(logN-logM))=O(N+N*logN-N*logM)
当N=M时,即极限情况下每个桶只有一个数据时,桶排序的最佳效率能达到O(N)。
总结:桶排序的平均时间复杂度为线性的O(N+C),其中C=N*(logN-logM)。若对于相同的N,桶数量M越大,效率越高,最佳时间复杂度可达O(N)。当然,桶排序的空间复杂度为O(N+M),若输入数据庞大且桶数量众多,空间代价将非常昂贵。此外,桶排序是稳定的。个人还有一个感受:在查找算法中,基于比较的查找算法最佳时间复杂度为O(logN),如折半查找、平衡二叉树、红黑树等。但Hash表却有O(C)线性级别的查找效率(无冲突时查找效率达O(1))。请大家仔细体会:Hash表的思想与桶排序是否有异曲同工之妙?
Node.js 安装配置与第一个 HTTP 服务器编写
2026-11-05 11:41:40
怎么使用 nvm 管理并平滑升级 Node.js 版本
2026-11-04 23:15:07
Node.js 怎么使用 zlib 模块解压 gzip 和 deflate
2026-11-03 23:40:50
直接覆盖安装还是用版本管理器?Node.js 升级方式对比
2026-11-03 22:59:07
Express.js 是什么:Node.js Web 框架核心概念与适用场景
2026-11-03 20:00:12