

详解js数组的完全随机排列算法
本文深入分析使用Array.prototype.sort进行数组随机排列的错误原因,指出其结果受具体排序算法实现影响且分布不均。通过冒泡、插入和快速排序的对比测试,证明该方法无法实现完全随机。文章最后介绍了时间复杂度为O(n)的经典Fisher-Yates洗牌算法,并辅以数学归纳法证明其均匀随机性,推荐在实际开发中替代错误的sort用法。
sort随机排列的错误实践
许多JavaScript开发者存在一个误区,即利用Array.prototype.sort方法来实现数组的随机打乱。在前端星计划挑战项目中,涉及实现blackjack游戏的需求时,不少参与者采用了这种sort随机洗牌的方式。
洗牌逻辑
以下是常见的、完全错误的随机排列代码示例:
function shuffle(arr){
 return arr.sort(function(){
 return Math.random() - 0.5;
 });
}
上述代码看似巧妙地借助Array.prototype.sort完成了随机操作,但实际上存在严重缺陷,甚至可以说是完全错误的做法。
证明Array.prototype.sort随机算法的错误
为了验证该算法的错误性,我们设计了一个测试方案。假设该排序算法是正确的,将其应用于随机数组[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]。若算法正确,每个数字在任意位置出现的概率应当均等。因此,重复执行洗牌操作足够多次,将每次结果在对应位置累加,最后计算每个位置的平均值。理论上,这个平均值应接近(0 + 9) / 2 = 4.5,且测试次数越多,平均值越趋近于4.5。基于此思路,我们编写了如下测试代码:
var arr = [0,1,2,3,4,5,6,7,8,9];
var res = [0,0,0,0,0,0,0,0,0,0];
var t = 10000;
for(var i = 0; i < t; i++){
 var sorted = shuffle(arr.slice(0));
 sorted.forEach(function(o,i){
 res[i] += o;
 });
}
res = res.map(function(o){
 return o / t;
});
console.log(res);
在Chrome浏览器中运行上述shuffle方法与测试代码,结果显示分布并不随机。各位置的平均值随索引增加而增大,这表明该算法导致较大数值出现在数组后部的概率更高。
产生这种结果的原因在于我们需要深入理解Array.prototype.sort的实际工作机制。
首先,排序算法种类繁多,ECMAScript规范并未强制规定Array.prototype.sort必须采用特定的排序算法。
虽然排序算法本身不是本文重点,但所有排序都涉及元素间的比较与交换,其效率取决于比较和交换的次数。
基础的排序算法包括冒泡排序和插入排序。原版冒泡或插入排序进行了n(n-1)/2次比较,即任意两个元素都经过一次比较。在此情况下,若采用前述sort随机算法,由于每次比较有50%的概率交换或不交换,结果是否均匀随机?我们可以通过以下示例观察:
function bubbleSort(arr, compare){
 var len = arr.length;
 for(var i = 0; i < len - 1; i++){
 for(var j = 0; j < len - 1 - i; j++){
 var k = j + 1;
 if(compare(arr[j], arr[k]) > 0){
 var tmp = arr[j];
 arr[j] = arr[k];
 arr[k] = tmp;
 }
 }
 }
 return arr;
}
function shuffle(arr){
 return bubbleSort(arr, function(){
 return Math.random() - 0.5;
 });
}
var arr = [0,1,2,3,4,5,6,7,8,9];
var res = [0,0,0,0,0,0,0,0,0,0];
var t = 10000;
for(var i = 0; i < t; i++){
 var sorted = shuffle(arr.slice(0));
 sorted.forEach(function(o,i){
 res[i] += o;
 });
}
res = res.map(function(o){
 return o / t;
});
console.log(res);
上述代码的随机结果同样不均匀,测试平均值显示越靠后的位置数值越大。(注:笔者此前未复制原数组导致得出均匀结论的错误,已于2016-05-10更正)
冒泡排序总是将较小的元素与前一个元素交换。我们可以推测,该算法中越靠后的元素交换到前面位置的概率越小(因为每次只有50%几率“冒泡”)。由于原始数组是从小到大排序的,测试平均值结果自然呈现越靠后越大的趋势(因为大数出现在前面的概率较小)。
接下来我们尝试另一种算法:插入排序。
function insertionSort(arr, compare){
 var len = arr.length;
 for(var i = 0; i < len; i++){
 for(var j = i + 1; j < len; j++){
 if(compare(arr[i], arr[j]) > 0){
 var tmp = arr[i];
 arr[i] = arr[j];
 arr[j] = tmp;
 }
 }
 }
 return arr;
}
function shuffle(arr){
 return insertionSort(arr, function(){
 return Math.random() - 0.5;
 });
}
var arr = [0,1,2,3,4,5,6,7,8,9];
var res = [0,0,0,0,0,0,0,0,0,0];
var t = 10000;
for(var i = 0; i < t; i++){
 var sorted = shuffle(arr.slice(0));
 sorted.forEach(function(o,i){
 res[i] += o;
 });
}
res = res.map(function(o){
 return o / t;
});
console.log(res);
由于插入排序是将后面的大数与前方的数进行交换,这次的结果与冒泡排序相反,测试平均值显示越靠后数值越小。原因类似:对于插入排序,越靠后的数字越容易随机交换到前面。
由此可见,即使是两两交换的排序算法,随机分布也存在较大差异。除了每个位置都进行两两比较的排序算法外,大多数排序算法的时间复杂度介于O(n)到O(n^2)之间,元素间的比较次数通常远小于n(n-1)/2。这意味着部分元素根本没有机会进行比较(也就失去了随机交换的可能),因此这些sort随机排序算法无法实现真正的随机。
我们将代码修改为采用快速排序:
function quickSort(arr, compare){
 arr = arr.slice(0);
 if(arr.length <= 1) return arr;
 var mid = arr[0], rest = arr.slice(1);
 var left = [], right = [];
 for(var i = 0; i < rest.length; i++){
 if(compare(rest[i], mid) > 0){
 right.push(rest[i]);
 }else{
 left.push(rest[i]);
 }
 }
 return quickSort(left, compare).concat([mid])
 .concat(quickSort(right, compare));
}
function shuffle(arr){
 return quickSort(arr, function(){
 return Math.random() - 0.5;
 });
}
var arr = [0,1,2,3,4,5,6,7,8,9];
var res = [0,0,0,0,0,0,0,0,0,0];
var t = 10000;
for(var i = 0; i < t; i++){
 var sorted = shuffle(arr.slice(0));
 sorted.forEach(function(o,i){
 res[i] += o;
 });
}
res = res.map(function(o){
 return o / t;
});
console.log(res);
快速排序并未进行两两元素比较,其概率分布同样不随机。
综上所述,使用Array.prototype.sort进行随机交换来排列数组,其结果并非完全随机,而是取决于排序算法的具体实现。使用JavaScript内置的排序算法进行此类操作,通常肯定是不完全随机的。
经典Fisher-Yates洗牌算法
经典的随机排列算法
所有空间复杂度为O(1)的排序算法,其时间复杂度介于O(nlogn)到O(n^2)之间。因此,在不考虑结果错误的前提下,使用排序来实现随机交换也是低效的。事实上,随机排列数组元素存在经典的O(n)复杂度算法:
function shuffle(arr){
 var len = arr.length;
 for(var i = 0; i < len - 1; i++){
 var idx = Math.floor(Math.random() * (len - i));
 var temp = arr[idx];
 arr[idx] = arr[len - i - 1];
 arr[len - i -1] = temp;
 }
 return arr;
}
在上述算法中,每次循环从剩余的len - i个元素中随机选择一个位置,将该元素与第len - i个元素交换,迭代直到i = len - 1为止。
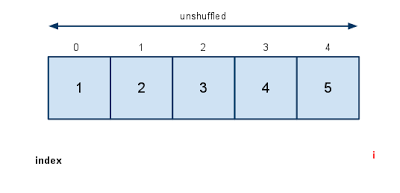
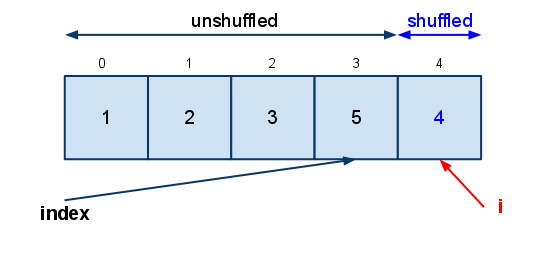
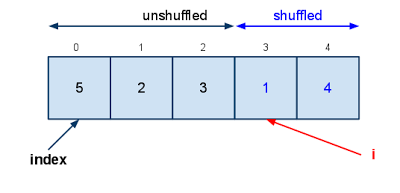
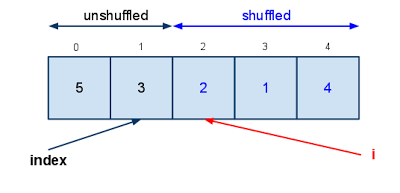
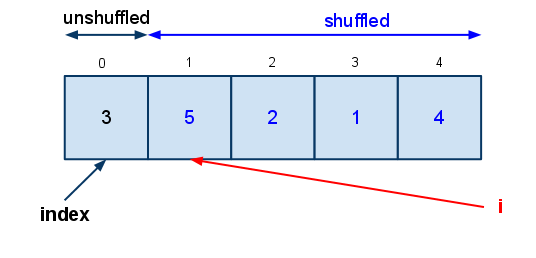
我们可以同样检验该算法的随机性:
function shuffle(arr){
 var len = arr.length;
 for(var i = 0; i < len - 1; i++){
 var idx = Math.floor(Math.random() * (len - i));
 var temp = arr[idx];
 arr[idx] = arr[len - i - 1];
 arr[len - i -1] = temp;
 }
 return arr;
}
var arr = [0,1,2,3,4,5,6,7,8,9];
var res = [0,0,0,0,0,0,0,0,0,0];
var t = 10000;
for(var i = 0; i < t; i++){
 var sorted = shuffle(arr.slice(0));
 sorted.forEach(function(o,i){
 res[i] += o;
 });
}
res = res.map(function(o){
 return o / t;
});
console.log(res);
从结果来看,该算法的随机分布应该是均匀的。不过,我们的测试方法存在一个小问题:我们仅测试了平均值。实际上,平均值接近只是均匀分布的必要而非充分条件,平均值接近并不意味着一定是均匀分布。但无需担心,事实上我们可以通过简单的数学证明该算法的随机性。
算法随机性的数学证明
随机性的数学归纳法证明
对n个数进行随机排列:
首先考虑n = 2的情况。根据算法,显然有1/2的概率两个数交换,有1/2的概率不交换。因此,对于n = 2的情况,元素出现在每个位置的概率均为1/2,满足随机性要求。
假设有i个数(i >= 2)时,算法随机性符合要求,即每个数出现在i个位置中任意位置的概率均为1/i。
对于i + 1个数,按照我们的算法,在第一次循环时,每个数都有1/(i+1)的概率被交换到最末尾。因此,每个元素出现在最末一位的概率均为1/(i+1)。同时,每个数也有i/(i+1)的概率不被交换到最末尾。如果不被交换,从第二次循环开始还原为i个数的随机过程。根据第2点的假设,它们出现在剩余i个位置的概率是1/i。因此,每个数出现在前i位任意一位的概率是(i/(i+1)) * (1/i) = 1/(i+1),同样为1/(i+1)。
综合上述1、2、3点,可以得出结论:对于任意n >= 2,经过该算法后,每个元素出现在n个位置中任意一个位置的概率均为1/n。
总结
一个优秀的算法应同时满足结果正确和高效率。不幸的是,使用Array.prototype.sort方法这两个条件均不满足。因此,当我们需要实现类似洗牌的功能时,应采用巧妙的经典洗牌算法,它不仅具有完全随机性,还具备高效率。
除了掌握此类算法外,我们还应认真对待这种动手分析和解决问题的思路,并重新拾起那些曾被大多数人遗忘的数学知识(例如数学归纳法这种经典的证明方法)。
如有任何问题,欢迎与作者探讨。
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作能带来一定的帮助,同时也希望多多支持本站!
ES6模块化中js文件怎么用import和export交互
2026-11-05 17:00:48
JS读取本地文件时报错或无响应的常见原因
2026-11-05 16:32:31
let、const与var的区别:JavaScript变量声明最佳实践
2026-11-05 14:16:38
JS中直接定义静态二维数组的字面量写法
2026-11-05 14:16:08
JS 怎么查找字符串中所有匹配项的位置
2026-11-05 14:15:53