基于face-api.js实现1:1人脸比对与身份验证逻辑
本文详细讲解如何基于face-api.js实现生产可用的1:1人脸比对与身份验证逻辑,涵盖模型选型加载、单人脸关键点对齐、128维特征向量提取、欧氏距离阈值判定及端云协同安全防护。
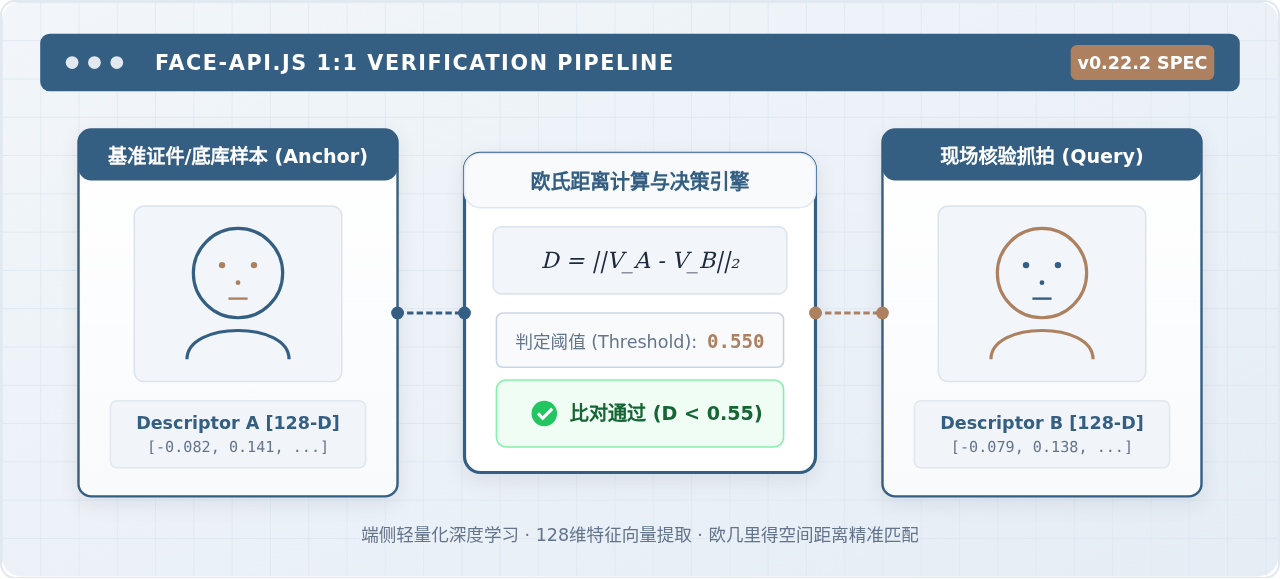
1. 1:1 比对与 1:N 检索的核心概念辨析
在人脸识别技术体系中,1:1比对(1:1 Verification / Authentication)与1:N检索(1:N Identification / Search)有着完全不同的数学模型与工程落地路径:
- 1:1 比对(身份核验):核心目标是回答“你是不是你所声称的那个人”。输入是两张人脸图像(一张为权威注册底库或身份证芯片照片,另一张为现场抓拍图像),系统只执行单次高维向量的距离测算,计算复杂度为严格的常数阶
O(1)。 - 1:N 检索(目标搜索):核心目标是回答“这个人到底是谁”。输入是一张未知身份抓拍图,系统需要将其特征向量与底库中的N个已知实体逐一遍历或通过近似最近邻(HNSW/Faiss)进行聚类检索,复杂度随底库规模线性膨胀
O(N)。
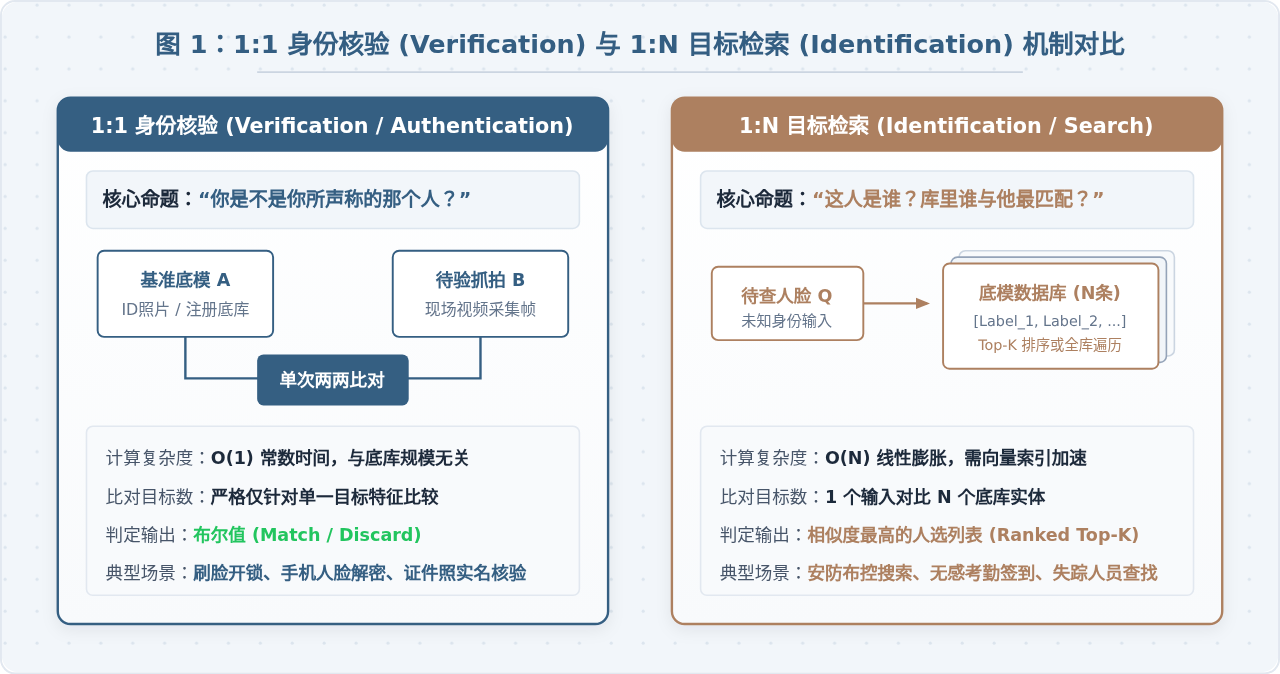
1:1身份验证的优势在于业务边界清晰、资源开销极小且无须维护庞大的向量索引库。在浏览器或移动端WebView等边缘计算环境中,face-api.js能够在本地硬件(GPU / WebGL)加持下完成毫秒级推理,免除将未脱敏的人脸原始图像频繁上传至云端带来的网络延迟与隐私合规风险。
2. face-api.js 模型管线与特征提取原理
face-api.js 内部并非通过单一黑盒模型完成比对,而是串联了三套经过轻量化裁剪的深度神经网络(Inference Pipeline):
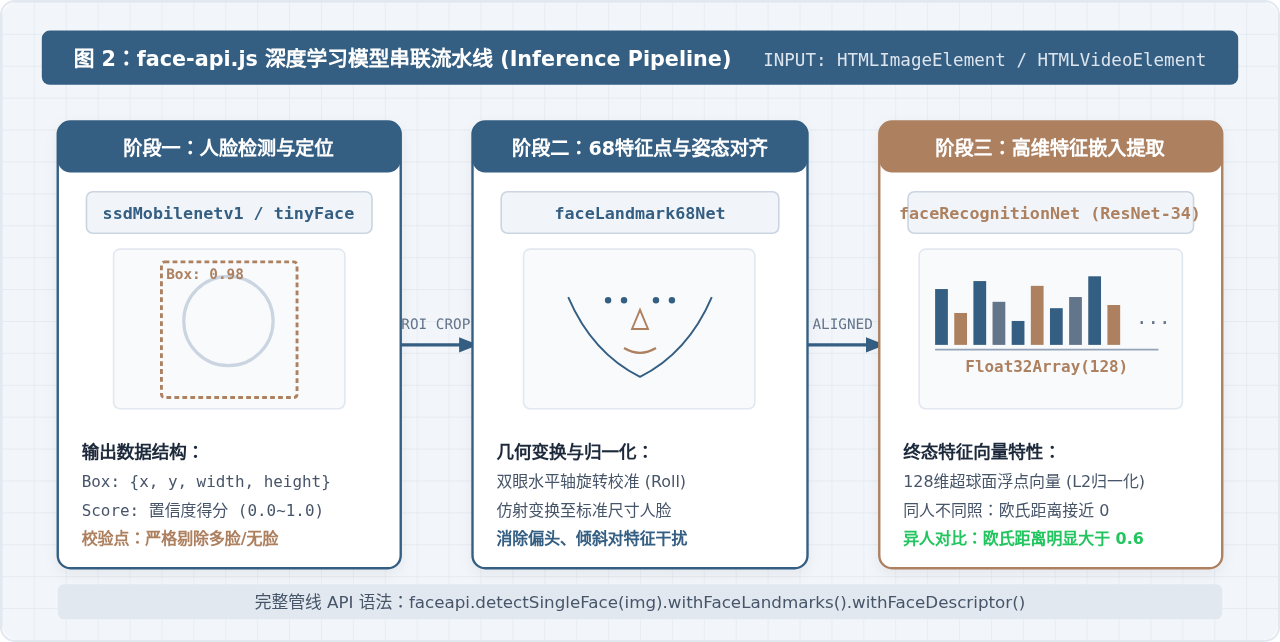
- 阶段一:人脸检测(Face Detection):
定位图像中是否存在人脸,并输出边界框(Bounding Box)与置信度得分。face-api.js 提供两种主流探测器:
ssdMobilenetv1:基于MobileNet V1的单发多框检测器,检测精度与抗逆光能力强,模型体积约 5.4MB,适合算力良好的桌面端。tinyFaceDetector:轻量级深度可分离卷积检测器,模型仅 190KB 左右,推理速度极快,适合移动端设备。
- 阶段二:68人脸特征点定位与几何对齐(Face Landmark Alignment):
通过
faceLandmark68Net定位人脸的下颌线、双眼、眉毛、鼻梁与嘴唇等关键点。通过计算双眼倾斜角度执行仿射变换(Affine Transformation),将旋转或侧倾的人脸旋转纠偏至正脸姿态并裁剪缩放,消除姿态倾斜对特征计算的干扰。 - 阶段三:128维特征向量嵌入(Face Recognition Embedding):
采用基于ResNet-34骨干网络裁剪的
faceRecognitionNet。对齐后的正脸图像送入网络,全连接层最终输出一个Float32Array(128)的128维超球面浮点向量。该向量在超球面上满足欧氏空间特性:同一个人不同光照角度下的距离趋近于0,而不同人脸的欧氏距离显著拉大。
3. 1:1 比对逻辑的完整工程实现
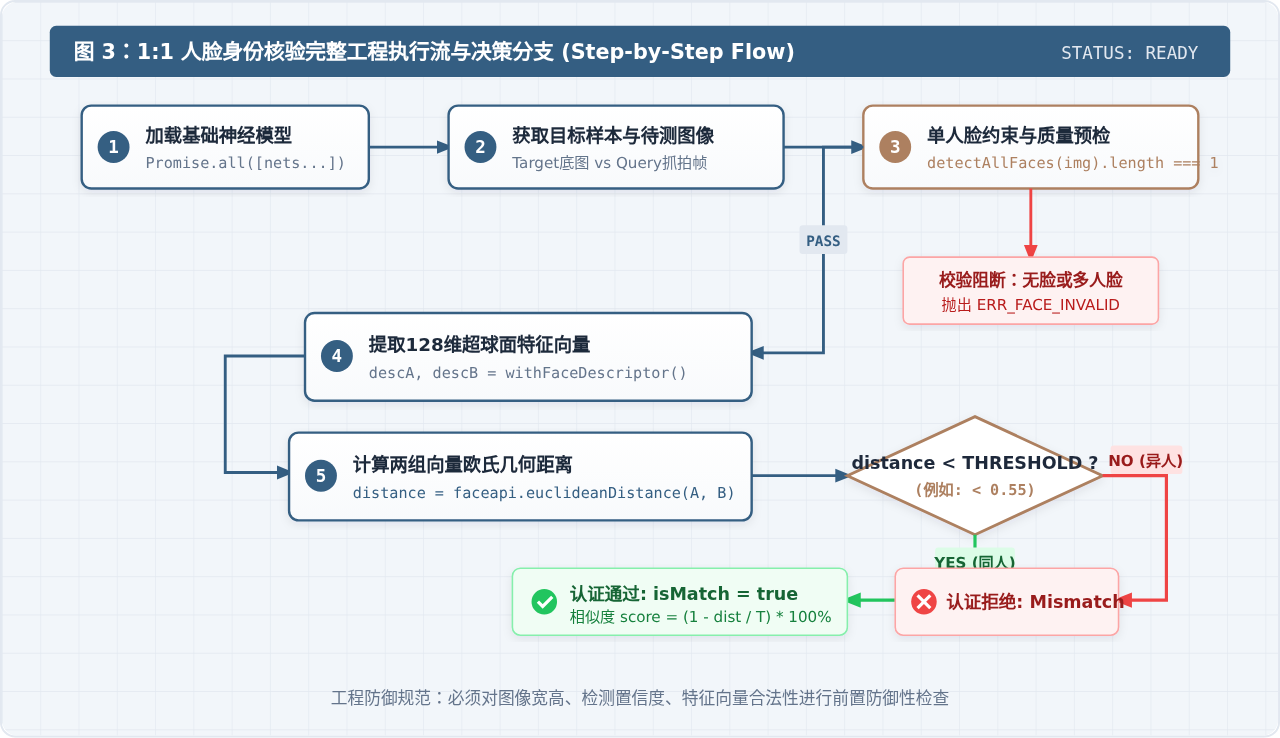
实现规范的1:1人脸比对,不能仅简单调用比较函数,必须包含模型权重加载、单人脸防御性校验、特征抽取以及距离计算四个严格阶段:
完整实现代码示例
/**
 * 1:1 人脸身份比对与验证核心服务类
 * 依赖环境:浏览器 / Node.js (需绑定 @tensorflow/tfjs-node 与 canvas)
 */
class FaceVerificationService {
  constructor(modelsPath = '/models', threshold = 0.55) {
    this.modelsPath = modelsPath;
    this.threshold = threshold; // 推荐严谨阈值 0.55
    this.isModelsLoaded = false;
  }

  /**
   * 步骤 1:异步加载必要神经网络权重文件
   */
  async loadModels() {
    if (this.isModelsLoaded) return;
    try {
      await Promise.all([
        faceapi.nets.ssdMobilenetv1.loadFromUri(this.modelsPath),
        faceapi.nets.faceLandmark68Net.loadFromUri(this.modelsPath),
        faceapi.nets.faceRecognitionNet.loadFromUri(this.modelsPath)
      ]);
      this.isModelsLoaded = true;
    } catch (error) {
      throw new Error(`[FaceAPI] 模型加载失败: ${error.message}`);
    }
  }

  /**
   * 步骤 2 & 3:提取图像中的人脸特征向量(严格执行单人脸校验)
   * @param {HTMLImageElement|HTMLVideoElement|HTMLCanvasElement} inputElement
   * @returns {Promise<Float32Array>} 128维特征向量
   */
  async extractSingleFaceDescriptor(inputElement) {
    if (!this.isModelsLoaded) {
      await this.loadModels();
    }

    // 前置检查:探测图像中检测到的所有人脸数量
    const detections = await faceapi.detectAllFaces(
      inputElement,
      new faceapi.SsdMobilenetv1Options({ minConfidence: 0.65 })
    );

    if (detections.length === 0) {
      throw new Error('VERIFY_ERR_NO_FACE: 未检测到有效人脸,请保持面部正对镜头');
    }
    if (detections.length > 1) {
      throw new Error('VERIFY_ERR_MULTI_FACES: 检测到多张人脸,画面中只允许出现一人');
    }

    // 获取完整对齐后的128维特征向量
    const result = await faceapi
      .detectSingleFace(inputElement, new faceapi.SsdMobilenetv1Options({ minConfidence: 0.65 }))
      .withFaceLandmarks()
      .withFaceDescriptor();

    if (!result || !result.descriptor) {
      throw new Error('VERIFY_ERR_ALIGN_FAILED: 人脸对齐或特征抽取失败');
    }

    return result.descriptor;
  }

  /**
   * 步骤 4:计算欧氏距离并输出比对决策
   * @param {HTMLImageElement} baseImage 基准底库图像(如身份证照)
   * @param {HTMLVideoElement|HTMLImageElement} liveImage 待核验现场抓拍
   * @returns {Promise<{isMatch: boolean, distance: number, confidenceScore: number}>}
   */
  async verify1v1(baseImage, liveImage) {
    // 分别抽取两张人脸的高维特征向量
    const [descriptorA, descriptorB] = await Promise.all([
      this.extractSingleFaceDescriptor(baseImage),
      this.extractSingleFaceDescriptor(liveImage)
    ]);

    // 计算欧几里得几何距离:D = sqrt(sum((A[i] - B[i])^2))
    const distance = faceapi.euclideanDistance(descriptorA, descriptorB);

    // 判定逻辑:距离小于阈值即判定为同一个人
    const isMatch = distance < this.threshold;

    // 将欧氏距离映射为 0% ~ 100% 直观可读置信度
    // 当 distance >= 1.0 时置信度衰减至 0%
    const confidenceScore = Math.max(0, Math.min(100, (1 - distance) * 100));

    return {
      isMatch,
      distance: Number(distance.toFixed(4)),
      confidenceScore: Number(confidenceScore.toFixed(2))
    };
  }
}detectSingleFace 之前,为什么推荐先使用 detectAllFaces?因为 detectSingleFace 只会默认抓取画面中置信度最高的一张脸,若背景中存在他人路过或墙上有大幅人像海报,系统会误将他人特征与底模比对,造成误判。必须通过 detectAllFaces().length === 1 阻断违规场景。
4. 欧氏距离阈值判定与误差权衡
比对算法的核心判据是两个128维向量之间的欧几里得距离(Euclidean Distance)。两个向量在几何空间的距离公式如下:
Distance(A, B) = √∑i=1128 (Ai - Bi)2
距离越接近 0,代表两张人脸的几何生理结构特征越一致;距离越大,代表两张人脸差异越大。
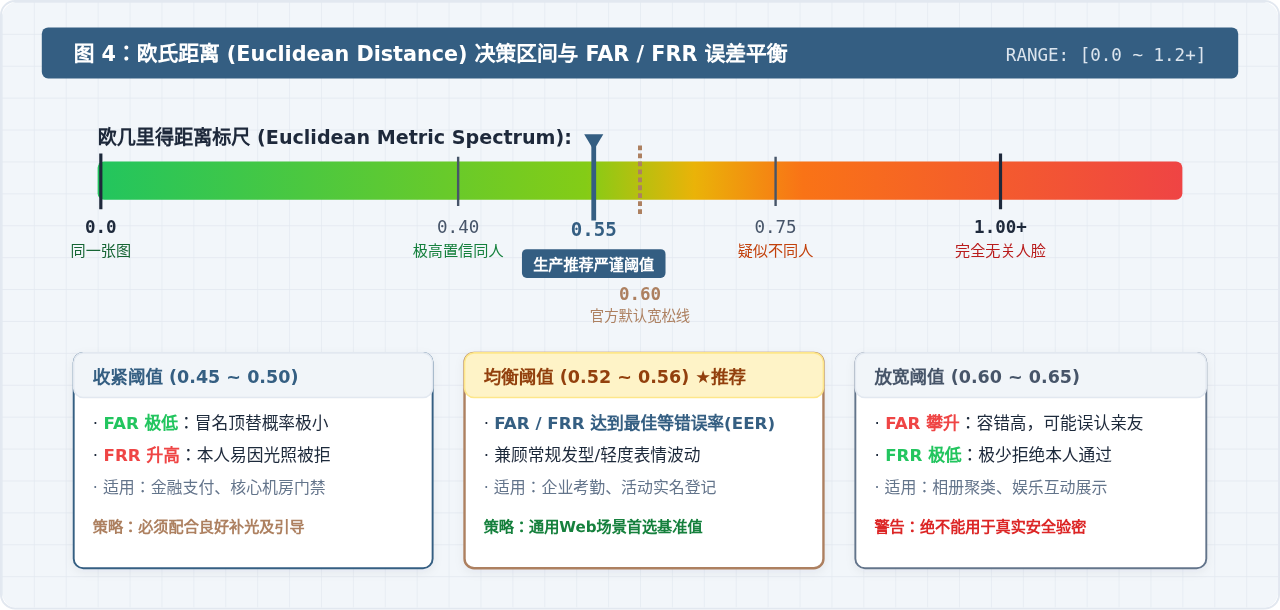
阈值选择的工程权衡(Trade-off)
| 阈值范围 | 误识率 (FAR, 假阳性) | 拒真率 (FRR, 假阴性) | 工程表现与推荐应用场景 |
|---|---|---|---|
| 0.40 ~ 0.50 (严格) | 趋近于 0(极难冒充) | 偏高(用户易被拒绝) | 高安全级身份核验、敏感操作二次密码确认。需要配合充足光线与高分辨率相机。 |
| 0.52 ~ 0.56 (均衡) | < 0.1% | < 1% | 生产推荐基准值(0.55)。企业门禁、考勤签到、实名制活动入场的黄金平衡点。 |
| 0.60 (宽松默认) | ~ 0.5% | 极低(极易通过) | face-api.js 官方示例默认值。容错强,但在双胞胎或五官相近场景下可能出现误认。 |
5. 生产落地挑战与端云安全闭环
在严肃业务系统中,切忌完全信任纯前端计算的判定结果。前端运行环境处于不可信域,攻击者可通过调试工具拦截函数调用、替换全局变量 isMatch = true,或使用静态人脸高清照片对准摄像头实现欺诈。
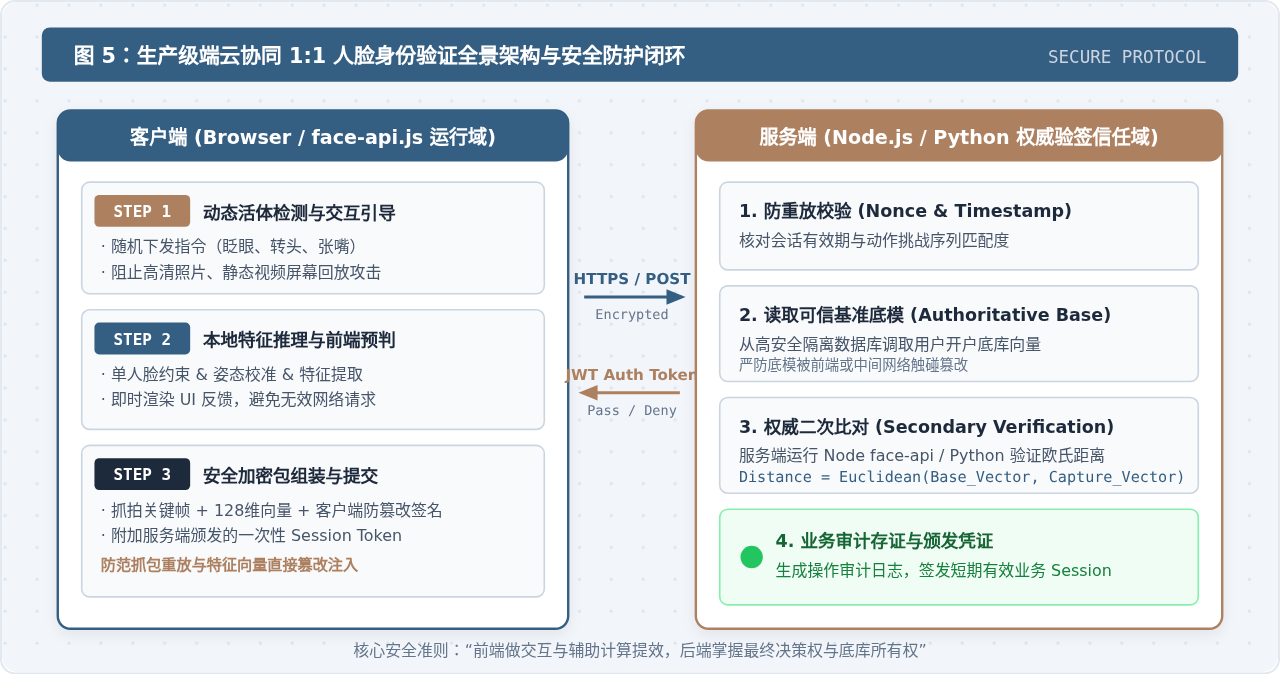
要构建生产级可信的身份验证链路,必须建立端云协同机制:
- 引入活体检测(Liveness Detection):在提取特征前,客户端先执行动作挑战(如由服务端随机下发序列:“向左转头 → 眨眼 → 保持静止”),通过监测 68 个关键点的运动矢量差排除翻拍屏幕或打印纸片攻击。
- 基准底模存储隔离:真实的身份证底库、用户原始注册底模切勿直接暴露下发给前端。基准特征向量应存放在后端受限数据库(如 PostgreSQL + pgvector 或 Redis)。
- 服务端权威双重验证:前端利用 face-api.js 进行实时的对齐检测与交互式反馈(提升用户体验),在用户完成抓拍后,将加密后的现场图片及上下文会话 Token 上报服务端。由服务端(Node.js / Python 容器)执行权威二次特征抽取与比对,杜绝篡改可能。
6. 常见问题排查与优化要点
在持续从
<video> 标签中读取帧进行比对时,TensorFlow.js 底层会频繁在 GPU 显存创建 Tensor 对象。如果不显式释放,几分钟内会导致浏览器标签页崩溃。务必使用 faceapi.tf.tidy(() => { ... }) 包裹临时计算过程,或在废弃不再使用的 Tensor 时调用 tensor.dispose()。
针对视频流比对的性能调优,建议采取以下措施:
- 降采样视频输入尺寸:摄像头捕获的 1080P 或 4K 原始帧不宜直接作为网络输入。人脸检测网络最佳输入尺寸在 320×240 至 640×480 之间,适当缩小尺寸可大幅降低推理耗时,且不损失特征提取精度。
- 离线底模预计算:在用户注册或管理员录入底库时,预先提取好基准底模的 128 维特征向量持久化存储。核验时只需提取一次现场特征,避免每次比对都重复推理两张完整图像。
适合浏览器端的轻量级JavaScript神经网络库推荐
2026-11-21 14:51:22
llama.cpp b12432的位置索引为何能减少缓存删除检查?
2026-11-16 19:09:49
OpenAI Agents SDK v0.24.0-alpha.8接入自有模型客户端要注意什么?
2026-11-16 13:01:56
Synthesia Syren接入Seedance 2.5,电影模式为什么不保证每次都用同一模型
2026-11-16 12:27:33
free-claude-code v6.19.35与v6.19.34分别改善哪些兼容与重试行为?
2026-11-16 11:10:36