

JS数组去重怎么处理NaN和undefined
讲解JavaScript数组去重时如何正确处理NaN和undefined,对比Set、includes、Map与indexOf的底层相等性规则,并说明稀疏数组与对象键冲突等常见误区。
在 JavaScript 中做数组去重时,如果数组里同时包含 NaN 和 undefined,最稳妥的做法是使用基于 SameValueZero 规则的 API——例如 new Set()、Array.prototype.includes() 或 Map。它们都会把多个 NaN 视为同一个值并保留一个,也能正常合并重复的 undefined;而传统的 === 和 indexOf() 会因为 NaN !== NaN 导致 NaN 丢失或重复。
一、为什么 NaN 和 undefined 在去重时表现不同
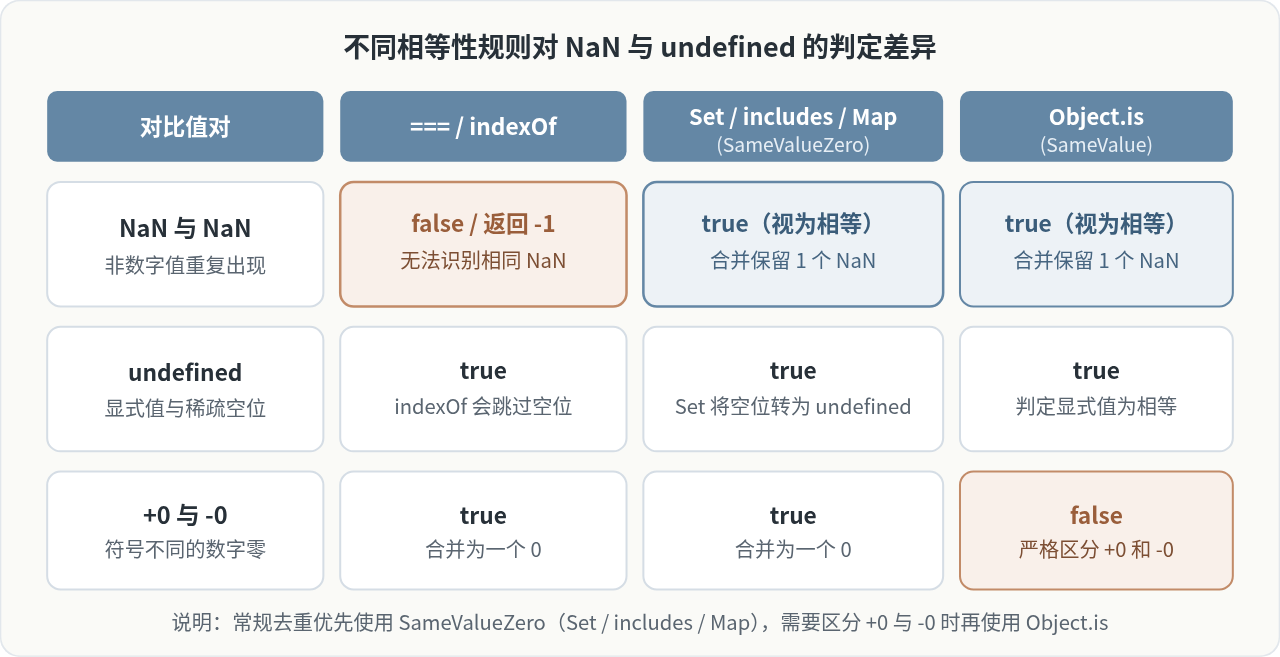
数组去重是否能正确处理这两个值,取决于去重方法底层采用哪种相等性比较规则。在日常写法中,主要涉及三种规则:严格相等(===)、SameValueZero(Set、Map、includes)以及 SameValue(Object.is)。
先看 NaN。根据 ECMAScript 规范,NaN 与任何值(包括它自身)使用 === 比较都返回 false。凡是内部依赖严格相等的方法,比如 indexOf() 和手写 a === b,都无法认出数组里已经存在一个 NaN。而 SameValueZero 和 SameValue 专门修正了这一点:只要两个操作数都是 NaN,就会判定为相等。
再看 undefined。对于正常写入数组的显式 undefined(例如 [undefined, undefined]),以上三种规则都会判定 undefined 等于 undefined,因此常规去重都能合并它们。undefined 真正容易出问题的场景有两个:一是用普通对象 {} 当哈希表时,undefined 会被转成字符串键名 "undefined";二是遇到稀疏数组空位(例如 [1, , 2])时,不同迭代方法对空位的处理方式不一致。
二、最简做法:使用 Set 一步去重
对于存放基础类型值的普通数组,直接使用 Set 配合展开运算符或 Array.from() 是最简洁的写法。Set 内部采用 SameValueZero 判断元素是否重复,同时把值按原始类型分别存储,因此不会把 NaN 与 "NaN"、undefined 与 "undefined" 混为一谈。
以下代码可在浏览器开发者工具控制台或 Node.js 环境中直接运行:
const arr = [NaN, undefined, NaN, 1, undefined, 'NaN', 'undefined', 1];
const result = [...new Set(arr)];
console.log(result);[ NaN, undefined, 1, 'NaN', 'undefined' ]
可以看到,多个 NaN 只保留了第一个,多个 undefined 也只保留了第一个,并且字符串 'NaN' 和 'undefined' 完整保留,没有发生类型混淆。
new Set() 通过迭代器遍历数组,会把稀疏空位(例如 [1, , 2] 中间未赋值的槽位)当作 undefined 处理。如果原数组存在空位且你不希望空位被转成 undefined,可以先用 Object.hasOwn(arr, i) 过滤出实际存在的索引,再交给 Set 去重。
三、需要自定义逻辑时:includes、Map 与 Object.is
实际开发里,有时不能只写一行 [...new Set(arr)]——例如需要在去重过程中跳过稀疏空位、对数组元素做预处理,或者根据对象数组里的某个字段(该字段的值可能是 NaN 或 undefined)去重。这时可以分别采用以下三种写法。
1. 遍历配合 includes()
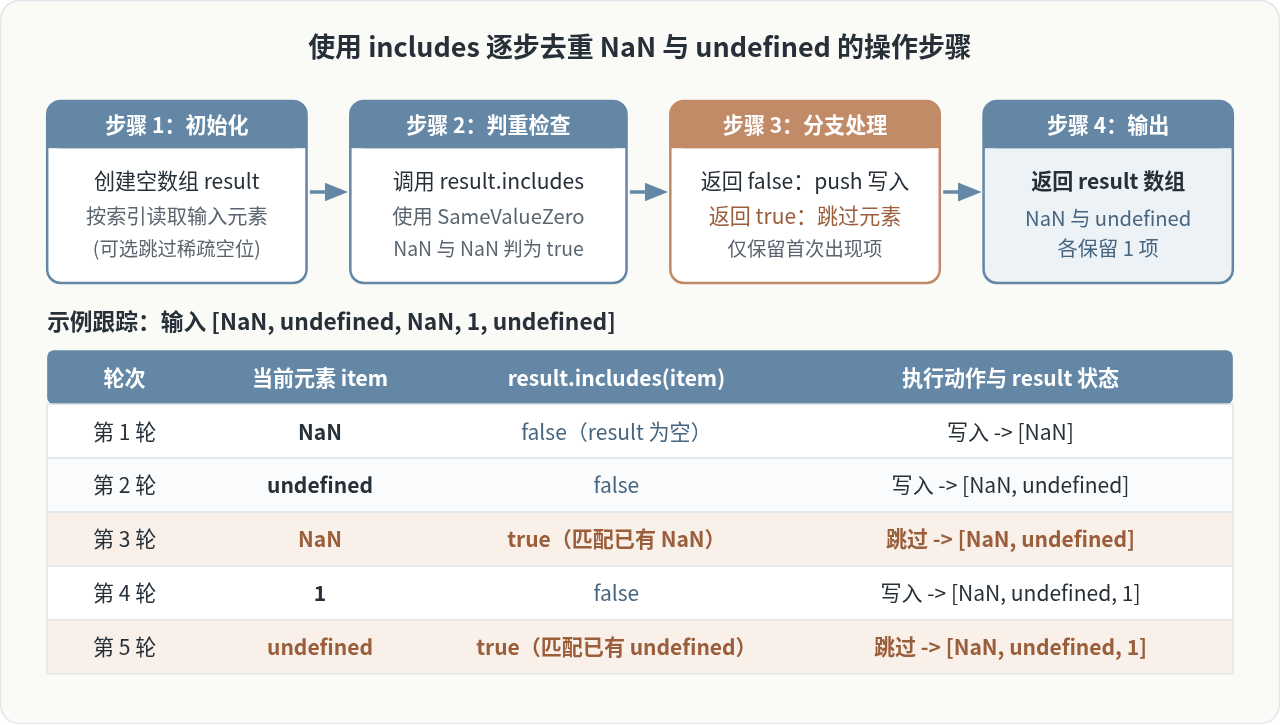
Array.prototype.includes() 同样使用 SameValueZero 算法,因此 result.includes(NaN) 在 result 已经包含 NaN 时会返回 true。如果希望跳过稀疏数组空位,可以用常规 for 循环配合 Object.hasOwn(或 i in arr)判断索引是否存在:
function uniqueWithIncludes(arr) {
  const result = [];
  for (let i = 0; i < arr.length; i++) {
    // 跳过稀疏数组中的空位,只处理真实存在的下标
    if (!Object.hasOwn(arr, i)) continue;
    const item = arr[i];
    if (!result.includes(item)) {
      result.push(item);
    }
  }
  return result;
}

const arr = [NaN, undefined, , NaN, 1, undefined];
console.log(uniqueWithIncludes(arr));[ NaN, undefined, 1 ]
如果确认数组本身是密集数组(没有空位),也可以把 for 循环简化为 for (const item of arr)。下面这张流程图展示了 includes() 逐步过滤 NaN 和 undefined 的过程。
2. 用 Map 做 O(n) 查重或对象数组按字段去重
当数据量较大时,result.includes(item) 每次都要从头扫描结果数组,整体时间复杂度接近 O(n2)。改用 Map(或 Set)记录已出现的值,可以把每次查重的复杂度降到常数级,而且 Map 的键同样遵循 SameValueZero 规则。
更常见的一个场景是“按对象里的某个属性去重”,且这个属性值可能是 NaN 或 undefined(例如接口返回的数据中缺少某字段或数值计算异常)。这时直接用 new Set(users) 只能比较对象引用地址,用普通对象 seen[key] 又会让键名转成字符串,而使用 Map 以字段值作键就能准确解决:
const list = [
  { id: 1, score: NaN },
  { id: 2, score: undefined },
  { id: 3, score: NaN },
  { id: 4, score: undefined },
  { id: 5, score: 'NaN' }
];

const seen = new Map();
const result = list.filter((item) => {
  if (seen.has(item.score)) return false;
  seen.set(item.score, true);
  return true;
});

console.log(result);[ { id: 1, score: NaN }, { id: 2, score: undefined }, { id: 5, score: 'NaN' } ]
在这段代码里,id: 3(score 为 NaN)和 id: 4(score 为 undefined)被正常过滤,id: 5(score 为字符串 'NaN')则被区分保留。
3. 还需要区分 +0 和 -0 时:用 Object.is()
大多数业务不区分 +0 和 -0;如果遇到科学计算或底层数据校验,既要合并 NaN 和 undefined,又要保留 +0 和 -0 的差异,就不能用 Set 或 includes()(它们把 +0 和 -0 视为相等),而应该使用 Array.prototype.some() 搭配 Object.is():
const arr = [NaN, NaN, undefined, undefined, +0, -0];
const result = [];

for (const item of arr) {
  if (!result.some((existing) => Object.is(existing, item))) {
    result.push(item);
  }
}

console.log(result);[ NaN, undefined, 0, -0 ]
四、三种常见写法的具体踩坑表现
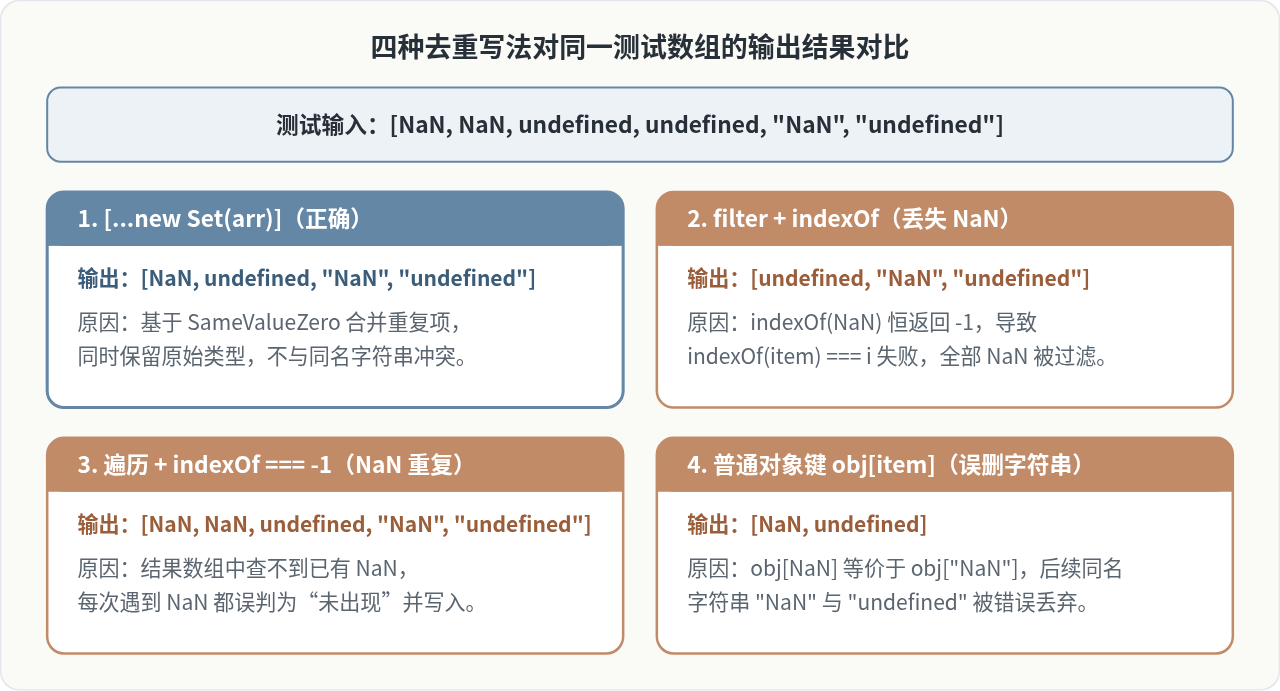
不少旧文章或老代码里还保留着 indexOf()、普通对象键和 JSON.stringify() 的去重写法。在数组不含特殊值时它们看似正常,一旦遇到 NaN、undefined 或对应同名字符串,就会出现不同形式的错误。
-
arr.filter((item, i) => arr.indexOf(item) === i)会丢掉全部NaN: 因为arr.indexOf(NaN)内部用===比较,永远返回-1,而当前下标i大于等于0,条件-1 === i恒为假,最终结果里连一个NaN都留不下。另外,filter()会跳过稀疏空位。 -
新建数组并判断
result.indexOf(item) === -1会让NaN重复保留: 每次遇到NaN时,result.indexOf(NaN)都返回-1,条件次次成立,导致有多少个NaN就写入多少个,根本没有去重。 -
用普通对象键
obj[item] = true会混淆类型: JavaScript 对象的属性键只能是字符串或 Symbol。写入obj[NaN]时键名变成"NaN",写入obj[undefined]时键名变成"undefined"。如果数组里同时有NaN和字符串"NaN",后出现的值会被误删。 -
用
JSON.stringify()序列化当键会抹平差异: 在 JSON 序列化中,NaN会变成"null",而作为数组元素或单独序列化时,undefined、NaN与null之间很难通过字符串安全区分,容易发生误合并。
五、不同场景下的选择建议
回到实际编写代码时,可以根据数组形态和判断条件直接对应下面的方案,避免继续使用依赖 indexOf() 或普通对象键的老写法:
| 具体场景 | 推荐方案 | 对 NaN 与 undefined 的表现 |
|---|---|---|
| 普通原始值数组去重 | [...new Set(arr)] |
各保留 1 个,类型不与字符串混淆 |
| 需跳过稀疏数组空位 | for + Object.hasOwn + Set / includes |
合并显式 NaN 与 undefined,空位不转成 undefined |
| 对象数组按字段去重 | filter + Map |
字段值为 NaN 或 undefined 时也能正常按首项保留 |
还需严格区分 +0 和 -0 |
循环 + some + Object.is |
合并 NaN 与 undefined,同时保留 +0 和 -0 |
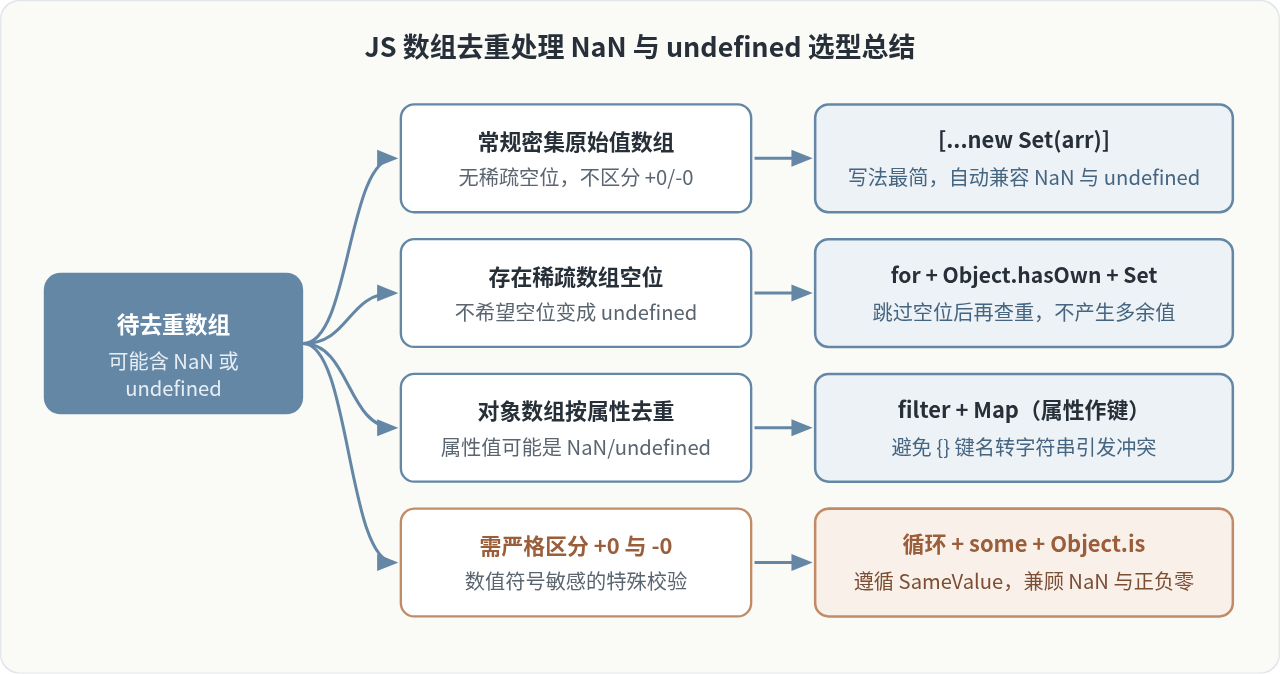
总结来说,处理 NaN 与 undefined 去重的核心就是避开严格相等(=== / indexOf)和普通对象键的隐式字符串转换,优先选择遵循 SameValueZero 的 Set、Map 或 includes();遇到稀疏空位或正负零敏感需求时,再补充 Object.hasOwn() 或 Object.is() 即可。
JavaScript for...in与for...of遍历数组的区别是什么
2026-11-21 22:44:49
JavaScript怎么处理含Emoji或特殊Unicode字符的反转乱码问题
2026-11-21 22:44:49
JS数组删除元素:splice修改原数组与filter生成新数组的区别
2026-11-21 18:56:39
JavaScript递归遍历树形结构的实现代码与逻辑详解
2026-11-21 18:40:24
JavaScript setTimeout和setInterval的基础语法与实例
2026-11-21 15:06:10
相关标签:







