

JavaScript for...in与for...of遍历数组的区别是什么
深入对比JavaScript中for...in与for...of遍历数组的核心区别。从底层原理、键值类型、原型链污染、稀疏数组处理及实际开发选型等方面详细剖析,帮助开发者规避隐蔽Bug。
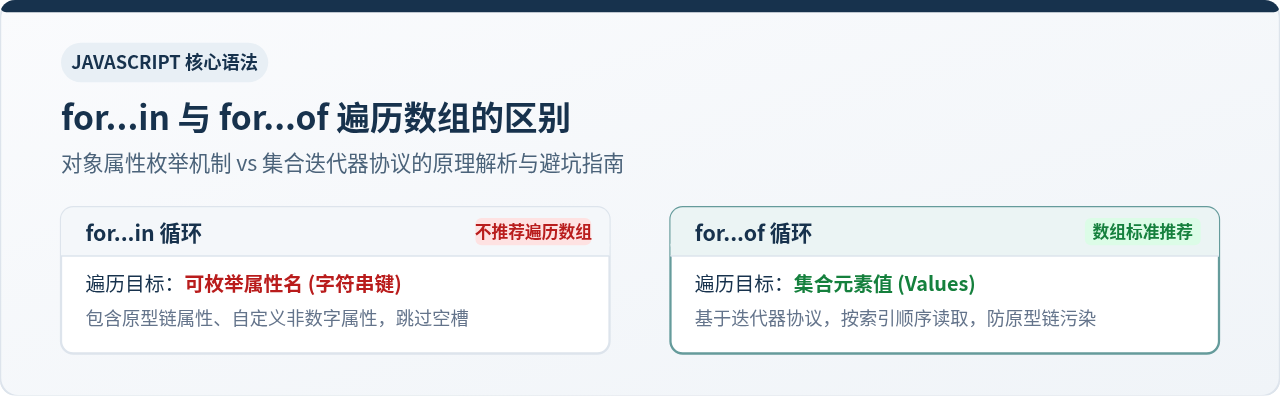
for...in 与 for...of 遍历数组最根本的区别在于“遍历的是属性名还是元素值”以及“遍历机制是否依赖迭代器协议”。for...in 专为遍历普通对象设计,它遍历的是所有可枚举的属性键名(字符串形式),且会遍历到自定义非数字属性和原型链上的扩展;而 for...of 是 ES6 引入的集合遍历器,它直接调用数组的迭代器协议(Iterator),仅按数值索引顺序取出数组的元素实际值。在日常开发中,应始终使用 for...of 遍历数组,绝不推荐使用 for...in。
一、核心表现对比:键名遍历与元素值遍历
初学者在遍历数组时,最容易遇到的困惑是循环变量中接收到的究竟是“下标”还是“内容”。我们通过一段基础代码直接观察两者的输出差异:
const fruits = ['苹果', '香蕉', '橙子'];

// 1. 使用 for...in
for (const key in fruits) {
  console.log(key, typeof key);
}
// 示例输出:
// "0"  "string"
// "1"  "string"
// "2"  "string"

// 2. 使用 for...of
for (const item of fruits) {
  console.log(item, typeof item);
}
// 示例输出:
// "苹果"  "string"
// "香蕉"  "string"
// "橙子"  "string"
从上面的输出可以清晰地看出两个根本性事实:
- for...in 产出的是键名(Key):循环变量接收到的是
"0"、"1"、"2"。需要格外注意,它的类型是字符串(String),而非数字。如果在循环内尝试执行key + 1计算下一个索引,由于字符串拼接特性,将会得到"01"、"11",从而导致严重的寻址计算错误。 - for...of 产出的是元素值(Value):循环变量直接绑定数组里的实际元素(如
"苹果"、"香蕉")。如果数组存储的是数字或对象,它会保留对应的数据类型,直接拿来运算或调用方法。
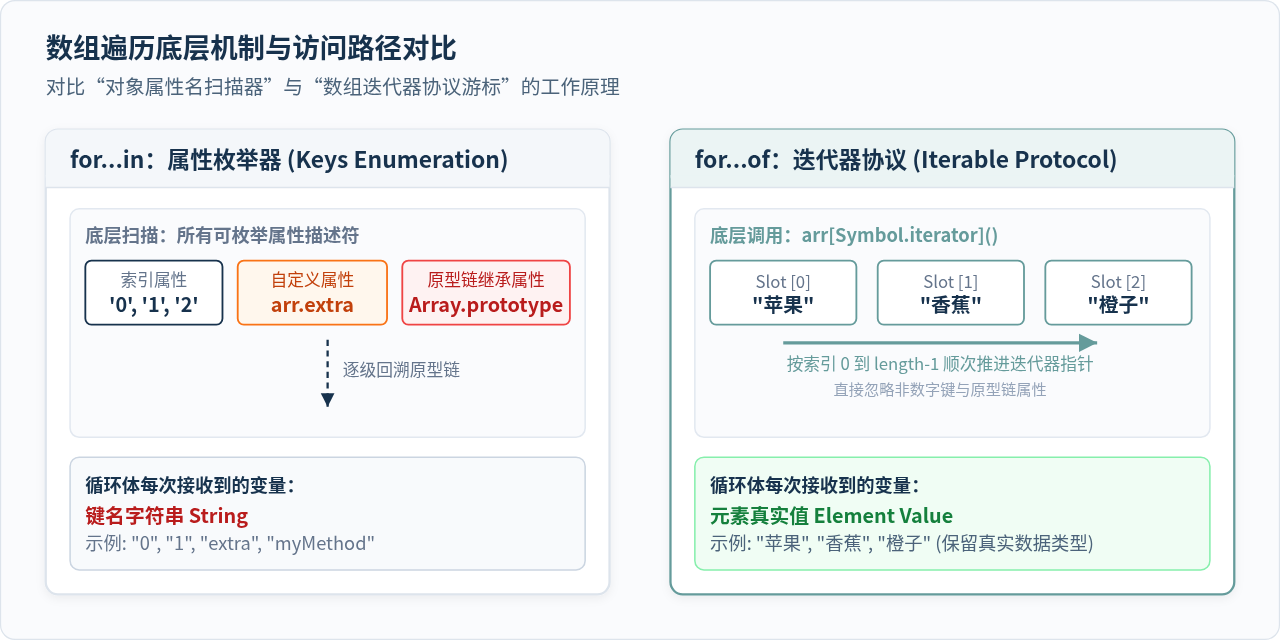
如架构图所示,两者在底层运作机制上的根本差异决定了它们的适用边界:
- for...in 属于对象属性枚举器:在底层调用规范中的
EnumerateObjectProperties机制。JavaScript 中的数组在底层也是对象,其索引本质上是对象的字符串属性名(如fruits["0"])。因此for...in是将数组当作普通对象去巡检每一个属性描述符。 - for...of 属于集合迭代器游标:在底层调用
fruits[Symbol.iterator]()。数组原型内置了迭代器生成器,游标严格根据数组的内部长度(length),按数字递增索引从0依次递增到length - 1,将每次迭代结果对象{ value, done }中的value交付给循环体。
二、执行陷阱解析:原型链污染与自定义属性
如果仅仅是“键”和“值”的区别,有人可能会想:“我用 for...in 拿到 key,再通过 fruits[key] 取值不也可以吗?”
这种做法隐藏着巨大的生产隐患。在大型协作项目或引入了第三方公共库的环境中,开发者可能会向数组原型链添加工具方法,或者在数组实例上添加元数据属性。此时 for...in 会暴露出严重的副作用。
const list = ['A', 'B'];

// 1. 为特定数组实例添加自定义附加属性
list.extraInfo = '内部标记';

// 2. 第三方库或旧项目扩展了 Array 原型链
Array.prototype.customHelper = function() { return 'helper'; };

// 执行 for...in 遍历
console.log('--- for...in 输出 ---');
for (const k in list) {
  console.log(`键: ${k}, 值: ${list[k]}`);
}
// 示例输出:
// 键: 0, 值: A
// 键: 1, 值: B
// 键: extraInfo, 值: 内部标记       <-- 意外产生!
// 键: customHelper, 值: [Function]  <-- 原型链被遍历!

// 执行 for...of 遍历
console.log('--- for...of 输出 ---');
for (const val of list) {
  console.log(`值: ${val}`);
}
// 示例输出:
// 值: A
// 值: Bfor...in 会循环遍历对象自身及其原型链上所有可枚举(enumerable: true)的属性。除非手动用 Object.hasOwn(list, k) 过滤,否则原型链上的属性必然会被扫出来,甚至导致逻辑崩溃。而 for...of 从设计根源上便不受原型链和自定义属性影响。
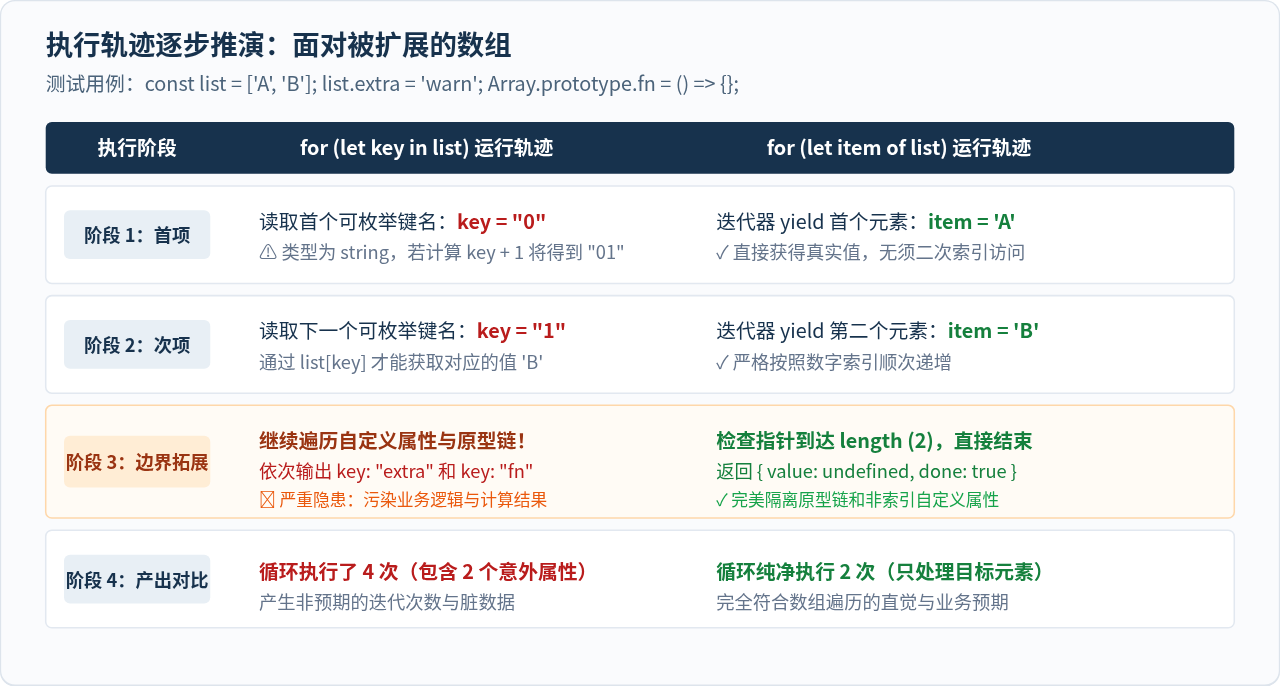
通过执行轨迹推导图可以清晰地看到:for...of 的终止条件严格受控于迭代器的结束标记 done: true,当且仅当数字下标遍历完毕即告结束;而 for...in 会持续向上追溯直到 Object.prototype,把所有未设置不可枚举标记的方法一并读入,这在处理数据数组时往往是不可接受的。
三、边界场景深度剖析:稀疏数组与执行顺序
除了键值类型与原型链的区别外,在应对复杂业务边界(如稀疏数组、迭代顺序)时,两者的表现同样截然不同。
1. 稀疏数组(Sparse Array)与空槽处理
当数组中存在没有显式赋值的“空槽”(hole)时(例如使用 new Array(3) 或数组字面量直接跳过 [1, , 3]),两者的行为出现了明显分化:
const sparseArr = ['X', , 'Z']; // 中间索引 1 是空槽 (empty slot)

console.log('sparseArr 长度:', sparseArr.length); // 3

// for...in 表现
for (const index in sparseArr) {
  console.log('for...in:', index);
}
// 示例输出:
// for...in: "0"
// for...in: "2"  (跳过了索引 1)

// for...of 表现
for (const item of sparseArr) {
  console.log('for...of:', item);
}
// 示例输出:
// for...of: "X"
// for...of: undefined  (访问了索引 1 并产出 undefined)
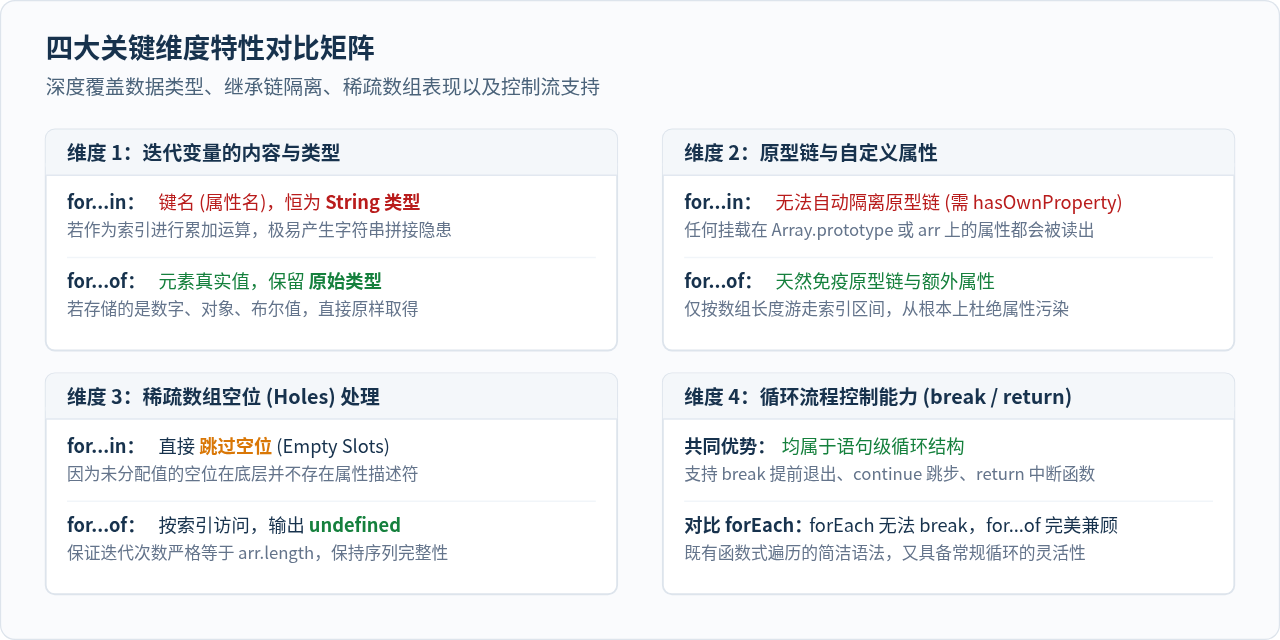
// for...of: "Z"原因解释:for...in 依靠检查对象的固有属性描述符。在稀疏数组中,未赋值的槽位根本不存在对应的属性名,因此被直接跳过;而 for...of 依据迭代器协议按部就班从 0 遍历到 length - 1,在访问 sparseArr[1] 时,JavaScript 引擎计算出的值为 undefined,因此会被完整读出。这确保了迭代次数与 arr.length 保持绝对一致。
2. 遍历顺序的确定性
虽然 ECMAScript 规范逐步规范了普通对象的属性枚举顺序,但 for...in 在不同历史版本和特定复杂环境下的枚举顺序并不总是等同于数值升序,特别是在混杂了非整数键和原型属性时。而 for...of 规范明确规定数组迭代器必须严格按照 0, 1, 2, ..., length - 1 的升序数字序列递增,保证了序列流计算的时序稳定性。
四、数组遍历选型指南与常见需求解答
理解了两者的技术差异后,我们在实际编码中应该如何选择数组遍历方案?以下是针对高频场景的推荐实践。
问题 1:如果使用 for...of,如何同时获取下标和值?
很多开发者之所以冒险去用 for...in,是因为希望能拿到索引。在 ES6 中,优雅的官方解法是配合 arr.entries():
const fruits = ['苹果', '香蕉', '橙子'];

for (const [index, fruit] of fruits.entries()) {
  console.log(`序号: ${index + 1}, 名称: ${fruit}`);
}
// 示例输出:
// 序号: 1, 名称: 苹果
// 序号: 2, 名称: 香蕉
// 序号: 3, 名称: 橙子index 是严格的数字类型(typeof index === 'number'),进行 index + 1 数学计算完全符合预期,同时享受 for...of 隔离原型链的所有安全性。
问题 2:for...of 与 forEach 的控制流差异
与数组实例方法 fruits.forEach(...) 相比,for...of 属于原生的循环控制语句,具有完整的控制流中断与异步调度能力:
- 支持流程打断:可以在循环体内部随时使用
break提前退出、使用continue跳过当前轮次,或在函数内使用return直接返回。forEach的回调函数则无法被break中断。 - 完美支持异步等待:可以在
for...of内部直接使用await,保证异步任务按序列串行执行;而forEach传入async函数会导致并发无序,无法阻塞后续代码。
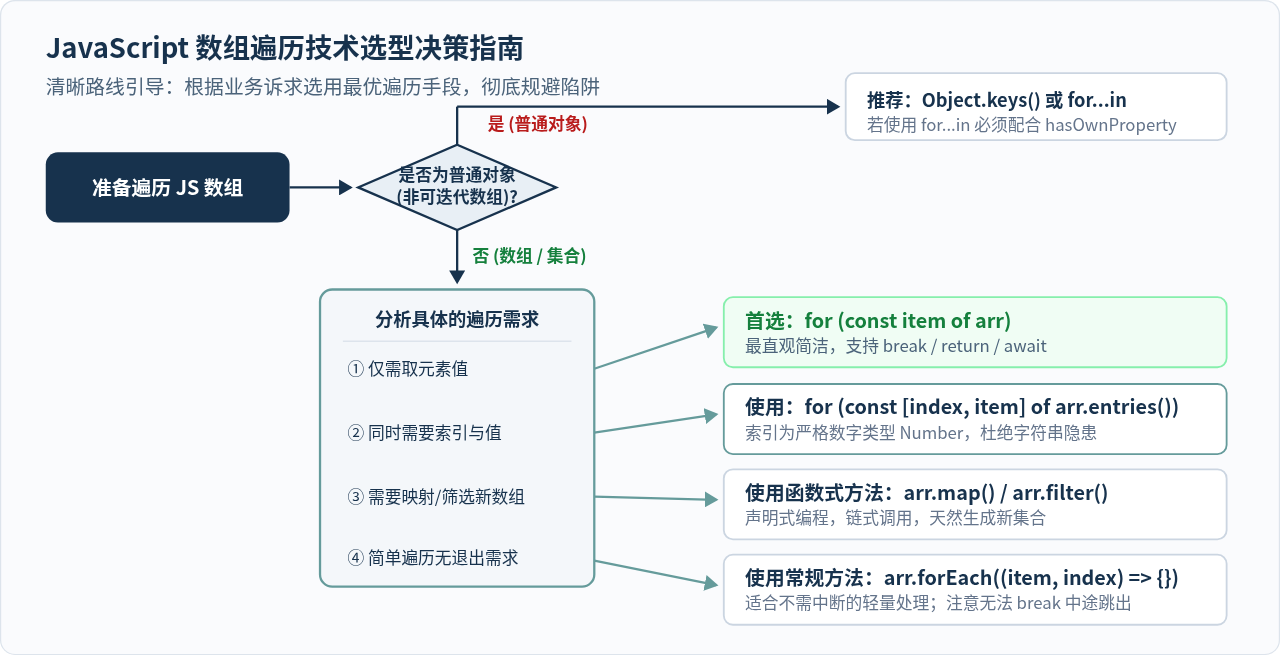
五、总结与速查清单
为了便于日常编码快速核对,下表系统总结了 for...in 与 for...of 在数组遍历中的全部关键指标:
| 比较维度 | for...in | for...of |
|---|---|---|
| 核心用途 | 枚举普通对象的可枚举属性 | 遍历可迭代对象(数组、Map、Set、字符串等) |
| 产出内容 | 属性名(键名) | 集合元素(值) |
| 迭代变量类型 | 字符串 String(易产生加法拼接 Bug) | 数据原生类型(保留数值/对象等类型) |
| 原型链隔离 | 否(会遍历到 Array.prototype 扩展) | 是(天然免疫原型链与自定义属性) |
| 稀疏数组空位 | 跳过未定义的空槽 | 输出 undefined(维持 length 一致性) |
| 控制流支持 | 支持 break / continue / return | 支持 break / continue / return |
| 获取下标方法 | 直接获取(但为字符串键) | 配合 arr.entries() 获取真实数字索引 |
| 数组场景推荐度 | ✗ 强烈不推荐 | ✓ 官方标准推荐 |
最终总结原则:在 JavaScript 中处理普通对象键名时使用 for...in(或更安全的 Object.keys() / Object.entries());而在处理数组、集合及其元素值时,for...of 始终是更安全、更直观、更符合现代规范的第一选择。
JavaScript怎么处理含Emoji或特殊Unicode字符的反转乱码问题
2026-11-21 22:44:49
JS数组删除元素:splice修改原数组与filter生成新数组的区别
2026-11-21 18:56:39
JavaScript递归遍历树形结构的实现代码与逻辑详解
2026-11-21 18:40:24
JavaScript setTimeout和setInterval的基础语法与实例
2026-11-21 15:06:10
为什么JS代码执行了但控制台没打印?排查过滤与异步问题
2026-11-21 13:12:59







