

JS数组交集:filter与includes基础实现
深入解析JavaScript中利用filter与includes实现数组交集的基础方法,包含完整执行过程拆解、代码示例、对象引用与重复项避坑指南及性能边界分析。
在 JavaScript 日常业务开发中,计算两个数组的交集(即找出同时存在于两个数组中的元素)是一项高频基础需求。最直观、易读且无需引入任何外部依赖的实现方式,就是组合使用数组原生的 filter 与 includes 方法。本文将从核心语法切入,详细拆解这一实现的内部工作原理、执行步骤、常见陷阱(重复项与引用类型),并给出清晰的性能适用边界。
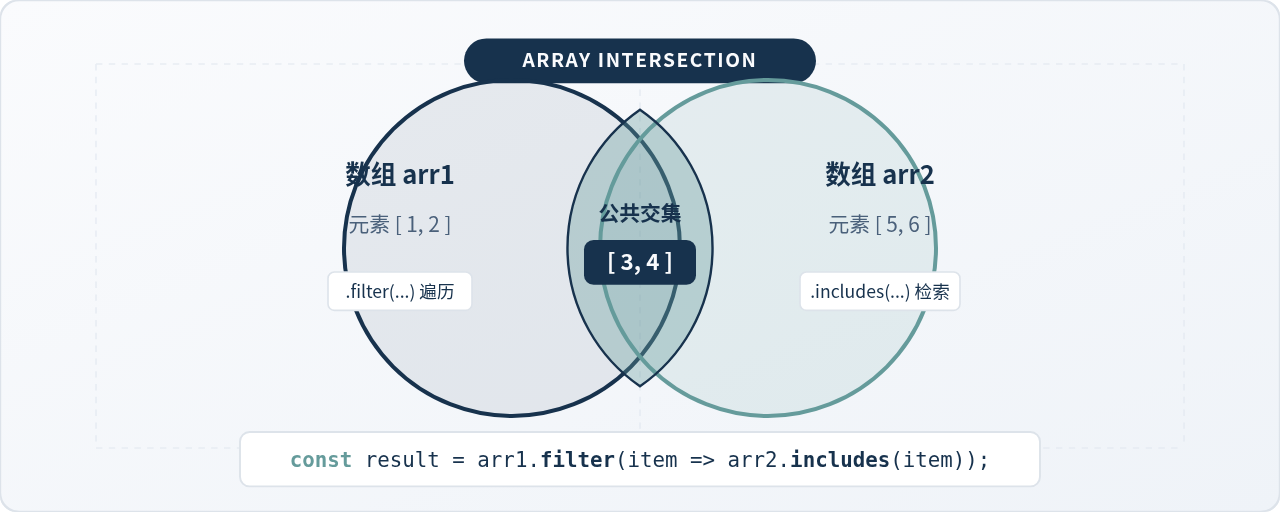
一、核心语法与基础代码实现
求交集操作的本质是一个“遍历并筛选”的过程:以第一个数组为主体逐项筛选,同时在第二个数组中确认当前项是否已经存在。若存在则保留,反之则舍弃。
filter 负责创建由通过测试的所有元素组成的新数组,而 includes 负责判断数组是否包含某个指定值并返回布尔值。两者的结合形成了一行精简的交集求解器:
// 基础交集实现函数
function getIntersection(arr1, arr2) {
  return arr1.filter(item => arr2.includes(item));
}

// 声明测试用例数据
const listA = [1, 2, 3, 4, 5];
const listB = [3, 4, 5, 6, 7];

const commonElements = getIntersection(listA, listB);
console.log(commonElements);
在上面的示例中,listA 中仅有数字 3, 4, 5 同时存在于 listB 中,因此最终得到包含这三个元素的新数组。原数组 listA 与 listB 在整个过程中均不会被修改,保证了函数的纯洁性与数据不可变性。
二、分步执行过程与内部机制拆解
为了透彻理解这段代码在底层是如何运行的,我们将其拆解为五个确切的步骤。整个操作流程呈现为一个清晰的双层嵌套循环结构:
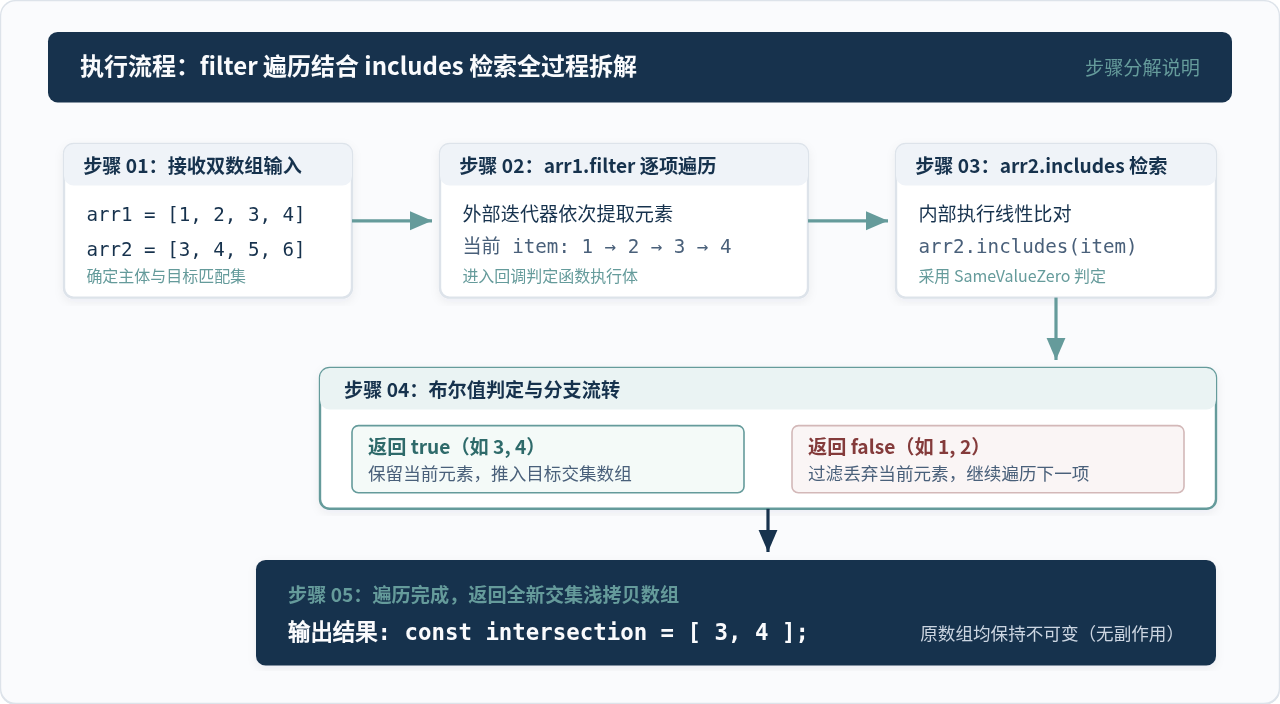
- 接收参数:函数获取输入的基准数组
arr1与比对目标数组arr2。 - 启动 filter 遍历:
arr1.filter启动内置迭代器,从索引0开始依次取出元素赋值给形参item。 - 触发 includes 检索:对于每一个
item,调用arr2.includes(item)。此时 JavaScript 引擎在arr2内部从头到尾进行线性比对(使用SameValueZero比较算法)。 - 判定与分支筛选:若在
arr2中找到了相同的值,includes立即返回true,filter会将该item暂存入结果队列;若遍历完整数组未找到对应值,则返回false,当前元素被跳过。 - 返回全新数组:当
arr1的所有元素均遍历完毕后,filter将收集到的全部符合条件元素打包为一个全新数组浅拷贝并返回。
三、核心注意事项与两大踩坑点
虽然 filter + includes 写法极其简明,但在实际生产环境中处理复杂数据时,有两处极其容易忽略的关键细节。
1. 数组含有重复项时的行为表现
需要特别注意:filter 是以第一个数组 arr1 为驱动基准的。如果 arr1 本身包含重复元素,只要该元素在 arr2 中存在,每一次遍历都会成功通过 includes 校验,从而导致最终交集结果也包含重复项。
// 重复项场景测试
const arrWithDupes1 = [1, 2, 2, 3, 4];
const arrWithDupes2 = [2, 3, 6];

const resultWithDupes = arrWithDupes1.filter(item => arrWithDupes2.includes(item));
console.log(resultWithDupes);arr1 进行去重,或者直接使用 Set:
const uniqueIntersection = [...new Set(arr1)].filter(item => arr2.includes(item));
2. 对象与引用类型的比对陷阱
includes 底层采用与严格相等 === 极为接近的 SameValueZero 规范比较。对于数字、字符串、布尔值等基本数据类型,它是直接比较具体字面量的值;但对于数组、普通对象等引用数据类型,它比对的是内存中的引用地址指针。
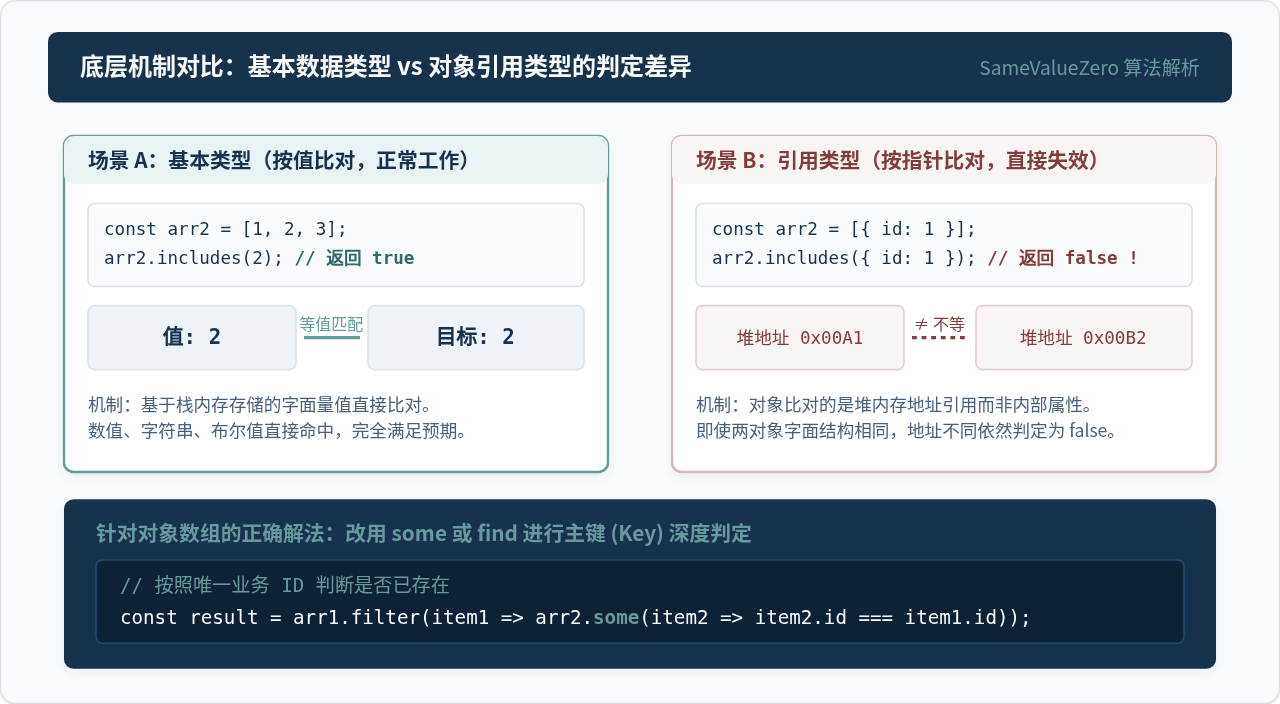
// 引用类型陷阱示例
const usersA = [{ id: 1, name: 'Alice' }, { id: 2, name: 'Bob' }];
const usersB = [{ id: 2, name: 'Bob' }, { id: 3, name: 'Charlie' }];

// 错误做法:直接使用 includes
const failedResult = usersA.filter(userA => usersB.includes(userA));
console.log(failedResult);
正确解法:当处理对象数组时,应依据唯一的业务主键(例如 id)进行比对,将 includes 替换为 some:
// 正确做法:使用 some 按业务标识比对
const correctResult = usersA.filter(userA =>
  usersB.some(userB => userB.id === userA.id)
);
console.log(correctResult);四、性能瓶颈与时间复杂度考量
任何算法的选型都离不开对数据规模的权衡。arr1.filter(item => arr2.includes(item)) 之所以被称为“基础实现”,是因为它在提供最高易读性的同时,隐含着二次方级别的时间复杂度开销。
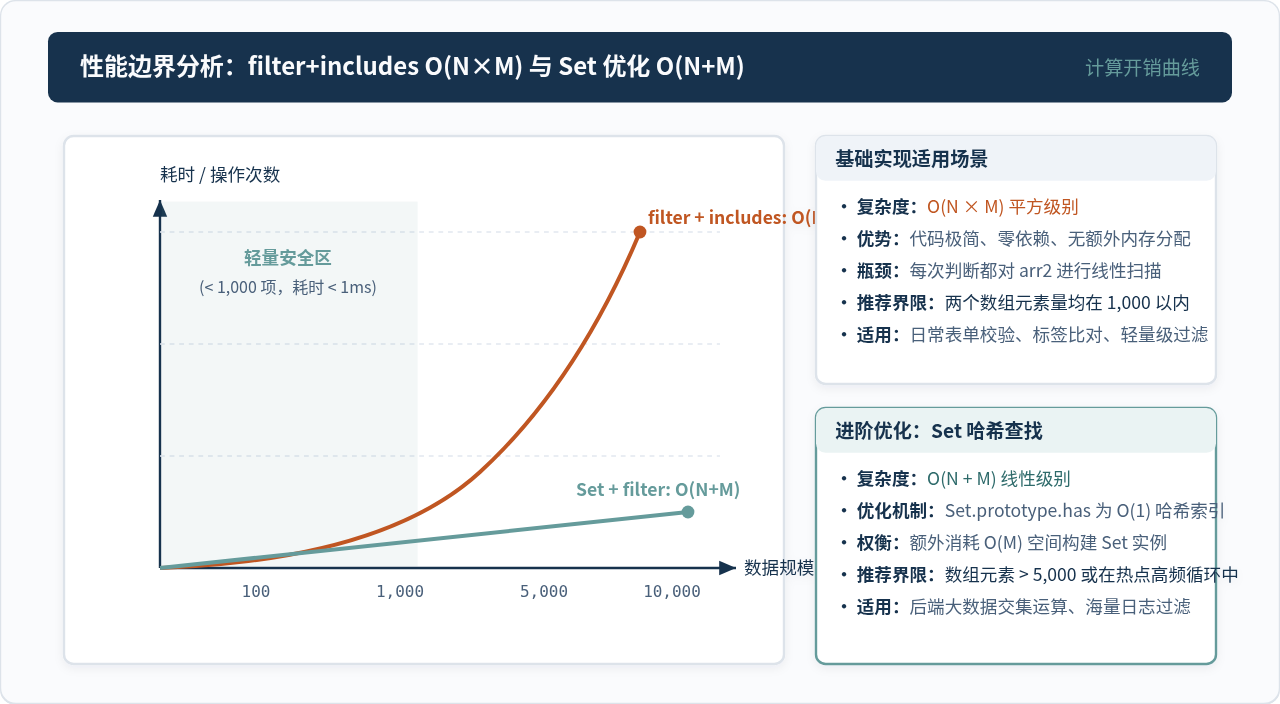
- 时间复杂度分析:
arr1.filter需要迭代N次(N = arr1.length)。在每一次迭代中,arr2.includes最多需要线性遍历M个元素(M = arr2.length)。因此总时间复杂度为 O(N × M)。如果两个数组长度相近(设为K),复杂度则为 O(K²)。 - 空间复杂度:除了存储最终交集的新数组外,整个过程没有额外开辟辅助映射表或数据结构,辅助空间复杂度为 O(1)。
- 适用规模分界线:在现代 V8 等 JavaScript 引擎中,当
N, M < 1,000时,双层循环的执行耗时通常低于 1 毫秒,体验极为流畅;但当数据规模增长至10,000以上时,比对次数达到亿级,会导致明显的界面卡顿。
Set。Set 的底层实现是哈希表,其 has 方法检索时间复杂度仅为 O(1):
const set2 = new Set(arr2);
const fastResult = arr1.filter(item => set2.has(item));
此优化方案将总体时间复杂度直接降为线性 O(N + M)。
五、方案选型矩阵与总结
在实际项目架构与日常编码中,可以根据数据形态(基本类型还是对象)、数据量级以及去重诉求,依据以下决策路径进行合理选型:
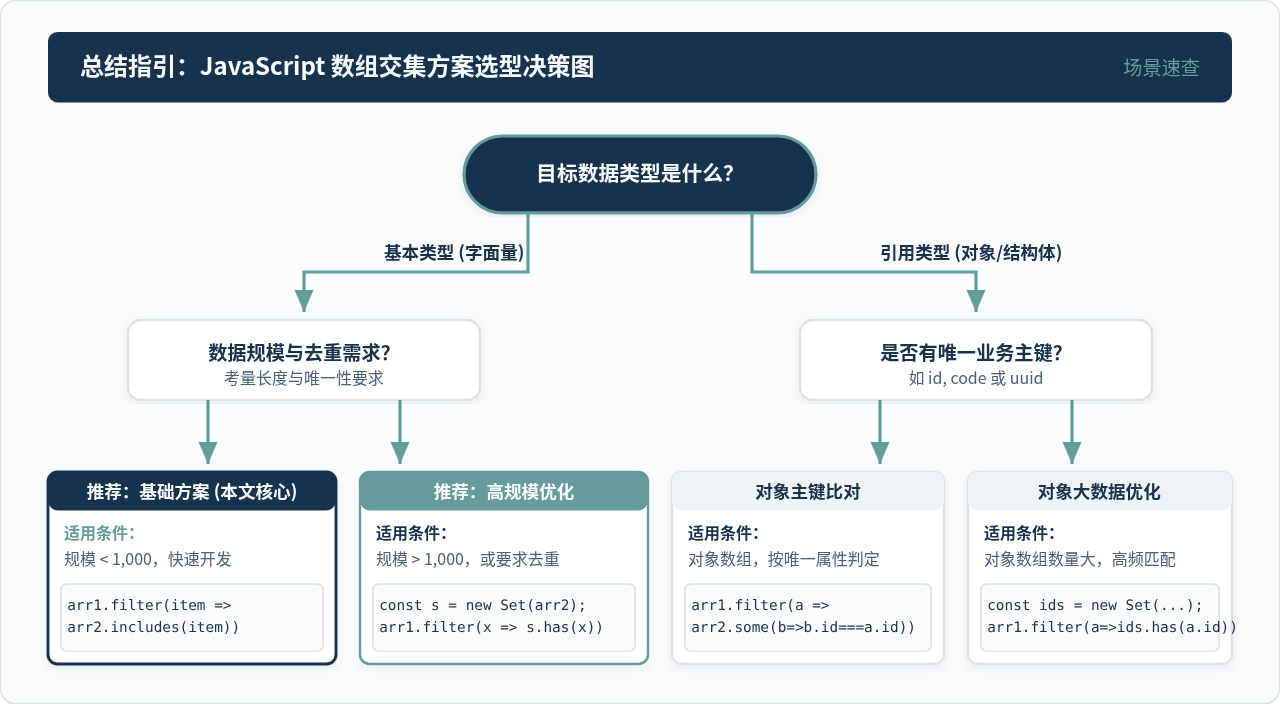
| 实现方式 | 时间复杂度 | 代码简洁度 | 支持对象数组 | 核心适用场景 |
|---|---|---|---|---|
| filter + includes | O(N × M) | ★★★★★(一行代码) | 否(仅基础类型) | 数据量小于 1000、原型开发、轻量级日常比对 |
| Set + filter + has | O(N + M) | ★★★★☆(清晰直接) | 否(仅基础类型) | 万级以上规模数据、高频密集运算、性能敏感型任务 |
| filter + some | O(N × M) | ★★★★☆(语法直观) | 是(指定唯一键) | 中小规模对象数组按业务 ID 比对交集 |
| Set(Map) + filter | O(N + M) | ★★★☆☆(需前置提取) | 是(基于哈希键) | 大规模复杂实体集合的高性能关联匹配 |
总结而言,filter + includes 是理解 JavaScript 数组高阶函数协同运作的绝佳范例。只要掌握好基本数据类型适用范围、留意重复项保留特征,并在面对海量数据时及时升级到 Set 哈希索引,就能在代码简洁度与执行性能之间取得最佳平衡。
怎么实现可暂停和恢复的JS定时循环逻辑
2026-11-21 21:30:59
怎么遍历JavaScript Map中的键值对
2026-11-21 20:30:02
JavaScript构造函数是什么:与普通函数的区别及基本用法
2026-11-21 19:11:19
JavaScript怎么将字符串拆分为单个字符数组
2026-11-21 16:49:51
JavaScript是什么:脚本语言的定义与核心特性
2026-11-21 14:32:41







