

JavaScript实现不重复随机数序列的方法
详细解析在JavaScript中生成不重复随机数序列的多种实现方案,包括Fisher-Yates洗牌算法、Partial局部抽样、Set循环查重法,并深入剖析sort随机排序的反模式陷阱及加密级随机数生成实践。
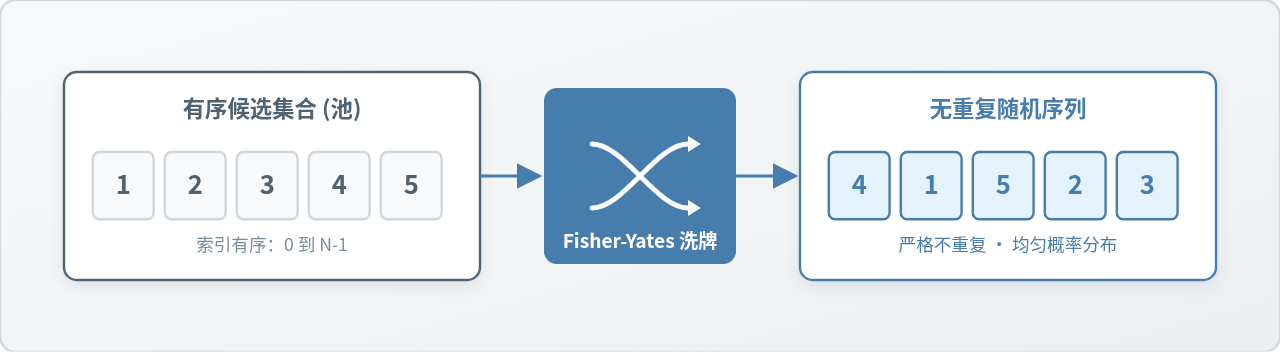
在前端交互、在线考试题库抽题、活动抽奖以及棋牌游戏等业务场景中,生成一组不重复的随机数序列是一项常见且关键的基础需求。JavaScript 内置的 Math.random() 函数只负责生成独立的伪随机浮点数,它本身并不维护任何历史状态,无法直接保证前后两次抽取的数值不发生重复。实现“不重复”的核心本质,在于从限定集合中进行“无放回抽样”,或将一个确定长度的离散序列进行“均匀打乱”。本文将针对不同的实际开发场景,具体拆解基于 Set 查重、标准 Fisher-Yates 洗牌、局部抽样优化以及加密级安全生成的实现方案,并分析工程实现中常见的误区与性能边界。
一、朴素方案:基于 Set 查重的循环生成法
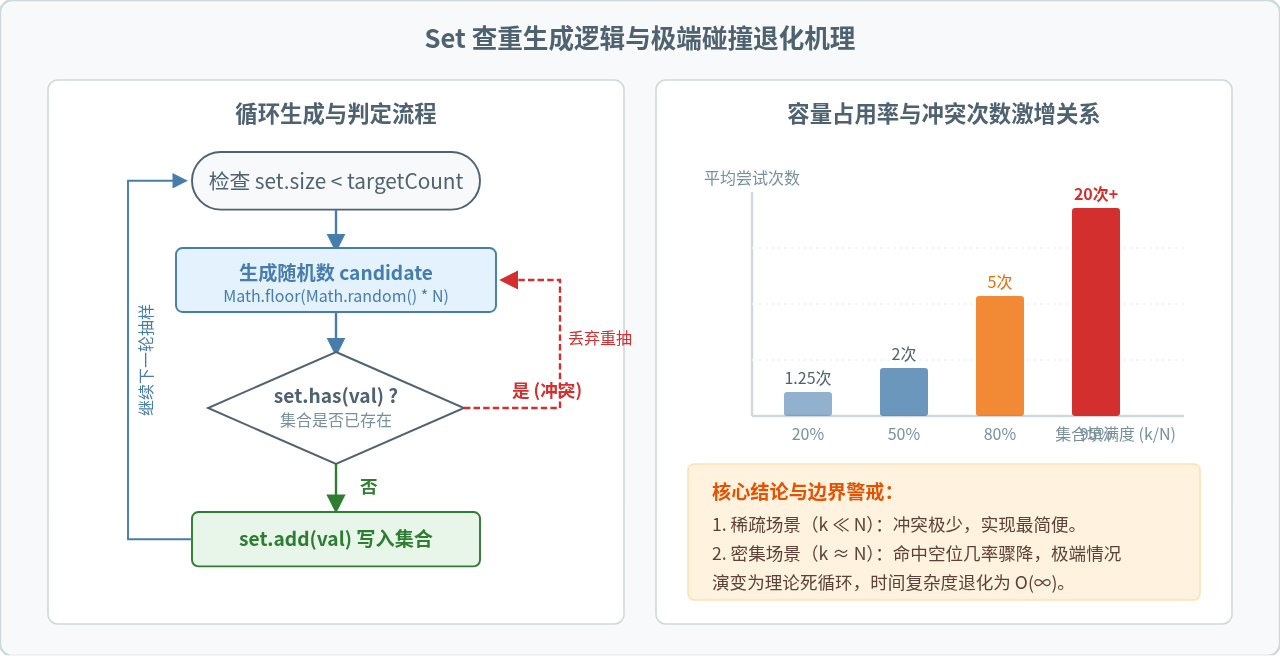
对于刚接触随机数生成的开发者而言,最直观的思路是使用一个循环结构反复调用 Math.random(),借助 ES6 的 Set 集合天然具备的键去重能力,若生成的数字在集合中已存在则忽略,不存在则加入,直到集合尺寸满足目标长度。
1. 具体实现代码
function generateUniqueBySet(min, max, count) {
  const totalAvailable = max - min + 1;
  if (count > totalAvailable) {
    throw new Error(`目标数量 count (${count}) 超出了范围最大容量 (${totalAvailable})`);
  }

  const resultSet = new Set();
  while (resultSet.size < count) {
    const num = Math.floor(Math.random() * totalAvailable) + min;
    resultSet.add(num);
  }

  return Array.from(resultSet);
}

// 示例调用:在 1 到 100 之间抽取 5 个不重复整数
const sample = generateUniqueBySet(1, 100, 5);
console.log('Set 抽样结果:', sample);
2. 适用场景与碰撞退化风险
该方案的代码简洁、符合直觉,在抽样数量远小于可用总池(即 \(k \ll N\))的极稀疏场景下(例如从 10,000 个题目中随机挑出 3 道展示),因为发生数值碰撞的概率微乎其微,程序能够以极高速度返回结果,辅助内存开销也仅为 \(O(k)\)。
然而,该方法存在显著的退化风险。随着集合中已填充元素数量的增加,下一次随机命中“尚未出现的数值”的概率会急剧下降。当我们需要生成的数量 \(k\) 接近可用总数 \(N\) 时(例如在 1 到 100 中取 99 个不重复数),最后剩下的几个空位将需要成百上千次无效的随机重试才能碰巧命中。在极端情况下,算法的时间复杂度会退化为理论上的 \(O(\infty)\),甚至引发主线程无响应或卡死。
二、工业级标准方案:Fisher-Yates (Knuth) 洗牌算法
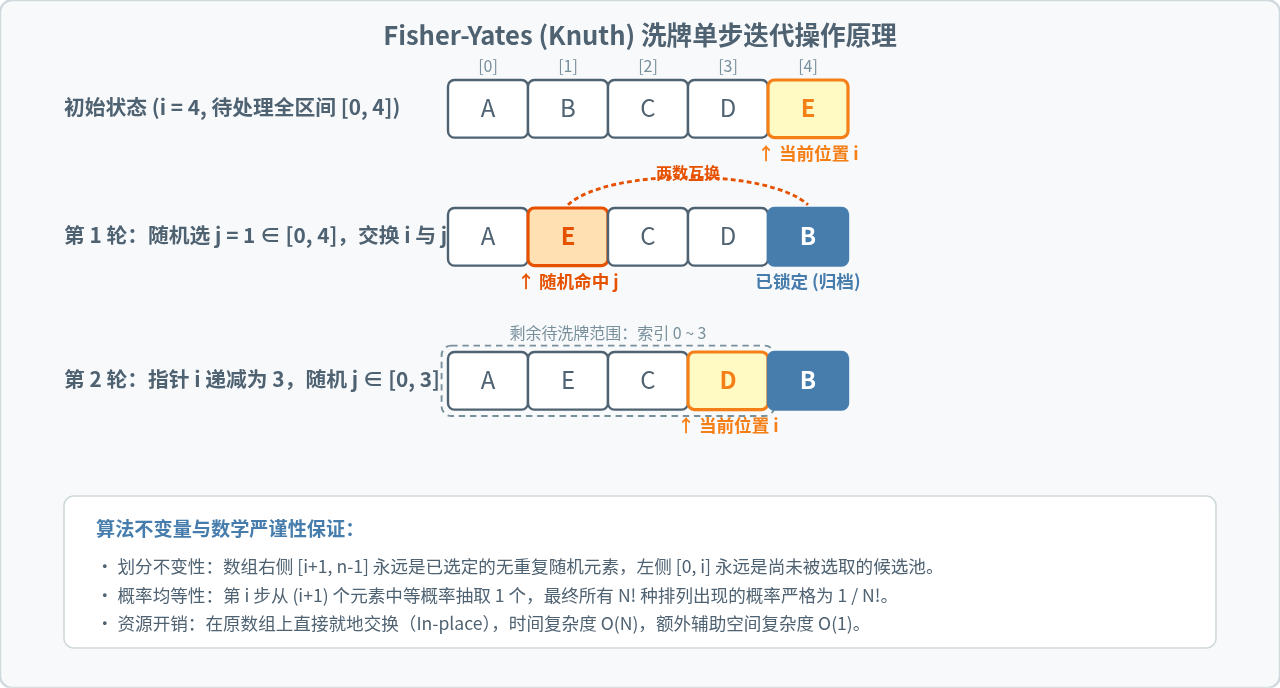
针对生成确定长度的不重复随机序列,计算机科学中公认最优且数学严谨的解法是 Fisher-Yates 洗牌算法(亦称 Knuth 洗牌)。该算法通过就地交换(In-place Swap),在严格 \(O(N)\) 的线性时间复杂度与 \(O(1)\) 的辅助空间内,确保全排列中每一种顺序出现的概率均为绝对均等的 \(1 / N!\)。
1. 算法核心步骤与逻辑
- 首先构造一个包含目标范围内全部候选元素的连续数组。
- 初始化索引指针
i指向数组末尾元素(即索引 \(N - 1\))。 - 在闭区间
[0, i]内随机挑选一个整数索引j。 - 将索引
i处的元素与索引j处的元素进行互换。此时位置i处的数值已彻底完成随机确定,归入“已就位区”。 - 将指针
i向前递减 1,重复步骤 3 和 4,直到i移动至索引 0 结束。
2. 完整 JavaScript 代码实现
/**
 * 原地打乱数组的 Fisher-Yates 洗牌函数
 * @param {Array} array 待打乱的原始数组
 * @returns {Array} 打乱后的原数组引用
 */
function shuffleArray(array) {
  for (let i = array.length - 1; i > 0; i--) {
    // 生成 [0, i] 之间的随机整数索引
    const j = Math.floor(Math.random() * (i + 1));
    // 使用 ES6 解构赋值进行原地交换
    [array[i], array[j]] = [array[j], array[i]];
  }
  return array;
}

/**
 * 生成指定范围内完整不重复的随机整数序列
 * @param {number} min 最小值 (包含)
 * @param {number} max 最大值 (包含)
 */
function generateShuffledRange(min, max) {
  const length = max - min + 1;
  // 快速构建连续升序数组 [min, min+1, ..., max]
  const pool = Array.from({ length }, (_, index) => min + index);
  return shuffleArray(pool);
}

// 示例输出:生成 1 到 10 的打乱无重复序列
const shuffledSequence = generateShuffledRange(1, 10);
console.log('全量洗牌结果:', shuffledSequence);j 时,乘数必须是 (i + 1)。这意味着元素有可能被选中“与自身交换”(即 j === i),这是保证数学上每一种排列概率严格对称(等概率)的必备前提;如果仅在 [0, i - 1] 中选择,会导致部分组合的生成几率发生系统性倾斜。
三、局部抽样优化:Partial Fisher-Yates 算法
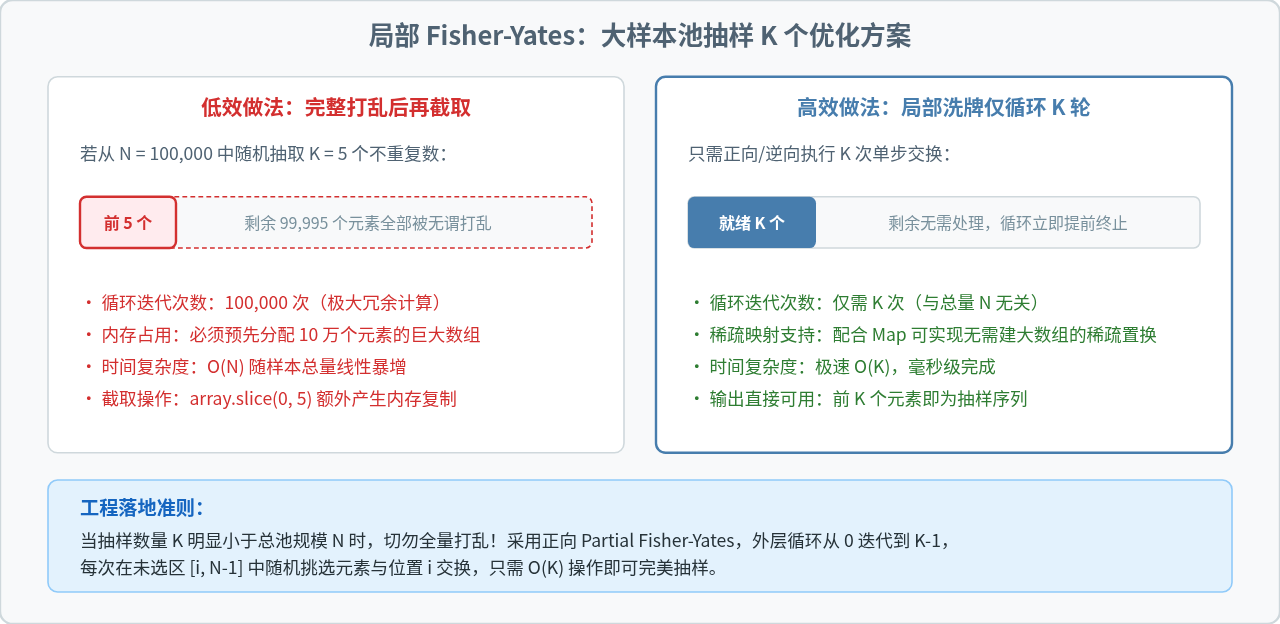
在日常业务开发中,还有一种高频需求:从总量非常大的池子 \(N\) 中,只抽取 \(K\) 个不重复的随机数(例如:在 100 万名注册用户中抽取 10 名幸运奖)。
如果使用全量洗牌,我们必须先在内存中分配包含 100 万个数字的大数组,并执行 100 万次完整的洗牌循环,最后再调用 slice(0, 10),这不仅会占用几十兆字节的内存空间,还会造成 99.999% 的无用计算浪费。此时,最优雅的解法是采用正向局部 Fisher-Yates 抽样。
1. 局部洗牌算法原理
与逆序洗牌相反,我们从数组头部索引 0 开始正向遍历,只需循环执行 k 次。在第 i 步时,在剩余的未处理区间 [i, n - 1] 内随机挑选一个位置 j,与位置 i 进行交换。当循环运行完 k 轮之后立即提前终止,数组的前 k 个位置就正好是一个均匀分布、绝无重复的抽样结果。
2. 代码实现:高性能局部抽样
/**
 * 从连续数字范围中高效抽取 k 个不重复随机数
 * @param {number} min 范围起点
 * @param {number} max 范围终点
 * @param {number} k 抽样数量
 */
function sampleUniqueNumbers(min, max, k) {
  const n = max - min + 1;
  if (k > n) {
    throw new Error('抽样数量不能大于可用范围总数');
  }

  // 初始化数组
  const array = Array.from({ length: n }, (_, index) => min + index);

  // 仅需循环 k 次,完成前 k 个位置的就地随机置换
  for (let i = 0; i < k; i++) {
    // 在剩余区间 [i, n - 1] 中选取随机索引 j
    const j = i + Math.floor(Math.random() * (n - i));
    [array[i], array[j]] = [array[j], array[i]];
  }

  // 直接提取前 k 个已完成抽样的元素返回
  return array.slice(0, k);
}

// 示例:从 1 到 1000 中随机抽取 5 个数,仅执行 5 次循环交换
const luckyWinners = sampleUniqueNumbers(1, 1000, 5);
console.log('局部抽样结果:', luckyWinners);
四、避坑预警:为什么严禁使用 sort(() => Math.random() - 0.5)
在网络上许多简易教程或问答社区中,经常可以看到一行极为精炼的代码:
// 危险反模式:请勿在生产环境中使用!
const badShuffle = array.sort(() => Math.random() - 0.5);尽管这行代码非常简短,但在严肃的生产开发中它被明确定义为反模式(Anti-pattern),存在两大致命缺陷:
- 概率分布严重不均(非等概率):标准的排序算法(例如 Chrome V8 引擎中的 Timsort 算法)内部依赖严格的元素全序关系传递性(即若 \(A > B\) 且 \(B > C\),则必须有 \(A > C\))。而
Math.random() - 0.5每次返回的比较值都是随机波动的,彻底破坏了排序算法的传递性假设。经过数万次统计测试可以发现,部分排列出现的频率显著高于其他排列,靠近数组起始位置的元素往往有更大几率停留在原地。 - 时间复杂度不可控:排序算法比较次数并非固定的 \(O(N)\),对于某些乱序输入,比较器可能会被调用 \(O(N \log N)\) 甚至更多次,白白浪费 CPU 算力。
五、安全增强:在敏感场景引入 Web Crypto API
无论是使用 Set 还是 Fisher-Yates 洗牌,底层如果直接依赖 Math.random(),其背后的伪随机数生成器(PRNG,多数现代浏览器采用 xorshift128+ 算法)并非密码学安全。在用户抽奖、发放无序防伪兑换码或安全会话生成等容易受到作弊攻击的场景下,恶意用户可能通过已知序列推算出后续的随机数状态。
在现代浏览器与 Node.js 15+ 环境中,可以使用标准的 crypto.getRandomValues() 替换 Math.random(),为 Fisher-Yates 提供密码学安全的真随机源:
/**
 * 密码学安全的无偏随机整数生成函数
 * @param {number} maxExclusive 最大值上限 (不包含)
 */
function getSecureRandomInt(maxExclusive) {
  const randomBuffer = new Uint32Array(1);
  const maxUint32 = 0xFFFFFFFF;
  const limit = maxUint32 - (maxUint32 % maxExclusive);

  let rand;
  do {
    crypto.getRandomValues(randomBuffer);
    rand = randomBuffer[0];
  } while (rand >= limit); // 拒绝采样,彻底消除模偏差 (Modulo Bias)

  return rand % maxExclusive;
}

/**
 * 密码学安全级别的 Fisher-Yates 洗牌
 */
function cryptoShuffleArray(array) {
  for (let i = array.length - 1; i > 0; i--) {
    const j = getSecureRandomInt(i + 1);
    [array[i], array[j]] = [array[j], array[i]];
  }
  return array;
}
六、不同实现方案对比与选型决策指南
为了帮助开发者根据业务边界快速做出正确的设计选型,下表将本文介绍的四种主要实现途径的关键指标进行了横向综合归纳:
| 实现方案 | 时间复杂度 | 空间复杂度 | 随机分布均匀性 | 碰撞死循环风险 | 最适业务场景 |
|---|---|---|---|---|---|
| 全量 Fisher-Yates 洗牌 | \(O(N)\) | \(O(1)\) (就地) | 严格等概率 | 无 | 全量打乱(棋牌发牌、整套试卷题序乱序、问卷选项乱序) |
| Partial 局部洗牌 | \(O(K)\) | \(O(1) \sim O(N)\) | 严格等概率 | 无 | 从固定规模数据池中抽取固定 \(K\) 个互不重复项(常规抽奖) |
| Set 循环查重法 | 平均 \(O(K)\) / 最坏 \(O(\infty)\) | \(O(K)\) | 等概率 | 高(当 \(K pprox N\) 时) | 抽样量占总池比例极低且池极大的轻量快速场景(\(K \ll N\)) |
| sort(() => Math.random() - 0.5) | \(O(N \log N)\) | \(O(1)\) | 严重偏差倾斜 | 无 | 存在统计缺陷,仅供非严肃个人草稿原型,生产环境禁止 |
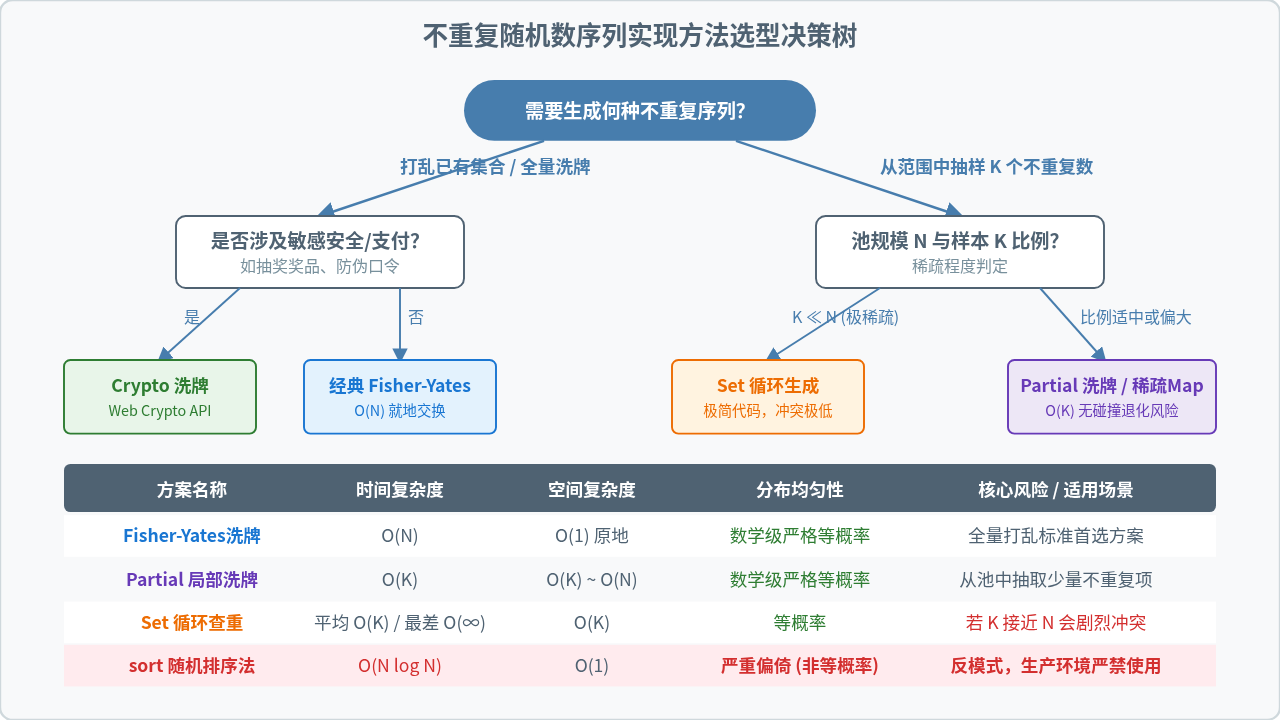
七、总结与最佳实践建议
在 JavaScript 中生成不重复随机数序列时,并不存在单一万能的银弹,但掌握以下准则能够保障程序的高效与稳健:
- 优先选择 Fisher-Yates 算法:不论是完整洗牌还是抽取子集,Fisher-Yates 提供了确定的 \(O(N)\) 或 \(O(K)\) 运行时间保障,算法执行路径不依赖运气,从根本上消除了
while查重死循环的隐患。 - 严禁在生产中使用
sort随机排序:即便代码再简短,也不能以牺牲分布均匀性为代价。 - 根据安全等级切换随机源:常规界面交互与动效使用
Math.random()即可满足性能要求;涉及资产、敏感验证码或竞技公平性时,应始终使用crypto.getRandomValues()作为底层熵源。
JavaScript箭头函数是匿名函数吗?this指向有何不同
2026-11-21 16:07:35
为什么JS sort()对数字排序会出错?正确写法与陷阱解析
2026-11-21 15:37:37
JavaScript对象添加属性的基础语法:点号与方括号的区别
2026-11-21 13:02:57
JavaScript数组高阶函数map、filter与reduce实战用法
2026-11-21 10:58:13
JS数组直接赋值为何修改一个会影响另一个?
2026-11-21 09:59:47







