

JavaScript数组高阶函数map、filter与reduce实战用法
深入解析JavaScript数组三大核心高阶函数map、filter与reduce的实战用法与运行机制,剖析参数传递、浅拷贝引用与初始值陷阱,结合真实业务场景展示链式管道化数据处理。
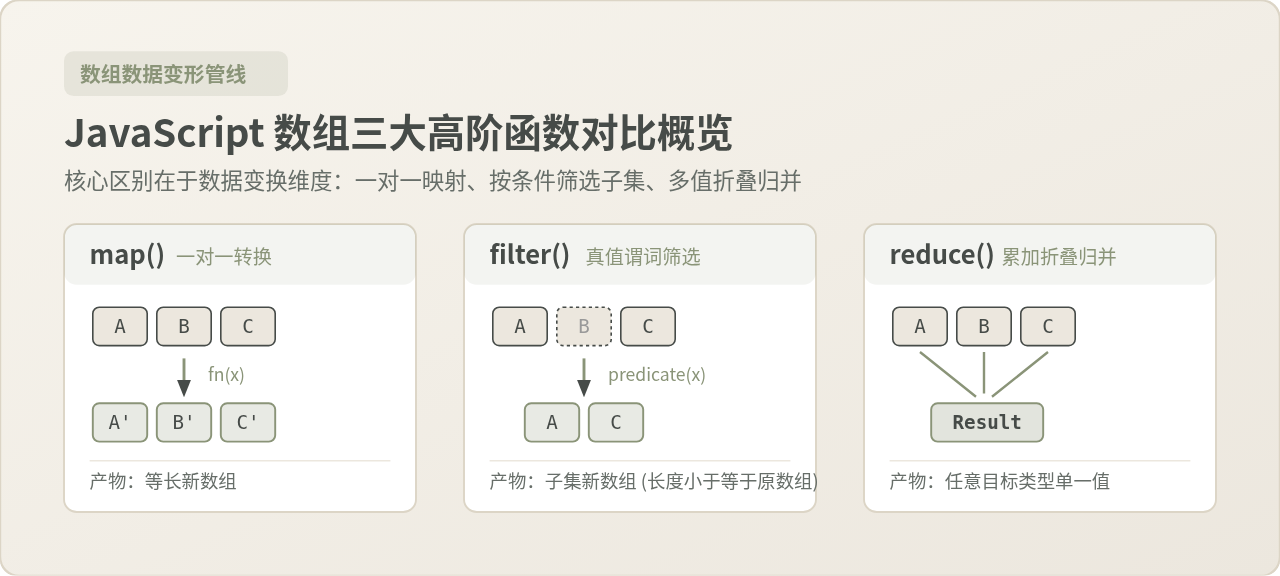
map、filter 与 reduce 是最核心的三个数组高阶函数。map 专注于元素的一对一投影变形,filter 负责按谓词条件挑选子集,而 reduce 则擅长将整个序列折叠归并为单一数值或复合数据结构。掌握这三者的正交分工与配合方式,能够完全取代容易产生越界与变量污染的传统命令式循环,构建出语义直观、结构纯粹的现代化数据处理管线。
一、核心概念与三者的职责边界
高阶函数(Higher-Order Function)是指接受函数作为参数或将函数作为返回值输出的函数。在数组原型链上,map、filter 和 reduce 都属于无破坏性(Non-mutating)的高阶方法:它们在执行时不会修改调用它们的原始数组,而是计算并返回全新的产物。
| 方法名称 | 核心设计职责 | 回调函数预期返回值 | 最终生成产物 |
|---|---|---|---|
map() |
一对一数据结构转换 | 当前索引计算后的新值 | 长度与原数组完全相等的新数组 |
filter() |
按条件筛选保留元素 | 真值(Truthy)或假值(Falsy) | 长度小于或等于原数组的子集新数组 |
reduce() |
步进累加与多维折叠 | 下一轮累积所需的累加器(accumulator) | 单一结果(数值、对象、Map 或任意类型) |
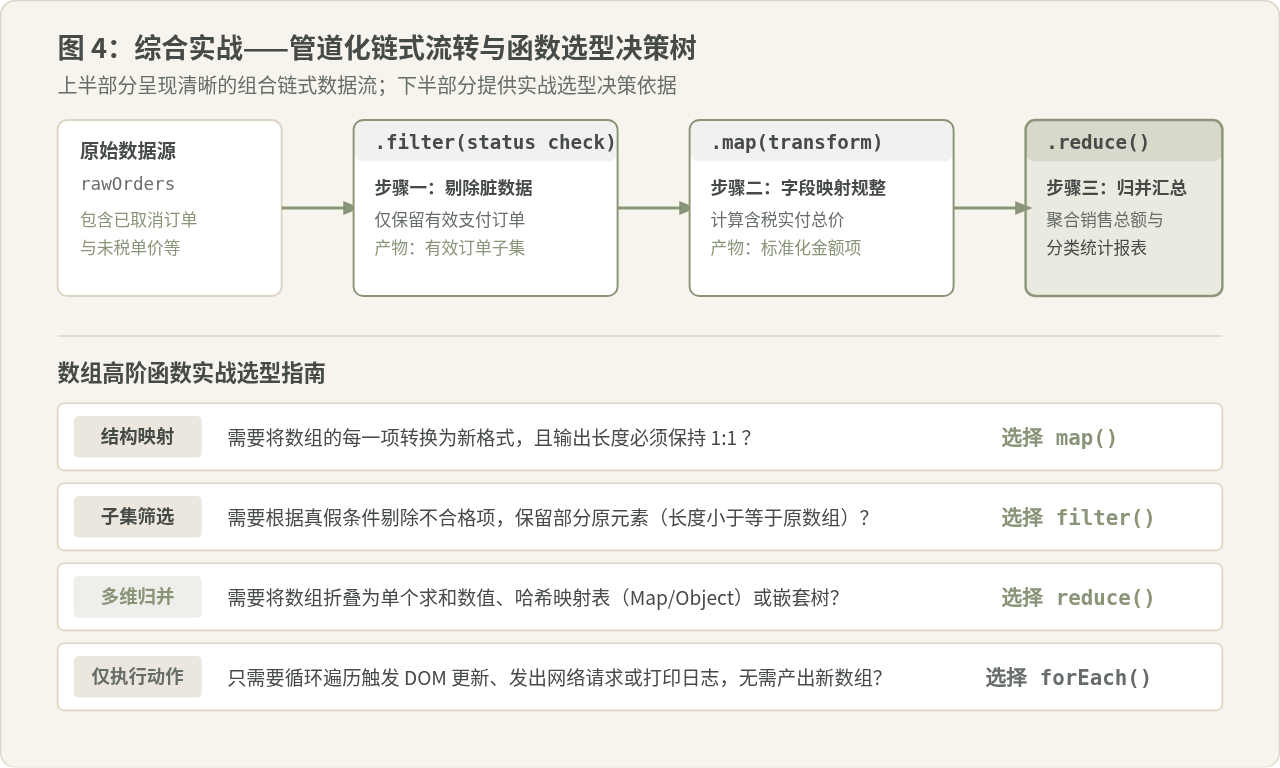
很多初学者在刚接触这三个方法时容易产生混淆,最典型的误区就是“只要想处理数组就全部无脑用 map”。实际上,这三个方法具有严格的职责边界:需要保持数组结构并一对一变形时用 map;需要精简集合元素时用 filter;需要把多项数据聚合成一个总报表、哈希表或嵌套树时用 reduce。
二、map():一对一投影映射与实战要点
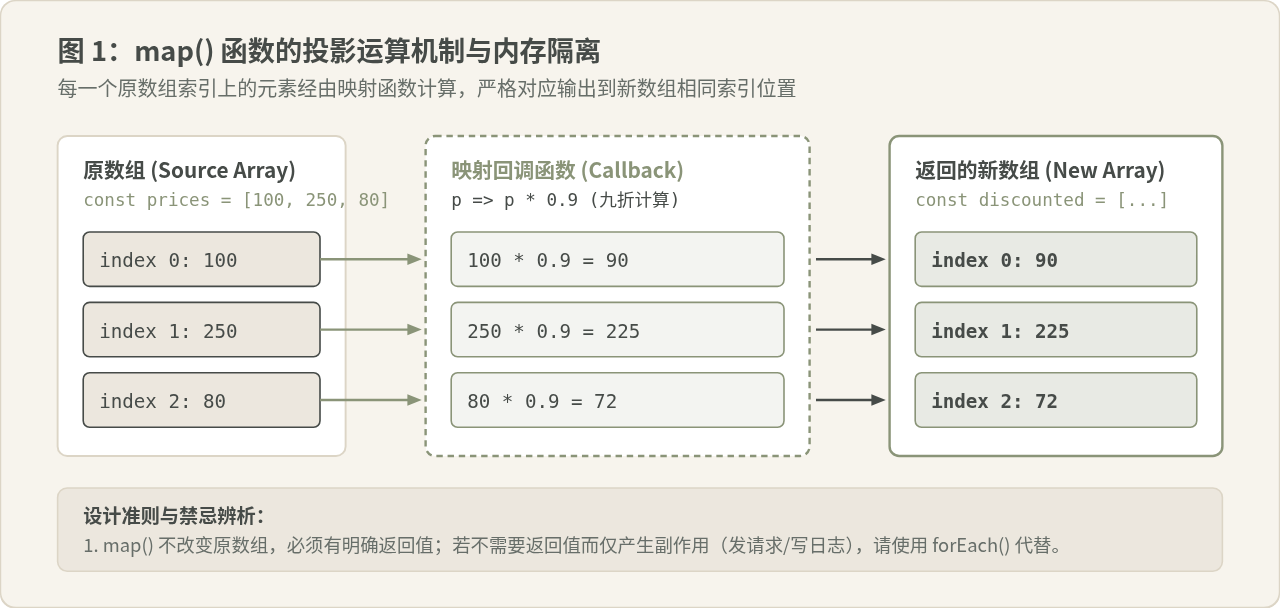
map() 方法为原数组中的每个元素调用一次提供的回调函数,并将每次回调的返回值组合成一个同等长度的新数组。原数组中的原始元素位置与新数组的生成位置严格一一对应。
1. 函数签名与参数规范
const newArray = array.map((currentValue, index, array) => {
  // 必须返回当前元素转换后的新值
  return transformedValue;
}, thisArg);
2. 业务实战示例:商品列表的价格折后规整
假设我们从服务端拉取了一组原始商品数据,前端需要将其格式化为具有统一展示文案、折后售价以及唯一键的渲染模型:
const rawProducts = [
  { id: "p101", name: "无线机械键盘", price: 399 },
  { id: "p102", name: "双模人体工学鼠标", price: 189 },
  { id: "p103", name: "4K高清拓展坞", price: 249 }
];

// 使用 map 生成视图专用数据
const displayList = rawProducts.map(product => {
  const discountedPrice = Math.round(product.price * 0.85);
  return {
    key: product.id,
    title: product.name,
    originalPrice: `¥${product.price}`,
    finalPrice: `¥${discountedPrice}`,
    isDiscounted: true
  };
});

// 示例输出结果:
// [
//   { key: 'p101', title: '无线机械键盘', originalPrice: '¥399', finalPrice: '¥339', isDiscounted: true },
//   { key: 'p102', title: '双模人体工学鼠标', originalPrice: '¥189', finalPrice: '¥161', isDiscounted: true },
//   { key: 'p103', title: '4K高清拓展坞', originalPrice: '¥249', finalPrice: '¥212', isDiscounted: true }
// ]
3. 常见认知偏差与经典陷阱
有人常写出形如 users.map(u => sendNotification(u)) 的代码,且根本不接收 map 返回的新数组。这种做法虽然可以运行,但违背了函数式编程中“无副作用投影”的初衷,且多分配了一个充满 undefined 的无用数组,造成了不必要的垃圾回收开销。如果目的只是遍历执行网络请求、更新外部状态或打印日志,应当直接使用 forEach()。
这是前端面试与日常开发中极高频出现的现象:
['1', '2', '3'].map(parseInt);
// 实际输出结果:[1, NaN, NaN]原因在于:map 在调用回调函数时传入了三个参数:(currentValue, index, array)。而 parseInt(string, radix) 接受两个参数。于是三次执行实际被解析为:
- 第一轮:
parseInt('1', 0)—— 基数为 0 时默认按十进制解析,返回1; - 第二轮:
parseInt('2', 1)—— 一进制中不可能包含字符 '2',解析失败返回NaN; - 第三轮:
parseInt('3', 2)—— 二进制中只有 0 和 1,无法解析 '3',返回NaN。
修正方案:始终显式声明形参,明确传参行为:['1', '2', '3'].map(num => parseInt(num, 10)) 或直接使用 ['1', '2', '3'].map(Number)。
三、filter():条件筛选与浅引用细节
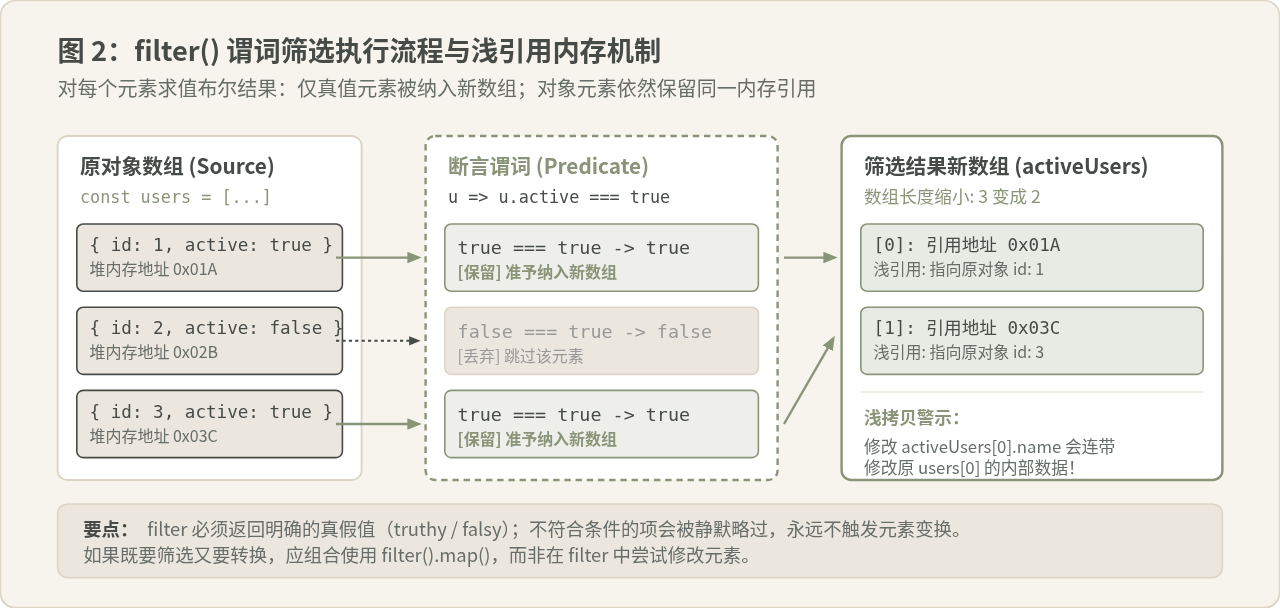
filter() 方法创建一个新数组,其包含通过所提供函数实现的测试的所有元素。若回调函数对某个元素返回真值,则该元素被拷贝到新数组;反之则被丢弃。
1. 函数签名与判定原则
const filteredArray = array.filter((currentValue, index, array) => {
  // 返回 true 或真值保留元素,返回 false 或假值丢弃元素
  return Boolean(condition);
}, thisArg);
2. 业务实战示例:多条件用户权限与状态检索
const userAccounts = [
  { id: 101, username: "alex", role: "admin", status: "active", points: 840 },
  { id: 102, username: "blake", role: "member", status: "banned", points: 120 },
  { id: 103, username: "casey", role: "member", status: "active", points: 350 },
  { id: 104, username: "dana", role: "guest", status: "active", points: 40 }
];

// 筛选出正常活跃且积分在 100 分以上的正式成员
const qualifiedUsers = userAccounts.filter(user => {
  const isActive = user.status === "active";
  const isMemberOrAbove = user.role === "admin" || user.role === "member";
  const hasEnoughPoints = user.points >= 100;
  return isActive && isMemberOrAbove && hasEnoughPoints;
});

// 示例输出结果:
// [
//   { id: 101, username: 'alex', role: 'admin', status: 'active', points: 840 },
//   { id: 103, username: 'casey', role: 'member', status: 'active', points: 350 }
// ]
3. 浅引用机制与潜在副作用辨析
虽然 filter() 会返回一个全新的数组实例(qualifiedUsers !== userAccounts 为 true),但如果数组内部存放的是对象、数组等复合引用类型,新数组中存放的仅仅是原对象的引用地址(浅拷贝)。
// 危险操作:修改了筛选结果中的对象内部属性
qualifiedUsers[0].points = 999;

// 验证原数组:
console.log(userAccounts[0].points); // 输出 999!原数组数据被连带篡改!
如果业务要求在筛选后修改数据且绝不能污染原数据,必须配合对象深拷贝或在后续 map 阶段解构克隆:filter(...).map(item => ({ ...item }))。
四、reduce():累加折叠与多维数据塑形
reduce() 是 JavaScript 数组中最强大、最灵活的高阶函数。它将数组中的每个元素逐次代入执行一个累积器函数,并将其结果汇总为单个返回值。
1. 函数签名与累积器参数
const result = array.reduce((accumulator, currentValue, currentIndex, array) => {
  // 必须返回更新后的 accumulator
  return nextAccumulator;
}, initialValue);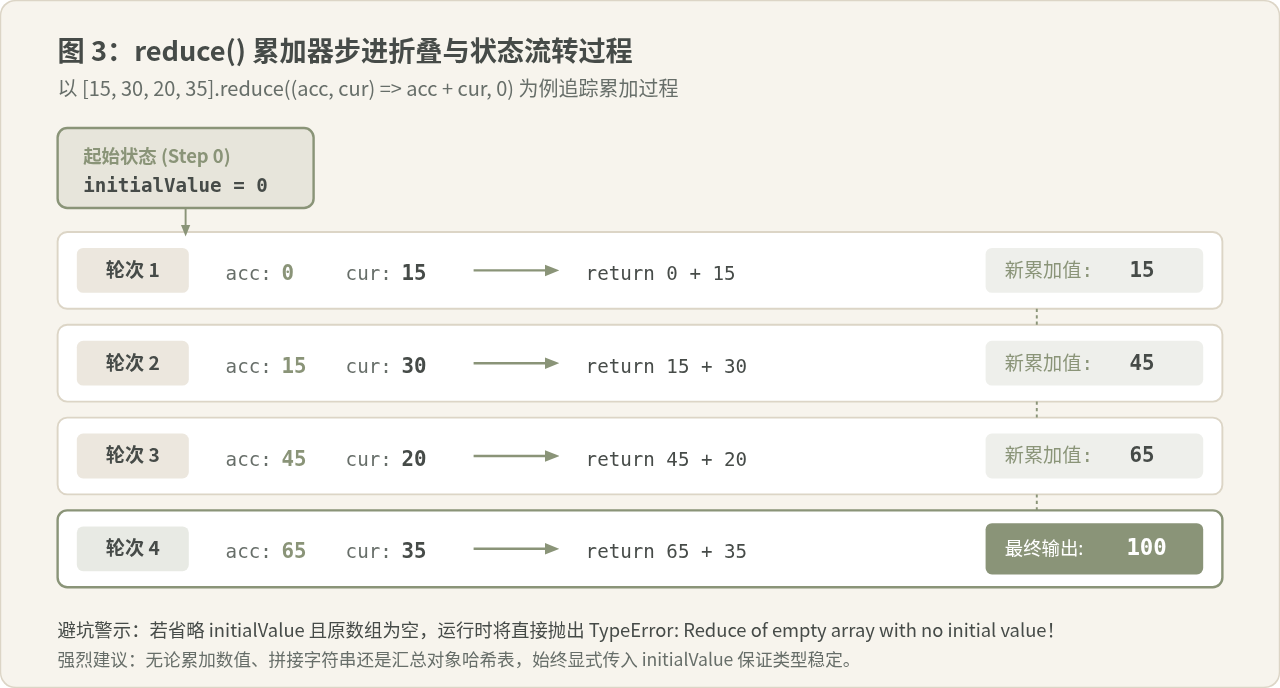
2. 实战场景一:数值累加与总额统计
const cartItems = [
  { name: "机械轴体", price: 1.5, quantity: 70 },
  { name: "定制键帽", price: 168, quantity: 1 },
  { name: "拔键器", price: 12, quantity: 2 }
];

// 计算购物车总金额
const totalCost = cartItems.reduce((acc, item) => {
  return acc + (item.price * item.quantity);
}, 0); // 显式初始值设为 0

// 示例输出结果:297
3. 实战场景二:按属性分组聚合(GroupBy)与哈希映射
在日常业务开发中,将扁平的记录列表转换为按类别、部门或日期归类的字典结构,是 reduce 最具生产力的用法:
const employees = [
  { id: 1, name: "张三", department: "技术研发部" },
  { id: 2, name: "李四", department: "产品运营部" },
  { id: 3, name: "王五", department: "技术研发部" },
  { id: 4, name: "赵六", department: "市场营销部" }
];

// 归并为按部门划分的组织架构字典
const deptGroups = employees.reduce((groups, emp) => {
  const dept = emp.department;
  if (!groups[dept]) {
    groups[dept] = [];
  }
  groups[dept].push(emp);
  return groups;
}, {}); // 初始值为空对象

// 示例输出结构:
// {
//   '技术研发部': [ { id: 1, name: '张三' }, { id: 3, name: '王五' } ],
//   '产品运营部': [ { id: 2, name: '李四' } ],
//   '市场营销部': [ { id: 4, name: '赵六' } ]
// }
4. 致命陷阱:不传 initialValue 的隐式边界危害
ECMAScript 规范规定:若未指定 initialValue,reduce 会将数组的第一个元素直接作为 accumulator 的初始值,并从第二个元素(索引 1)开始执行回调。这会引发严重隐患:
- 空数组运行时报错:调用
[].reduce((acc, cur) => acc + cur)会直接抛出不可恢复的TypeError: Reduce of empty array with no initial value。若传入0,则安全返回0。 - 对象累加产生字符串拼接错误:对形如
[{price: 10}, {price: 20}]的数组求和时,如果不传初始值,第一轮的acc是对象{price: 10},与数字相加会导致隐式转换产生"[object Object]20"的灾难性 Bug。
工程规范结论:在任何使用 reduce 的场景中,务必始终显式声明 initialValue。
五、综合实战:构建链式数据转换管线
高阶函数最迷人的特质在于其可组合性。在复杂业务流程中,我们可以将数据处理分解为独立、单一职责的步骤,通过链式调用(Chaining)像组装流水线一样处理数据。
1. 业务场景需求
有一批原始线上订单流水,我们需要:
- 筛选(filter):剔除状态为
cancelled(已取消)的无效订单; - 变换(map):计算出每一笔订单的实付金额(包含 6% 增值税与折扣扣减);
- 聚合(reduce):按支付渠道(如微信、支付宝、银联)汇总累计流水与成交笔数。
const orderStream = [
  { orderId: "ORD-001", channel: "WeChat", amount: 200, discount: 20, status: "completed" },
  { orderId: "ORD-002", channel: "Alipay", amount: 500, discount: 50, status: "cancelled" },
  { orderId: "ORD-003", channel: "WeChat", amount: 350, discount: 0,  status: "completed" },
  { orderId: "ORD-004", channel: "UnionPay", amount: 1000, discount: 100, status: "completed" },
  { orderId: "ORD-005", channel: "Alipay", amount: 150, discount: 10, status: "completed" }
];

// 链式处理流水线
const channelReport = orderStream
  // 步骤 1:过滤掉已取消订单
  .filter(order => order.status === "completed")
  // 步骤 2:投影转换,计算税后实付总额
  .map(order => {
    const baseAmount = order.amount - order.discount;
    const taxIncluded = Math.round(baseAmount * 1.06);
    return {
      channel: order.channel,
      paidAmount: taxIncluded
    };
  })
  // 步骤 3:按渠道归并统计报表
  .reduce((summary, cur) => {
    const { channel, paidAmount } = cur;
    if (!summary[channel]) {
      summary[channel] = { totalRevenue: 0, orderCount: 0 };
    }
    summary[channel].totalRevenue += paidAmount;
    summary[channel].orderCount += 1;
    return summary;
  }, {});

// 示例输出结果:
// {
//   WeChat: { totalRevenue: 562, orderCount: 2 },
//   UnionPay: { totalRevenue: 954, orderCount: 1 },
//   Alipay: { totalRevenue: 148, orderCount: 1 }
// }
六、性能考量与工程决策指南
虽然链式高阶函数语法优雅且维护性高,但在高频执行与海量数据场景下,仍需理性评估执行特性:
1. 链式多次遍历 vs 单次循环归并
在上面的链式示例中,.filter().map().reduce() 实际上对数组进行了三次线性扫描(即创建了两个中间临时数组)。理论上,这一切完全可以在一个单独的 reduce 或经典 for 循环中通过一次遍历完成。
- 普通业务量级(小于 10,000 条):现代 V8 引擎对内建数组高阶函数进行了极深度的 JIT 内联与逃逸分析优化,临时数组的分配消耗在微秒级别,几乎无法感知。此时,代码的可读性、职责解耦与可测试性远比微观性能重要。
- 极大规模数据(数十万条以上或高频帧渲染):多次创建中间数组会加重垃圾回收(GC)的停顿压力。此时建议合并为一个单次遍历的
reduce,或回归传统的for...of循环,避免内存抖动。
2. 最佳实践总结准则
- 保持纯函数特性:传递给
map和filter的回调函数应当只依赖输入参数,避免在回调内部修改外部作用域变量。 - 防御性返回:在
filter中避免返回非布尔类型的不确定真值(如0或""会被视作 false);在reduce中每一条分支都必须明确return accumulator。 - 显式初始值约定:在团队编码规范中建立准则:任何
reduce调用都必须显式传入第二个参数initialValue,杜绝空数组抛出运行时崩溃的隐患。
JS数组直接赋值为何修改一个会影响另一个?
2026-11-21 09:59:47
JS关键字、保留字和标识符有什么区别
2026-11-21 09:34:44
JS new关键字底层原理:实例化对象时发生了什么
2026-11-21 08:45:20
区分JS语法错误与被拦截:通过Network和Console面板定位
2026-11-20 23:30:37
JavaScript为什么被称为脚本语言
2026-11-20 21:37:57







