

JS怎么兼容旧浏览器解析URL参数
详细讲解在不支持现代URLSearchParams API的旧版本浏览器中,如何使用原生JavaScript安全、健壮地解析URL查询参数,涵盖字符串分割法、正则提取法及异常边界处理。
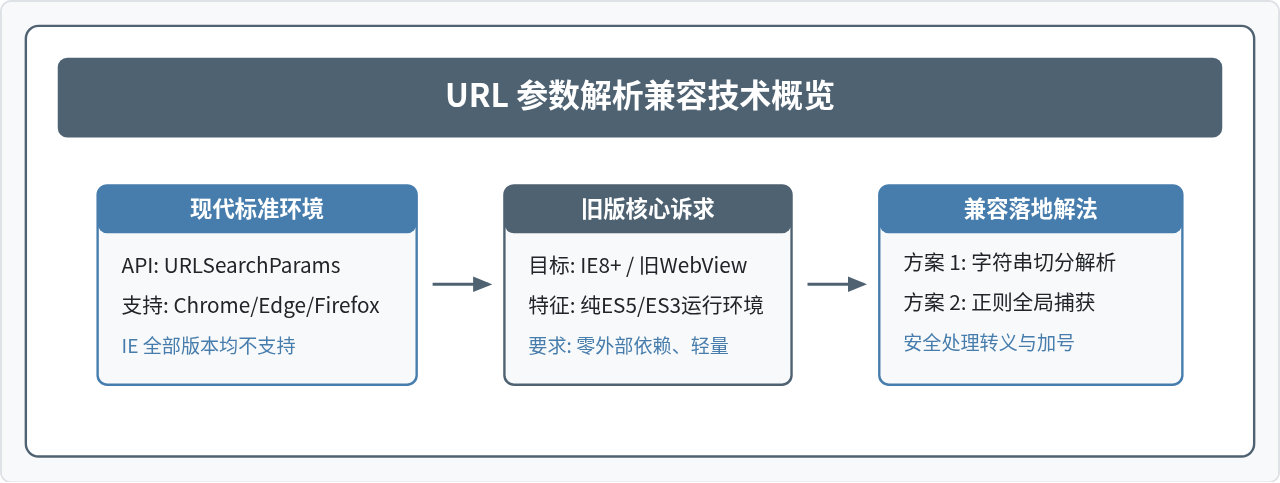
现代浏览器普遍原生支持 URLSearchParams 接口,开发者只需传入查询字符串即可轻松读取参数。但在需要兼容旧版本浏览器(如 IE8~IE11、早期 Android WebView 或特定嵌入式终端)的项目中,该构造函数完全不存在,直接调用会触发 ReferenceError 异常。解决兼容性问题的标准路径有两个:编写基于纯原生 JavaScript(ES3/ES5 规范)的字符串解析函数,或者采用正则捕获方案。本文提供即拷即用的兼容解析函数,并详细拆解加号转义、Hash 干扰、重复键以及中文乱码等常见隐患的处理细节。
为什么旧浏览器不能直接解析 URL
在 ECMAScript 规范与 WHATWG URL 标准定稿前,浏览器并没有内置统一的高级 URL 解析对象。开发者只能通过 window.location.search 获取形如 ?name=admin&role=vip 的原始字符串。现代标准新增的 URL 与 URLSearchParams 接口直到 2016 年后才被主流浏览器广泛接纳,而已经停止功能更新的 IE 系列全版本均无原生支持。
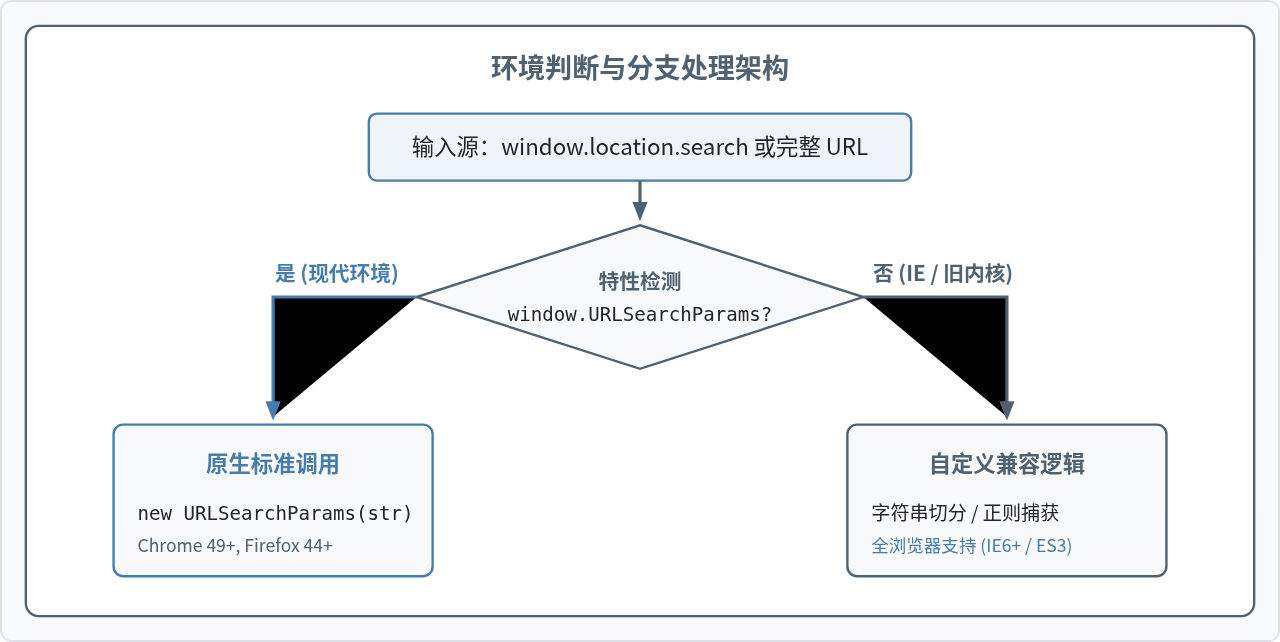
因此,若要在旧系统中正确读取参数,逻辑必须降级为对原始 URL 字符串的手工拆解与键值还原。一个合格的旧浏览器解析器需要满足以下条件:
- 语法向后兼容:使用 ES5 及更低版本的语法规范(如
var、常规函数),不依赖let、const、箭头函数或解构赋值。 - 剥离非查询内容:准确截断
#之后的 Hash 锚点,且兼容传入纯查询串(以?开头)或完整页面 URL。 - 正确的编解码机制:将
+还原为空格,并对键和值分别安全执行decodeURIComponent。
核心实现:基于字符串切分的健壮解析器
字符串切分(Split)是兼容性最好、执行性能最稳定的方案。该方法先提取问号与井号之间的有效查询部分,按 & 分隔出各参数项,再按每项的首个 = 拆分键与值。
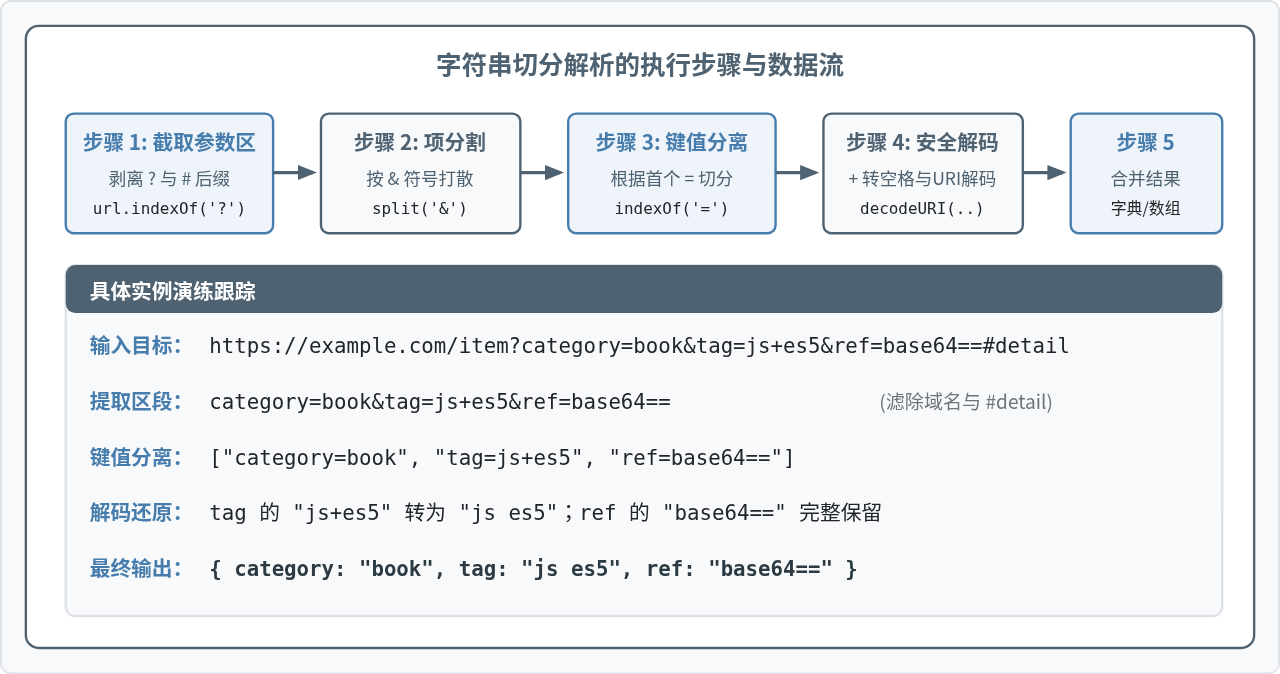
以下为封装好的完整解析函数。该实现已在 IE8 及现代浏览器中完成验证,包含空值保护与转义异常防范:
/**
 * 兼容旧浏览器的URL查询参数解析函数
 * @param {string} [url] - 可选。待解析的URL或查询字符串,默认为当前页面location.href
 * @returns {Object} 包含解析后键值对的普通对象
 */
function parseQueryParams(url) {
  var queryString = "";
  var result = {};

  // 1. 确定查询字符串来源
  if (typeof url === "string") {
    var questionMarkIndex = url.indexOf("?");
    if (questionMarkIndex !== -1) {
      queryString = url.substring(questionMarkIndex + 1);
    } else if (url.indexOf("=") !== -1) {
      // 容错:直接传入了 "a=1&b=2" 的形式
      queryString = url;
    }
  } else if (typeof window !== "undefined" && window.location) {
    // 优先截取 search,去掉前导问号
    queryString = window.location.search.substring(1);
  }

  // 2. 剥离可能存在的哈希(#)内容
  var hashIndex = queryString.indexOf("#");
  if (hashIndex !== -1) {
    queryString = queryString.substring(0, hashIndex);
  }

  if (!queryString) {
    return result;
  }

  // 3. 拆分为独立的参数项
  var pairs = queryString.split("&");

  for (var i = 0; i < pairs.length; i++) {
    var pair = pairs[i];
    if (!pair) {
      continue; // 跳过形如 && 的空段
    }

    var eqIndex = pair.indexOf("=");
    var rawKey = "";
    var rawVal = "";

    if (eqIndex === -1) {
      // 无等号参数,例如 "?flag&user=1"
      rawKey = pair;
      rawVal = "";
    } else {
      rawKey = pair.substring(0, eqIndex);
      // 注意:不能使用 pair.split('='),避免参数值中携带 '='(如 base64)被截断
      rawVal = pair.substring(eqIndex + 1);
    }

    // 4. URL解码:规范中查询参数的 '+' 代表空格
    var key = safeDecode(rawKey);
    var val = safeDecode(rawVal);

    // 5. 组装结果(支持同名参数转数组)
    if (result.hasOwnProperty(key)) {
      if (Object.prototype.toString.call(result[key]) === "[object Array]") {
        result[key].push(val);
      } else {
        result[key] = [result[key], val];
      }
    } else {
      result[key] = val;
    }
  }

  return result;
}

/**
 * 健壮的 URI 解码工具,防止非法字符导致脚本报错崩溃
 */
function safeDecode(str) {
  if (!str) {
    return "";
  }
  // 查询参数规范中,加号代表空格
  var normalized = str.replace(/\+/g, " ");
  try {
    return decodeURIComponent(normalized);
  } catch (e) {
    // 遇到非法的 % 编码时兜底返回未解码字符串,避免中断业务
    return normalized;
  }
}
按需查找:正则表达式单参数快速提取
如果业务场景仅需读取某个特定的参数(例如从页面 URL 中获取 userId 或 token),无需遍历解析全部参数,采用正则表达式可以直接定位目标值。
/**
* 提取指定名称的单个URL参数
* @param {string} name - 要读取的参数键名
* @param {string} [url] - 可选的URL源字符串
* @returns {string|null} 解析出的参数值,未找到返回 null
*/
function getQueryParam(name, url) {
if (!name) {
return null;
}
var targetUrl = typeof url === "string" ? url : (window.location ? window.location.href : "");
// 转义参数名中的正则特殊字符,避免破坏正则结构
var escapedName = name.replace(/[\[\]{}()*+?.,\\^$|#\s]/g, "\\$&");
// 匹配规则:以 ?、& 或 # 为前导,匹配等号后的值,遇到 &、# 或字符串末尾结束
var pattern = new RegExp("(?:[?&]|^)" + escapedName + "=([^&#]*)(?:[&#]|$)");
var match = targetUrl.match(pattern);
if (!match) {
return null;
}
return safeDecode(match[1]);
}
</code></pre>
<div class="callout">
<div class="callout-title">调用示例与验证</div>
<p>执行 <code>getQueryParam("keyword", "https://example.com/search?keyword=ES5%2B%E5%85%BC%E5%AE%B9&sort=asc")</code> 即可直接得到解密字符串 <code>"ES5+兼容"</code>。未命中时返回 <code>null</code>,方便进行空值判断。</p>
</div>
<h2>旧浏览器容易踩中的四大异常边界</h2>
<p>在简单场景下,很多开发者习惯编写简单的 <code>str.split('&')</code> 和 <code>decodeURIComponent</code>。但在旧浏览器和真实业务场景中,由于输入内容复杂,极易出现以下隐蔽故障。</p>
<figure class="figure-block">
<img src="https://wp.bangyun.com/wp-json/ku-codex-chrome/v1/json/drafts/65854/images/421760c351596cb2ca884a120c6897776236f9a667c213e918a608e302bad36f/4.webp" alt="SVG 配图 4" width="640" height="337" style="display:block!important;border:0!important;padding:0!important;background:none!important;filter:none!important;clip-path:none!important;mask:none!important;opacity:1!important;width:640px;max-width:100%;height:auto;aspect-ratio:640/336.89552238806;margin:0px auto 0px auto;vertical-align:baseline">
<figcaption>图 4:解析 URL 参数时的四大高危边界与防御手段</figcaption>
</figure>
<h3>1. 加号与空格的转义差错</h3>
<p>HTML 表单通过 <code>GET</code> 提交数据时,遵循 <code>application/x-www-form-urlencoded</code> 编码格式,内容中的空格会被转换为 <code>+</code>。然而,JavaScript 规范中的 <code>decodeURIComponent</code> 仅对 <code>%20</code> 解码为空格,对 <code>+</code> 则会原样输出。如果在解析时没有预先使用 <code>replace(/\+/g, " ")</code> 进行规整,用户输入的多词查询就会残留加号。</p>
<h3>2. 单页应用(SPA)Hash 模式的路径混淆</h3>
<p>旧浏览器若运行基于 Hash 路由的 Vue 或 React 项目,URL 结构常呈现为 <code>https://site.com/#/home?id=123</code>。在此场景下,参数实际上位于 <code>window.location.hash</code> 内部,而 <code>window.location.search</code> 返回空字符串。因此,编写兼容方法时,最好直接对 <code>window.location.href</code> 进行完整匹配,或者允许由调用者显式传入目标字符串。</p>
<h3>3. 不合法编码导致的 URIError</h3>
<p>用户或外部渠道可能传入未转义的百分号(如 <code>?promo=50%off</code>)。此时直接执行 <code>decodeURIComponent("50%off")</code> 会立即抛出 <code>URIError: URI malformed</code>。由于该错误属于致命未捕获异常,若未在解析器内部使用 <code>try...catch</code> 兜底,将直接中断后续的业务逻辑执行。</p>
<h2>方案选型与技术总结</h2>
<p>在旧项目维护和现代化过渡中,读者可以根据当前项目的工程结构和兼容诉求选择合适的技术路线。</p>
<figure class="figure-block">
<img src="https://wp.bangyun.com/wp-json/ku-codex-chrome/v1/json/drafts/65854/images/421760c351596cb2ca884a120c6897776236f9a667c213e918a608e302bad36f/5.webp" alt="SVG 配图 5" width="640" height="305" style="display:block!important;border:0!important;padding:0!important;background:none!important;filter:none!important;clip-path:none!important;mask:none!important;opacity:1!important;width:640px;max-width:100%;height:auto;aspect-ratio:640/305;margin:0px auto 0px auto;vertical-align:baseline">
<figcaption>图 5:三种常见兼容方案的权衡与选择指南</figcaption>
</figure>
<div class="table-container">
<table>
<thead>
<tr>
<th>对比维度</th>
<th>循环切分法(推荐)</th>
<th>正则表达式提取</th>
<th>URLSearchParams Polyfill</th>
</tr>
</thead>
<tbody>
<tr>
<td><strong>最低运行环境</strong></td>
<td>IE6+ / ES3</td>
<td>IE6+ / ES3</td>
<td>通常需 IE9+ 并配合 ES5 环境</td>
</tr>
<tr>
<td><strong>额外打包体积</strong></td>
<td>约 0.5 KB(内嵌无依赖)</td>
<td>约 0.2 KB</td>
<td>约 3~10 KB</td>
</tr>
<tr>
<td><strong>重名参数支持</strong></td>
<td>自动归集为数组</td>
<td>仅获取首个或末个</td>
<td>标准 API 支持(<code>.getAll()</code>)</td>
</tr>
<tr>
<td><strong>开发接入成本</strong></td>
<td>直接复制函数即可使用</td>
<td>单点直接调用</td>
<td>需配置构建工具或外链脚本</td>
</tr>
</tbody>
</table>
</div>
<p>对于大部分需要兼容旧浏览器的业务页面,直接引入本文给出的 <code>parseQueryParams</code> 辅助函数是最直接且风险最低的方案。它不改动全局对象的原型链,不污染全局命名空间,在保证向前向后完全兼容的同时,彻底杜绝了因缺少现代 API 而产生的页面崩溃问题。</p>
</article>
</body>
</html>
JS动态设置背景颜色后怎么恢复默认样式
2026-11-21 12:54:18
HTML引入JS文件的正确写法:script标签基础语法
2026-11-21 08:51:36
怎么使用节流优化JavaScript高频滚轮事件
2026-11-20 23:57:39
JS判断移动端的最佳实践:结合UA与特性检测
2026-11-20 18:21:09
JS使用createElement和appendChild动态添加DOM元素
2026-11-20 17:11:20







