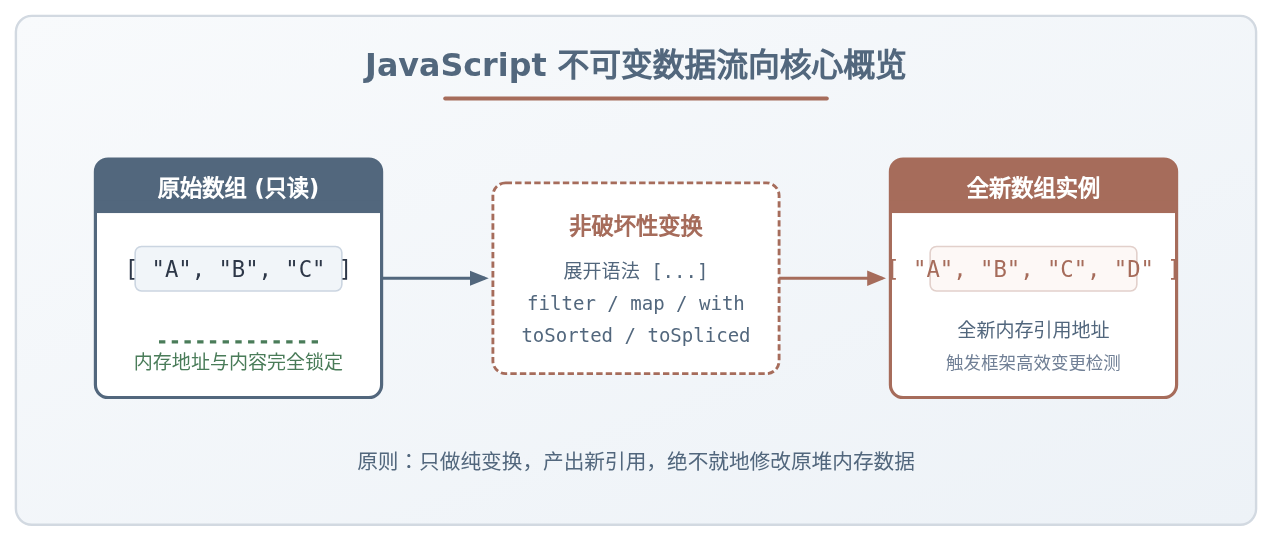
JS数组合并去重:结合Set与展开运算符的实现技巧
详细讲解在 JavaScript 中结合 Set 与展开运算符实现数组合并去重的原理、执行步骤、SameValueZero 判等机制及边界处理技巧。
一、核心语法与执行步骤拆解
在日常前端与 Node.js 开发中,经常需要汇总来自不同接口、用户输入或状态切片的数组,并确保其中的值具有唯一性。直接看这行核心代码:
const arr1 = [1, 2, 3];
const arr2 = [2, 3, 4, 5];

// 核心合并去重写法
const result = [...new Set([...arr1, ...arr2])];

console.log(result);
// 示例输出: [1, 2, 3, 4, 5]
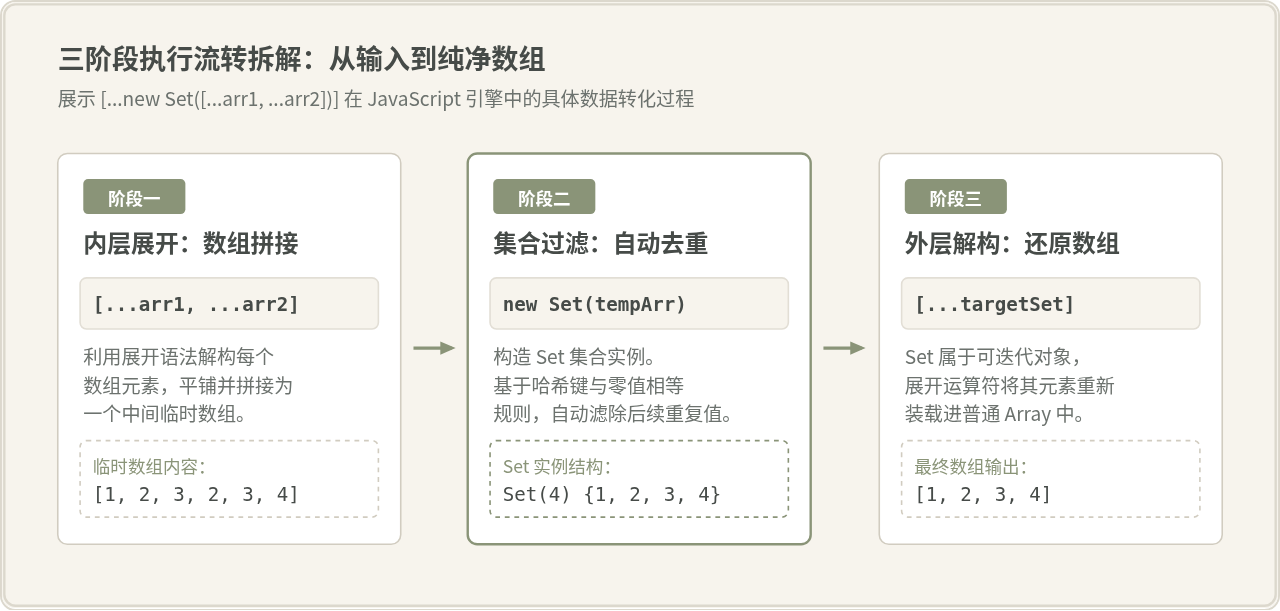
这行看似简单的组合表达式,在 JavaScript 运行环境中实际经历了三个连续的处理步骤:
-
内层展开拼接:
[...arr1, ...arr2]
展开运算符(Spread Operator)将数组arr1与arr2中的各个元素分别取出,放入一个新的临时数组中。此时得到的中间结果是包含重复项的完整平铺数组[1, 2, 3, 2, 3, 4, 5]。与传统的arr1.concat(arr2)相比,展开语法表达更为紧凑,且方便横向追加第三个、第四个数组。 -
实例化 Set 去重:
new Set(...)
ES6 引入的Set是一种类似于数组但成员的值都是唯一的集合数据结构。将合并后的临时数组传给Set构造函数时,集合内部会按顺序迭代每个元素并执行成员检查。若发现集合中已存在相同的值,则忽略该次插入,从而自动完成去重。在此阶段,数据转化为包含 4 个唯一成员的Set实例。 -
外层解构成数组:
[...new Set(...)]
Set实现了可迭代协议(Iterable Protocol)。使用外层方括号与展开运算符包裹该集合后,会重新遍历 Set 提取各个成员,依次放入一个新建的原生 Array 中。此时,数据结构恢复为调用方熟悉的标准数组。
二、底层判等机制与适用边界
了解去重的执行流程之后,需要明确 Set 内部到底依据什么标准判定两个元素是“相同”的。这是决定该方案能否安全应用于当前业务的关键。
1. 判等依据:SameValueZero 规则
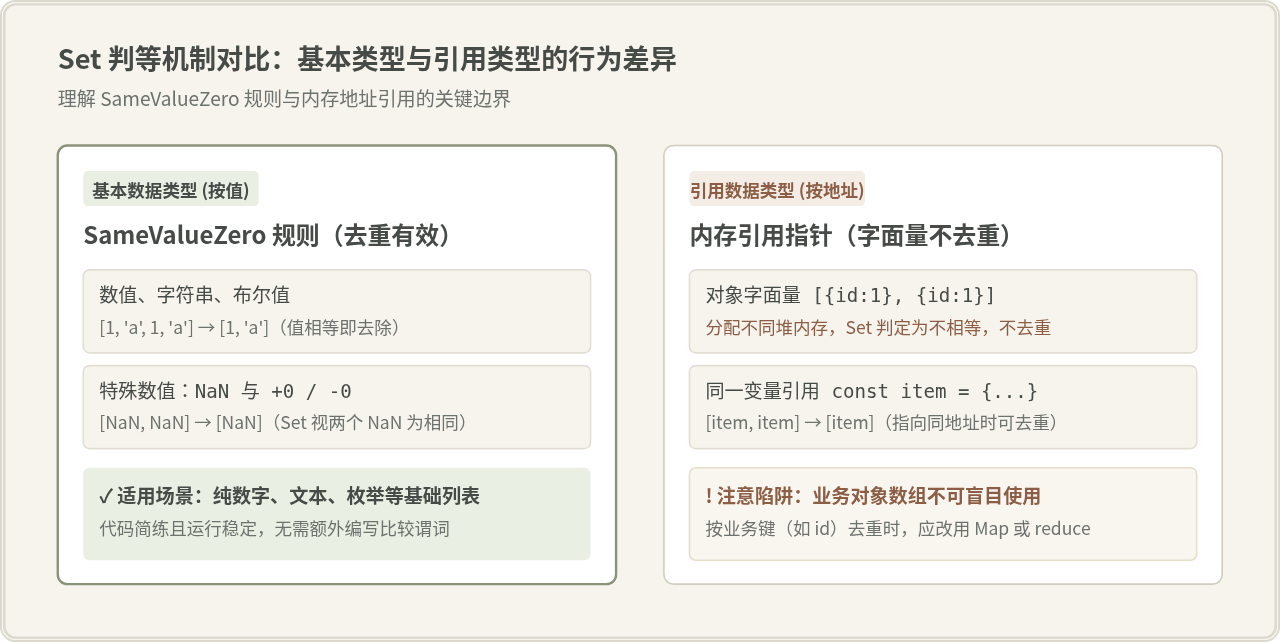
Set 内部进行元素去重时,采用的是 ECMAScript 规范定义的 SameValueZero(零值相等)算法,而不是简单的严格全等运算符 ===。理解该算法需要把握以下两个关键细节:
-
对
NaN的处理:在传统的 JavaScript 全等比较中,NaN === NaN返回false,导致基于indexOf或includes的某些旧版去重函数无法正确合并多个NaN。但在Set的 SameValueZero 规则下,所有NaN被视为相互相等,多次出现的NaN仅会被保留一个。 -
对符号零的处理:正零
+0与负零-0在Set中同样被视作同一个值,去重后统一保留0。 -
基础数据类型全等:字符串、数字、布尔值、Symbol 和 BigInt 均严格按其原始值进行匹配。不同基础类型之间不会发生隐式类型转换(例如数字
1与字符串'1'属于不同值,均会被保留)。
const mixed1 = [1, '1', NaN, +0];
const mixed2 = [1, NaN, -0, '2'];

const dedupedMixed = [...new Set([...mixed1, ...mixed2])];
console.log(dedupedMixed);
// 示例输出: [1, '1', NaN, 0, '2']
2. 常见认知辨析:Set 去重是否对所有数据结构都通用?
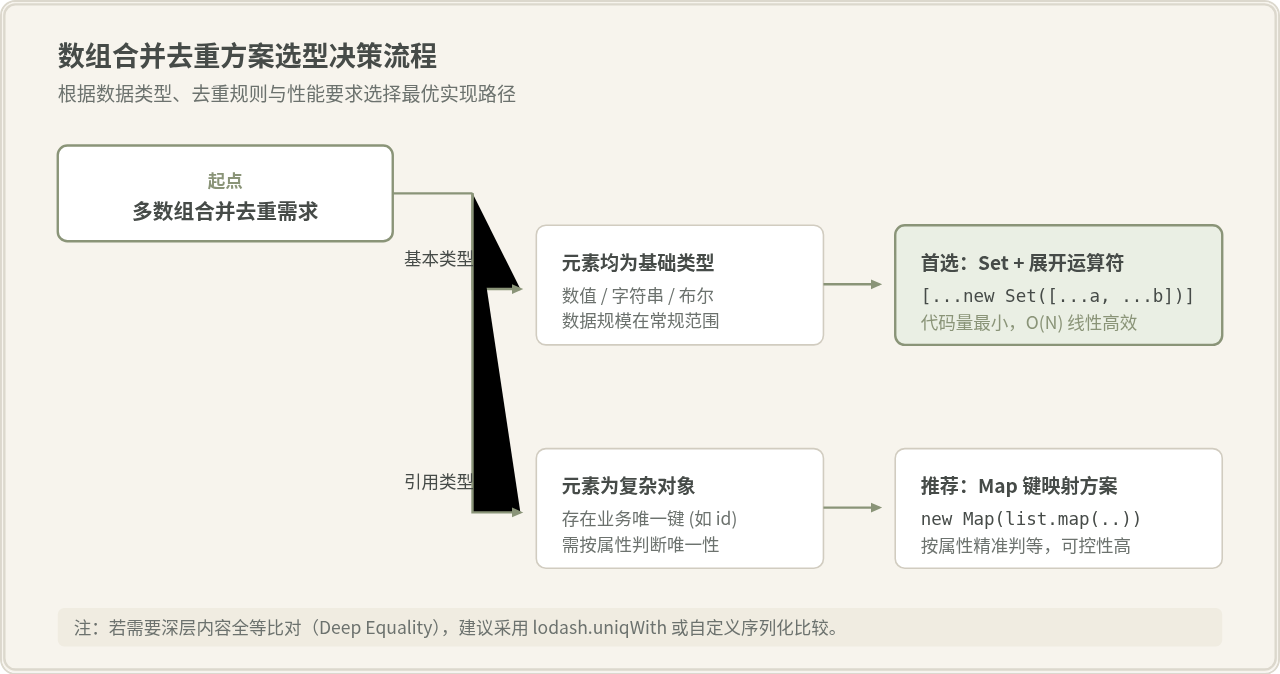
一种容易让人困惑的说法是:“只要用 [...new Set([...a, ...b])],就能解决所有数组合并去重需求”。这种说法看似合理,因为在绝大多数数字、字符串和枚举列表中它的表现极其可靠;但在处理复杂对象数组时,该说法需要立刻得到修正。
原因在于:JavaScript 的引用数据类型(Object、Array、Function 等)在变量中存储的是堆内存中的地址引用,而非对象具体属性值。当数组中存放的是对象字面量时,即使两个对象的属性键值完全一致,它们在内存中依然是两个不同的独立实体。
// 两个结构相同但引用地址不同的对象字面量
const listA = [{ id: 1, name: 'Alice' }];
const listB = [{ id: 1, name: 'Alice' }];

const objResult = [...new Set([...listA, ...listB])];
console.log(objResult.length);
// 示例输出: 2
// 原因:两个对象分配了不同的内存指针,Set 判定为两个不同值,无法自动去重。
只有当两个数组中的元素指向同一个对象引用时,Set 才能将其识别为重复项并完成剔除。
三、多场景扩展与进阶实战技巧
在掌握基础用法的基础上,结合实际项目中的参数形式与数据结构,可以将该模式拓展到更为广泛的应用场景中。
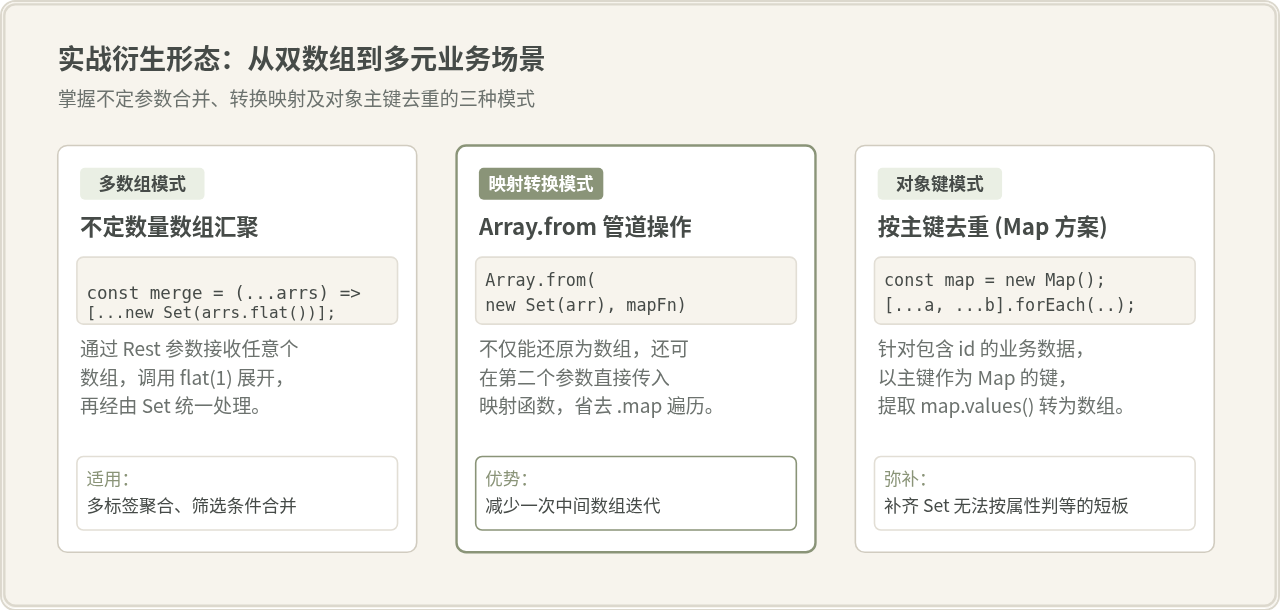
1. 合并任意多个数组的通用函数
如果需要合并的数组数量不固定(例如接收动态参数或数组集合),可以通过 Rest 剩余参数与 flat 扁平化方法封装一个通用合并函数:
/**
 * 合并任意数量的数组并去除重复项
 * @param  {...Array} arrays 待合并的源数组集合
 * @returns {Array} 去重后的全新数组
 */
function mergeAndDedupe(...arrays) {
  return [...new Set(arrays.flat(1))];
}

// 示例调用
const a = ['apple', 'banana'];
const b = ['banana', 'orange'];
const c = ['orange', 'pear', 'apple'];

console.log(mergeAndDedupe(a, b, c));
// 示例输出: ['apple', 'banana', 'orange', 'pear']
2. 使用 Array.from 结合映射步骤
除了使用展开运算符 [...] 还原数组,标准库提供的 Array.from() 同样能够将 Set 转换回数组。更重要的是,Array.from() 支持传入第二个参数作为映射函数(mapFn),允许在去重还原的同时直接转换数据,避免额外书写一次 .map() 带来的二次遍历开销:
const rawScores1 = [10, 20, 30];
const rawScores2 = [20, 30, 40];

// 去重同时将各项乘以 1.1 的增益系数
const adjusted = Array.from(new Set([...rawScores1, ...rawScores2]), x => Math.round(x * 1.1));

console.log(adjusted);
// 示例输出: [11, 22, 33, 44]
3. 业务对象数组按特定键去重的正确解法
正如上一节所分析的,对于包含相同业务主键(例如 id 或 code)的对象数组,单纯依赖 Set 无法生效。此时推荐利用 ES6 的 Map 结构。由于 Map 保证键的唯一性,后插入的重复键会自动覆盖前项(或选择保留首项):
const usersA = [
  { id: 101, name: '张三' },
  { id: 102, name: '李四' }
];
const usersB = [
  { id: 102, name: '李四(新版本)' },
  { id: 103, name: '王五' }
];

// 利用 Map 按照业务属性 id 去重(后出现的项覆盖前项)
const mergedUsers = Array.from(
  new Map([...usersA, ...usersB].map(item => [item.id, item])).values()
);

console.log(mergedUsers);
// 示例输出:
// [
//   { id: 101, name: '张三' },
//   { id: 102, name: '李四(新版本)' },
//   { id: 103, name: '王五' }
// ]
四、性能考量与选型决策
在选择技术方案时,除了语法的优美度,执行开销与内存占用同样是衡量代码质量的核心标准。
1. 复杂度分析:为什么 Set 方案更高效?
在 ES6 之前,常见的数组去重方案往往使用 filter 结合 indexOf 或 includes:
// 传统去重写法(不推荐在大数据量中使用)
const legacyDedupe = arr => arr.filter((item, index) => arr.indexOf(item) === index);
在上述传统写法中,外部 filter 需要遍历 $N$ 次,内部 indexOf 每次查找又需要遍历最多 $N$ 次,导致其整体时间复杂度达到 $O(N^2)$。当数组规模达到上万条时,页面容易出现明显的卡顿甚至假死。
相比之下,[...new Set([...arr1, ...arr2])] 方案的时间复杂度为严格的 $O(N)$:
- 展开运算符合并两个数组:耗时与元素总数 $N$ 成正比,为 $O(N)$;
- 将元素存入
Set:底层基于哈希表实现,每次插入与查重平均耗时仅为 $O(1)$,总耗时为 $O(N)$; - 将
Set展开回数组:遍历集合元素耗时为 $O(N)$。
在空间复杂度方面,由于中间过程构建了临时数组与 Set 实例,内存占用为 $O(N)$。对于绝大多数现代 Web 应用与服务端脚本,这种以极少内存换取线性时间复杂度的做法是非常合理的。
2. 元素保留顺序与稀疏数组注意事项
-
顺序保持:规范规定
Set的遍历顺序与元素的插入顺序完全一致。因此合并后数组将优先保留首次出现的元素相对位置。 -
稀疏数组(Sparse Arrays):如果源数组中包含未赋值的空槽位(例如
[1, , 3]),展开运算符在遍历时会将其读取为undefined,最终会被Set视作单一的undefined成员保留。
| 方案 | 时间复杂度 | 适用场景 | 限制与缺点 |
|---|---|---|---|
| Set + 展开运算符 | $O(N)$ | 基础类型数组合并、快速去重 | 不支持对象属性深度比对;产生中间集合占用 |
| Map 键映射 | $O(N)$ | 对象数组按指定唯一键(如 id)去重 | 需要明确指定标识字段 |
| filter + indexOf | $O(N^2)$ | 旧环境兼容、超小体量数组(十以内) | 数据量稍大即出现性能瓶颈;无法正确处理 NaN |
五、总结
结合 Set 与展开运算符的 [...new Set([...arr1, ...arr2])] 是处理 JavaScript 基础类型数组合并去重的标准惯用手法。它兼备代码简洁度与 $O(N)$ 的高效执行性能。在实际应用时,只需牢记其依托于 SameValueZero 规则运作,对基础数据类型的去重完全自动化;而对于具有业务主键的对象数组,则应顺应数据特征选用 Map 方案,以此写出健壮、清晰且高性能的代码。
JSP与JavaScript语法基础对比:Java与ECMAScript
2026-11-20 17:50:36
JS对象转JSON字符串:JSON.stringify()用法详解
2026-11-20 15:35:12
怎么在JS数组指定位置插入元素?splice方法实战
2026-11-20 14:52:19
JavaScript闭包为何会延长变量生命周期?原理与实战解析
2026-11-20 14:31:25
JSONP实现JS跨域的原理、局限性与现代替代方案
2026-11-20 14:13:28