

JavaScript中escape函数为何不推荐用于中文编码
深入解析JavaScript中escape函数不推荐用于中文编码的核心原因,从%uXXXX非标准格式与RFC 3986标准的冲突、网络传输与服务端解析异常、ECMA规范演进及encodeURI与encodeURIComponent的正确替代选型展开全面剖析。
一、编码机制脱节:%uXXXX 与标准 UTF-8 百分比编码
了解 escape 为何不适用于中文,首先需要审视它对中文字符的具体转换逻辑。在 JavaScript 语言诞生初期(ECMAScript 1 时代),国际化标准尚处于起步阶段,escape 的设计初衷仅是对字符串中的特定字符进行简易转义,以便在早期内部网络协议中流转。
当面对大于 255 的字符(如中文字符“中”,Unicode 码点为 U+4E2D)时,escape 的做法是直接截取其 16 位 UTF-16 码点值,并在前面强行拼接 %u 前缀,得到 %u4E2D。
// 示例 1:escape 与现代编码函数对中文字符的处理对比
const text = '中文';

// 1. escape 生成非标准的 %u 码点序列
const escapedResult = escape(text);
console.log(escapedResult);
// 输出: "%u4E2D%u6587"

// 2. encodeURIComponent 基于 UTF-8 字节序列编码
const componentResult = encodeURIComponent(text);
console.log(componentResult);
// 输出: "%E4%B8%AD%E6%96%87"

// 3. encodeURI 同样基于 UTF-8 字节序列编码
const uriResult = encodeURI(text);
console.log(uriResult);
// 输出: "%E4%B8%AD%E6%96%87"
对比上述代码的输出结果可以发现关键差异:标准编码函数 encodeURIComponent 生成的是 %E4%B8%AD,而 escape 生成的是 %u4E2D。这种差异并不是语法糖或风格不同,而是底层架构的截然不同:
- 字符码点拼接(escape):只将字符的内部编码编号转为十六进制文本,脱离了底层二进制字节流,无法表示可变长度字符集。
- 标准百分比编码(encodeURIComponent / encodeURI):根据 RFC 3986 规范,统一将字符转换为标准的 UTF-8 字节序列(中文在 UTF-8 下通常占用 3 个字节),然后对每个字节分别以
%HH(HH 为该字节的两位十六进制表示)进行转义。字符“中”对应的 UTF-8 三个字节分别为0xE4、0xB8、0xAD,因而被严谨转义为%E4%B8%AD。
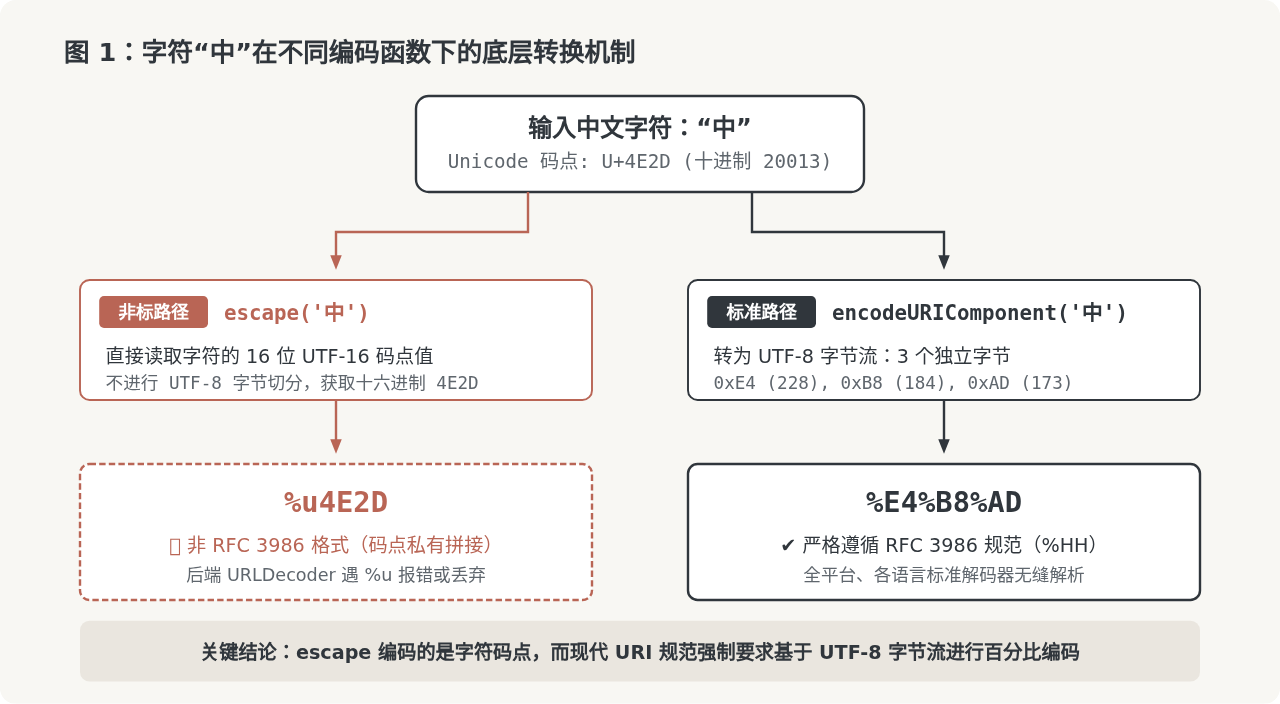
% 后紧跟两位十六进制数组成。%uXXXX 这种使用 u 引导 4 位十六进制数的格式是早期私有扩展,从来不是 IETF 认可的标准百分比编码格式。
二、网络传输与服务端解析的兼容性灾难
在实际 Web 工程中,前端对中文进行编码的主要目的,通常是通过 HTTP GET 请求的 Query 参数、路径段(Path Segment)或表单数据将参数安全地传递给后端服务。如果在客户端使用了 escape,这些带有 %u 的字符串就会进入 HTTP 报文。这一行为会在网关及服务端引发多层次的解析故障。
1. 反向代理与 API 网关层拦截
现代高可用架构中,外部请求首先抵达 Nginx、Envoy、Cloudflare 或各类 API Gateway。根据 HTTP 规范,网关在解析请求 URI 时,会验证百分比编码的合法性。遇到形如 %u4E2D 的字符序列时,解析器扫描到 %,预期读取后续两个十六进制字符(0-9, A-F),但紧随其后的却是字母 u。严格配置的 Web 服务器或网关会直接将此判定为“非法 URI 格式”,向客户端返回 HTTP 400 Bad Request,请求甚至无法触达后端业务应用。
2. 主流语言标准库解码器崩溃
即使请求穿透了网关到达后端业务层,主流编程语言的 URL 解码标准库也均以 RFC 3986 与 UTF-8 为准绳。当后端程序尝试解码 escape 产生的字符串时,会出现以下典型异常:
// Java 服务端环境解析示例
import java.net.URLDecoder;
import java.nio.charset.StandardCharsets;

public class TestDecode {
    public static void main(String[] args) {
        String escapeParam = "%u4E2D%u6587";

        // 尝试使用标准 URLDecoder 解析
        try {
            String result = URLDecoder.decode(escapeParam, StandardCharsets.UTF_8.name());
            System.out.println(result);
        } catch (Exception e) {
            // 抛出异常: java.lang.IllegalArgumentException:
            // URLDecoder: Incomplete trailing escape (%) pattern
            System.err.println("解析失败: " + e.getMessage());
        }
    }
}
在 Node.js 中调用原生 decodeURIComponent('%u4E2D%u6587') 时,系统将立即抛出 URIError: URI malformed;在 Python 中执行 urllib.parse.unquote('%u4E2D%u6587'),解析器无法识别 %u,会将其原样跳过并返回未解析的无意义字符串,导致数据库查询条件匹配落空。
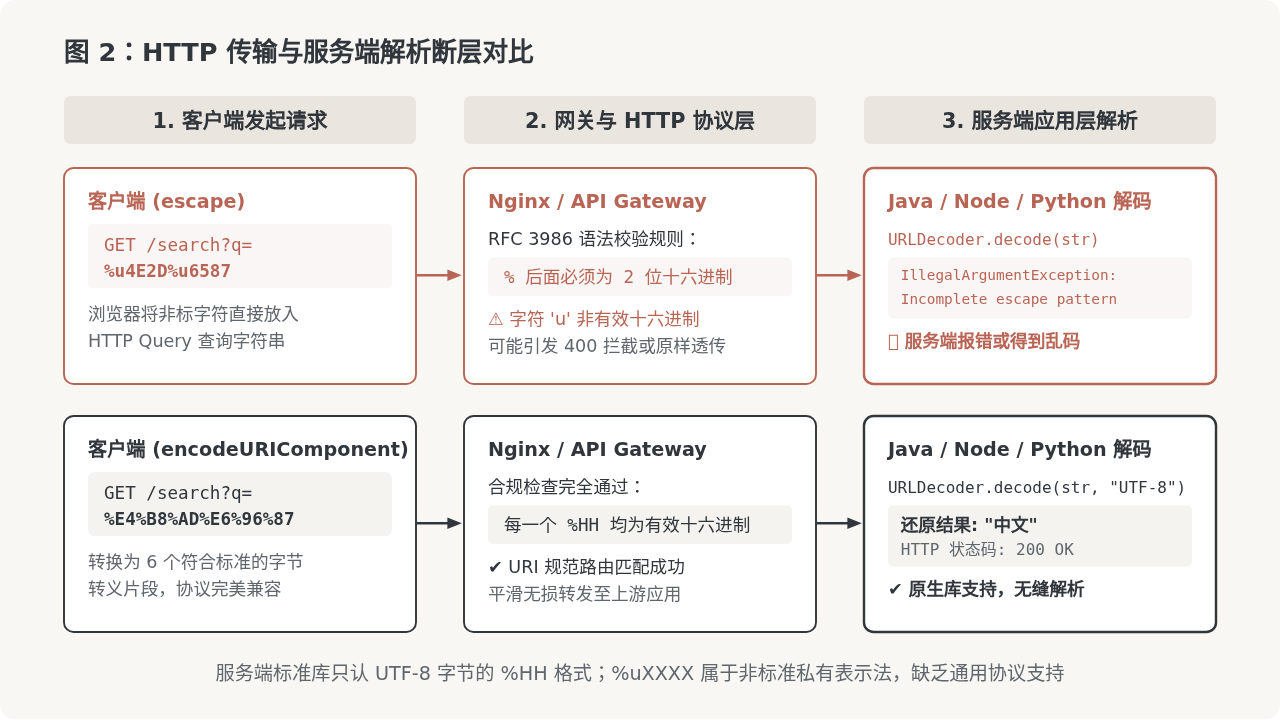
之所以早年间某些系统能够运行 escape,是因为在早期的特定生态(如旧版 ASP、JScript 配合微软专有组件)中,开发者在服务端手写了对应的 unescape 自定义函数来逆向还原 %uXXXX。然而在如今异构微服务、跨平台协作的互联网环境中,这种打破通用协议的私有方案具有极高维护成本和脆弱性。
三、规范演进与内置编码函数的正确定位
在 ECMAScript 语言规范的发展历程中,escape 的地位早已盖棺定论。ECMA-262 规范早自第 3 版(1999 年)开始,就正式将 escape 和 unescape 移入附录 B(Annex B: Additional ECMAScript Features for Web Browsers)。
规范在附录 B 中明确批注:“这些特性并不是 ECMAScript 核心语言的一部分……程序员不应在新的代码中依赖或使用它们”。保留其定义的唯一目的,是保证上世纪 90 年代的老旧静态网页在极少数遗留浏览器上不至于直接抛出语法未定义错误。
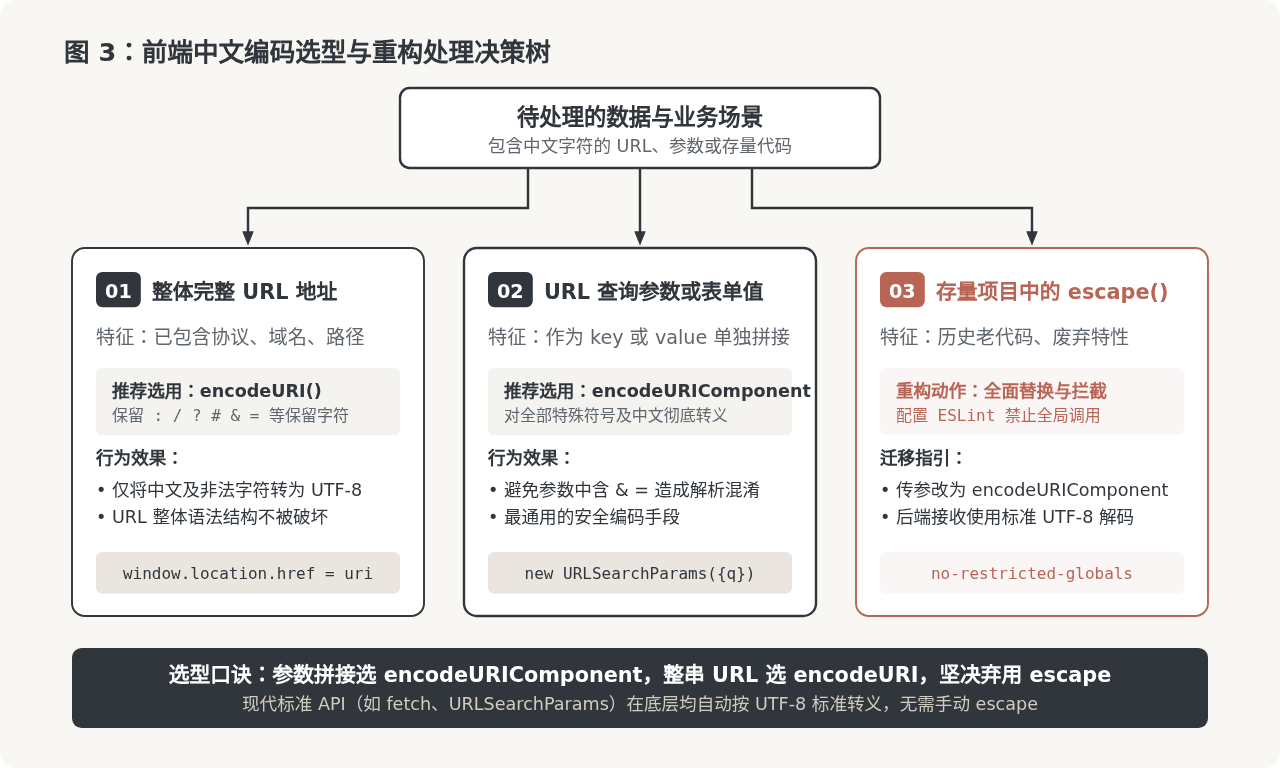
为了彻底取代 escape,ECMAScript 标准库提供了两个正规的核心函数:encodeURI 与 encodeURIComponent。正确区分和使用这两个函数,是避免中文乱码与 URL 语法损坏的核心功底。
1. encodeURI 的职责边界
encodeURI 的设计目标是处理整个完整的 URI 字符串。为了保证 URL 本身的层级、协议与定位功能不受破坏,它特意保留了具有特定 URI 语法的保留字符,包括:
; , / ? : @ & = + $ # 以及非转义字符 - _ . ! ~ * ' ( ) [0-9a-zA-Z]。
因此,当你需要对一个已经拼装好的完整链接进行中文安全转义时,应当选用 encodeURI。它会将链接路径中的中文字符转换为 %HH 字节序列,而不会误伤 https://、路径斜杠 / 或查询起始符 ?。
2. encodeURIComponent 的职责边界
encodeURIComponent 的设计目标是处理URI 中的某一个独立参数组件(如查询字符串的参数值)。在作为参数值时,字符 &、=、+ 或 / 必须被视作普通文本而非分隔符。因此,encodeURIComponent 会将除 - _ . ! ~ * ' ( ) [0-9a-zA-Z] 之外的所有特殊字符及中文字符全量转义为百分比字节序列。
如果在拼接 Query 参数时误用了 encodeURI,一旦中文参数中夹带 & 或 =,就会导致 URL 参数被截断解析;而在参数值场景下使用 encodeURIComponent,则能确保参数内容完整无损地传输至后端。
四、现代实践指南与遗留代码重构方案
理解了 escape 的缺陷与现代函数的特性后,在日常业务开发与系统重构中,推荐遵循以下具体操作范式。
1. 现代 URL 查询参数的标准构建方式
在现代前端工程中,手动使用字符串拼接和编码容易产生漏编或重复编码问题。最推荐的做法是直接利用现代浏览器与 Node.js 均内置的 URL 和 URLSearchParams API:
// 最佳实践:使用 URLSearchParams 处理含中文字符的查询参数
const baseUrl = 'https://api.example.com/v1/search';
const queryParams = {
  keyword: '前端性能优化 & 架构',
  category: '中文技术教程',
  page: 1
};

const searchParams = new URLSearchParams(queryParams);
const fullUrl = `${baseUrl}?${searchParams.toString()}`;

console.log(fullUrl);
// 自动按照 UTF-8 和 RFC 3986 完成标准编码:
// https://api.example.com/v1/search?keyword=%E5%89%8D%E7%AB%AF%E6%80%A7%E8%83%BD%E4%BC%98%E5%8C%96+%26+%E6%9E%B6%E6%9E%84&category=%E4%B8%AD%E6%96%87%E6%8A%80%E6%9C%AF%E6%95%99%E7%A8%8B&page=1
URLSearchParams 内部完全遵循现代标准规范,自动对键和值执行标准的 UTF-8 编码,彻底免除了手动调用的心智负担。
2. 存量系统中针对 %uXXXX 的过渡与解耦
如果需要维护具有十数年历史的存量系统,前端可能仍残存着历史写入 Cookie 或 LocalStorage 中的 %uXXXX 数据。在此类场景下,切忌继续调用全局的 unescape,而应采用精简的无副作用函数进行单点解析,并在更新数据时统一升级为标准 UTF-8 格式:
// 安全解析历史遗留的 %uXXXX 字符串,不依赖已废弃的全局 unescape
function parseLegacyUnicodeString(input) {
  if (typeof input !== 'string') return '';

  // 匹配 %u 紧跟 4 位十六进制数,通过字符编码原地还原
  return input.replace(/%u([0-9a-fA-F]{4})/g, (_, hexCode) => {
    return String.fromCharCode(parseInt(hexCode, 16));
  });
}

// 验证示例
const legacyData = '%u4E2D%u6587%u6D4B%u8BD5';
const restoredText = parseLegacyUnicodeString(legacyData);
console.log(restoredText); // "中文测试"

// 存入新存储或发送新接口时,必须立即切换为现代标准方案
const standardEncodedData = encodeURIComponent(restoredText);
console.log(standardEncodedData); // "%E4%B8%AD%E6%96%87%E6%B5%8B%E8%AF%95"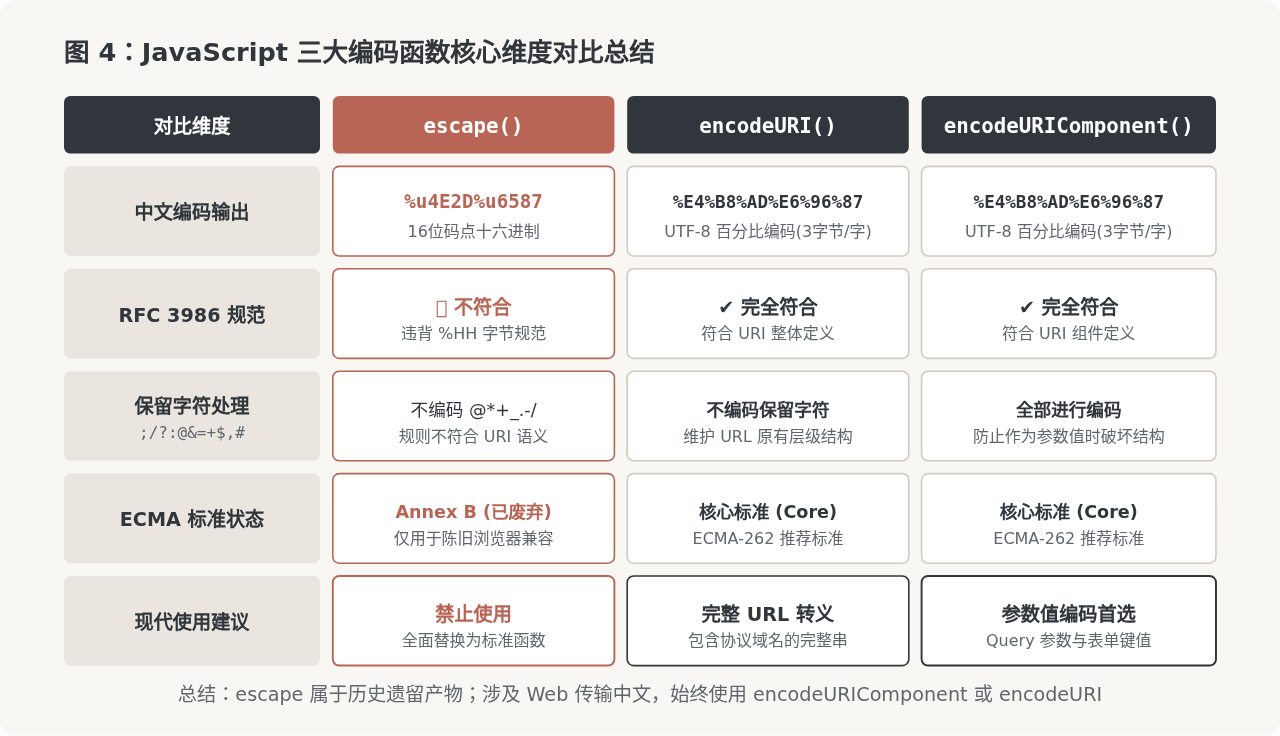
五、工程化约束与检查清单
为了从工程机制上杜绝 escape 再次进入代码仓库,建议在前端项目的 ESLint 静态代码分析配置中加入全局禁用规则:
// .eslintrc.json 配置规则
{
  "rules": {
    "no-restricted-globals": [
      "error",
      {
        "name": "escape",
        "message": "严禁使用已废弃的 escape 函数,中文及参数编码请使用 encodeURIComponent 或 encodeURI。"
      },
      {
        "name": "unescape",
        "message": "严禁使用已废弃的 unescape 函数,解码请使用 decodeURIComponent 或 decodeURI。"
      }
    ]
  }
}
在日常开发与 Code Review 中,请对照以下检查清单核对字符编码行为:
| 检查项 | 错误做法 | 推荐标准做法 |
|---|---|---|
| URL 参数拼接 | url + '?q=' + escape(val) |
url + '?q=' + encodeURIComponent(val) 或 URLSearchParams |
| 完整 URL 重定向 | escape(fullUrl) |
encodeURI(fullUrl) |
| Cookie 写入与读取 | document.cookie = 'k=' + escape(v) |
document.cookie = 'k=' + encodeURIComponent(v) |
| 跨语言接口联调 | 要求后端写特殊正则解析 %u |
全链路统一采用标准 UTF-8 URL 百分比编码 |
JavaScript高级程序设计第4版是否涵盖最新ES标准特性
2026-11-20 15:06:45
JavaScript异步编程:从回调函数到async/await的演进
2026-11-20 15:04:08
JS怎么生成指定长度的随机字母字符串
2026-11-20 14:37:42
JavaScript setTimeout基础用法与clearTimeout清除定时器
2026-11-20 14:20:52
为什么JavaScript类需要私有变量:封装性与API设计
2026-11-20 13:29:20







